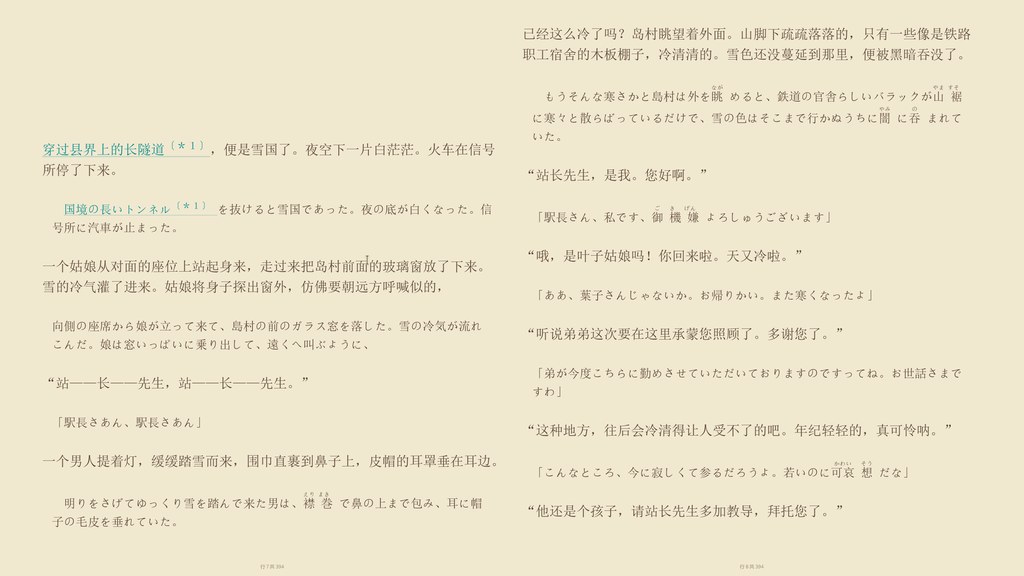
Wenyi 把整本書放進記憶:一次譯完一本書,角色名終於唔再走樣

Wenyi 是一款針對小說、專書同長篇敘事嘅開源翻譯工具,主打逐章掃描、術語即時對齊同可斷點續譯,支援 DeepSeek、OpenAI、Gemini 等多個模型供應商。

wenyi emblem

好多人試過用大型語言模型 (LLM) 翻譯小說或學術專書,往往喺第三、四章就發現角色名譯咗另一個譯法,或者術語前後矛盾,要回頭逐段人手修正。Wenyi 就係針對呢個常見痛點而設計嘅 Python 開源工具,主打長篇文本嘅翻譯流程。佢會事先將全書掃描一次,為每個章節建立摘要同全書概要,再喺逐批翻譯時一齊注入,令模型對脈絡同角色關係有長期記憶。

工具同時內建術語管理模組,會隨翻譯過程自動抽取人名、地名同專有詞彙,並偵測前後唔一致嘅譯法,要求人手仲裁,再影響後續批次。咁樣嘅設計對譯者、編輯同人氣翻譯團隊特別有用,可以避免「譯到後期先發現譯名漂移」嘅慘況。Wenyi 仲提供可選嘅多階段品管:先以主力模型做初譯,再由較強模型做潤稿,最後以證據導向嘅方式做整書 AI 審閱,適合對品質要求高、但又想慳人手嘅場景。

操作上,每批翻譯都有 checkpoint 落盤,章節狀態有獨立追蹤,任何時候中斷都可以用同一個指令續譯。支援嘅模型供應商包括 DeepSeek、OpenAI、OpenRouter、OrcaRouter、Google Gemini、Ollama、vLLM 及任何 OpenAI 兼容端點,可分為三個方便嘅 tier,亦可每個操作揀唔同模型。輸出格式方面,佢會直接寫返入原 EPUB 嘅 XHTML 模板,嘗試保留樣式、圖片、目錄同錨點,對電子書排版敏感嘅讀者會幾啱用。

要注意嘅限制係,Wenyi 仍然依賴上游模型嘅語言能力同上下文窗口,對語氣、文風同微妙雙關嘅判斷無可避免會受模型本身限制;長篇翻譯嘅成本同時間亦會隨章節增加。文檔列明需要 Python 3.10 或以上,社群主要喺 Discord 運作。

重點摘要:
– 全書預掃描 (Whole-book prescan):每章摘要 + 全書概要同時注入翻譯批次
– 即時術語同衝突偵測,可人手決議後回寫後續翻譯
– 支援 DeepSeek、OpenAI、Gemini、Ollama 等多 LLM,可分三層 tier
– 提供 checkpoint 續譯,中斷後同一指令可接返
– 多階段品管:初譯 → 強模型潤稿 → 全書 AI 審閱,並原生保留 EPUB 排版
GitHub

Categories: 開源, Google, OpenAI, DeepSeek, Gemini, Image, 工具, Ollama, Python

MiniMax H3 Director Studio:Windows 本地模型做 AI 影片前期製作

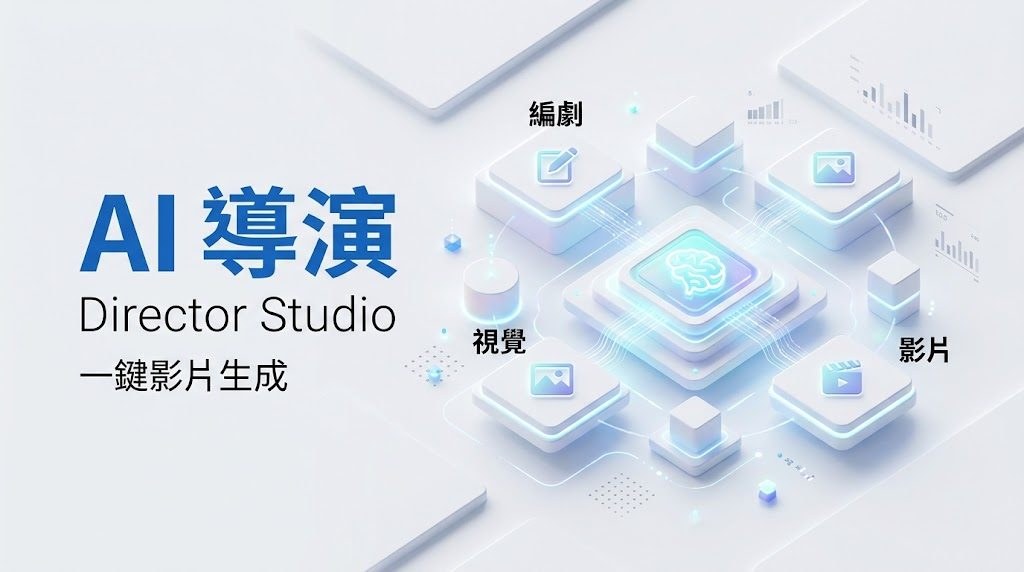
Director Studio 是一個本地優先的前期製作工作空間,串接 Ollama 規劃鏡頭、ComfyUI 生成畫面,再交由 MiniMax H3 出片,特別適合想完全控制創作流程的獨立創作者。

Repository image for ai2764/Director-Studio

想在本地完成 AI 影片從構思到成片的整條前期流程,而不依賴雲端訂閱?Director Studio 正是針對這個需求的工作空間類工具。它把鏡頭規劃、可重用的視覺與語音資產管理、以及 MiniMax H3 Ref2AV 提示詞撰寫,整合在同一個介面內,最後透過 ComfyUI 與 MCP 協議生成圖像與影片。

與一般 ComfyUI 前端不同,它把「規劃 Agent」綁定在本地 Ollama 上運行,並與 ComfyUI 共享 VRAM,避免兩者搶顯存。用戶可以選擇全本地流程,亦能把 H3 影片交給官方 MiniMax API 處理,兼顧靈活與效能。內建的 typed asset library、演員與場景工作流、可編輯的 Picture/Audio 參考、以及六段式 H3 提示詞結構,讓鏡頭設計不再是憑感覺亂試。

Qwen3.8 27B Directs H3 | Director Studio Is Now Open Source

對於獨立創作者、小型製作團隊,或需要反覆迭代鏡頭分鏡的人,這套工作流省下了在不同工具間切換的成本。Windows 用戶只要安裝 Ollama、ComfyUI Desktop 與 Python 3.10+,再解壓官方 zip 即可透過 DirectorStudio.exe 啟動,所有資料儲存在執行檔旁的 data 目錄,方便升級前備份。

採用 FastAPI 後端配合 Vite + React 前端,規劃 LLM 透過 Ollama 執行,生成層則透過 ComfyUI MCP 串接。架構與擴展點已在 docs/ARCHITECTURE.md 說明,適合想自行修改管線的進階用戶。

需要注意,VRAM 是這套系統的瓶頸:Ollama 與 ComfyUI 需共享顯存,若要同時運行大型本地模型與高解像度影片工作流,硬體門檻不低。對於偏好全雲端、或無獨立顯卡的用戶,這套方案未必比 SaaS 工具方便。

GitHub

Categories: 開源, ComfyUI, Agentic, AI productions, MCP, 模型, 多模態模型, API, Video, Image, Audio, 工具, Content Creator, Ollama, Python, , MiniMax

VibeVoice-ASR-Streaming-7B 即時辨識與轉錄合而為一

Microsoft Research團隊將講者辨識加入串流語音轉錄,讓語音助手更快知道誰在說甚麼。

Hugging Face

Microsoft Research 聯同中國科學院大學及上海交通大學研究人員,開發VibeVoice-ASR-Streaming。

模型以 Large Language Model(LLM)為核心的端到端串流Speaker-Attributed Automatic Speech Recognition(ASR)系統,連續處理到達中的語音,同時輸出文字及講者身份。傳統流程通常把ASR與speaker diarization分開處理;此模型將兩項工作放進單一模型,針對即時語音助手及語音代理需要低延遲回應的場景,減少等待完整錄音後才分析的限制。

VibeVoice-ASR-Streaming 會交錯處理固定大小的audio chunks,並加入少量lookahead,讓模型在保留未來聲音片段作判斷的同時,逐步產生轉錄結果。固定分塊有助控制處理延遲,但lookahead 與分塊大小之間仍要取捨:前者越多,講者切換及語句判斷可能更穩定,回應時間亦可能增加。

  • 以單一LLM-based端到端模型同步處理ASR與speaker attribution
  • 使用固定大小audio chunks及少量lookahead支援串流輸出
  • 針對即時語音助手及agents的低延遲需求設計
  • 量化檔案、推論框架、硬體需求及效能指標尚未在提供內容中交代

項目主頁 · Paper · 模型

Categories: Agentic, 微軟, Audio, Discord, LLaMa, Ollama, 語音, Dataset 數據集

[技術文章]LLM 媲美 Embedding,成本卻高逾 1431 倍

LLM已能追上頂尖Embedding模型,但搜尋系統未必值得因此承受高昂成本。

Hugging Face

做語意搜尋、分類或文件聚類時,LLM已能在多項測試追上專門的文字嵌入模型;但每次評測成本最高相差1,431倍,令「是否應取代Embedding pipeline」成為成本與能力之間的取捨。本頁屬研究論文內容,並非可直接下載的單一模型頁面;未有提供可確認的 base model 或 fine-tuned from 資訊,因此無法判定某個模型的原始基礎模型。

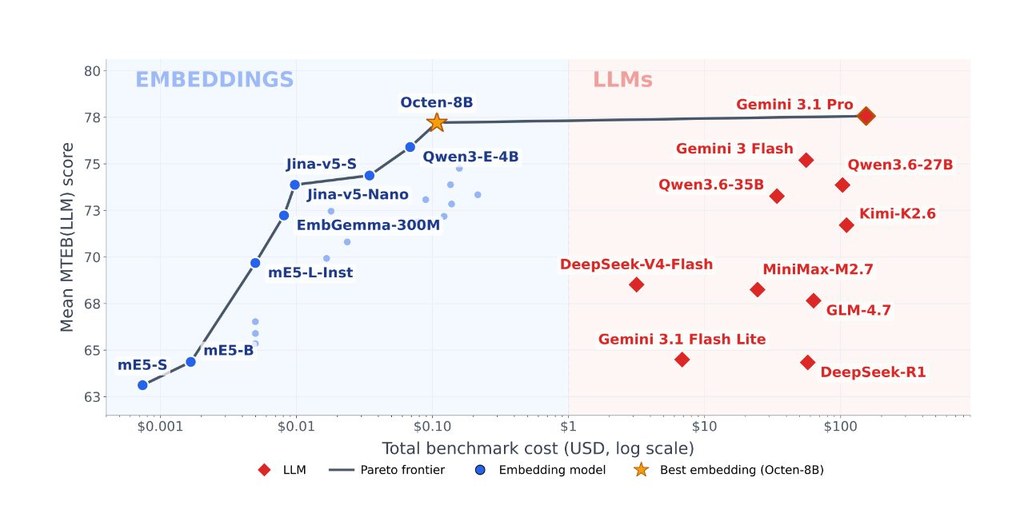
研究比較10個、來自6個家族的 large language models (LLMs),以及26個參數量由118M至14B的 embedding models,測試涵蓋37項 MTEB(LLM) 任務,包括分類、semantic textual similarity (STS)、聚類、pair classification 和 retrieval。最佳 LLM Gemini 3.1 Pro 得分77.6,最佳 embedding model 得分77.2,差距只有0.4分。

  • Embedding models 在分類、相似度和聚類表現較合適
  • LLM 在需要推理的 retrieval 任務較有優勢
  • LLM 每次 benchmark pass 成本約154美元,embedding model 約0.11美元
  • 開源 LLM 在同一 GPU 上慢約2.5至736倍
  • reasoning tokens 佔 LLM inference 成本28%至81%

研究亦指出,降低 reasoning budget 對多數模型的 retrieval 品質沒有明顯傷害,反映混合式流程更合理:以 embedding model 負責大部分相似度搜尋,再把需要理解語境或多步推理的查詢交給 LLM。

Paper

Categories: Embedding, Qwen, Gemini, LLaMa, Ollama, Dataset 數據集, Kimi

Qwen3.8-2.4T-A95B 超大型開放權重文字推理模型

Qwen3.8 把 Qwen-Max 級別能力帶到開放模型,強項不只是答題,而係更穩定完成多步驟工作。

Og image

Qwen3.8-2.4T-A95B 把 Qwen-Max 級別的能力開放出來,而且明確建基於 Qwen3.5 的架構底層,BF16 safetensors 格式及1M上下文。定位上屬於 Causal Language Model,面向文字生成、編程、研究工作與長流程 Agentic 任務;相比只追求單輪回答,它更著重規劃、接收環境回饋,以及把多步驟工作做完。

Qwen3.8-2.4T-A95B 的核心規格相當進取:總參數 2.4T(2.4 trillion)參數,但每次啟動 95B,屬於典型大型 Mixture of Experts(MoE)路線,用較高總容量換取較可控的推理成本。模型經過 Pre-training 與 Post-training,並採用 Qwen3.5 架構延伸而來的層設計,包括 Gated DeltaNet、Gated Attention 與 MoE 組合,重點不是單純堆大,而是提升長鏈推理與任務完成的穩定性。

Qwen3.8-2.4T-A95B 主要來自兩個控制點:reasoning_effort 可調整推理深度,preserve_thinking 可保留歷史訊息中的 reasoning context。這代表它比較適合需要反覆修正、逐步執行的工作流,而唔係只看一次輸出的場景。頁面亦提到它對常見 harness 與開發工具有更廣泛支援,模型檔案可配合 Transformers、vLLM、SGLang、TokenSpeed 等推論堆疊。

  • 基礎模型可確認是建基於 Qwen3.5 architectural foundation。
  • 已知開放的是 Hugging Face Transformers 格式的 post-trained 權重。
  • 官方另有 Qwen3.8-Max 版本,功能更多,包含 vision input、non-thinking support、內建工具,以及預設 1M context length;但這些能力屬於官方服務版本,不應直接視為此頁權重全部具備。
  • 從已公開資訊看,它的優勢在於長流程 Agent 執行與專業工作可靠度提升;限制是硬體需求、完整上下文長度與量化部署細節未在此頁交代,離本地輕量部署仍有距離。

跟一般只強調 benchmark 分數的模型相比,它更強調任務完成率、規劃能力與工具鏈兼容性。由於缺少量化版本、推理記憶體需求與更完整評測數字,現階段較適合把它理解成面向高階推論服務與大型基建環境的開放權重,而不是即插即用的本地模型項目。

模型

Categories: 開源, Agentic, 模型訓練, Qwen, API, LLaMa, Ollama, 編程, Dataset 數據集

MiniMax H3:全模態影音生成說明書

MiniMax H3 把文字、圖片、影片與聲音整合到同一套生成流程,並支援同步影音輸出。

Og image

MiniMax H3 面向需要由多種媒體素材生成影片的場景,輸入可包括文字、圖片、影片及聲音,輸出則涵蓋影片與同步音訊。它屬於通用 omni-modal generative system,並非只處理 text-to-video,亦標示支援 image-to-video、video-to-video、audio-to-audio-video 等流程。提供的內容未載明它基於哪個 base model,亦無法確認是否由其他模型 fine-tuned from。

這種統一處理方式適合將參考圖片、動態片段或聲音一併納入生成條件,減少工作流程需要分拆成多個模型的情況。metadata 指向 Diffusers,並列出 multimodal、synchronized-audio-video 及 reference-to-audio-video 等能力;不過目前資料未交代模型架構、參數規模、上下文長度、訓練方法或效能指標。

可留意的使用重點包括:
– 支援 text-to-video、image-to-video、image-text-to-video 及 video-to-video。
– 可處理文字、圖片、影片與音訊,並生成 audio-video 組合內容。
– 提供 Global 與中國地區的 Online API,以及 Hailuo AI 網頁和桌面 App。
– 標示使用 MiniMax H3 Community License Agreement,部署前應查閱 LICENSE。

項目主頁

Categories: 開源, 多模態模型, 視頻模型, Video, Image, Audio, 3D, Ollama, MiniMax

LFM2.5-2.6B:細模型做得到本地 Agent

LiquidAI 把 2.6B 模型做成可離線執行的 Agent 核心,重點是工具調用同多步任務。它更像一個為裝置端而設的工作模型,而唔係只追求聊天流暢度。

Og image

LFM2.5-2.6B 屬於經過後訓練的語言模型,基礎模型是 LFM2.5-2.6B,並非頁面再細分成其他來源模型。它的定位很清楚:在筆電、手機呢類裝置上處理工具調用、網頁搜尋同多步工作流程,盡量將推理留喺本地,減少資料外傳同雲端成本。

模型先經過約 34T tokens 的 pre-training,再用 mid-training 將上下文擴到 128K。之後以四階段後訓練把 base model 變成 agent,包括兩輪 SFT、按領域訓練 teacher、MOPD(Multi-domain on-policy distillation)同 Agentic RL(Agentic Reinforcement Learning)。頁面亦提到它在常見 agentic harness 內做過強化學習,目的係提升同工具框架的兼容度。

重點放在 GGUF 格式、mmproj 及量化版本,但目前提供的內容未列出完整檔名與各自大小,所以無法可靠列出每個檔案細節。作者建議由 Q4_K_M 作為起點,再按記憶體同速度需求向上或向下選擇;頁面同時指出它可以配合 llama.cppOllamaLM Studio 使用。

它在 Apple M5 Max 可達 220 tok/s,在 AMD Ryzen CPU 上可達 113 tok/s,而且記憶體需求低於 2.5 GB。不過,模型亦有清楚限制:它主要強在 agent 任務同工具使用,並唔代表所有通用推理場景都會贏過更大的模型;進階用法可配合 MTP draft speculation,但頁面未提供足夠細節去判斷其實際收益幅度。

  • 約 34T tokens 預訓練,後續再做 agent 導向微調
  • 上下文窗擴到 128K,適合較長任務鏈
  • Q4_K_M 可作為量化起點,兼顧體積同速度
  • 支援 llama.cppOllamaLM Studio
  • 設計重點係本地工具調用、多步 workflow,同私隱優先

項目主頁 · 模型

Categories: 模型, 教學, Mac, LLaMa, Ollama

DeepSeek-V4-Flash-0731:輕量化 Agent 模型追上大模型

想要較少啟動參數,又保留強 Agent 表現,DeepSeek-V4-Flash-0731 就係呢類取向。它把重點放在工具調用、編碼同自動化任務,速度與能力之間取得幾實際的平衡。

Og image

要兼顧回應速度、部署成本同 Agentic 能力,DeepSeek-V4-Flash-0731 走的是「較少啟動參數換取高效任務表現」的路線。頁面已清楚寫明它與 DeepSeek-V4-Flash-DSpark 採用相同模型結構,並且附帶 speculative decoding module,所以它不只是一般聊天模型,而是明顯朝工具使用、自動化操作與程式任務優化的版本。

它屬於 DeepSeek-V4-Flash 官方正式發布版,取代 preview 版本,並強調 agentic capabilities 有明顯提升。模型卡同時指出它的模型結構與 DeepSeek-V4-Flash-DSpark 一致,代表推理流程很可能圍繞主模型加速草稿模組來設計。

效能數字是最值得留意的部分。它在 Terminal Bench 2.1、NL2Repo、Cybergym、DeepSWE、Toolathlon-Verified、Agents’ Last Exam、AutomationBench Public 等基準上,普遍明顯高於 DeepSeek-V4-Flash(Preview),部分項目亦超過 DeepSeek-V4-Pro(Preview)。這種進步集中在 terminal 操作、程式庫理解、資安演練、軟件修復同工具鏈任務,反映它更像為 Computer-use agents、程式代理與自動化流程而調整,而不只是追求一般問答分數。

  • 與 DeepSeek-V4-Flash-DSpark 同結構,並附帶 speculative decoding module
  • 官方正式版取代 preview,重點提升 agentic capabilities
  • 多個 Agent/編碼基準明顯優於 DeepSeek-V4-Flash(Preview)
  • 啟動參數較少,但表現可與部分強勢閉源模型接近

部署資訊方面,內容只提供一則討論帖,提到可用兩台 DGX Spark 配合 ghcr.io/bjk110/vllm-spark:unholy-fusion-prod-ready 作最少設定部署;但模型頁面片段未列出上下文長度、GGUF 格式量化檔、mmproj、檔案大小、chat template 注意事項或 v2 檔名變更,因此不能推斷 llama.cpp、Ollama、LM Studio 的支援細節,也不能提供 Q4_K_M 一類量化建議。現有資料較適合把它理解成一個偏向高效率 Agent 任務的 DeepSeek 模型發布,而不是本地 GGUF 部署導向的模型。

模型

Categories: 開源, Agentic, 模型, DeepSeek, LLaMa, Ollama

Ollama 3.25 把開源模型帶回你部機

想喺自己電腦跑開源大模型,又唔想先砌一大堆環境,Ollama 正正係針對呢個卡位。它將模型執行、管理同串接應用壓縮成一條較順手的路。

Repository image for ollama/ollama

想將開源模型放返本地處理,又要兼顧聊天、程式整合同 agent 工作流,Ollama 幾乎係目前最直接的一條路。它屬於模型執行與管理工具,核心作用係將本地大語言模型的下載、啟動、呼叫同整合收斂到同一套介面,令 Mac、Windows、Linux 甚至 Docker 部署都比較一致。

它吸引人的地方不只是可以對話,而係可以直接接去 Claude Code、OpenClaw、Codex、Copilot 等現有工具鏈。換句話說,Ollama 唔係只提供一個聊天殼,而係充當本地模型服務層;你可以用 CLI 跑模型、經 REST API 調用,亦可以配合 ollama-python、ollama-js,或者再接 Open WebUI、LibreChat、Lobe Chat、NextChat、Perplexica 呢類前端與應用。

同類做法入面,Ollama 的取向好清楚:它唔著重花巧介面,而係先處理「點樣穩定喺本地把模型跑起來,再供其他程式使用」呢件事。背後支援 llama.cpp,意味住它承接咗本地推理生態的成熟基礎;代價亦存在,本地效能仍然受你部機的記憶體、GPU 與模型大小限制,追求大型模型或高併發時,就未必有雲端服務咁輕鬆。

  • 安裝路徑完整,覆蓋 macOS、Windows、Linux 同 Docker,理解上可以當成一個本地 AI 服務。
  • 既可直接 run 模型聊天,亦可透過 REST API、Python、JavaScript 接入現有項目。
  • 跟 Claude Code、OpenClaw、Codex、Copilot 等整合,適合做本地 agent 與開發工作流。
  • 配合 Open WebUI、LibreChat、Lobe Chat、NextChat 等,可快速補上可視化操作層。

較受惠的一群,會係想保留資料喺本地的開發者、需要快速測試開源模型的團隊,以及想把 AI 能力嵌入內部工具的人。就產品定位而言,Ollama 最有價值的地方,係將「本地跑模型」由零散步驟變成可重用的基礎設施。

項目主頁 · GitHub

Categories: 開源, Agentic, API, Mac, Linux, Ollama, Python

OpenWorker – Andrew Ng 開發桌面 AI 龍蝦

OpenWorker 係一個開源嘅桌面 AI 同事,由 Andrew Ng 團隊開發,強調本地執行、帶自己嘅模型 API key,並且會產出真正嘅成品而唔止係聊天回覆。

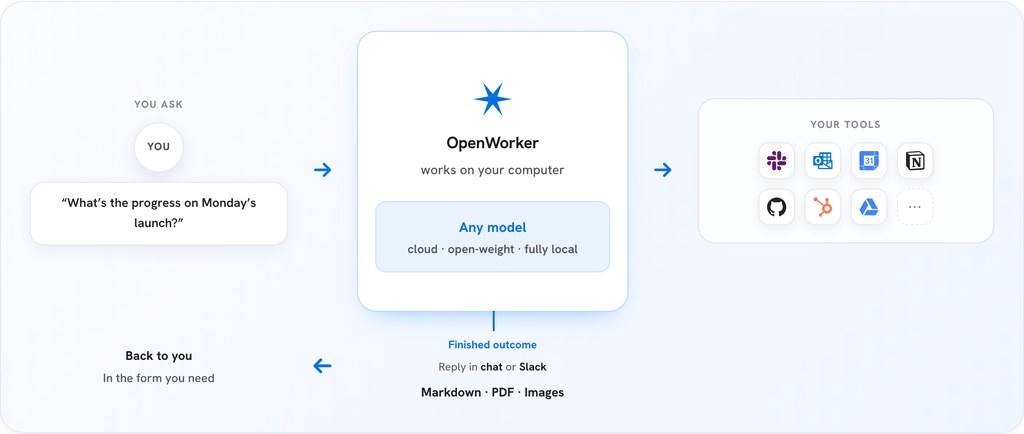
How OpenWorker works

對好多打工仔嚟講,最大嘅困擾唔係 AI 唔夠聰明,而係佢只識得「答問題」而唔識得「做完件事」。OpenWorker 嘅切入點正正喺呢度:佢定位係一個會跑喺你電腦上面嘅 AI 同事,可以幫你整理 calendar、寫 follow-up email、甚至自動出一份 customer brief,最後畀你一份可以直接開嚟用嘅文件,唔係一串對話。

OpenWorker 由 Andrew Ng(吳恩達)相關團隊推出,引擎建基於佢哋自己開發嘅 Python 開源庫 aisuite,呢個庫提供統一嘅 chat-completions API 以及支援工具調用(tool calling)、MCP 等功能。簡單講,OpenWorker 唔係從零寫起嘅 wrapper,而係將 aisuite 包成一個真正面向桌面用戶嘅應用,並且喺原本 aisuite 倉庫入面開發咗一段時間之後,先搬出嚟獨立成 repo。

目前支援 macOS(Apple Silicon)以及 Windows 10/11,用家可以貼上自己嘅 API key 去用 OpenAI、Anthropic、Google Gemini、DeepSeek、Kimi、Qwen、Mistral 等模型,亦可以經 Ollama 完全本地跑開源模型。所有嘢都喺本機行,只有用家授權嘅 model call 或者連接工具先會接觸到網絡。對於注重私隱或者公司政策唔畀數據出 cloud 嘅人,呢個係一個幾實際嘅選擇。

OPENWORKER: The Free AI Desktop Agent That Isn't Locked to One Model

佢亦內建 25+ 個整合,包括 GitHub、Slack、Jira、Notion、Linear、HubSpot、Outlook、Gmail、Google Calendar 等,亦支援任何可以經 MCP(Model Context Protocol)接駁到嘅工具。最令筆者欣賞嘅係佢嘅審批機制:寫訊息、發送郵件、執行 shell 指令呢類「對外有影響」嘅動作,全部都要先經你確認先至會執行,唔會自己靜靜雞撳掣。

以下係幾個用家會比較關心嘅重點:

  • 定位係桌面 AI 同事,目標係交到「成品」而唔止係聊天回覆,例如 HTML brief、Markdown 報告、排好嘅 calendar 更新等。
  • 完全開源、MIT 授權,由 Andrew Ng 團隊開發,引擎建基於佢哋嘅 aisuite 開源庫。
  • 模型自選,支援多間主流 cloud provider,亦可以經 Ollama 完全本地執行開源模型。
  • 重視私隱,對話、token、API key 都儲喺本機 secret store,唔需要登入亦可以用。
  • MCP + 審批機制,所有對外動作(發訊息、執行指令)都會先問過你先做,減低「AI 自行撳掣」嘅風險。

如果你係一個人或者小型團隊,想搵一個可以幫你「跑手」而唔係淨係「傾偈」嘅 AI 工具,又唔想將公司敏感資料送去閉源服務,OpenWorker 算係一個值得試嘅選擇。佢而家仲喺 open beta,官方表示會自動更新、不斷執吓啲 bugs,畀用家提交 issue。適合想認真將 AI 融入日常工作流、對私隱同可控性有要求嘅人。

項目主頁 · GitHub

Categories: 開源, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Ollama, Python, Anthropic, 蘋果, Kimi

Page 1 of 3
1 2 3