Kimi K3 把開源大模型推到 3T 級別

想要一個同時處理寫碼、長文件同推理工作的模型,Kimi K3值得留意。它未追平最強閉源模型,但已把開源模型的上限再推高一截。

Kimi K3 hero visual

長上下文、程式開發同知識工作往往要分開交畀不同模型處理,Kimi K3嘗試把這幾件事收在同一個開放模型內。它屬於大型多模態模型,重點是處理長流程 coding、長篇資料閱讀與推理之間的切換成本,並提供原生 vision 能力與 1M context。

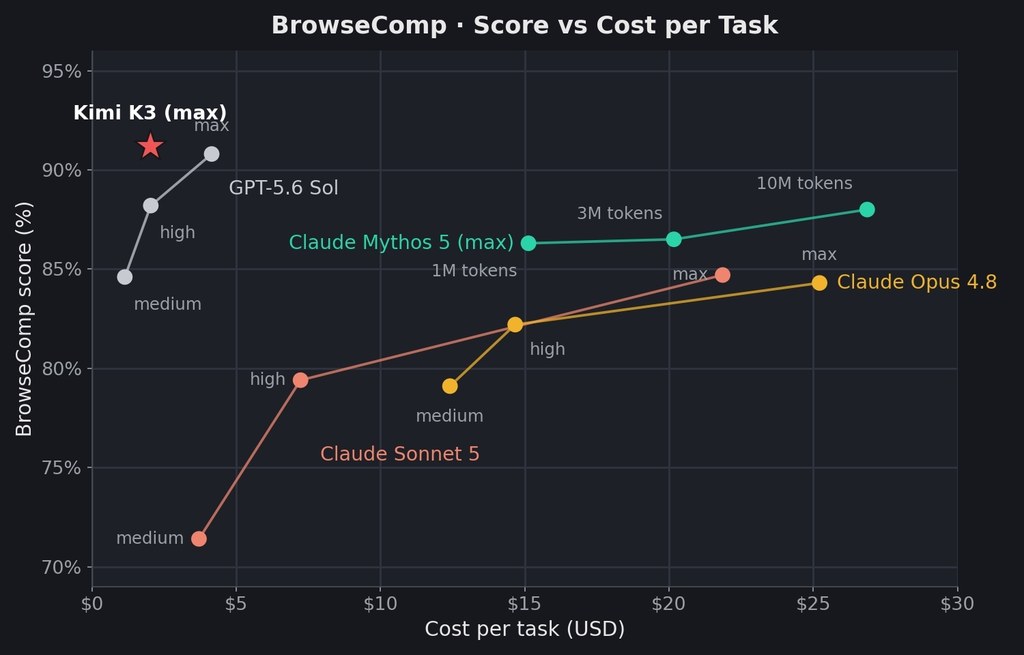
Kimi K3 的定位,不是單靠參數規模取勝,而是想在開源路線上逼近 frontier intelligence。資料提到它有 2.8T parameters,屬於首個 open 3T-class model,整體表現仍落後於 Claude Fable 5 和 GPT 5.6 Sol,但在自家 evaluation suite 內已持續超過其他被測模型,顯示它在開源陣營有明顯競爭力。

技術上,這個模型建基於 Kimi Delta Attention(KDA)同 Attention Residuals(AttnRes),目的是改善資訊在長序列與深層網絡中的流動方式;同時也擴大了 Mixture of Experts(MoE)sparsity。這種做法反映它要處理的核心矛盾:一邊維持超長 context 與多類任務能力,一邊控制推理與訓練效率。

  • 首個 open 3T-class model,規模達 2.8T parameters
  • 原生支援 vision,並提供 1M context window
  • 目標場景包括 long-horizon coding、knowledge work 同 reasoning
  • 採用 Kimi Delta Attention(KDA)、Attention Residuals(AttnRes)與 Mixture of Experts(MoE)
  • 已在 Kimi.com、Kimi Work、Kimi Code 同 Kimi API 提供使用

對開發者、研究者同需要長文檔工作流的人來說,Kimi K3最有吸引力的地方,在於它把「夠長、夠廣、夠開放」放在同一個項目裡。現階段可確認的限制也很清楚:它未到最強閉源模型的水平,而完整權重、架構與訓練細節仍要等後續 technical report 與正式釋出。

項目主頁

Categories: 開源, Agentic, 多模態模型, API, Vibe Coding, 教學, 線上服務, IDE, Mac, 編程, OpenClaw

MuScriptor 把多樂器轉譜拉近可用水位

想把整首歌拆成可編輯的 MIDI,MuScriptor 提供一條比舊式轉譜工具更貼近真實錄音的路。它重點唔係只識單一樂器,而係處理混音後仍然保留多聲部。

MuScriptor logo

聽住一段完整歌曲,直接整理出可編輯的 MIDI,本來最易卡住嘅位係多樂器同時出現之後,音色、失真同重疊頻段會令轉譜結果迅速走樣。MuScriptor 針對嘅正正係呢種情況:它屬於開源音樂轉譜模型,目標係將真實世界嘅多樂器錄音轉成符號化樂譜,而唔係只喺單一樂器或合成資料上做得好睇。

舊一代 Automatic Music Transcription 往往依賴大量 synthetic training data,代表性做法如 MT3,喺合成測試集成績可以唔錯,但一落到真實混音音樂就容易失準。MuScriptor 嘗試修正呢個範式,先分析 synthetic data pre-training 嘅作用,再結合真實音訊 fine-tuning,同時加入 reinforcement learning 做 post-training,重點唔係追求實驗室式乾淨訊號,而係提升跨曲風、多樂器錄音嘅泛化能力。

對一般創作者、編曲人、音樂研究者同需要把歌曲快速轉成 MIDI 工作流嘅團隊來講,呢個項目吸引力幾直接。它提供 web UI 同 CLI 兩種方式,本地可先用 uvx muscriptor serve 背後嘅介面理解效果,亦可以用命令列批次處理;首次執行前要有 HuggingFace 帳戶並接受模型授權,權重會下載後快取,本地網頁服務預設只開喺 127.0.0.1,改成 --host 0.0.0.0 就可以喺區域網路存取。

  • 已公開 smallmediumlarge 三個模型,分別為 103M、307M、1.4B 參數
  • small 較適合 CPU-only 環境,medium 係預設速度與準確度平衡,large 追求更高準確率但更重
  • 模型架構採用 transformer decoder only
  • 支援 instrument presence conditioning,用來控制轉譜時聚焦邊類樂器
  • 播放功能唔係單純示意,而係透過完整 SoundFont synthesizer SpessaSynth 回播

限制亦寫得算坦白:權重受 CC BY-NC 4.0 約束;Intel Mac 要留意 PyTorch 同 Python 版本配搭。現有資料指出它訓練用到 170k 首歌,涵蓋 classical music 到 heavy metal,定位上明顯比只靠小量真實資料、再用大批合成音訊補足嘅方法更著重真實混音可用性。對需要高質多樂器 AMT 嘅人,MuScriptor 目前最值得留意嘅,係它唔再只展示「可以轉譜」,而係開始處理「轉出嚟能否進入後續編曲或分析」呢個關鍵差距。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Mac, Python, 音樂, Dataset 數據集

Needle 想把微型 AI 帶落手機同手錶

Needle唔係追求萬能對話,而係集中做好 function call。26M 參數做到可本地微調,方向相當鮮明。

Logo

想喺手機、手錶或者眼鏡一類裝置放入可用嘅個人 AI,卡位往往唔係模型夠唔夠大,而係夠唔夠細、夠唔夠快,仲要肯做工具呼叫。Needle 就係朝呢個位置落手:一個以 Simple Attention Network 為核心嘅微型模型項目,重點處理 single-shot function call,目標唔係長篇對話,而係幫個人 AI 更穩定咁叫工具做事。

呢個項目最值得留意嘅地方,在於佢將 Gemini 3.1 蒸餾到 26M 參數,並且保留到可以喺 Mac/PC 本地 finetune 嘅路線。對開發者同產品團隊嚟講,意思好直接:你未必要綁死雲端大模型,亦可以先用開放權重同資料生成流程,試自己嘅工具介面、指令格式同 function schema,再按需要微調。

Cactus Needle - The 26M Function Calling Model

同類小模型通常會喺「尺寸、速度、泛化能力」之間拉扯,Needle 明顯揀咗功能導向呢一邊。README 已經講得很坦白:佢喺 single-shot function call 勝過 FunctionGemma-270m、Qwen-0.6B、Graninte-350m、LFM2.5-350m,但呢類較大模型喺對話範圍同容量上仍然更強,所以 Needle 比較似一把專用工具,而唔係通才助手。

  • 類型上屬於開源模型項目,集中解決小裝置上嘅 function call 效率與部署成本。
  • 權重同 dataset generation 都已開放,適合拿來測試自家工具鏈同微調流程。
  • 生產環境配合 Cactus,可達 6000 toks/sec prefill 同 1200 decode speed,取向非常著重吞吐。
  • 預訓練用 16 TPU v6e 跑 200B tokens,之後再用 2B tokens 嘅 single-shot function call dataset 做 post-training。

模型結構亦反映咗呢種取向:Simple Attention Network 採用 encoder-decoder 佈局,配合 GQA+RoPE、Cross Attn、ZCRMSNorm 同 shared embedding,目的係用更細規模支撐工具呼叫輸出。要留意嘅限制同樣清楚,小模型本身比較 finicky,對資料格式、工具定義同微調質素會更敏感;需要穩定多輪對話或者更廣知識覆蓋嘅場景,仍然未必係 Needle 最合適。

GitHub

Categories: 開源, Embedding, 模型, 模型訓練, Qwen, Gemini, Mac, Dataset 數據集

GitHub Copilot 桌面 app 全面開放

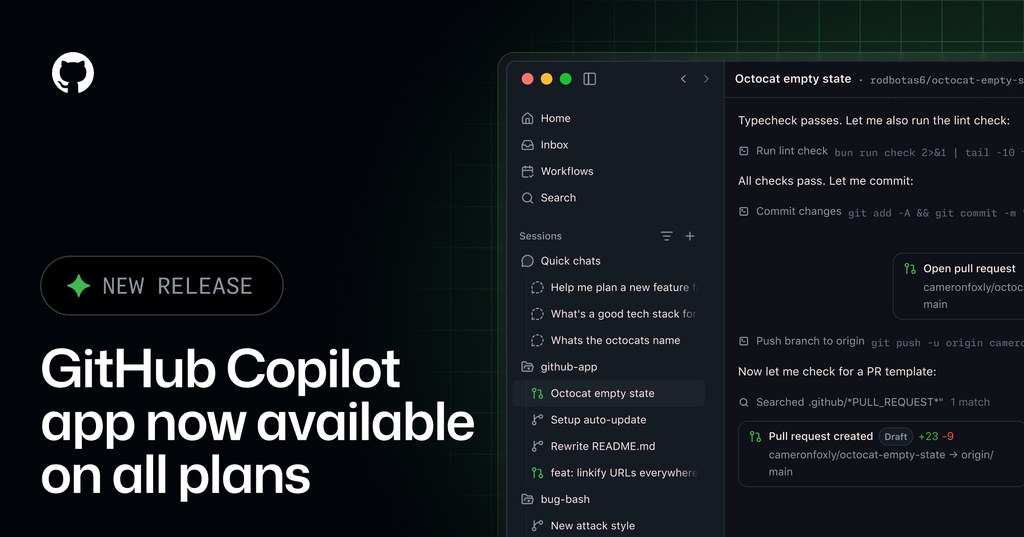
而家唔止付費用戶先可用 GitHub Copilot app,連 Free 同教育方案都可以直接開跑。你可以把它理解成將 agent-driven development 帶到桌面的入口。

Og image

寫程式想快啲進入 agent-driven development,而家門檻低咗好多。GitHub Copilot app 已經開放畀所有 Copilot 方案使用,涵蓋 Copilot Free 同 GitHub Education,並且支援 macOS、Windows 同 Linux,等開發者可以直接由桌面開始工作。

對一般開發者而言,重點唔只係「多一個 app」,而係登入 GitHub 帳戶後,幾下點擊就可以開 session,將 Copilot 由編輯器內的輔助,延伸到更完整的桌面互動流程。呢個變化對想集中用單一入口管理開發節奏、快速試 agent 工作方式的人會更有吸引力。

另一個取向幾清楚:就算冇訂閱 Copilot 方案,仍然可以用 bring your own key(BYOK)接上自己嘅 model provider 跑 session。即係話,GitHub 將入口開放得更闊,一邊照顧現有 Copilot 用戶,一邊容許偏好自選模型供應商嘅團隊或個人保留彈性。

  • 所有 Copilot 方案都可使用,包括 Copilot Free 同 GitHub Education
  • 支援 macOS、Windows、Linux 三個桌面平台
  • 可用 GitHub 帳戶直接登入並快速開始 session
  • 冇 Copilot 訂閱亦可透過 BYOK 連接自有 model provider
  • Business 或 Enterprise 方案需由管理員啟用 Copilot CLI 政策設定

對團隊環境來講,Business 同 Enterprise 用戶仲要留意權限設定:組織或企業管理員需要先在 policy settings 啟用 Copilot CLI,先可以存取 GitHub Copilot app。呢點反映出 GitHub 既想擴大可用範圍,同時亦保留企業管理所需的控管方式。

項目主頁

Categories: Agentic, 微軟, API, Mac, Linux, 編程

DeepSeek-V4-Flash 本地 GGUF 版

想喺本地跑 DeepSeek-V4-Flash,重點唔只係能否啟動,仲要留意量化後準確度、記憶體門檻同對話模板是否貼近官方表現。呢個版本主打用 GGUF 格式換取更易部署,但硬件要求仍然偏高。

Og image

最值得先講的是,它明確基於 deepseek-ai/DeepSeek-V4-Flash 製作,屬於面向本地部署的 GGUF 量化版本,處理的是大型語言模型喺本機執行時常見的記憶體壓力與部署門檻。頁面同時提醒要配合最新版本的 llama.cpp 或 Unsloth Studio,否則 DeepSeek-V4 可能無法正確運行,代表它對推論框架版本有一定依賴。

Unsloth 把焦點放喺量化後仍盡量保持原模型表現,並提到改良了 DeepSeek-V4 的 chat jinja template,經過超過 4000 段對話測試後,效果與官方 baseline 等效。對使用者來說,呢點比單看可唔可以載入更重要,因為同一個模型換咗模板後,回答風格、工具調用格式甚至思考開關行為都可能出現明顯差異。

檔案資訊方面,頁面清楚列出 UD-Q8_K_XL 屬於 full precision lossless 的建議選項,大小約 162GB,而且只比 Q4 的 UD-Q4_K_XL 大 7GB。描述亦提到 3-bit 可喺 110GB Mac、RAM 或 VRAM 配置運行,full precision lossless 則需要大約 168GB RAM;不過目前提供內容未見完整 GGUF 檔名清單、各量化級別大小、mmproj 附加檔案或上下文長度細節,因此無法逐一確認。

  • 已確認 base model 是 deepseek-ai/DeepSeek-V4-Flash
  • 建議使用最新 llama.cpp 或 Unsloth Studio
  • UD-Q8_K_XL 約 162GB,主打 lossless
  • 3-bit 版本可面向約 110GB 記憶體配置
  • chat template 經 4000+ 對話測試,目標貼近官方 baseline

同類模型比較上,呢個項目的差異不在重新訓練,而在於 GGUF 量化封裝、Unsloth Dynamic 2.0 量化方法,以及對 DeepSeek-V4 對話模板的修正。頁面提到 Unsloth Dynamic 2.0 準確度優於其他主流 quants,但未附上完整對比分數; v2 更新內容、檔名變更、MTP draft speculation 支援、Ollama 與 LM Studio 的具體載入方式,現有資料只足以確認支援方向,未足以逐項下定論。

項目主頁 · 模型

Categories: 開源, 模型, DeepSeek, Mac, Ollama

oMLX:把 Mac 變成本地 LLM 控制台

oMLX 針對 Mac 本地 LLM 部署而設,重點不是模型本身,而是讓快取、載入與切換更省心。

oMLX

oMLX 是一個針對 Apple Silicon 的本地 LLM 推理工具,也是帶有圖形介面與 CLI 的伺服器管理項目。它主要解決的不是「能不能跑模型」,而是怎樣在 Mac 上較穩定地管理多個模型、保留 KV cache,並減少重複計算帶來的等待時間。

這個項目的取向很明確:用選單列介面處理常見操作,再配合終端機與 Apple Shortcuts 控制同一個服務。安裝路線亦相當直接,macOS 用戶可透過 .dmg 安裝,另有 Homebrew 方式;日志位置、背景服務與 CLI shim 都已交代,對需要長時間開著本地模型的人較友善。

Finally, The CORRECT Way to Run Local AI on a Mac

它和一般本地 LLM server 的差異,在於分層 KV cache 設計。oMLX 把常用內容留在 RAM 的 hot tier,不夠位時再轉去 SSD 的 cold tier,並以 safetensors 格式保存;即使伺服器重啟,遇到相同前綴內容仍可重用快取,這對長對話、編程輔助和工具調用尤其有價值。

只需點擊一下,即可直接從管理面板設定 OpenClaw、OpenCode、Codex、Hermes Agent、Copilot 和 Pi。無需手動編輯配置。

  • 支援 hot tier(RAM)與 cold tier(SSD)分層快取
  • 可自動以 LRU 方式卸載較少使用的模型
  • 管理介面可手動 load/unload 模型
  • 提供選單列操作、CLI 與 Apple Shortcuts 整合
  • 適合需要長上下文與多模型切換的 Mac 工作流程

現有資訊提到 continuous batching、context limits 與基準測試頁面,但 README 片段未列出具體數字,所以性能判斷宜保持審慎。可確定的是,它較適合在本地做持續開發、配合 Claude Code 一類工具,並集中管理「常駐小模型+按需切換大模型」的團隊或個人環境;相關模型方面,內容明確提到 everyday models、heavier models,以及可選的 GLM-5.2、MiniMax M3 原生 custom kernels 支援。

GitHub

Categories: 開源, Agentic, 模型, 框架, Mac, 蘋果

NeuraDock Agent:把 7 通道 EEG 變成可用狀態訊號

這不是一般腦波展示工具,而是把7通道EEG整理成可供應用程式使用的即時狀態。它重點不在生成炫技介面,而在穩定解析、質量把關與本地處理。

Repository image for Neuradock/eeg-workstation-agent

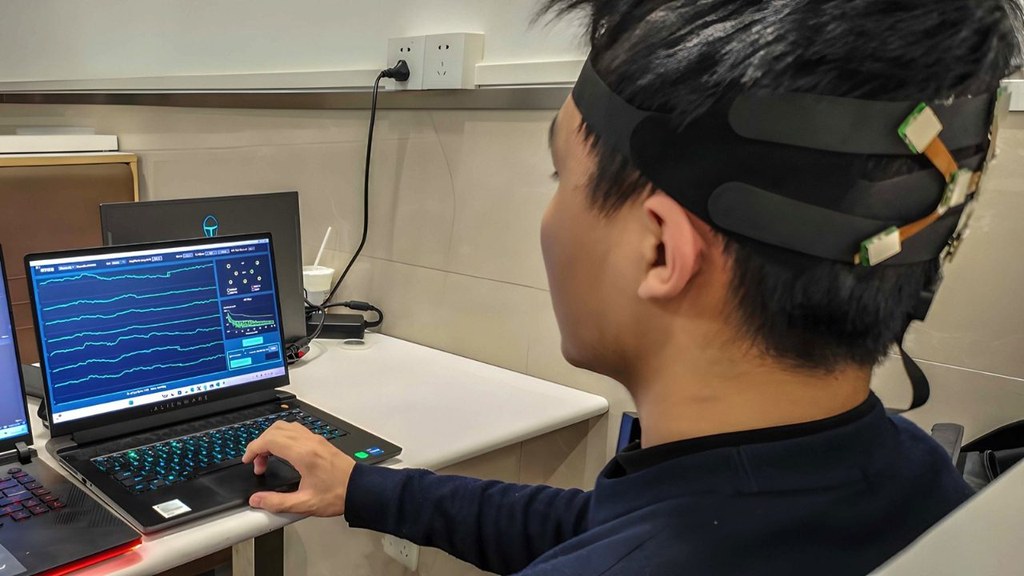
NeuraDock/eeg-workstation-agent 是一個本地優先的 Python 工具項目,也可視為面向應用整合的 EEG agent。它主要將 NeuraDock EEG Workstation 的 7 通道腦電訊號,轉成經過質量檢查的 visual cognitive-load 狀態,讓介面、XR、車載 HMI 或互動系統可以即時讀取,而不必直接處理原始 EEG。

現有不少 EEG 流程會把重心放在原始波形顯示、離線分析,或讓開發者自行拼接 preprocessing、quality control 與特徵提取;作者在技術文件中明確反對讓通用 LLM 直接對感測結果作自由解讀的做法。這個項目的取向,是把 deterministic local EEG engine 與 hardware-aware language layer 分開:前者負責解析、前處理、spectral workflows 與 machine-readable artifacts,後者只接收 allowlisted summary 與 versioned context pack,避免模型對 7-channel EEG 說出超出量測邊界的結論。

NeuraDock EEG Agent Workflow

部署路線算清晰。儲存庫列出 Python 版本範圍、支援 Windows、macOS、Linux,亦提供無硬件 synthetic replay,所以就算未買 NeuraDock EEG Workstation,也可以先啟動本地 dashboard 與 API,檢查 GET /api/status 會輸出哪些欄位;真正連接裝置時,Agent 會經 TCP 收流、做 online preprocessing,再輸出如 visual_load_indexalpha_peak_hzalpha_suppression_from_baselinequality.status 等狀態。示例資料要到另一個資料儲存庫下載,這裡沒有直接附上人類 EEG 數據,反映作者對資料安全與分發邊界相當保守。

和同類做法相比,它的差異不在「能否分析 EEG」,而在於它刻意收窄可宣稱的範圍。這套工具聚焦 posterior Alpha dynamics、within-subject Rest/Task visual cognitive-load comparison,以及 quality-gated adaptation,並清楚說明它不是 medical device,亦不能直接診斷 attention、fatigue、impairment 或跨個體比較表現。這種取捨令它的野心比一些泛用腦機介面平台細,但換來較可控的輸出與較低的誤讀風險。

  • 定位明確:屬於本地執行的 EEG 分析工具項目,重點是把 7 通道訊號轉成應用可讀狀態。
  • 測試門檻較低:有 synthetic replay,未接硬件都可以先驗證 dashboard、API 與流程。
  • 邊界控制做得細:LLM 不接觸 raw EEG 與 dense time-series arrays,只接收精簡指標與受控上下文。
  • 適合即時互動場景:視覺搜尋、adaptive vehicle HMI、cognitive load game 都是直接示範。
  • 資料解讀有限制:結果偏向個體內比較,不適合把不同人的 workload 分數直接放在同一把尺上。

性能描述方面,技術報告提供了幾個辨識度很高的訊號。其一,12 份錄音在十次 numerical repetitions 下得到相同 structured results,完整 Rest/Task 執行在三次重跑下亦產生相同 result、report 與 figure hashes,說明 deterministic pipeline 不是口號。其二,作者做了 request-capture 與 failure-injection experiments,檢查資料邊界與本地 artifacts 在 HTTP、格式錯誤及連線失敗下是否仍能保留。其三,boundary-awareness benchmark 涵蓋 ordinary 與 adversarial questions,並結合 qwen3.7-max 和 kimi-k2.6 生成輸出;這部分重點不是比較哪個模型最聰明,而是檢查語言層有沒有超越硬件與工作流容許的解釋範圍。

相關模型與組件方面,README 沒有把核心 EEG 推理包裝成 foundation model,而是以 reviewed workflows 為中心;可見的外部模型主要是 optional LLM mode 會用到的 LLM,例如 qwen3.7-max、kimi-k2.6。適合受益的人,包括做 HCI、XR、遊戲互動、復健訓練、工業監測與研究原型的團隊;他們想要的通常不是一套醫療級診斷系統,而是一個可以穩定輸出、容易接入前端或控制邏輯、又盡量把資料留在本機的腦訊號工具鏈。

項目主頁 · GitHub · Paper

Categories: Agentic, Qwen, API, 框架, Medical醫學, Mac, Linux, Python

Apple container:Mac 原生容器新選擇

Apple 推出的 container 不是另一個包裝層,而是針對 Apple silicon 與 macOS 26 的原生容器工具。它適合想在 Mac 上跑 Linux 容器、又重視輕量與兼容性的人。

Containerization logo

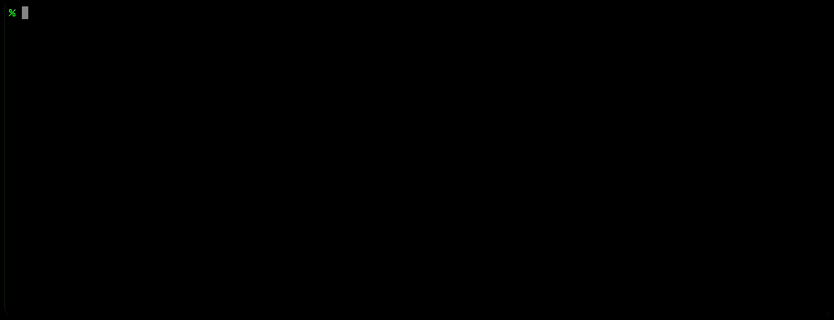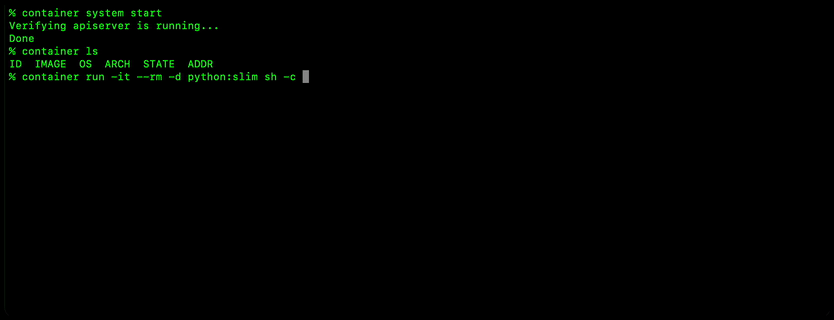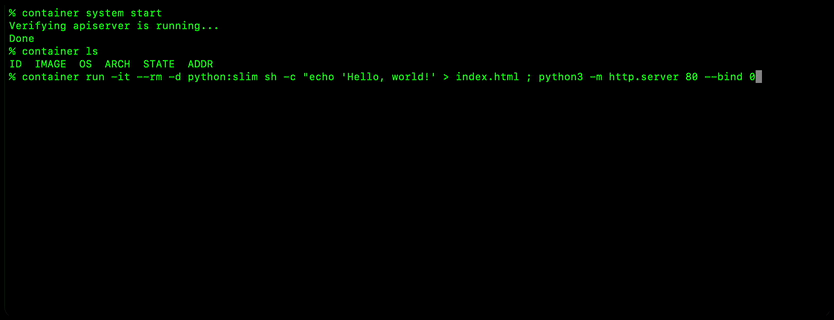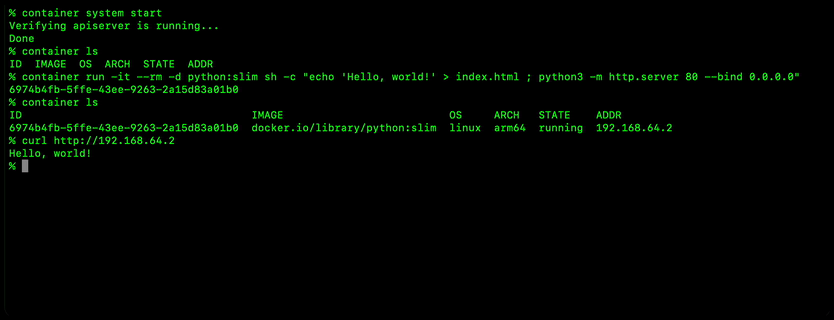
container 是一個工具,用來在 Mac 上建立及執行 Linux containers,做法更接近把容器當成輕量虛擬機處理;它要解決的,是 Mac 開發者在本機跑 Linux 工作負載時,如何兼顧隔離、速度與 OCI 相容性。

這個項目最明顯的取向,是 Apple 自己用 Swift 編寫,並且針對 Apple silicon 優化,同時依賴 Containerization 這個 Swift package 處理較底層的 container、image 與 process 管理。跟不少人熟悉的 Docker Desktop 或其他 Mac 容器方案相比,它不是強調整合一大堆開發配套,而是集中做好原生執行、標準映像相容,以及 Apple 平台能力。

安裝不算複雜:官方提供已簽署的安裝包,裝好後要啟動 system service,並且整個項目只支援 Apple silicon 與 macOS 26。這代表門檻很清楚:如果你仍在舊版 macOS,或者團隊有 Intel Mac,這個項目暫時就不會是通用解法。

Apple Just Built WSL for the Mac (Container Machines)
它支援讀寫 OCI-compatible container images,所以可以從標準 container registry 拉取映像、建立映像,再推回其他 OCI-compatible application 可用的環境。對開發團隊來說,這點很重要,因為它不是把流程鎖死在 Apple 自家格式,而是保留與現有容器生態互通。

  • 針對 Apple siliconmacOS 26,平台限制明確
  • 支援 OCI-compatible container images,可接標準 registry
  • 底層建基於 Containerization,偏向原生與輕量路線
  • 較適合 Mac 開發、測試、映像建置,不是全功能平台替代品

效能方面,暫時沒有提供完整官方基準數字,但外部已有文章把它放到 Docker Desktop、OrbStack 一類方案旁邊看 CPU、記憶體、啟動時間與 I/O。即使未能單靠儲存庫內容下定論,仍可合理判斷:Apple 想做的不是「功能最多」,而是在自家硬件上提供更貼近系統能力的容器執行方式。較受惠的會是以 Mac 為主要開發機、需要 OCI 相容流程、又願意接受新平台限制的工程團隊。

這個項目不是 AI 模型;若要說相關技術組件,主要是 OCI-compatible container imagesContainerization

GitHub: https://github.com/apple/container

項目: https://developer.apple.com/videos/play/wwdc2026/389/

Categories: 開源, 工具, Mac, Linux, , 蘋果

MiniMax Hub:本機優先的多模態創作工作站

MiniMax Hub把文案、影像、影片與配音流程放進同一個創作畫布。重點是本機優先,素材可留在自己電腦。

MiniMax Hub

MiniMax Hub 是一個 Multimodal Creative Agent,定位像 AI 創作工作站,不只是聊天工具。它把 Copy Generation、Image Creation、Video Editing、Audio & Voiceover、Auto Packaging 與 Multi-format Export 整合在同一個流程,讓用家由想法到成片可在一處完成。

它支援 macOS 與 Windows 下載,輸入簡報、文字想法,或直接加入本機素材後,主代理會先理解創作目標,再做 Smart task decomposition,之後交由多個 agents 並行處理文案、視覺與音訊。用家仍可手動選模型,亦會在關鍵節點收到確認,避免流程完全黑箱。

這個項目在於把創作流程保存成可重用的 Skills。系統會隨工作過程累積你的做法與風格,之後可重複套用;如果需要,也可從 MiniMax Skills Market 啟用現成 Skills 或外掛。對經常製作短劇、電商內容、品牌 TVC 與廣告素材的團隊來說,這類流程重用能力相當實用。

  • 本機優先設計,頁面明確指出 local files stay on your machine
  • 單一畫布整合腳本、分鏡、影片、音樂與剪輯流程
  • 支援資產管理與 batch generation,可一次產出多個版本
  • 代理會自動分解任務,並在關鍵步驟要求人工確認
  • 可把工作流程沉澱成 Skills,逐步累積個人或團隊方法

MiniMax Hub較著重工作流編排與創作協作,而不是單一模型能力展示。網站未列出具體性能分數或公開評測結果,因此較適合把它理解為面向內容製作的本地化 AI 工具平台。文中未提供明確模型清單,只提到會自動匹配最合適模型。

項目: https://hub.minimax.io/

Categories: Agentic, AI productions, 模型, 視覺模型, 多模態模型, 視頻模型, Video, Image, Audio, 軟件, Mac, 語音, Win, 音樂, Skill 技能

VisualClaw:會進化的視覺代理

VisualClaw 不只是接駁模型的工具,還把記憶、技能與影片處理串成可持續改良的代理系統。

VisualClaw icon

現時不少 vision-language agents 主要靠固定提示、整段影片送入模型,或者一次性工具調用去完成任務;作者認為這種 fixed scaffold 容易令延遲、成本同提示長度一齊上升,而且部署後幾乎唔會自己累積經驗。VisualClaw 因而提出一個 modular multimodal agent system,夾在 Claude Code、Codex、OpenClaw 同上游 LLM providers 之間,加入 retrieved memory、skill bank、self-evolution、video processing 同 evaluation hooks。

這個項目屬於框架兼工具型基建,重點唔係再訓練一個新模型,而係幫 Computer-use agents、tool-using vision-language agents 更有效處理影片、工作空間同多輪任務。配套的 VisualClawArena 則是獨立 benchmark/data release,收錄 200 個 scenario,要求代理真正在 workspace 內用影片證據、文件、動態更新與 executable checks 解題,補回一般 video-QA benchmark 對工具使用情境測試不足的缺口。

把它當成 gateway proxy,用熟悉的 OpenAI 或 Anthropic 相容介面接到現有 agent workflow,再逐步打開 skills、memory、video cascade 等模組。對已經在用 Claude Code 或 Codex 的團隊,這種接法尤其實用,因為毋須由零重寫整個代理流程。

  • 核心結構清楚:gateway design 加上 pre/post hooks,方便在提示前後插入技能、記憶與評測。
  • 創新位具體:以 hybrid encoding 處理 streaming video,配合 cascaded gate、keyframe context、hot/cold top-k injection,目標是壓低成本而保留關鍵視覺證據。
  • 會累積經驗:self-evolution 會根據失敗回合與成功記憶更新 skill bank,唔係每次都由同一套靜態提示開始。
  • 評測唔只看答對:VisualClawArena 把多輪問題、影片、workspace 操作同評估輸出綁埋一齊,更接近真實代理任務。

在 4 個 video-QA benchmarks、2 個 VLMs(Gemini 3 Flash、GPT-5.2)上,VisualClaw 對 full-frame upload 的每題 API 成本平均可減 98%,相對 offline uniform 8 frame baseline 亦再降 25.9%,同時多數設定下準確率有提升。到 VisualClawArena,配合 Codex(GPT-5.5)與 Claude Code(Sonnet 4.6)等 backend,macro accuracy 分別提升 2.9% 同 3.2%;如果你關心的是可插拔代理基建、多模態工作流,或者想為 live vision 與影片任務加上可持續進化能力,這個項目比單純模型包裝器更有研究同落地價值。

GitHub: https://github.com/UCSC-VLAA/VisualClaw

項目: https://ucsc-vlaa.github.io/VisualClaw/

Categories: 開源, 清華大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, OpenAI, Gemini, API, Video, 框架, Vibe Coding, 工具, IDE, Mac, 編程, OpenClaw, Anthropic, Skill 技能

Page 3 of 4
1 2 3 4