UrbanGround 開源:真實香港城市級 3D 沙盒多模態智能體

UrbanGround 是一個以香港全境 3D 地理數據搭建的城市級模擬環境,可直接用第一人稱遊玩,亦可讓 MLLM 智能體透過程式介面操作同一個世界。

UrbanGround: From Local Perception to Spatial Agency in a Real-Scale City

UrbanGround 由一個學術團隊在 GitHub 上開源,整個項目的野心在於把「真實城市規模」這件事帶進多模態智能體(Multimodal Large Language Model, MLLM)的研究裡。它以香港的 3D Visualisation Map 為底層地理數據,搭配 Unity 場景提供第一人稱連續移動、碰撞與日夜、天氣、行人等動態變化,使用者可以直接以 WASD 鍵盤操作在城市裡行走、爬樓梯、找地點、切換視角,亦可以交由 AI 智能體透過程式介面(HTTP API)取得 RGB 觀察、物理動作與地圖資訊,自行決策。
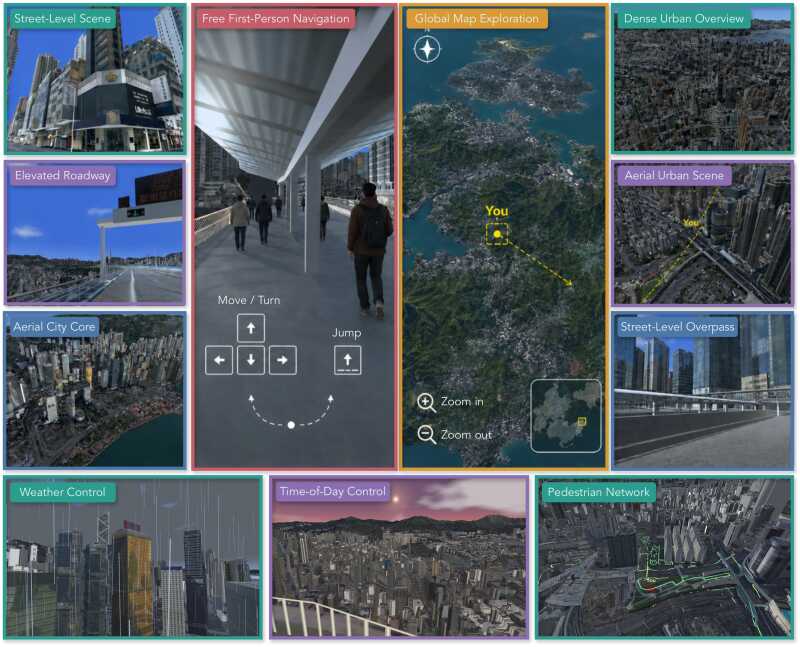
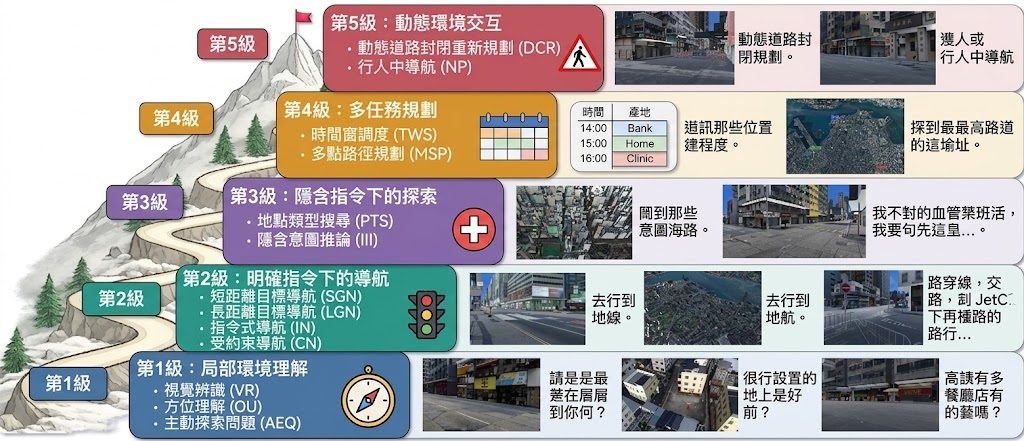
這個環境和過往以小型合成場景或封閉遊戲引擎為主的做法相比,核心差異在於「規模」與「真實地理閉環」:智能體看到的不是抽象方塊,而是一座真實城市的街道、樓宇、地形,並且觀察、動作、地圖三者來自同一個介面,方便研究者設計貼近真實導航、空間感知與任務規劃的測試。整個項目同時釋出網頁版、macOS、Windows 與 Linux 原生版本,並附上多個由五個能力層級組成的評測任務,供 MLLM 在感知與行動兩端做系統性比較。

對研究 MLLM 空間智能、城市導航或數字孿生的團隊來說,UrbanGround 提供了一個比手工搭建的小場景更貼近現實的測試場;對一般玩家或開發者而言,它也是一個能在瀏覽器直接探索香港街景的實驗性沙盒。需要留意的是,網頁版首次載入完整 Unity 場景在繁忙時段或慢速網絡下需時約 3 至 5 分鐘,作者建議從 GitHub 下載並在本地網絡提供 tile 數據以加快速度。目前場景仍有「模糊或不完整幾何」以及「車輛與行人種類有限」等已知限制,相關修正在路線圖中。

重點摘要:

  • 真實城市規模:以香港全境 3D 地理數據驅動,非抽象小型合成場景。
  • 雙操作介面:第一人稱玩家與 MLLM 智能體共享同一套 RGB 觀察與動作 API。
  • 跨平台發佈:提供網頁版與 macOS、Windows、Linux 原生應用。
  • 結構化評測:內建多層級任務,用於量度多模態智能體在感知與行動上的能力。
  • 已知限制:場景幾何仍有缺損,車輛與行人種類待擴充。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 多模態模型, API, 香港, Mac, 3D, Linux, Dataset 數據集

VoxEMW:把 Mac 變成 1.3 秒回應的私人語音助手

VoxEMW 將語音處理放在 Apple Silicon Mac,手機只需透過瀏覽器或 iOS 客戶端對話,回應速度與音色克隆是最大賣點。

Repository image for emwstudio/VoxEMW

對住手機講完一句話,約 1.3 秒後便聽到固定角色用克隆聲線回答,VoxEMW 屬於開源語音助手項目,處理判停、轉寫、對話調度及語音合成,解決語音對話延遲高、角色聲線難以保持的問題。Mac 負責主要語音管線,只有 LLM 大腦經 DeepSeek API 上雲,日常成本相對可控。

整套流程由 Silero 加 SmartTurn 負責判斷何時真正講完,Qwen3-ASR-0.6B-hf 在 MPS 上轉寫,再由 DeepSeek v4-flash 產生回覆,Qwen3-TTS-1.7B-Base 以 MLX 6bit 執行零樣本音色克隆。參考聲音配合逐字台詞便可註冊角色,首段聲音約 0.5 秒生成;中途打斷時,已播放及已聽內容會寫回上下文,對話較不容易斷層。

一块 4090 跑通 AI 视频通话全栈:Qwen3.8-27B 本地部署,对话时延 2 秒

項目需要 Apple Silicon Mac 作本地伺服器,實測以 M5、16GB 記憶體可以流暢運行,模型及環境約需下載 4GB。瀏覽器可直接連接本機介面;iPhone 或 iPad 則要透過局域網 HTTPS/WSS 連線,並自行處理 TLS 證書、Xcode 簽署及免費帳戶七日側載限制。

• 回應最快 1.26 秒,中位數約 1.6 秒,實際速度仍受網絡及 API 影響
• VAD、STT、TTS 留在本機,DeepSeek API 按 token 收費
• 支援流式字幕、空回覆重試及語音中斷後續接
• 全屏星空會隨說話及聲波變化,增加角色互動感

相比全程雲端方案,VoxEMW 減少語音資料離開家中 Mac,但需要一部 Apple Silicon Mac 長期運行;相比完全離線方案,DeepSeek API 帶來額外費用及資料傳輸考慮。適合想建立固定聲線角色、研究低延遲語音管線,或有 Mac 作家庭伺服器的開發者,普通使用者則要先接受證書、模型環境及 API 金鑰設定等門檻。

GitHub

Categories: 開源, 文字轉語音, Qwen, DeepSeek, API, 框架, Mac, 語音, 蘋果

Tencent UI-Mate 桌面操作示範變成可重用工作流

開源權重的通用 GUI 智能體:環境驅動訓練 + 上下文演示學習——流程演示一次即可,不必把所有約定寫進提示。

UI Mate icon

很多桌面任務難寫成一段完整提示,問題不在指令太短,而是在檔名規則、視窗擺位、公司流程這些細節往往靠示範更容易講清。UI-Mate 就是朝這個位置切入的開源 GUI agent 項目:它在原生桌面看螢幕畫面,用鍵盤和滑鼠跨應用程式執行長流程工作,並且支援把一次人手操作示範轉成可重用工作流。

UI-Mate 把示範當成建議。當畫面內容、資料、視窗狀態或任務目標有變化,代理仍會按即時畫面重新判斷,避免變成只懂重播錄製腳本的 Computer-use agents(CUAs)。這個取捨很重要,因為它直接回應了 GUI 自動化最常見的失敗位:流程相似,但畫面從來不會完全一樣。

訓練方法亦反映它想處理真實環境,而不只是跑單一 benchmark。項目提到 closed-loop data engine,會串連任務合成、環境建構、rollout、驗證與 filtering,再用 capability tree 補回覆蓋不足的能力;同時支援 Ubuntu、Windows 和 macOS 的統一 rollout layer,並以 asynchronous group-relative optimization 處理長而且變化大的 rollout。整體方向很清晰:先把可執行環境和驗證機制搭好,再談代理怎樣學會跨系統做事。

公開結果亦有參考價值。UI-Mate 在 OSWorld-Verified 達到 77.0%,WindowsAgentArena 為 66.2%,而 OSWorkerBench 嚴格成功率 41.0%、progress 76.9%;加入一次 same-task demonstration 後,OSWorker self-demo strict success 由 17.2% 升到 35.4%。這些數字未必代表它已經能穩定接手所有桌面工作,但至少說明示範式引導不只是概念包裝,對長流程任務有明顯幫助。

  • 屬於開源 GUI agent 項目,重點是處理跨應用、跨作業系統的長流程桌面任務
  • 核心差異在於支援 in-context demonstrations,把一次示範整理成可重用工作流
  • 示範不是腳本重播,代理會按 live screenshot 即場重新規劃
  • 較適合需要固定流程但畫面與資料經常變動的團隊、營運與辦公自動化場景
  • 目前已公開模型與結果,但 OSWorkerBench 等配套仍有部分內容標示為 Coming Soon

部署與理解方式上,現有資料較接近研究原型加可試權重,而不是開箱即用的完整產品。官方已放出 code、weights、technical report 和 Try App,較合理的看法是先把它當成可驗證 demonstration-guided GUI agent 能力的開源基線,再看後續 benchmark、資料集與工具鏈是否補齊。對研究 GUI agent、企業桌面自動化,或者想比較文字指令與示範引導差異的團隊,這個項目很值得跟進。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, 模型, Mac, Linux, Dataset 數據集, UI/UX

VoxWeave:Windows 本機 RVC 變聲工作站

把音頻、影片、麥克風同批次任務收在同一個桌面工作站,VoxWeave 走的是本機離線處理路線。它重點解決變聲流程分散、結果難追蹤,同時保留即時變聲與批量轉換。

VoxWeave

VoxWeave 是一套面向 Windows 的 RVC(Retrieval-based Voice Conversion)變聲工作站,定位很清楚:把離線轉換、即時麥克風變聲、批量處理和結果追蹤放進同一個桌面流程。它適合要穩定處理音頻、歌曲或影片音軌的人,也適合需要交付產物、查看失敗原因和保存位置的工作場景。

使用方式偏向本機部署而不是雲端服務。EXE 不內置大體積環境或模型,首次使用可在介面內按需下載經哈希校驗的運行組件與推薦模型;來源倉庫也保留 Linux 和 macOS 的邊界,但目前真機驗收集中在 Windows 11 與 NVIDIA CUDA。

它和常見變聲工具最大的分別,在於把狀態、任務、批量規則、即時會話、產物與歸檔都收進 SQLite 作為單一真源,連診斷匯出都會帶上運行時、模型和日誌清單。這種做法讓問題排查和重試更直接,但代價是它明確不提供虛擬聲卡、模型訓練或 GPT-SoVITS,定位比完整聲音工坊收得更窄。

  • 支援音頻、影片、資料夾和麥克風輸入,流程集中。
  • 可做離線轉換、即時變聲與批量處理,結果可追蹤。
  • 模型按原路徑登記,會計算權重和索引的 SHA-256,不會複製或改名。
  • URL 模型需要提供來源、最終大小和 SHA-256,授權不明時會明確標示。
  • 目標較適合 Windows 本機使用者、內容製作流程,和需要留存產物與錯誤記錄的團隊。

GitHub

Categories: 開源, AI productions, NVIDIA, Mac, Linux, 語音, Win

Grok Bot 登場:xAI 推出常駐 AI 同事,能自主操作電腦完成任務

Grok Bot 就像一隊永不登出的 AI 隊友,能登入你的軟件代勞長時間任務,從銷售外聯到支援工單都接力完成。

Og image

xAI 最新推出的 Grok Bot,把「Computer-use agents(CUAs)」這個概念包裝成一支可以分工的虛擬團隊。它擁有自己獨立運行的電腦環境,能像真人般登入 Zendesk 等 SaaS 工具、瀏覽網頁、操作軟件介面,並在背景 24 小時不中斷地接力完成任務。對需要處理大量例行工序的小團隊或一人公司來說,這類 agent 最直接的價值是把「等人按掣」的等待時間壓縮到接近零。

Grok Bot 強調幾個工作流設計:你可以同時叫多個 Bot 進入同一個對話串,分頭負責研究、公關、差旅等不同環節,Bot 之間會自行交接工作;只要你親自示範一次流程,它就能把步驟記成「routine」自動重複執行,並隨時間累積記憶,例如記下某客戶只簽年約、誰是決策人。對需要批量生成銷售名單、處理支援工單或長期追蹤項目進度的使用者而言,這種「邊做邊學」的能力比單純的 prompt 工具更貼近實際工作節奏。

定價方面,Grok Bot 綁定在 Cursor Ultra 月費 200 美元的方案內,包含其專屬電腦環境、跨裝置使用與排程執行;團隊版則額外提供 SSO 與共享用量分析。xAI 將其定位為企業 SaaS 的入口代理,但實際上能否取代 ClickUp、HubSpot 等內建自動化,仍要視乎它對接工具的覆蓋率與執行成功率。

重點摘要

  • 擁有獨立電腦,能像人類登入並操作 SaaS 工具完成長時間任務
  • 支援多 Bot 協作,在同一對話串內自行分工與交接
  • 用戶示範一次流程後,Bot 可記為 routine 自動重複執行
  • 隨時間累積記憶,保留客戶偏好、決策人等脈絡
  • 透過 Cursor Ultra(200 美元/月)方案提供,團隊版含 SSO 與共享分析

項目主頁

Categories: Agentic, API, 工具, 線上服務, IDE, Mac, 免費試用

Ouroboros 把 AI 代理變成「自我演化」

它不只會接任務,還會記住自己做過什麼,甚至改寫自己。對想長期運行 AI agent 的團隊,呢種設計幾有吸引力。

Terminal-Bench 2.1: Ouroboros against Claude Code, Codex CLI, Cursor CLI, and Hermes on matched models, with a same-harn

一次性完成指令的 AI agent 已經不少見,但能夠跨任務、跨重啟保留身份、記憶同歷史,仲可以持續修改自己運行方式的並不多。Ouroboros 屬於開源通用型 AI agent,處理的是長週期工作會斷線、失憶,同埋難以持續改進代理本身的問題。

它不是單純能開多個 specialist agents,而是保留「同一個負責任主體」去協調研究、建構、驗證同審查。呢種做法對外部程式碼項目、需要長時間追蹤證據的工作流特別有用;代價是系統野心很大,對使用者來說亦意味要接受一個會動到自身程式碼、prompt、tools 甚至 dependencies 的代理。

Ouroboros 可當原生桌面程式使用,也可走 headless CLI,Windows x64 同多種 Linux 發行版都有發佈版本。執行期會把 repository、durable memory、history 同介面留在本機,模型推理則可接駁你自行設定的遠端 API,或者用本地 GGUF 模型,對想保留資料控制權的人較有吸引力。

  • 開源通用型 AI agent,重點在持續身份、durable memory 與自我修改
  • 可協調一組 specialist agents,但最終責任仍由單一 root agent 承擔
  • 支援桌面 app 與 CLI,適合長時間運行或接手外部程式碼項目
  • 本機保存記憶與歷史,模型可用遠端 API 或本地 GGUF 格式在本地執行推理
  • 官方列出 Terminal-Bench 2.1、OSWorld-Verified、CL-Bench 的 self-reported 成績

Ouroboros 公開了在 Terminal-Bench 2.1、OSWorld-Verified 同 CL-Bench 的 self-reported 結果,並以 matched model 或公開排行榜對照 Codex、Claude Code、Cursor、Hermes。呢類數字有參考價值,但仍要留意它屬自報結果;較可取的是,項目同時強調 traces、evidence 同可重現性,顯示它想把重點放在可檢查的過程,而不只是最終分數。

整體來看,Ouroboros 適合研究型開發者、想建立長記憶 agent 的團隊,以至需要代理長期接手軟件工作流的人。它吸引人的地方在於把 agent 由「一次性助手」推向「可延續個體」,但同時也把風險一併帶進來:自我演化愈強,愈需要清楚邊界、驗證流程同責任歸屬。

項目主頁 · GitHub

Categories: 開源, Agentic, API, IDE, Mac, Linux, Dataset 數據集

free-claude-code:一個代理層打通 Claude Code 與 Codex

想保留原生開發代理體驗,又想自由換模型與供應商,free-claude-code 正正補上這個缺口。它把 Claude Code、Codex 同 Pi 接到同一個可管理入口。

用開 Claude Code 或 Codex 的人,最在意通常唔係再裝多一個聊天介面,而係可否繼續用原生 model picker、串流回應、tool use 同 image input,同時改用自己揀的模型供應商。free-claude-code 就係一個 proxy 工具,把 Claude Code、Codex、Pi 及其 IDE 擴充功能接到自管入口,處理多供應商切換同路由分發。

它的價值在於工作流幾乎唔使重學。你可以照用 fcc-claude、fcc-codex 或 fcc-pi 啟動對應代理,Windows 同 macOS 亦可放在背景執行,再到本地 Admin UI 揀選並驗證供應商。可在 31 個 cloud 與本地 providers 之間切換,亦可把 Fable、Opus、Sonnet、Haiku 同 fallback 流量分別導向不同模型,這點對想控制成本、速度同能力分工的團隊幾實用。

跟直接綁死單一 API 的做法相比,這個項目押注在「保留原生客戶端體驗,再用 proxy 抽換後端」。代價是相容性要靠代理層維持,所以它明確強調只會在兼容模型上保留 streaming、tool use、reasoning 同 image input;換句話說,模型可揀得更自由,但不是每個後端都保證功能完全一致。

  • 支援 Claude Code、Codex、Pi,同時保留各自原生 model picker
  • 透過本地 Admin UI 管理與驗證 31 個 cloud/本地 providers
  • 可把不同流量類型分流到不同模型,方便平衡成本與能力
  • 適合想用本地模型、付費模型或免費模型混搭的開發團隊

安裝與測試方式偏向開發者工具鏈:項目以 Python 3.14、uv、Pytest、Ruff、Ty 組成,部署重點不是雲端託管,而是先在本機跑起 proxy,再讓代理客戶端經它連線。現階段最適合已經在用 Claude Code 或 Codex、又想統一管理模型入口的人;追求零設定即用的讀者,會覺得它比較像一層需要自己維護的基建。

GitHub

Categories: 開源, NVIDIA, API, Image, 工具, IDE, Mac, Python, 編程, Anthropic, UI/UX

LFM2.5-2.6B:細模型做得到本地 Agent

LiquidAI 把 2.6B 模型做成可離線執行的 Agent 核心,重點是工具調用同多步任務。它更像一個為裝置端而設的工作模型,而唔係只追求聊天流暢度。

Og image

LFM2.5-2.6B 屬於經過後訓練的語言模型,基礎模型是 LFM2.5-2.6B,並非頁面再細分成其他來源模型。它的定位很清楚:在筆電、手機呢類裝置上處理工具調用、網頁搜尋同多步工作流程,盡量將推理留喺本地,減少資料外傳同雲端成本。

模型先經過約 34T tokens 的 pre-training,再用 mid-training 將上下文擴到 128K。之後以四階段後訓練把 base model 變成 agent,包括兩輪 SFT、按領域訓練 teacher、MOPD(Multi-domain on-policy distillation)同 Agentic RL(Agentic Reinforcement Learning)。頁面亦提到它在常見 agentic harness 內做過強化學習,目的係提升同工具框架的兼容度。

重點放在 GGUF 格式、mmproj 及量化版本,但目前提供的內容未列出完整檔名與各自大小,所以無法可靠列出每個檔案細節。作者建議由 Q4_K_M 作為起點,再按記憶體同速度需求向上或向下選擇;頁面同時指出它可以配合 llama.cpp、Ollama 同 LM Studio 使用。

它在 Apple M5 Max 可達 220 tok/s,在 AMD Ryzen CPU 上可達 113 tok/s,而且記憶體需求低於 2.5 GB。不過,模型亦有清楚限制:它主要強在 agent 任務同工具使用,並唔代表所有通用推理場景都會贏過更大的模型;進階用法可配合 MTP draft speculation,但頁面未提供足夠細節去判斷其實際收益幅度。

  • 約 34T tokens 預訓練,後續再做 agent 導向微調
  • 上下文窗擴到 128K,適合較長任務鏈
  • Q4_K_M 可作為量化起點,兼顧體積同速度
  • 支援 llama.cpp、Ollama、LM Studio
  • 設計重點係本地工具調用、多步 workflow,同私隱優先

項目主頁 · 模型

Categories: 模型, 教學, Mac, LLaMa, Ollama

Reasonix:DeepSeek AI 編碼 agent,用 cache-first 降低長會話嘅 token 成本

Reasonix 係 DeepSeek 嘅終端 AI coding agent,以 cache-first loop 壓低長會話嘅 token 成本,適合反覆改碼、工具呼叫同團隊迭代。支援 CLI/TUI、桌面、Web UI 同 ACP 編輯器整合,配合 /plan、MCP 同 sandbox 權限控制。

Reasonix

Reasonix 是 DeepSeek 一個面向桌面及終端的 AI coding agent,核心價值唔係花巧介面,而係將長會話裡不斷累積的上下文成本壓低。它適合要一路改檔、一路試工具、一路追問模型的人,特別是團隊日常做修補、重構同埋持續迭代時,對 token 成本同回合延遲都會有明顯感受。

Reasonix 主打 cache-first loop,令 prompt 前綴保持 byte-identical,配合 DeepSeek 的 prefix cache 去提升長會話命中率。項目同時提供 CLI/TUI、桌面端、local browser UI,同埋支援 ACP-compatible editor integration,部署方式亦算直接:CLI 可用 npm 安裝,桌面版則有 macOS、Windows、Linux 套件可選。

Deepseek's ~OFFICIAL Code: RIP Claude,Codex! This is CRAZY GOOD!

Reasonix 唔係純粹包住模型嘅殼,而係圍繞工具呼叫修正、成本控制同 sandbox 權限去設計。/plan 會先要求模型規劃,再進入實作;MCP(Model Context Protocol, MCP)亦作為一等入口,方便把外部工具合入同一個 registry。這種做法較適合重視可控性、可追蹤性,亦需要長時間跑 session 的開發流程。

要留意嘅係,呢條 TypeScript 線已經進入 maintenance mode,主力開發搬去 Go rewrite,同步文件亦指向 main-v2 同 migration guide。現時更合理嘅理解方式,係將佢視為一個仍可用但已凍結方向的終端編碼 agent 版本,重點價值在 cache 效率、工具整合與成本壓縮,而唔係追求最新功能擴張。

  • 長會話下,prefix cache 命中率可維持在 90%+,輸入 token 成本可明顯下降
  • 同一套引擎可喺 CLI/TUI、桌面端、Web UI 同編輯器接入使用
  • /plan、權限控制同 workspace sandbox 一齊限制工具呼叫,取向偏向可控
  • 適合經常改碼、反覆驗證、又在意推理成本嘅個人或團隊

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, DeepSeek, Vibe Coding, Mac, Linux, 編程

OmegaUse-OfficeVal 量度 Office 代理能力

想比較 LLM agents 做 Office 工作交付得好唔好,單靠主觀打分唔夠。OmegaUse-OfficeVal 用可執行驗證器同經濟訊號,將評測流程整理成可重跑的框架。

OmegaUse-OfficeVal benchmark framework

做 Office-suite 長流程任務,最難唔係叫模型產生文件,而係點樣穩定判斷交付物到底合格未。OmegaUse-OfficeVal 把這件事做成一個 Python 框架,同時連接 benchmark 思路與驗證流程:它收 ZIP 提交、先做安全檢查,再逐個執行 100 個 Office document evaluators,最後輸出 JSON 同 CSV 報告,適合用來評測 LLM agents 在 Office 任務中的完成度。

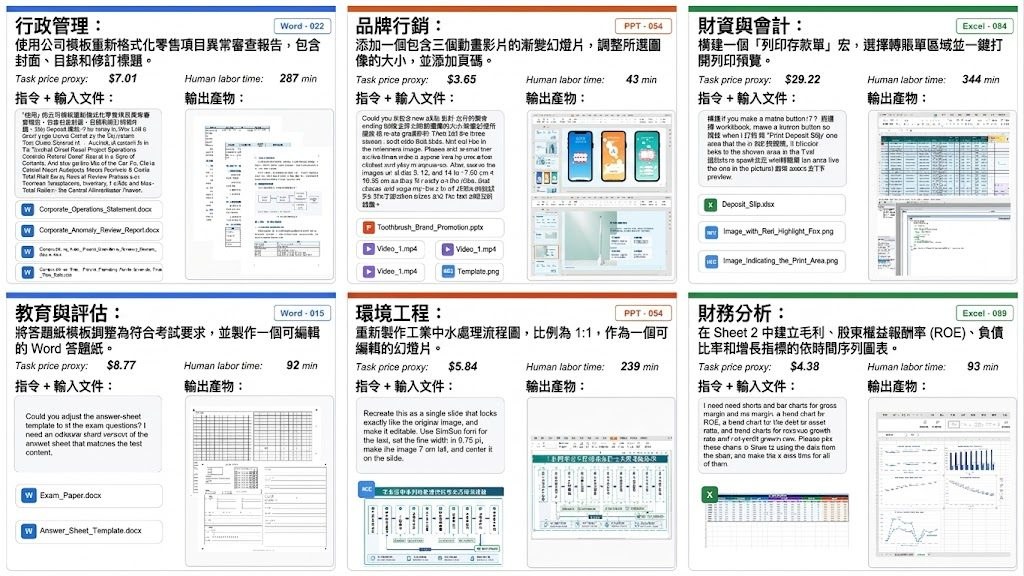
呢個項目的取向幾鮮明:重點唔放喺即場互動,而係放喺可重複、可審核、可批量執行的驗證。網站資料亦交代,OmegaUse-OfficeVal 對應的是一組有經濟 grounding 的長時程 Office-suite tasks,100 個任務平均要 2.32 小時人手完成,並附有人力時間與 task price proxy,方便把模型推理成本同人類成本放埋一齊看。相比只做最終分數排行,這種設計更接近團隊挑選 agent、比較交付價值時會遇到的問題。

它不是把資料集、提交內容同工作目錄全部包在倉庫內,而是把評測框架與 verifier source code 分開提供,benchmark data 另外發佈。Python 3.10 以上可跑,Windows、macOS、Linux 都支援 normal mode;其中 91 個 verifiers 可跨平台執行,另有 9 個 verifiers 依賴 Windows 上的 Office COM,相關環境未齊時會被跳過或只限指定平台處理。

  • 以 evaluate(directory: str) -> dict 統一 100 個驗證器介面,方便批量評測與整合
  • 收件前先檢查 ZIP traversal、加密、大小、檔案數量與壓縮比,安全性考慮算完整
  • 每個 verifier 在隔離 subprocess 執行,可設定 concurrency 同 timeout,減少互相干擾
  • 輸出採用 machine-readable JSON、CSV,而且每個 verifier 各有結果,後續分析較方便

這個倉庫裡主要體現在覆蓋範圍與流程穩定性,而唔係模型速度本身:可見進度、目前 verifier ID、執行 channel 同耗時,對跑大批提交會實用。它更像一個面向 Agentic 評測、研究復現同內部驗收的基建項目;想測 Office 類代理,尤其想把安全收件、隔離執行、可讀報告放進同一條流水線,這個項目的完成度相當高。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 框架, Mac, Linux, Python, Dataset 數據集, 百度

Page 4 of 7
1 2 3 4 5 6 7