PanoWorld 把 360 影片生成拉回真實場景

想做會記得路徑同方位的全景生成,PanoWorld比一般短片模型更有方向感。它瞄準長距離一致性,重點不只係畫面靚,仲要前後場景講得通。

PanoWorld logo

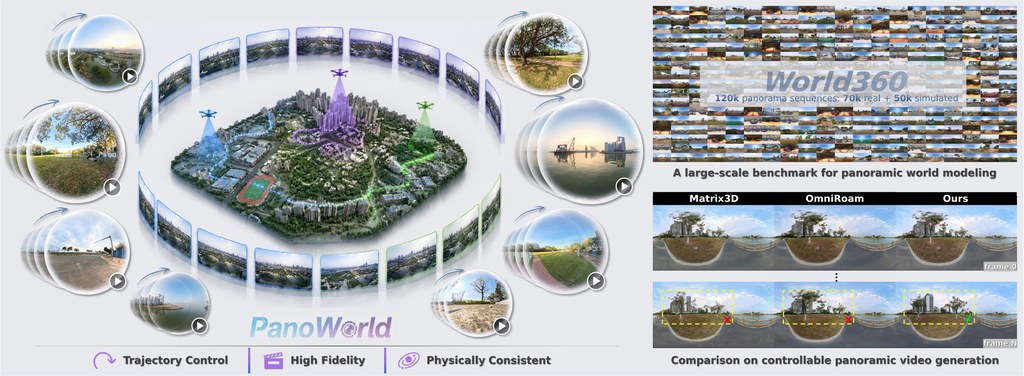
做 360° 影片生成,最易穿崩的往往不是單幀畫質,而是鏡頭轉了一大圈之後,場景記憶是否仍然連貫。PanoWorld屬於世界模型兼影片生成模型,針對全景 world model 的 long-range memory 問題,目標是生成更符合空間幾何與物理一致性的 panoramic video。

這個項目的取向幾明確:不是單純追求更短時間出片,而是利用 omnidirectional representations 的 rotation-equivariant 特性,將旋轉視為隱含幾何變換,再把相機軌跡簡化成固定朝向下的平移。核心做法包括 Dense Panoramic Ray-Conditioning (DPRC) 與 Geometry-aware Memory Augmentation (GMA),並建基於 Wan2.2 backbone 的 triple-stream DiT,處理當前動作建模與長程記憶。

現階段公開資訊較適合做推理測試與結果驗證,訓練代碼仍未釋出。環境要求也不算輕:Linux(已測 Ubuntu 22.04)、CUDA 12.8 以上、Python 3.10,並需要至少 20GB VRAM 的 CUDA GPU;README 亦提供 demo assets,可先用來跑 inference,觀察 81-frame 與 161-frame panoramic video 的生成表現。

  • 重點放在 long-range memory,而非只提升單段片段觀感
  • 可生成 81-frame、161-frame 的 panoramic video
  • 評測依託 World360,涵蓋真實全景無人機片段與 AirSim360 模擬資料
  • 官方表示在 World360 上明顯勝過其他方法,但目前公開細節以展示頁與推理資源為主

受益最明顯的,會是做 360 內容生成、沉浸式視覺、無人機視角模擬,或研究世界模型長時序一致性的團隊。它未必是最容易部署的項目,但定位很清楚:當一般 video model 在大範圍空間變化與光照變化下容易失憶,PanoWorld正面處理這個痛點,並且連同 World360 一起把評測場景拉近真實世界。

項目主頁 · GitHub

Categories: 開源, 清華大學, 視頻模型, 世界模型, NVIDIA, Video, 影像處理, 3D, Linux, Python, Dataset 數據集

ABot-World 把互動世界模型帶上桌面 GPU

ABot-World想解決的,不是再做一段更長影片,而是讓生成世界可以持續回應操作。你可以把它理解成一個開始接近可玩狀態的互動式世界模型示範。

ABot World 0

影片生成做到流暢並不罕見,但能一邊接收操作、一邊把世界延伸落去,門檻就高得多。ABot-World定位屬於模型加示範工具,核心處理的是 action-conditioned world rollout:用戶輸入動作之後,系統持續生成可探索的世界,而唔係播完就停的被動片段。

呢個項目的取向相當鮮明:它唔係先追求超高畫質,而是把「可互動、可持續、可在單張桌面顯示卡跑起來」放到前面。官方公開的數字是單張 NVIDIA RTX 5090 可在 720P、16 FPS、1.2 秒延遲、19GB GPU 記憶體下運行,配合 LongForcing training 減少 scene lock-in,令 rollout 期間可以擴展新場景同動態,唔使靠 prompt switching 硬接續。

測試方式算直接:項目已提供本地 gradio demo,同時有線上版 ABot World Studio;想自己部署,它在 Ubuntu 22.04、CUDA 13.3、NVIDIA RTX 5090 環境驗證過,並要先下載 ABot-World-0-5B-LF checkpoint。換句話說,現階段較適合把它理解成高階桌面 GPU 上的研究型互動系統,而唔係一般消費級硬件都能順手跑的輕量工具。

幾個重點值得留意:
– ABot-World-0-5B-LF 已公開,屬於 causal student model
– 互動重點在連續探索,不是固定長度 video generation
– 本地推理與線上 playground 都已提供,驗證路徑清楚
– Bidirectional Teacher Model 仍未釋出,生態暫時未算完整

適合研究 world model、interactive video generation、Agentic 模擬環境,或者想為遊戲原型與具身智能測試場景找參考的團隊。現階段的吸引力在於它把「無限 rollout」和「單桌面 GPU 即時推理」放到同一個項目內。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視頻模型, 世界模型, 模型訓練, Google, NVIDIA, Video, Linux, 蘋果

LongE2V 把事件流變成穩定長影片

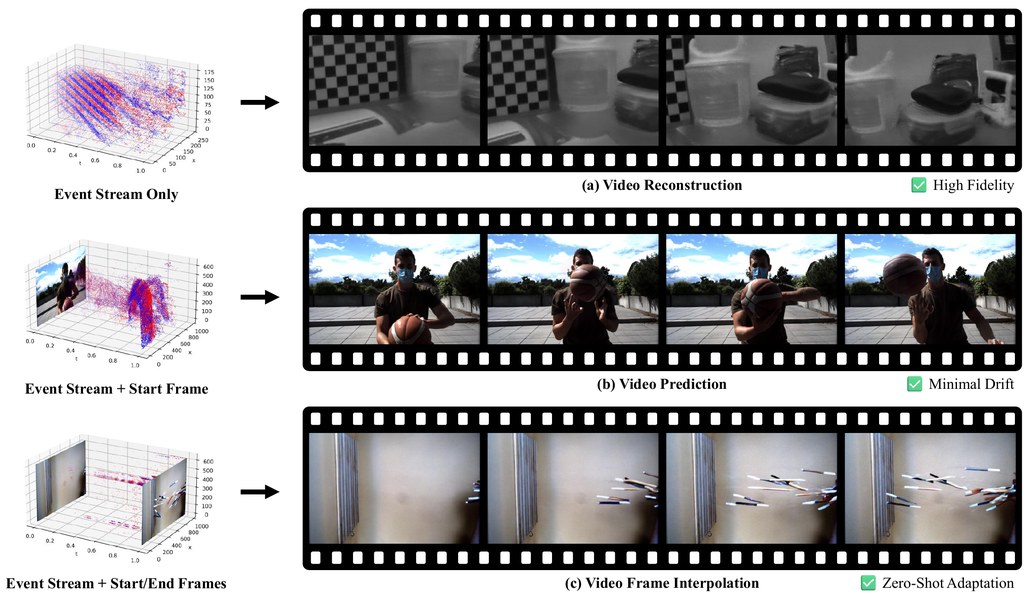
LongE2V 針對事件相機最難處理的長時序穩定度落手,想同時做好重建、預測與補幀。你可以把它理解成一套用 video diffusion model 補回連續畫面的研究型框架。

Logo

事件相機資料本身又稀疏又碎,畫面一拉長,很多方法不是紋理發糊,就是前後段落開始飄。LongE2V 走的是研究型模型/框架路線,目標不是只修一段短片,而是把 sparse event streams 轉成較穩定的長影片,並且同時處理 reconstruction、prediction 同 frame interpolation。

同類做法常見兩條路:一類用 regression methods,速度直接但容易損失細節;另一類雖然有 generative models 的畫質優勢,長序列又容易出現 temporal drift。LongE2V 把 pre-trained video diffusion priors 拉進 event-based video 任務,再加上 Autoregressive Unrolling、Adaptive Context Switching,以及插幀用的 Reencoding Alignment with Cross Residual Correction,核心取向很清楚:接受系統更複雜,換取較長時間的一致性同感知品質。

部署環境以 Python 3.10 為基礎,Linux 加 NVIDIA GPU,同時依賴整理好嘅資料結構;訓練要每段 sequence 準備 images/.png、voxels/.npz 同 cogvlm_prompts.txt,推理前亦要確保 voxel 檔名、數量同資料夾完全對齊,因為多一個或少一個 voxel 檔,都會改變事件切塊方式,直接影響訓練同推理結果。

重點整理如下:
– 同一套框架覆蓋 reconstruction、prediction、frame interpolation,減少每個任務各自維護一套模型的割裂情況
– reconstruction / prediction 以 ECD、MVSEC、HQF 為主,interpolation 用 BS-ERGB 同 HQF
– 空事件區間會寫入 zero voxels,避免時序長度對不上
– --reverse-time --reverse-polarity 產生的 voxels_reverse 只供 interpolation 測試使用,唔需要帶入 reconstruction、prediction 或訓練
– 在 real-world benchmarks 上優於多個 state-of-the-art 方法,並強調 temporal coherence 同 zero-shot generalization

相關模型包括 E2VID、FireNet、ET-Net、SPADE-E2VID、SSL-E2VID、HyperE2VID、VDM-EVFI、CBMNet-Large 同 TLXNet+。LongE2V 較適合做事件相機、視覺生成、機械感知或學術重現的團隊參考;它吸引之處在於把三類任務收進同一個 video diffusion framework,但代價是資料前處理要求嚴格、硬件門檻偏高,整體更像面向研究與實驗室工作流。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, NVIDIA, Video, 框架, Linux, Python

GitHub Copilot 桌面 app 全面開放

而家唔止付費用戶先可用 GitHub Copilot app,連 Free 同教育方案都可以直接開跑。你可以把它理解成將 agent-driven development 帶到桌面的入口。

Og image

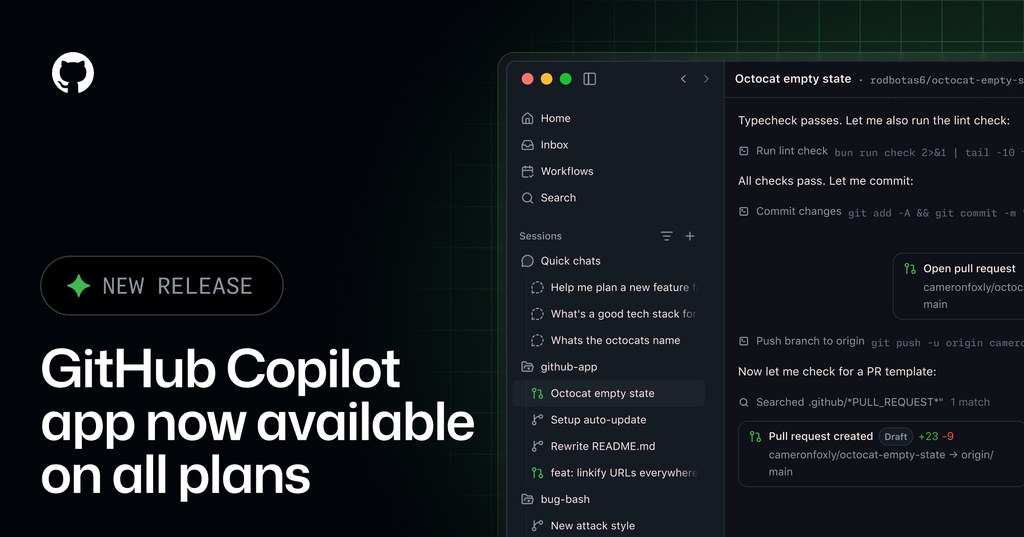
寫程式想快啲進入 agent-driven development,而家門檻低咗好多。GitHub Copilot app 已經開放畀所有 Copilot 方案使用,涵蓋 Copilot Free 同 GitHub Education,並且支援 macOS、Windows 同 Linux,等開發者可以直接由桌面開始工作。

對一般開發者而言,重點唔只係「多一個 app」,而係登入 GitHub 帳戶後,幾下點擊就可以開 session,將 Copilot 由編輯器內的輔助,延伸到更完整的桌面互動流程。呢個變化對想集中用單一入口管理開發節奏、快速試 agent 工作方式的人會更有吸引力。

另一個取向幾清楚:就算冇訂閱 Copilot 方案,仍然可以用 bring your own key(BYOK)接上自己嘅 model provider 跑 session。即係話,GitHub 將入口開放得更闊,一邊照顧現有 Copilot 用戶,一邊容許偏好自選模型供應商嘅團隊或個人保留彈性。

  • 所有 Copilot 方案都可使用,包括 Copilot Free 同 GitHub Education
  • 支援 macOS、Windows、Linux 三個桌面平台
  • 可用 GitHub 帳戶直接登入並快速開始 session
  • 冇 Copilot 訂閱亦可透過 BYOK 連接自有 model provider
  • Business 或 Enterprise 方案需由管理員啟用 Copilot CLI 政策設定

對團隊環境來講,Business 同 Enterprise 用戶仲要留意權限設定:組織或企業管理員需要先在 policy settings 啟用 Copilot CLI,先可以存取 GitHub Copilot app。呢點反映出 GitHub 既想擴大可用範圍,同時亦保留企業管理所需的控管方式。

項目主頁

Categories: Agentic, 微軟, API, Mac, Linux, 編程

GigaWorld-1:機械人世界模型開源路線圖

GigaWorld-1 不只是模型,亦是一套圍繞機械人世界模型的訓練與推理流程。它的重點是用模擬 rollout 協助評估 robot policy。

GigaWorld-1 Teaser

GigaWorld-1 是一個面向 robot world models 的開源工具鏈與研究原型。它主要用來訓練、推理、處理資料,並把世界模型當成 robot policy evaluation 的替代評估器,減少每次都要落真機做 rollout 的成本。

現有做法通常依賴真實機械人測試,或者用偏重短片畫質的 video world models 觀察結果;作者認為這種範式未必足夠反映 policy 是否可靠,因為短期視覺真實感不等於長時序、動作一致的 rollout 準確度。這個項目連同 WMBench 一齊提出較清晰的評測框架,重點放在 long-horizon、action-faithful rollout consistency,而不是只看畫面似唔似真。

和一般只放模型權重的 GitHub 項目相比,GigaWorld-1 較完整地公開了訓練、inference、資料處理、checkpoint conversion 及 LoRA merge 流程,取向明顯偏向可重現與可擴充。基礎模型亦不是由零開始孤立建立,而是結合 Wan、Diffusers、Helios、Genesis 等元件,反映它更像一條可調整的工作流程,而不只是單一模型展示。

  • 重點不在短期畫面好看,而在 rollout 是否長時間維持動作一致性
  • 提供 training、inference、data processing、checkpoint conversion、LoRA merge 等完整流程
  • 相關模型與元件包括 Wan、Diffusers、Helios、Genesis
  • 配套有 ToyDataset、CVPR 2026 WorldModel Track Dataset 與 WMBench benchmark

部署思路相對明確:環境以 Python 3.10+、PyTorch 2.x、Linux 為主,再按 README 準備資料、模型與推理流程;需要下載模型或資料時,亦已有獨立工具說明。硬件需求未算輕量,但首頁提到 1.3B / 5B 變體與低於 24GB 記憶體的生成設定,代表它並非只面向超大規模研究機構。

較適合受益的群體,是做 embodied AI、robotics、world model research 的團隊,以及想建立 policy evaluator 管線的人。現有資訊顯示它背後有 12,000+ 小時訓練影片、324,000+ 模擬 rollout 配對真機執行,以及 7 類 video world models、4 種 action representations 的比較;這些數字未必等於任何場景都會即插即用,但足以說明它的價值在於提供一套有 benchmark 支撐的評估方法,而不只是再多一個生成模型。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 世界模型, 模型訓練, Video, VLA, Robotic, 框架, Linux, Python, Dataset 數據集

LiveEdit:串流影片編輯走向即時化

LiveEdit 把文字指令變成串流影片編輯,重點放在速度與畫面穩定。它嘗試兼顧即時反應,以及背景與非編輯區域的保留。

Image 1

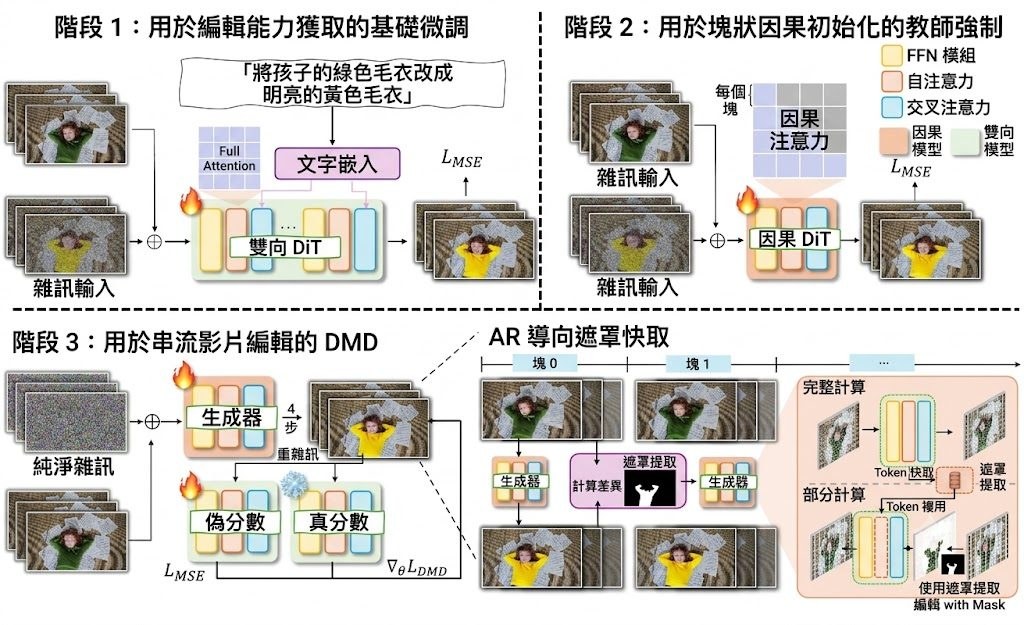
LiveEdit 是一個 diffusion-based streaming video editing 系統,屬於影片編輯模型與方法項目。它的核心任務是根據來源影片加上文字指令,逐段完成 causal chunk-by-chunk editing,並盡量保留背景與沒有修改的區域。

這個項目不是追求離線影片慢慢算到最靚,而是針對接近即時的串流編輯。它建基於 Wan2.1 和 Self-Forcing codebase,並用 three-stage distillation,把雙向編輯 teacher 的能力轉移到串流 student,再配合 AR-oriented Mask Cache 減少重複運算,換來較低延遲。

部署與測試資訊算是完整,提供 inference scripts、training code、checkpoint instructions,也講明建議在 Linux 配合 NVIDIA GPUs 執行;單 GPU 可做 inference,多 GPU torchrun 主要用於訓練。輸入方式是準備一個 JSON,填入 source video 路徑和 instruction,然後配合已釋出的權重與 Wan2.1 base model 進行推理。

有一個相當關鍵的參考值:項目頁列出 12.66 FPS,並表示透過 4-step distilled diffusion generation 達成 real-time streaming inference。這個成績對互動式影片編輯很重要,不過公開資訊未見更完整的硬件條件、顯存需求或不同解析度下的比較,因此判斷效能時仍要保留一點。

  • 重點不是一般文字生片,而是保留原片內容的串流影片編輯
  • 主要技術包括 three-stage distillation、Causal DiT、AR-oriented Mask Cache
  • 已公開 inference 與 training 程式碼,也提供 Hugging Face checkpoint 指引
  • 已知較適合 Linux、NVIDIA GPU 環境,研究團隊或影像生成工程師較易受益
  • 相關模型與基礎包括 Wan2.1-T2V-1.3B、bidirectional editing teacher、streaming student

整體來看,LiveEdit 的價值在於把 streaming video editing 做得更接近可互動系統,而不只是展示級效果。它較適合研究即時影片編輯、互動內容製作、直播視覺處理或需要低延遲生成的團隊;一般用家若想直接在圖形介面一鍵開用,現有資料未提供管理後台整合、免手動設定流程,仍然比較像面向研究與開發者的項目。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Video, 框架, Linux, 蘋果

MemoBench 點樣測世界模型記憶力

MemoBench專門檢查世界生成模型會否在物件離鏡後再出現時「記錯樣」。它用V-D-R流程,把畫質、一致性與語意判斷拆開量度。

Repository image for MemoBench-Team/MemoBench

MemoBench 是一個 benchmark,屬於用來評測 world generation models 的數據集加評測工具組。它主要檢查模型在鏡頭移開再回來之後,能否把同一個物件的外觀、位置與狀態準確重建,而不是只生成一段看似流暢的影片。

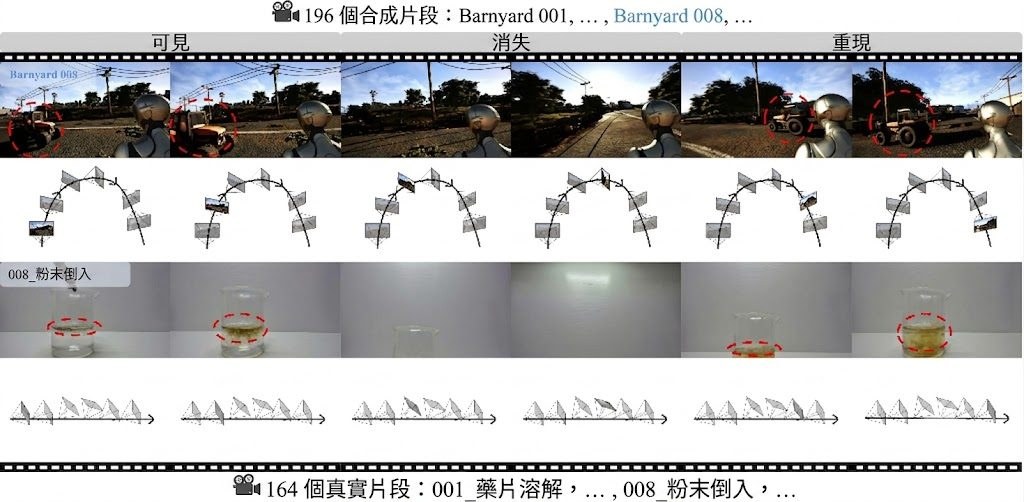
現有影片生成或世界模型評測,很多時集中在畫質、動作流暢度,或者短時間一致性;作者認為這類範式未必能測到 visual memory。MemoBench 因此用 V-D-R (Visible → Disappeared → Reappear) 結構重組任務:先見到目標物件,再讓它離開視野,最後要求模型在重返視野時保持物件永久性與幾何一致性,這比單看首尾畫面更接近真正的記憶測試。

資料部分有 360 段片,分成 196 段 synthetic 與 164 段 real-world clips,並提供 V-D-R 邊界、GT camera poses、目標物件文字描述、VQA question banks 等配套。部署思路相當清楚:環境以 Linux、Python 3.11、CUDA GPU 為主,評測流程分成自動指標、Object Revisit Score (ORS),以及 VQA 三步,輸入格式是逐格 PNG 圖片;camera controllability 會用到 MapAnything,ORS 會用到 SAM-3。

它和同類 benchmark 的差異,不在於片段數量特別大,而在於把「物件消失後再出現」設成核心壓力測試,並同時覆蓋 synthetic 與真實場景。14 項指標亦不是只量畫面好不好看,還會看 temporal consistency、geometric fidelity、object permanence、camera controllability,以及 VQA-based reasoning,取向明顯偏向診斷模型缺口,而不是只做單一排行榜。

  • 適合比較 不同 world generation models 在長時序記憶上的穩定度
  • 測試材料完整,包含 phase 邊界、相機姿態、文字提示與 VQA 題庫
  • 評測角度較細,把低階畫質與高階語意一致性分開量度
  • 部署門檻不算低,需要 Linux、CUDA GPU,亦依賴 MapAnything 與 SAM-3

相關模型方面,官方內容提到已基準測試 8 個模型,但這份儲存庫摘要未列出完整名稱,因此較穩妥的理解是:MemoBench 重點不是提供新模型,而是提供一套可重覆的記憶一致性測試基準。對研究 world modeling、影片生成、camera-controlled generation 的團隊尤其有參考價值,因為它能幫你分辨模型是「畫得靚」,還是真正記得之前見過什麼。

項目主頁 · GitHub · Paper

Categories: Google, NVIDIA, Image, 框架, Linux, Python

NeuraDock Agent:把 7 通道 EEG 變成可用狀態訊號

這不是一般腦波展示工具,而是把7通道EEG整理成可供應用程式使用的即時狀態。它重點不在生成炫技介面,而在穩定解析、質量把關與本地處理。

Repository image for Neuradock/eeg-workstation-agent

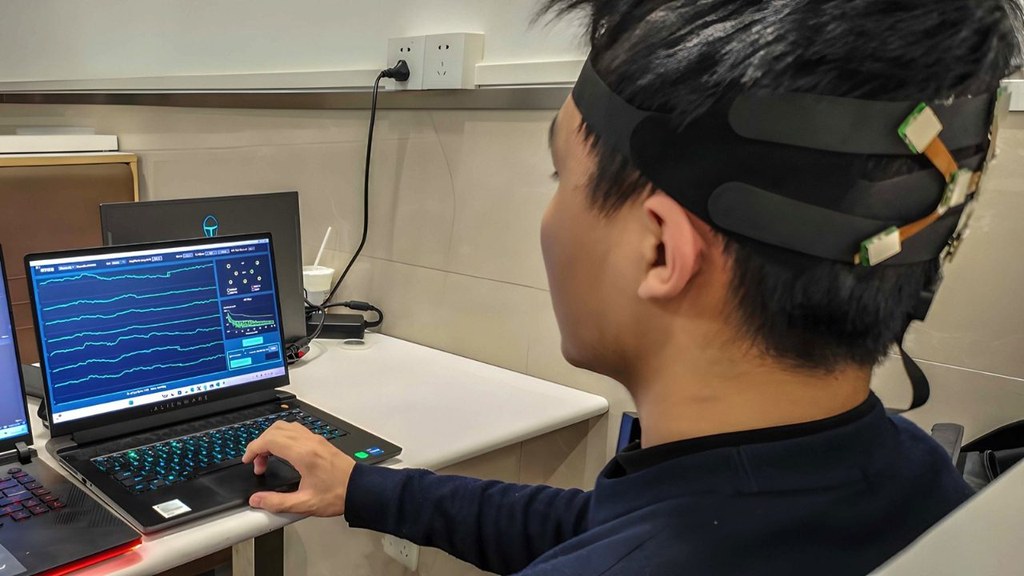
NeuraDock/eeg-workstation-agent 是一個本地優先的 Python 工具項目,也可視為面向應用整合的 EEG agent。它主要將 NeuraDock EEG Workstation 的 7 通道腦電訊號,轉成經過質量檢查的 visual cognitive-load 狀態,讓介面、XR、車載 HMI 或互動系統可以即時讀取,而不必直接處理原始 EEG。

現有不少 EEG 流程會把重心放在原始波形顯示、離線分析,或讓開發者自行拼接 preprocessing、quality control 與特徵提取;作者在技術文件中明確反對讓通用 LLM 直接對感測結果作自由解讀的做法。這個項目的取向,是把 deterministic local EEG engine 與 hardware-aware language layer 分開:前者負責解析、前處理、spectral workflows 與 machine-readable artifacts,後者只接收 allowlisted summary 與 versioned context pack,避免模型對 7-channel EEG 說出超出量測邊界的結論。

NeuraDock EEG Agent Workflow

部署路線算清晰。儲存庫列出 Python 版本範圍、支援 Windows、macOS、Linux,亦提供無硬件 synthetic replay,所以就算未買 NeuraDock EEG Workstation,也可以先啟動本地 dashboard 與 API,檢查 GET /api/status 會輸出哪些欄位;真正連接裝置時,Agent 會經 TCP 收流、做 online preprocessing,再輸出如 visual_load_index、alpha_peak_hz、alpha_suppression_from_baseline 及 quality.status 等狀態。示例資料要到另一個資料儲存庫下載,這裡沒有直接附上人類 EEG 數據,反映作者對資料安全與分發邊界相當保守。

和同類做法相比,它的差異不在「能否分析 EEG」,而在於它刻意收窄可宣稱的範圍。這套工具聚焦 posterior Alpha dynamics、within-subject Rest/Task visual cognitive-load comparison,以及 quality-gated adaptation,並清楚說明它不是 medical device,亦不能直接診斷 attention、fatigue、impairment 或跨個體比較表現。這種取捨令它的野心比一些泛用腦機介面平台細,但換來較可控的輸出與較低的誤讀風險。

  • 定位明確:屬於本地執行的 EEG 分析工具項目,重點是把 7 通道訊號轉成應用可讀狀態。
  • 測試門檻較低:有 synthetic replay,未接硬件都可以先驗證 dashboard、API 與流程。
  • 邊界控制做得細:LLM 不接觸 raw EEG 與 dense time-series arrays,只接收精簡指標與受控上下文。
  • 適合即時互動場景:視覺搜尋、adaptive vehicle HMI、cognitive load game 都是直接示範。
  • 資料解讀有限制:結果偏向個體內比較,不適合把不同人的 workload 分數直接放在同一把尺上。

性能描述方面,技術報告提供了幾個辨識度很高的訊號。其一,12 份錄音在十次 numerical repetitions 下得到相同 structured results,完整 Rest/Task 執行在三次重跑下亦產生相同 result、report 與 figure hashes,說明 deterministic pipeline 不是口號。其二,作者做了 request-capture 與 failure-injection experiments,檢查資料邊界與本地 artifacts 在 HTTP、格式錯誤及連線失敗下是否仍能保留。其三,boundary-awareness benchmark 涵蓋 ordinary 與 adversarial questions,並結合 qwen3.7-max 和 kimi-k2.6 生成輸出;這部分重點不是比較哪個模型最聰明,而是檢查語言層有沒有超越硬件與工作流容許的解釋範圍。

相關模型與組件方面,README 沒有把核心 EEG 推理包裝成 foundation model,而是以 reviewed workflows 為中心;可見的外部模型主要是 optional LLM mode 會用到的 LLM,例如 qwen3.7-max、kimi-k2.6。適合受益的人,包括做 HCI、XR、遊戲互動、復健訓練、工業監測與研究原型的團隊;他們想要的通常不是一套醫療級診斷系統,而是一個可以穩定輸出、容易接入前端或控制邏輯、又盡量把資料留在本機的腦訊號工具鏈。

項目主頁 · GitHub · Paper

Categories: Agentic, Qwen, API, 框架, Medical醫學, Mac, Linux, Python

Apple container:Mac 原生容器新選擇

Apple 推出的 container 不是另一個包裝層,而是針對 Apple silicon 與 macOS 26 的原生容器工具。它適合想在 Mac 上跑 Linux 容器、又重視輕量與兼容性的人。

Containerization logo

container 是一個工具,用來在 Mac 上建立及執行 Linux containers,做法更接近把容器當成輕量虛擬機處理;它要解決的,是 Mac 開發者在本機跑 Linux 工作負載時,如何兼顧隔離、速度與 OCI 相容性。

這個項目最明顯的取向,是 Apple 自己用 Swift 編寫,並且針對 Apple silicon 優化,同時依賴 Containerization 這個 Swift package 處理較底層的 container、image 與 process 管理。跟不少人熟悉的 Docker Desktop 或其他 Mac 容器方案相比,它不是強調整合一大堆開發配套,而是集中做好原生執行、標準映像相容,以及 Apple 平台能力。

安裝不算複雜:官方提供已簽署的安裝包,裝好後要啟動 system service,並且整個項目只支援 Apple silicon 與 macOS 26。這代表門檻很清楚:如果你仍在舊版 macOS,或者團隊有 Intel Mac,這個項目暫時就不會是通用解法。

Apple Just Built WSL for the Mac (Container Machines)
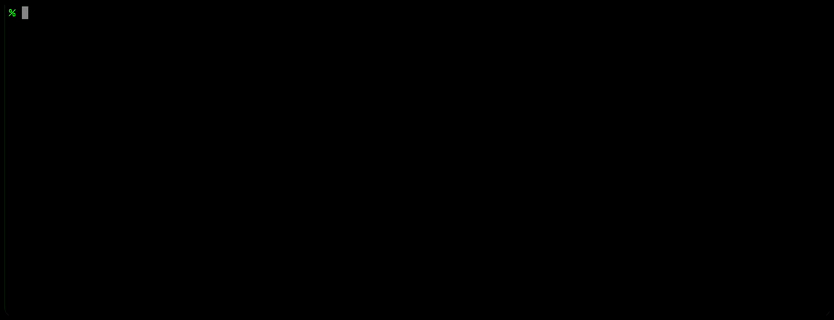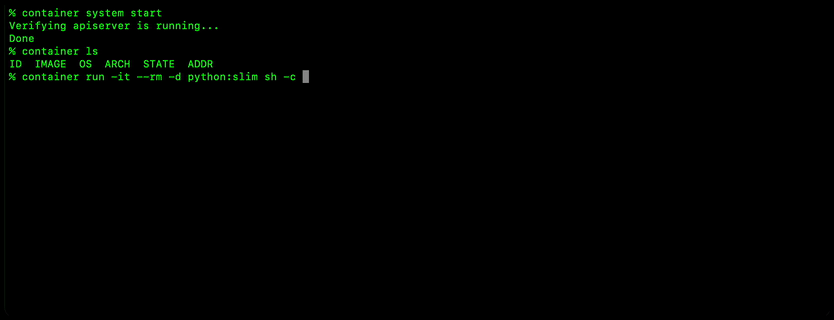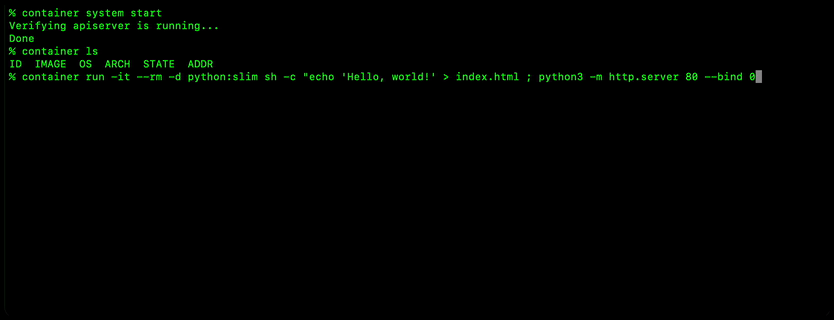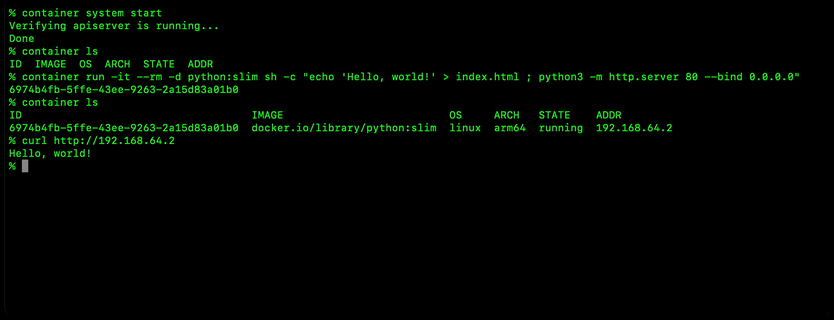
它支援讀寫 OCI-compatible container images,所以可以從標準 container registry 拉取映像、建立映像,再推回其他 OCI-compatible application 可用的環境。對開發團隊來說,這點很重要,因為它不是把流程鎖死在 Apple 自家格式,而是保留與現有容器生態互通。

  • 針對 Apple silicon 與 macOS 26,平台限制明確
  • 支援 OCI-compatible container images,可接標準 registry
  • 底層建基於 Containerization,偏向原生與輕量路線
  • 較適合 Mac 開發、測試、映像建置,不是全功能平台替代品

效能方面,暫時沒有提供完整官方基準數字,但外部已有文章把它放到 Docker Desktop、OrbStack 一類方案旁邊看 CPU、記憶體、啟動時間與 I/O。即使未能單靠儲存庫內容下定論,仍可合理判斷:Apple 想做的不是「功能最多」,而是在自家硬件上提供更貼近系統能力的容器執行方式。較受惠的會是以 Mac 為主要開發機、需要 OCI 相容流程、又願意接受新平台限制的工程團隊。

這個項目不是 AI 模型;若要說相關技術組件,主要是 OCI-compatible container images 與 Containerization。

GitHub: https://github.com/apple/container

項目: https://developer.apple.com/videos/play/wwdc2026/389/

Categories: 開源, 工具, Mac, Linux, 庫, 蘋果

當 AI 程式助手遇上滿山數據:CoDA-Bench 想考甚麼?

中國人民大學團隊發表的 CoDA-Bench,把 AI 代理人丟進藏有數百檔案的 Linux 沙盒,測試牠們在真實數據密集場景下找檔案、寫代碼、做分析的綜合能力。

CoDA-Bench

現有針對 AI 程式代理(AI coding agents)的評測,大致分為兩類:一類專注於軟件工程任務(例如 SWE-Bench、Terminal-Bench),只考驗代碼本身;另一類專注於數據分析能力(例如 DS-1000、DA-Code、DataSciBench),卻把所需數據直接攤在桌面,等着代理去讀。中國人民大學數據實驗室團隊指出,這種把「代碼」與「數據」分開評估的範式,與真實開發場景脫節——現實中的工程師,往往要在堆滿雜亂檔案的環境中,自己摸索出哪些數據有用,再寫代碼處理它們。

為此他們提出 CoDA-Bench(Code and Data-intensive Benchmark),屬於 benchmark 類型的評測框架。它建構了一個基於 Kaggle 生態的 Linux 沙盒,每個任務環境平均包含約 980 個檔案,總共 1,009 道題目橫跨 31 個主題社區,要求代理先在語意相近的眾多檔案中大海撈針,再整合異質資料、撰寫分析代碼,產出最終答案。

團隊測試了多款頂尖代理後發現,即使表現最好的系統,成功率也只有 61.1%,暴露出現有模型在「數據發現」與「代碼執行」之間缺乏有效銜接。這個缺口正好為下一代研究指明方向:未來的代理不只要會寫代碼,更要懂得在雜亂的檔案系統中自行導航。

如果你從事 Agentic AI 研發、數據分析自動化,或想測試 LLM 在複雜環境中的推理與編程整合能力,這套開源 benchmark 提供了一個貼近現實的試金石。完整題目已釋出於 HuggingFace,評估則可透過 Docker 一鍵執行。

重點摘要:
– 修正舊範式:突破 SWE-Bench 與 DS-1000 把代碼與數據分開考的做法,統一在同一環境內評測。
– 真實規模沙盒:每題約 980 個檔案,模擬 Kaggle 上雜亂而龐大的真實數據環境。
– 雙重能力整合:同時考驗資料探索、檔案導航、跨格式整合與代碼生成四個面向。
– 成績慘淡:頂尖代理在完整題集上僅約 61.1% 成功率,顯示仍有明顯改進空間。
– 完整開源:包含 1,009 道題目、31 個社區數據(約 43 GB),以及 Docker 評測流程。

GitHub: https://github.com/ruc-datalab/CoDA-Bench

Paper: https://arxiv.org/pdf/2606.15300

Categories: 開源, 清華大學, Agentic, AI productions, 模型, 框架, Vibe Coding, 軟件, Linux, 編程, 中國, Dataset 數據集

Page 6 of 7
1 … 4 5 6 7