UniVR:視覺推理訓練變成可控工作流

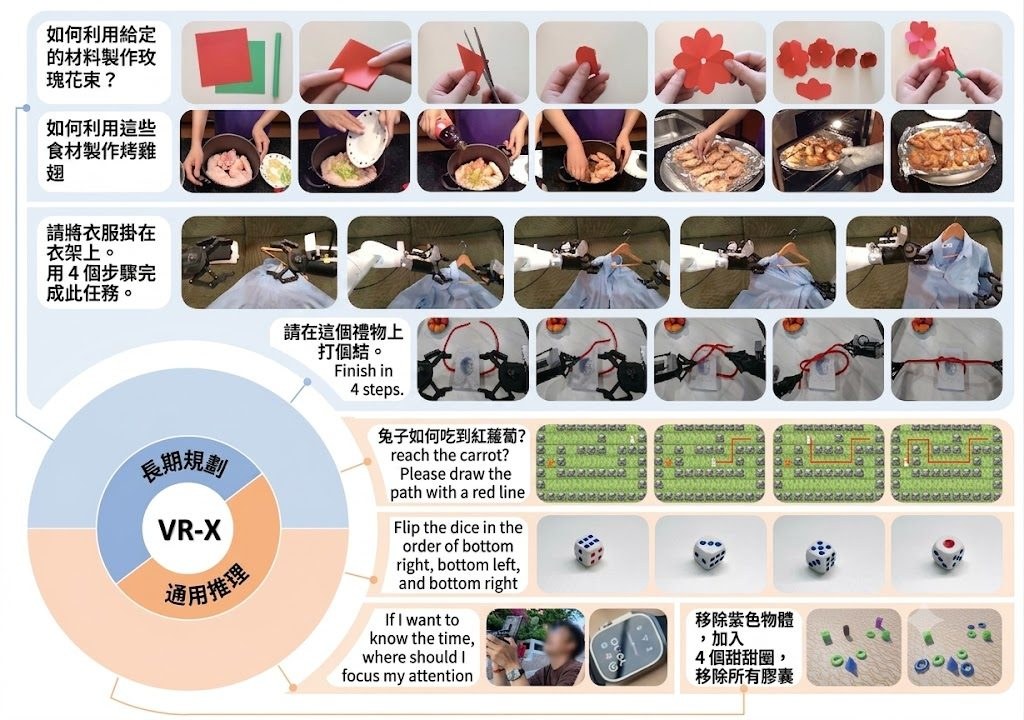
UniVR 把 Emu3.5 的視覺推理訓練拆成 SFT 與 GRPO 兩段,讓團隊可用自己的資料同獎勵函數接上去。它更像一個面向視覺任務的訓練骨架,而唔係單一模型。

UniVR Overview

UniVR 係一個能理解我們視覺空間中的思考方式及其在統一視覺推理中的應用,它針對 Emu3.5 unified generative models 的訓練框架,處理的是視覺推理、長程規劃同結果判斷點樣一齊學。它唔係拿來直接做推理展示,而係俾你用自己的資料同獎勵訊號,去微調一個已經懂得處理圖像與文字的底座模型。

SFT(supervised fine-tuning)階段要提供統一格式的樣本:query image、textual instruction、visual reasoning trajectory;RL(reinforcement learning)階段則改成透過 HTTP reward server 送回分數。原始資料沒有提供完整安裝流程,所以目前可確定的只有要把自定義 PyTorch Dataset 接入 UniVR_SFT/train.py,以及把 reward function 換成自己的服務。

和一般只做單次微調的做法相比,UniVR 的取向更偏向「先教格式,再用獎勵修正推理」。它在 RL 端用 GRPO,並配合 HybridEngine 與 Emu3.5 的 vLLM patch,強調 rollout 效率;同時保留 LoRA 同 full-parameter training,適合資源與改動幅度唔同的團隊。

  • 支援多節點 SFT,兼容 LoRA 同 full-parameter training
  • RL 端基於 verl,同 GRPO 搭配自訂 HybridEngine
  • Emu3.5 的 vLLM no-CFG parallel inference 可做到約 2 倍 throughput
  • 獎勵設計分成 format reward、global reward,同 step-level 的視覺推理約束
  • 相關模型包括 Emu3.5 同作為評分器的 Qwen3-VL-30B

較容易受惠的情境包括做視覺代理、機械臂/操作規劃、長程任務推理,或者想將現成視覺模型轉成自己工作流的團隊。它的價值在於把「資料格式、推理軌跡、獎勵判斷」串成同一條訓練路線,令視覺任務唔再只靠靜態標註去學。
項目主頁 · GitHub · Paper

Categories: 開源, 字節跳動, 多模態模型, 模型訓練, Qwen, OpenAI, DeepSeek, Gemini, Image, Python, Dataset 數據集

BadWAM 直指 World-Action Models 盲點

BadWAM唔係做更強控制,而係專門測試 World-Action Models 會點樣「想得啱、做錯事」。對研究機械人安全同對抗攻擊的人來說,呢類偏移比一般失敗更值得警惕。

Repository image for LiQiiiii/BadWAM

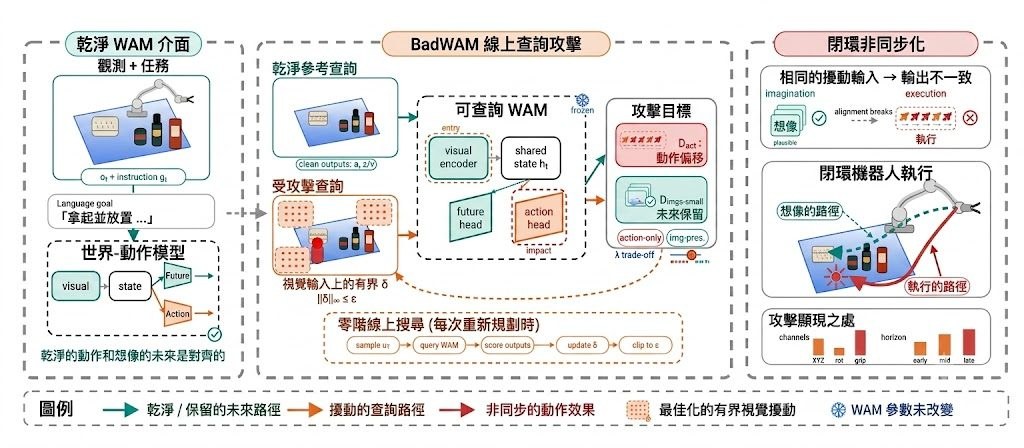
當一個 World-Action Models(WAMs)睇落仍然能夠預測合理未來,但實際控制已經被悄悄帶偏,問題就唔再只是準確率高低。BadWAM 屬於研究型安全測試框架,集中模擬 World-Action Drift Attacks,用細微視覺擾動去拆開「想像」同「行動」之間原本應該對齊的部分。

呢個項目的價值,在於它唔係單純證明模型會失手,而係指出一種更難察覺的失效方式:未來預測仍然似樣,行動卻已經朝向任務失敗。相比一般只睇輸出有冇偏移的對抗攻擊做法,BadWAM更貼近 WAM 的結構特性,分成 Action-only Adversarial Attack 同 Imagination-preserving Adversarial Attack 兩條路線,後者尤其針對「表面正常、實際出錯」的情況。

重點可先睇幾項:
– 支援 query-based 攻擊,重點在凍結的 WAM 上做線上搜尋
– 提供 LIBERO closed-loop attack evaluation,唔只停留在單步分析
– 包含 matched-strength stealth analysis 同 ablation experiments
– 內附 statistics export 與 plotting utilities,方便整理結果

從部署角度看,儲存庫提供的是研究代碼而唔係開箱即用套件,基礎環境指向 Python 3.10+,並建基於 FastWAM。README 亦講明未附 model checkpoints、LIBERO data、dataset statistics、RoboTwin assets 同實驗輸出,所以要重現結果,仍然要自行補齊相關資源與依賴。

現有公開結果已經說明這個框架唔只係概念展示。在 LIBERO closed-loop 測試中,action-only WAM 成功率由 96.5% 跌到 43.1%,joint WAM 亦由 98.1% 跌到 61.5%。受益最大的會係做機械人控制、WAM 安全、對抗魯棒性測試的研究團隊;對一般應用開發者來說,它未必直接幫你部署產品,但很適合作為檢查模型是否「睇落可靠、其實已偏航」的驗證工具。

項目主頁 · GitHub

Categories: 開源, 香港理工大學, 世界模型, 框架, 香港, Python, 安全, Dataset 數據集

Self-in-Space 補上無人機空間理解盲點

無人機睇得見環境,未必真正理解自己點樣移動。Self-in-Space把評測、數據同模型放埋一齊,專門拆解呢個落差。

Teaser

講無人機視覺理解,很多方法集中在環境辨識或任務完成,但較少正面處理飛行器本身的狀態感知。Self-in-Space屬於研究型基準測試、訓練數據集與模型組合項目,核心是把 UAV 的 spatial cognition 與 self-awareness 分開檢查,看看模型是否不只「見到空間」,亦知道自己在場景中如何移動。

作者明確批評現有 UAV-oriented MLLMs 普遍偏向 environment-centered、task-oriented 範式:重視周圍有什麼,較少處理自身運動如何影響理解。為此,他們提出 SIS-Bench、SIS-Motion-54K 與 SIS-Motion,重新把 aerial understanding 拆成 perception、memory、reasoning 三層,再同時覆蓋空間與自我兩條軸線,令問題定義比一般影片問答 benchmark 更貼近 embodied UAV 場景。

SIS-Bench 包含 1,646 段真實 UAV 影片與 4,856 組 QA,覆蓋 13 個任務;團隊用它測試 26 個 video MLLMs,包括 6 個 proprietary models 與 20 個 open-source models。結果指出兩個穩定現象:模型對 self 的建模弱過 space,而且能力會由 perception 走到 memory、再到 reasoning 時逐步下跌,這個診斷比單看整體分數更有參考價值。

  • 結合 benchmark、training dataset 與 motion-aware model,不是單一模型發佈
  • 直接針對 UAV embodied intelligence 的 self-awareness 缺口
  • 評測設計有清楚分層,方便看出模型在哪一段開始失準
  • SIS-Motion 嘗試用 motion-aware representation 改善 aerial video understanding
  • 已公開 SIS-Bench 與 SIS-Motion-54K,可在 Hugging Face 或 ModelScope 了解內容

這項目的受眾很清楚:做 UAV 視覺、aerial video understanding、embodied AI、video MLLMs 評測的人,都會較容易用得着。現階段它更像研究與比較基礎設施,而不是即裝即用產品;想部署測試,較合理做法是先從 SIS-Bench 驗證現有模型在 self-awareness 與 spatial reasoning 的表現,再看 SIS-Motion 是否能為下游 UAV navigation tasks 帶來可轉移的增益。相關模型與資源以 SIS-Motion、SIS-Bench、SIS-Motion-54K 為主,並且對照了多個 video MLLMs 的表現。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, 字節跳動, 多模態模型, 模型訓練, Qwen, Gemini, Video, Dataset 數據集

awesome-Self-Improving-Agents:拆解自我改進 Agent 地圖

想追蹤 self-improving agents 點樣由概念走到方法,呢個整理庫比單看論文更省時間。它把分散做法收成一張可導航地圖,方便快速判斷研究路線。

Main figure of the survey

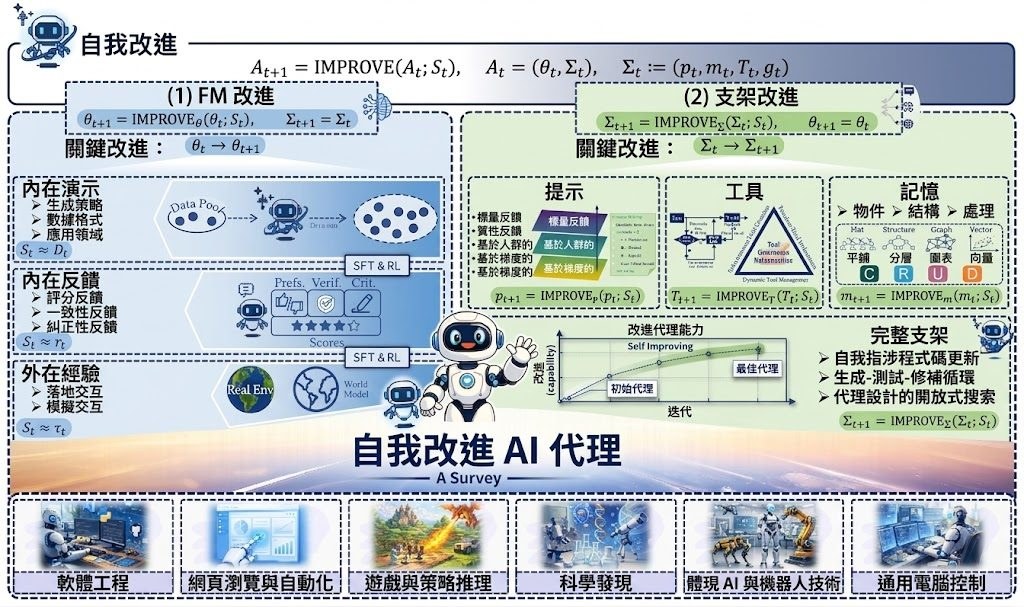
當大家都在談 Agent 會否愈跑愈聰明,真正麻煩的往往不是資料太少,而是做法太散、名詞太多、更新位置又不一樣。awesome-Self-Improving-Agents 把這件事整理成一個論文地圖型資源庫,核心不是教你直接部署系統,而是幫你分清楚 self-improving agentic systems 究竟在改進模型本身,還是在改進 prompt、memory、tools 與 control logic 這些外圍 scaffolds。

現有討論常把各類自我改進方法混在一起看,作者則用一條很實際的分界重組內容:一邊是 Foundation Model Improvement,另一邊是 Scaffolding Improvement。這個切法的好處,是你很快知道某篇工作追求的是更持久但較重的參數更新,還是較快、較平、亦較容易回退的代理層更新,閱讀時不會把 LoRA、工具路由、記憶結構調整當成同一類問題。

它不是可即裝即跑的軟件工具,更像研究與產品規劃都用得著的索引庫。你可以直接從 GitHub README、survey hub 同 arXiv 論文交叉閱讀;要測試這個項目的價值,最直接的方法是按 taxonomy 揀一條路,例如 Intrinsic Generative Demonstrations、Intrinsic Evaluative Feedback,或者 memory、tool refinement、full scaffolding,看看它能否幫你更快找到代表性工作與相近分支。

  • 把 self-improvement 分成 Foundation Model Improvement 與 Scaffolding Improvement 兩大路線
  • 收錄 239 篇 papers,當中 73 篇屬 FM improvement,166 篇屬 scaffolding improvement
  • 細分到 Intrinsic Generative Demonstrations、Intrinsic Evaluative Feedback、dynamic tool routing、autonomous tool creation 等機制
  • 適合研究員、Agent 產品團隊、技術寫作者整理文獻脈絡與比較方法取向

相關模型與系統脈絡圍繞 Foundation-Model-Based Agents 展開,但這個項目本身不提供單一模型權重或 benchmark 分數,也不是 OSWorld 那類直接跑任務的評測框架。它的價值在於建立閱讀順序與判斷框架;想找可落地的 agent 改進方向,這份 curated map 比單篇 survey 更接近工作清單。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 模型, 多模態模型, Meta, Dataset 數據集

EgoMemo 讓助手懂得幾時先開口

唔少助手識回應,真正難的是判斷應否打擾你。EgoMemo把連續第一身影片整理成可檢索記憶,嘗試把主動提醒變成可評測的能力。

Repository image for SitongGong/EgoMemo

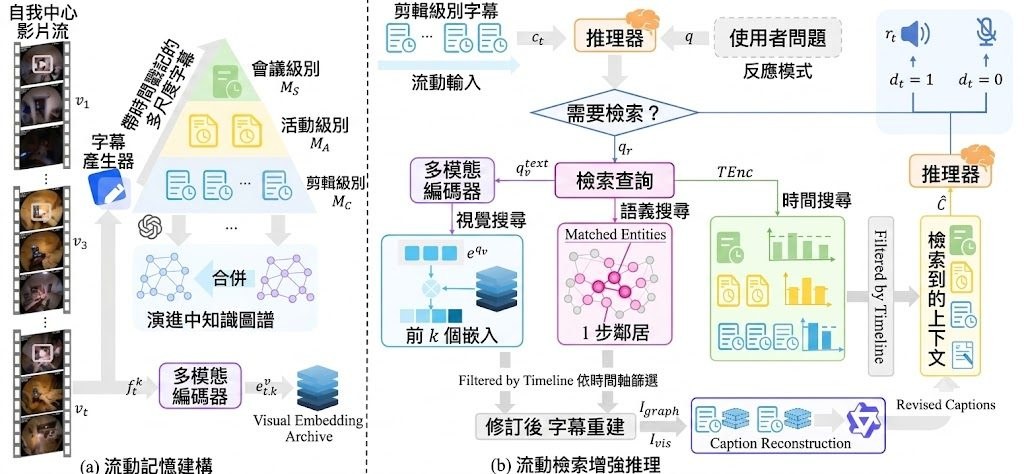
助手最難處理的,不是看見了甚麼,而是判斷幾時該出聲、幾時應該保持安靜。EgoMemo對準的正是這個空位:它屬於一個面向連續第一身影片的記憶增強代理系統,同時附上 benchmark,目標是讓系統根據累積情境主動提供服務,而不只是等人發問或對每個事件都作反應。

現有做法多數落在兩個範式:reactive,只會被問到先答;semi-proactive,偵測到預先定義事件就回應。作者認為這兩類方法都欠缺對使用者歷史、當前活動與介入時機的判斷,所以用 EgoServe 重新定義問題,把主動協助視為 context-dependent decision problem,再由 EgoMemo用 three-level temporal memory graph、semantic knowledge graph 同 visual embedding archives 做 retrieval-augmented reasoning。

這個 GitHub 項目不止放出模型思路,亦包含 memory-graph construction + retrieval pipeline、evaluation suite、dataset annotation 與 streaming demo。理解部署方式並不複雜:先準備 Python 3.10 環境與 .env 內的 API keys、資料路徑,再下載 EgoServe 註釋及對應來源影片,之後按不同資料集分開執行 processing 與 retrieval 兩階段,前者建立記憶圖,後者生成 proactive-service response。

  • EgoServe 收錄超過 3,000 個 service instances,橫跨 4 個 temporal memory horizons 與 10 類服務
  • EgoMemo 採用 training-free 設計,重點放在記憶組織與檢索,而不是再訓練一個大模型
  • 項目同時支援 EgoLife、HoloAssist、CaptainCook4D、EyeWo / ESTP-Bench、OVO-Bench 等資料來源
  • retrieval 可切換 caption retrieval、visual retrieval 等設定,方便做 ablation

EgoMemo 不是追求單次問答表現,而是補上長時間情境累積後的判斷能力。受益最大的是做 egocentric AI、智能助理、穿戴式裝置或多模態 Agentic 項目的研究團隊;限制也同樣直接,整個流程依賴外部影片資料、API keys 與多階段處理,重點更接近研究基線與評測框架,而未算一個即裝即用的消費級產品。相關模型與組件方面,儲存庫示例已出現 QwenVL 3 8B Instruct、GPT-5、Gemini 等作為 caption 或 response 端選項。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Embedding, 多模態模型, 模型訓練, OpenAI, Gemini, API, KnowledgeGraph, Python, Dataset 數據集

Hallo4D 點樣補救 3D 與 4D 生成穿崩

3D同4D生成最怕畫面一轉角度就走樣,或者動起來之後角色忽然變臉。Hallo4D想處理的,正正是這類跨視角、跨時間都難收拾的失真。

4d boy

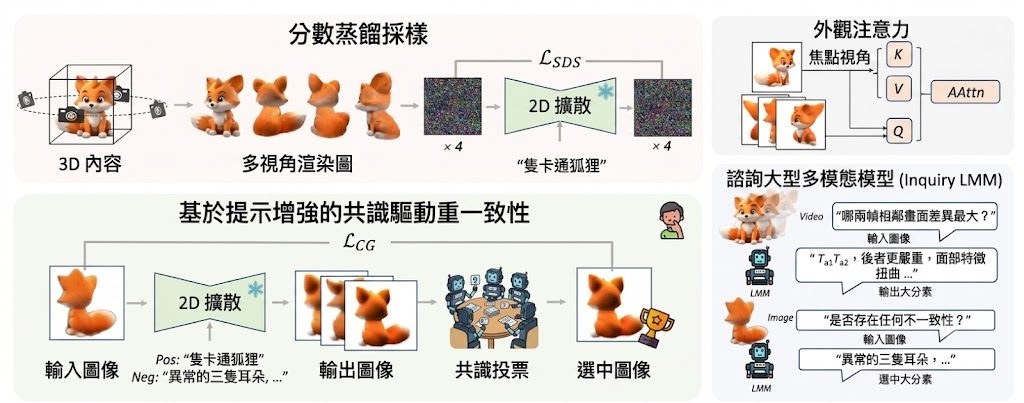
做3D同4D內容生成,最麻煩往往唔係單張畫面唔夠靚,而係鏡頭一轉、時間一推進,物件結構開始重複、錯位,角色仲會出現 jitter、identity flicker 同 structural drift。Hallo4D沿住呢個痛點出發,屬於一個研究型框架,重點唔係再訓練新模型,而係插入現有流程,幫3D與4D生成結果找出並修正時空不一致。

而家常見做法多數仍然依賴 2D diffusion-based supervision,但欠缺直接約束幾何一致性的機制,所以會出現 duplicated structures 同 misaligned geometry;去到4D,問題再擴大到時間軸。Hallo4D提出的是 generation-detection-correction 範式:先生成,再用 Large Multimodal Models(LMMs)從 multi-view、multi-frame renderings 判斷邊度出錯,之後以 image-space consistency optimization 做修正,並用 multi-model voting 揀較穩定的候選結果。

它不是跟同類方法鬥基礎生成能力,而是做一層 tuning-free、model-agnostic 的補救機制,聲稱毋須 retraining 或 architectural modification。代價亦很明顯,整個流程更依賴外部 LMM 推理、候選修正與投票判斷,較像高質後處理,而唔係最省算力的路線。

  • 重點放在 spatio-temporal hallucination mitigation,不是直接取代原有 3D / 4D 生成模型
  • 用 LMMs 檢查多視角、多幀輸出,再引導修正不一致位置
  • 針對時間穩定性加入 optical flow 驅動的 keyframe sampling
  • 以 CSEA、log-dynamic-range loss 同 union-of-frusta visibility pruning 處理曝光崩壞

目前較適合當作研究方法理解,而不是即開即用的產品工具。測試方式大致應是把它接到既有 Text-to-3D、Image-to-3D 或 4D pipeline,對比 baseline 與修正後結果,觀察多視角幾何、角色身份穩定度同曝光控制有無改善;頁面亦提供多組 visual comparisons,以及在 SV4D 的額外 4D 場景結果。

十分適合本身已經在做 3D / 4D 生成、又經常被跨視角穿崩同時序閃爍拖慢流程的研究團隊。相關脈絡亦值得一併看:Hallo3D主攻 multi-view-consistent 3D generation,Hallo4D則把範圍擴展到統一處理 3D + 4D 的時空一致性;量化表現,現有儲存庫文字未見完整指標表,判斷仍要以論文與項目頁面的可視化對比為主。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, Image, 3D, 中國, Dataset 數據集, 任何模型

KnowAct-GUIClaw 跨平台 GUI 代理

想讓代理真正代你點按、輸入同切 App,難處從來不只係識畫面。KnowAct-GUIClaw把記憶、路由同技能接埋,重點放喺長流程任務穩定完成。

GUIClaw

要代理跨桌面、Android、iOS 同 HarmonyOS 幫你做事,最易失手的位通常唔係單一步驟,而係多個 App 之間點樣接續執行。KnowAct-GUIClaw屬於 Agentic 自動化框架/工具,核心處理的是長流程 GUI automation:由理解意圖、揀路徑、執行操作,到把經驗寫回記憶與技能庫,令之後的任務唔使每次由零開始。

同類 GUI agent 常見做法,是把畫面理解同動作決策綁成單次 observe-reason-act 迴圈;作者認為這種固定範式一遇上跨 App、跨系統流程,就容易缺少任務分解、歷史經驗同可重用技能。KnowAct-GUIClaw改用 Know–Route–Act–Reflect,前面先整理證據與路由,後面再把軌跡蒸餾成 memory 同 skills,取向明顯偏向「愈用愈熟手」而唔係單次回答最聰明。

部署上有兩條路:一條是完整 host,配合 nanobot webui、gateway 同 agent 去跑;另一條是獨立 guiclaw 工具,讓其他 host、腳本或終端直接調用。GUI automation 會改變裝置狀態,驗證任務應先用 dry-run,同時用測試裝置或測試帳號,這點對企業內部流程、自動測試、數碼助理場景尤其重要。

  • 支援 desktop、Android、iOS、HarmonyOS,重點係跨平台一致流程
  • 以 memory store 同 skill store 補強長流程任務,而唔只靠即場推理
  • 在 MobileWorld benchmark 取得 64.1%,頁面稱超過多個 open agent frameworks 及部分 closed agents
  • 對不同底模有泛化效果:Kimi-2.6 提升 8.5%,Qwen3.5-35B-A3B 提升 16.2%

受惠最大的,會是要處理重複 GUI 流程的團隊,例如行動裝置測試、跨 App 任務編排、個人助理型代理開發。不過它的價值未必只在榜單,而係把 GUI agent 從「會操作畫面」推向「會累積經驗再操作畫面」。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 工具, Dataset 數據集, Skill 技能

Ring-Zero 1T 參數零樣本強化學習

唔靠人工標註推理步驟,模型一樣可以練出更成熟的思考方式。Ring-Zero 想解的,正是大模型推理愈大愈難教、愈難穩定訓練的問題。

Og image

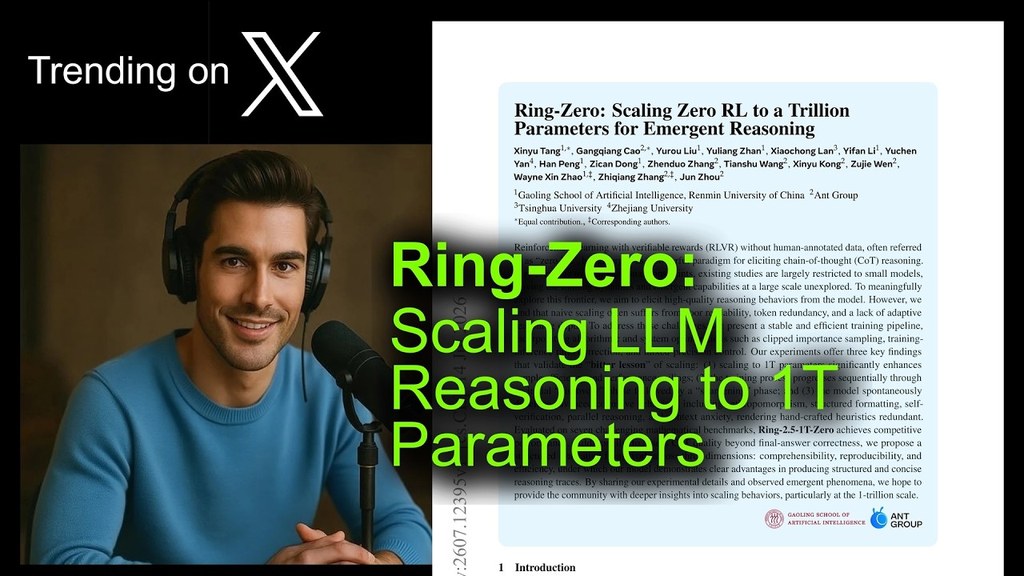
當模型愈做愈大,真正困難唔只係算力,而係點樣令佢喺冇人工示範推理鏈嘅情況下,仍然學到清晰、有效又可延伸嘅思考方式。Ring-Zero 屬於大型語言模型推理訓練研究,重點放喺將 zero RL 擴展到 1T 參數,觀察推理能力會唔會隨規模自然湧現。

呢個項目要處理嘅問題幾具體:以 Reinforcement Learning with Verifiable Rewards(RLVR)直接訓練 base model,雖然可以避開昂貴嘅人工 chain-of-thought(CoT)資料,但簡單放大規模會帶來可讀性差、token 冗餘,同埋推理深度唔夠靈活。Ring-Zero 針對呢幾個卡位,加入 clipped importance sampling、training-inference ratio correction 同 mixed-precision control,目標係令訓練流程更穩定,輸出亦更精煉。

同常見依賴監督式推理示範或者較細模型做 zero RL 嘅做法相比,Ring-Zero 想證明一件事:規模本身會改變模型學推理嘅方式。研究者觀察到訓練大致會經歷「discovery」再到「sharpening」兩個階段,而且模型會自發出現 anthropomorphism、structured formatting、self-verification、parallel reasoning 同 context anxiety 等行為,顯示部分人手設計技巧未必再係必要。

  • 把 zero RL 擴展到 1T 參數,核心焦點係大規模推理湧現
  • 唔用人工標註 CoT,改用 RLVR 從 trial-and-error 中學習
  • 除咗最終答案,仲額外檢查 comprehensibility、reproducibility、efficiency
  • 在七個數學 benchmark 上,Ring-2.5-1T-Zero 表現具競爭力

對研究 LLM 推理、模型訓練同 scaling law 嘅讀者,呢個項目最有參考價值。佢唔單止關心分數高低,仲嘗試回答大模型點樣學會更短、更有結構、亦更容易重現嘅 CoT;呢一點對之後做 AGI、模型訓練同推理優化都幾關鍵。

Youtube · Paper

Categories: 清華大學, 模型訓練, 安全, AGI, 中國, Dataset 數據集

MonkeyOCRv2 文件通用 OCR 底座

掃描文件、表格、公式到場景文字,往往要分開處理。MonkeyOCRv2想做的是用同一套視覺編碼器,接住多語言文件理解與 OCR 工作流。

overview

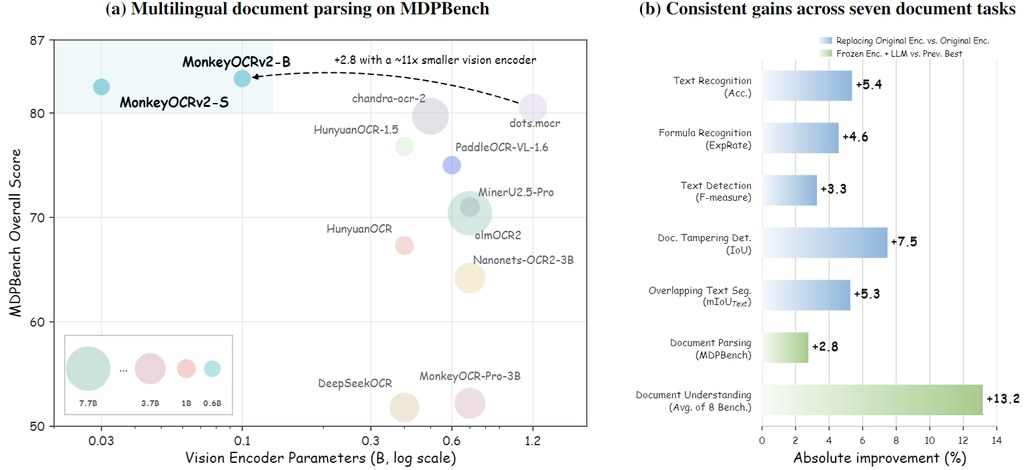
文件 AI 最麻煩的地方,在於文字辨識、版面解析、文件理解、公式辨識,甚至竄改檢測,很多時都要拆成幾個模型串起來。MonkeyOCRv2 把自己放在視覺文字基礎模型的位置,核心不是只追單一 OCR 指標,而是想用同一個 encoder 同時覆蓋多語言文件 parsing、understanding、text recognition、formula recognition 以至 scene text detection。

它採取的路線很明確:不像部分做法會按任務各自訓練小模型,MonkeyOCRv2 強調 fine-grained text modeling、cross-task representation learning 同 cross-lingual generalization,等於先把「文字作為視覺內容」這件事學得更深,再把能力分流到不同文件任務。這種取向的好處,是同一套底座較適合研究團隊或產品團隊整合工作流;代價則是現有資訊仍以模型發布為主,完整效能對比與部署細節還要結合論文與 checkpoint 再判斷。

現階段最值得留意的,是項目已不只放出單一模型名稱,而是分成幾條較清晰的能力線。 MonkeyOCRv2 vision encoder,以及面向 multilingual document parsing 的 MonkeyOCRv2-Parsing、面向 efficient document understanding 的 MonkeyOCRv2-Und,並提供 Hugging Face 與 ModelScope checkpoint,代表測試方式大致會圍繞下載權重後,按任務接入 parsing、recognition 或 understanding 流程,而不是單純打開一個聊天介面就完成。

  • 涵蓋 OCR、文件理解、公式辨識、竄改檢測、重疊文字分割等多類任務
  • 提供 MonkeyOCRv2-S、MonkeyOCRv2-B、MonkeyOCRv2-AS,不同 backbone 對應不同場景
  • S、B 版本偏向 Recognition / Parsing / Understanding,AS 版本偏向 Detection / Segmentation
  • 已公開 Demo、Hugging Face 集合與 MonkeyDocv2 數據集線索,方便交叉驗證

從現有公開資訊看,這個項目較適合做 Document AI、智能審核、票據與表單處理,也適合想比較 dots.mocr、PaddleOCR-VL、Qwen3-VL 這類路線差異的人。它未必是最輕量的選擇,但「一個編碼器橫跨多任務與多語言」這個方向,對需要長期維護文件工作流的項目有相當吸引力。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Qwen, OpenAI, 影像處理, 框架, Medical醫學, Dataset 數據集

RINO 用圖像編輯統一視覺任務

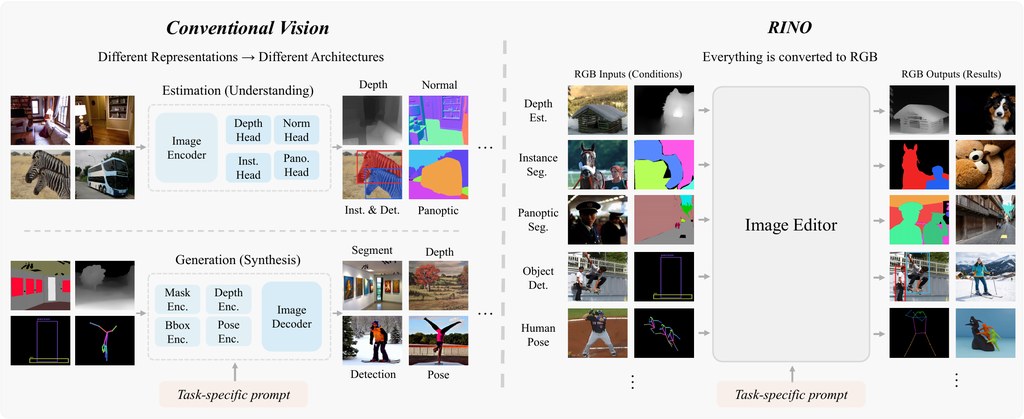
把深度、分割、姿態估計都改寫成 RGB 圖像輸入輸出,RINO 想驗證一個大膽方向:凍結式 image editor 能否直接兼任理解與生成。

RINO unifies vision under a single RGB interface: one frozen image editor, driven by a task-specific prompt, handles est

與其為每個視覺任務各自接駁 head、decoder 或 adapter,RINO 選擇更激進的路線:全部改寫成 RGB In, RGB Out。它屬於一個以 PyTorch 實作的研究型評測與實驗項目,核心問題是檢查單一凍結式 image editor,能否同時處理視覺理解與條件生成,而毋須為深度、segmentation、pose 之類任務另建模組。

這個定位帶來的吸引力很直接:流程統一、介面統一、後端也能互換。項目目前接上三個開源 image-edit 模型作為黑盒後端,包括 Qwen-Image-Edit、FireRed-Image-Edit 與 LongCat-Image-Edit;任務目錄結構一致,每個 task 都有獨立 evaluate 程式與 output 結果,方便逐項跑 benchmark,比起各任務各寫一套推理邏輯,整理與比較都省事得多。

但它的取捨同樣明顯。RINO 並沒有訓練新模型,也不做 fine-tuning,而是堅持用 released weights 直接測 zero-shot 表現;好處是比較乾淨,較能反映 image editor 本身的泛化能力,限制則是上限會被原生編輯模型綁住,對結構化輸出是否穩定、是否容易受 prompt 與渲染方式影響,仍要按任務逐個看。

  • 重點不是追求單一任務最佳成績,而是測試「同一個 RGB 介面」能否橫跨多類視覺工作
  • 三個後端可互換:Qwen-Image-Edit、FireRed-Image-Edit、LongCat-Image-Edit
  • 採用 copied official metric code 評分,數字理論上較容易與既有文獻對齊
  • 部署理解不複雜:安裝依賴後,按 task 準備 dataset,再選 BACKEND 與對應 MODEL 便可執行評測

較適合留意這個項目的,會是想研究 unified vision 介面、比較不同 image editor 泛化力,或者想把多個 benchmark 收攏到同一工作流的團隊。現有資訊未列出完整成績表,但它已清楚交代評測方法、資料夾規格與模型來源;作為研究驗證平台,價值在於提出一套可重覆比較的做法,而不是即刻取代每類任務的專用模型。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, Image, 影像處理, Python, Dataset 數據集

Page 18 of 29
1 … 16 17 18 19 20 … 29