Gemini Spark 登陸香港:AI 代你長時間跟進工作

想交低指示後由 AI 繼續處理雜務,Gemini Spark 就是朝這個方向而來。它把電郵、文件、搜尋與排程串連起來,減少你反覆催促。

Og image

最易理解 Gemini Spark 的方式,是把它看成一個會在背景持續運作的 Agentic AI 助手:你先交代目標,它再慢慢把零散工序接起來,處理那些花時間、又不想不停重複提示的工作。Google 已在香港推出這項服務,定位很清楚,就是幫用家把日常行政與資料整理自動化。

它接上的重點,不是單次問答,而是整段工作流。Gemini Spark 運行於 Google 的雲端基礎設施,能原生連接 Workspace 工具,例如 Gmail 和 Docs,毋須另外設定,就可以整理混亂的電郵往來、彙整行業消息、從舊文件抽資料做後續安排,甚至進行網上資料搜集、比較選項與完成預訂。

Google 提到,系統以 tasks、custom skills 和 schedules 這類機制去安排工作,讓用家用自然語言交代規則、例行事項與時間觸發條件,毋須寫程式。另一個分別在於,它不會因為你闔上手提電腦或鎖上手機就停下來,背景流程仍可繼續運作,較適合需要長時間跟進的文書與研究工作。

  • 支援背景持續執行,不用反覆重新提示
  • 可原生連接 Gmail、Docs 等 Workspace 工具
  • 能處理資訊整理、排程準備、網上研究與預訂類工作
  • 高風險動作前會先要求明確同意

控制權仍然留在用家手上。Google 表示,Gemini Spark 會按照用家指示運作,用家可決定何時啟用,以及容許它接觸哪些應用程式;遇到交易或發送電郵等高風險操作,系統亦會先徵求明確授權。現時香港由 Google AI Ultra 訂閱用家率先使用,Google AI Pro 用家的開放時間會在未來數星期逐步擴展。

項目主頁

Categories: Agentic, Google, Gemini, 提示詞, 框架, 香港, 工具, 編程, Skill 技能

ViMax 把影片生成變成多代理流程

想由一句想法走到完整影片,卡位往往唔係生成本身,而係分鏡、節奏同角色一致性。ViMax把呢條流程拆成多個 Agent 協作,重點放在先規劃、再生成。

Repository image for hkuds/vimax

直接由文字生成影片,最易出問題的通常不是畫面夠不夠靚,而是故事走向會散、鏡頭難連貫、角色設定前後不一。ViMax把這些環節拉回工作流處理:它屬於 Agentic Video Generation 類型的開源項目,用多個 Agent 分別扮演 Director、Screenwriter、Producer 與 Video Generator,目標是把影片生成由單次出圖,變成可規劃的多步驟流程。

這種取向的分別,在於它不只追求「一句提示詞出片」,而是先把敘事、鏡頭與製作安排拆開,再交回生成模組執行。對內容創作者、想做短片原型的團隊,或者研究多代理協作點樣落地到視頻模型工作流的人,這個項目會較有參考價值;但儲存庫提供的資訊目前偏簡短,未見完整測試結果、部署細節或清晰的安裝流程。

從名稱與描述判斷,ViMax較像一個協調層或框架,而不只是單一視頻模型。它想補的是影片生成裡最難靠單一模型穩定完成的前置規劃,因此價值未必在最終某一幀畫質,而在於整段片能否保持節奏與結構。不過,原始資料未交代它串接哪些底層模型、怎樣處理角色一致性,亦未提供性能指標,現階段較適合先當成研究方向與工作流設計來理解。

  • 把影片生成拆成 Director、Screenwriter、Producer、Video Generator 多個 Agent
  • 重點放在規劃與協作,不只是單次提示詞生成
  • 適合研究多代理、多步驟視頻製作流程的人參考
  • 儲存庫描述很短,暫時未見完整安裝、部署與評測資訊

ViMax最吸引人的地方,是它把「生成影片」理解成一條需要分工的製作鏈,而不是單一模型一次完成所有事。現有資訊仍不足以判斷成品穩定性或生產可用度,但作為開源方向,它清楚對準了多模態模型在長段影片敘事上的核心難題。

GitHub

Categories: 開源, 香港大學, Agentic, AI productions, Video

Color Pass-Through 重新做色彩校準

想令手機畫面更接近眼前真景,難處往往唔係相機或螢幕單獨夠唔夠準,而係兩者夾埋之後會一路累積偏差。Color Pass-Through就係針對呢個落差,將整條 camera-display 路徑一齊學起來。

Color Pass-Through teaser

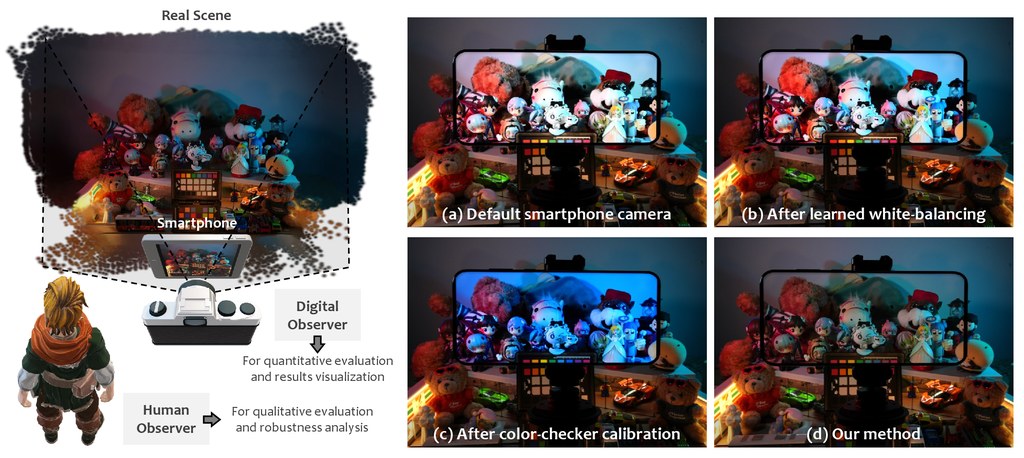
想像你透過手機或頭戴裝置睇現場畫面,明明場景喺眼前,畫面顏色同亮度卻總有一層隔膜。Color Pass-Through 針對的正正係呢種 camera-display 不一致:它屬於影像處理研究項目,以端到端方式學習固定裝置上的 camera-display 路徑,目標唔係單獨校正相機或螢幕,而係令人經過裝置觀看時,感知上更接近真實場景。

作者明確反對傳統 ICC workflow 呢種兩段式校準範式。舊做法會先分開處理相機同顯示器,再靠預先定義的中介色彩空間接駁,誤差容易逐步累積;Color Pass-Through 改為直接學完整投影路徑,並為每位觀察者做 one-step calibration。呢個取向的好處係更貼近人眼最終見到的結果,代價就係它依賴特定 device pair,同時帶有 observer-specific 設定,泛化方式同傳統標準化流程唔一樣。

目前公開資訊顯示,項目已放出完整 training and inference pipeline,並提供兩款支援裝置的 pretrained checkpoints,所以較合理的理解方式係:它首先係研究原型,其次先係可重現的程式碼。資料集仲準備公開,Android toy example 亦仍在開發中,部署重點暫時仍然放喺已支援裝置上重現論文結果,而唔係即插即用地套入任何手機。

  • 核心改動係把 camera 與 display coupling,唔再經固定中介色域分開校正
  • 以每位使用者一次校準換取更貼近主觀觀感的色彩與亮度表現
  • 人類評分提升 +2.0 分(5 分制),亮度 4.32/5,色彩 4.03/5
  • 定量結果亦有明顯優勢,PSNR、ΔE、STRESS 在兩款商用手機上都優於列出的基線

同類方法很多時會加強 white balance、ColorChecker mapping,或者在既有 ISP 後面再補一層修正;這個項目則直接把問題重寫成特定裝置、特定觀察者的整體感知重建。對做 AR/VR pass-through、顯示校準、計算攝影研究的人最有參考價值,尤其當重點唔係標準色彩流程有幾完整,而係人眼最後見到的畫面到底似唔似真景。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 華為, 模型訓練, 蘋果, Dataset 數據集

AsySplat:3D 場景重建更省算力

長場景的新視角合成,常見難點是算力花得多,但畫面未必再明顯變好。AsySplat 直接把幾何和外觀分開處理,在保留細節之餘減少重複計算。

Teaser Image

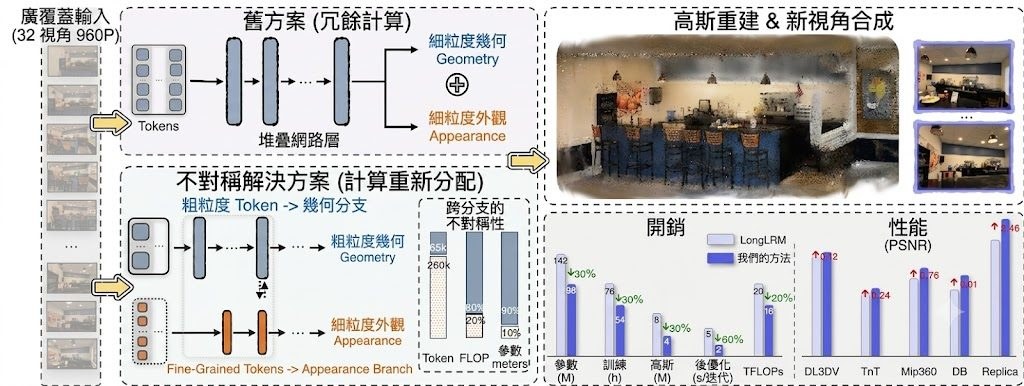
AsySplat 是一個用於 3D Gaussian Splatting 的重建框架,主力解決長序列、廣覆蓋場景做新視角合成時,訓練和推理都太重的問題。現階段這個 GitHub 儲存庫主要提供項目頁、論文連結和資源,程式碼尚未公開,所以要理解它,重點放在方法設計而不是直接安裝部署。

它的做法是把 geometry branch 和 appearance branch 分開,前者處理較粗粒度的資訊,後者用較少參數補回外觀細節,再用 bilateral connections 互相引導。這種取向和一般把所有資訊一起硬塞進去的做法不同,目標是把算力用在更值得的位置。

從現有資料看,AsySplat 比較適合做多視角場景重建、研究級新視角合成,或需要在較大輸入規模下控制訓練成本的團隊。同時使用 sparse attention module,結合 convolution blocks 和 self attention 來減少開銷,並在 32-view 960P 輸入上取得較少參數和較低訓練、推理負擔的結果。

  • 類型:3D Gaussian Splatting 重建框架
  • 目標:降低 wide-coverage scene modeling 的重複計算
  • 特色:幾何與外觀分流處理,再以 bilateral connections 協調
  • 效能:在 32-view 960P 設定下,宣稱比之前的 generalizable models 更省參數和開銷
  • 相關模型:3D Gaussian Splatting、generalizable 3DGS models、novel view synthesis (NVS)

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港城市大學, 香港, 3D, Dataset 數據集

BadWAM 直指 World-Action Models 盲點

BadWAM唔係做更強控制,而係專門測試 World-Action Models 會點樣「想得啱、做錯事」。對研究機械人安全同對抗攻擊的人來說,呢類偏移比一般失敗更值得警惕。

Repository image for LiQiiiii/BadWAM

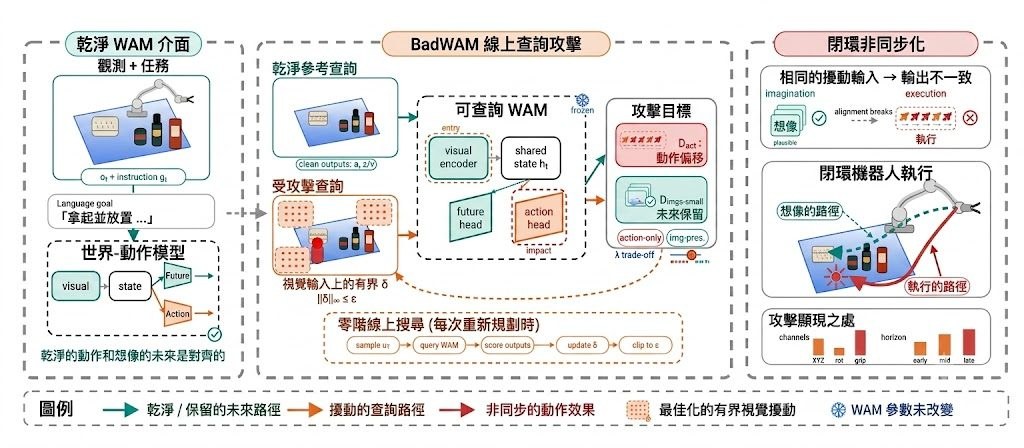
當一個 World-Action Models(WAMs)睇落仍然能夠預測合理未來,但實際控制已經被悄悄帶偏,問題就唔再只是準確率高低。BadWAM 屬於研究型安全測試框架,集中模擬 World-Action Drift Attacks,用細微視覺擾動去拆開「想像」同「行動」之間原本應該對齊的部分。

呢個項目的價值,在於它唔係單純證明模型會失手,而係指出一種更難察覺的失效方式:未來預測仍然似樣,行動卻已經朝向任務失敗。相比一般只睇輸出有冇偏移的對抗攻擊做法,BadWAM更貼近 WAM 的結構特性,分成 Action-only Adversarial Attack 同 Imagination-preserving Adversarial Attack 兩條路線,後者尤其針對「表面正常、實際出錯」的情況。

重點可先睇幾項:
– 支援 query-based 攻擊,重點在凍結的 WAM 上做線上搜尋
– 提供 LIBERO closed-loop attack evaluation,唔只停留在單步分析
– 包含 matched-strength stealth analysis 同 ablation experiments
– 內附 statistics export 與 plotting utilities,方便整理結果

從部署角度看,儲存庫提供的是研究代碼而唔係開箱即用套件,基礎環境指向 Python 3.10+,並建基於 FastWAM。README 亦講明未附 model checkpoints、LIBERO data、dataset statistics、RoboTwin assets 同實驗輸出,所以要重現結果,仍然要自行補齊相關資源與依賴。

現有公開結果已經說明這個框架唔只係概念展示。在 LIBERO closed-loop 測試中,action-only WAM 成功率由 96.5% 跌到 43.1%,joint WAM 亦由 98.1% 跌到 61.5%。受益最大的會係做機械人控制、WAM 安全、對抗魯棒性測試的研究團隊;對一般應用開發者來說,它未必直接幫你部署產品,但很適合作為檢查模型是否「睇落可靠、其實已偏航」的驗證工具。

項目主頁 · GitHub

Categories: 開源, 香港理工大學, 世界模型, 框架, 香港, Python, 安全, Dataset 數據集

PalmClaw 把手機變成可落地 AI 助理

PalmClaw唔係把桌面代理硬搬上手機,而係直接把 Android 當成代理運行環境。想要私隱、速度同部署簡化兼顧,呢個方向幾有意思。

PalmClaw Line Logo (light mode)

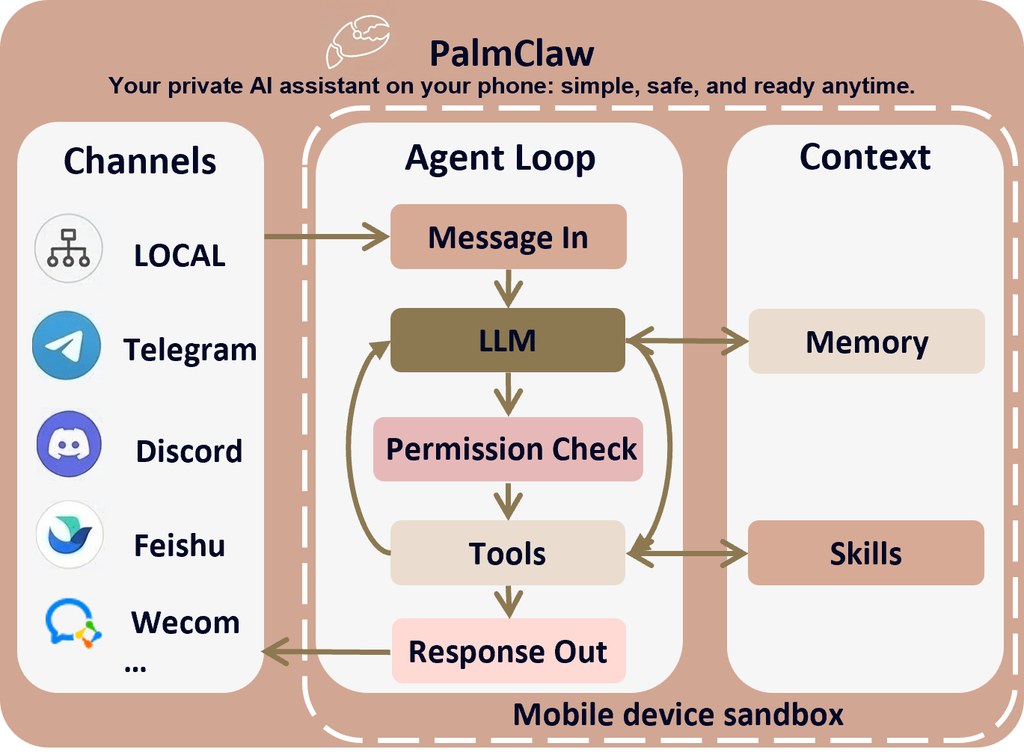
想在手機上跑 AI 助理,最大問題通常唔係模型夠唔夠聰明,而係行動流程太依賴點擊介面、太多步,又難清楚限制每次操作。PalmClaw 選擇唔跟 GUI 自動化嗰條路走,而係做成一個原生 Android 代理框架,直接在裝置內管理 session、memory、skills、tools 同 agent loop,處理的是「手機可唔可以自己成為代理執行環境」呢個問題。

同類做法很多會把手機當成一個要被點擊、滑動、輸入的目標畫面,PalmClaw則把裝置能力包裝成有明確參數同結構化結果的 device tools。呢個取向的好處很直接:動作邊界更清楚,執行鏈更短,亦較少受介面改版影響;代價是它偏向整合系統能力與通道,而唔係模擬人手操作所有 App 畫面。

安裝理解上亦算直接,項目已提供 APK,重點不是先搭 server,而是把代理本身部署到 Android。應用程式內可管理設定、工具同 channels,並連接 Telegram、Discord、Slack、Feishu、Email、WeCom 等通道;資料與硬件存取留在本機,較適合在意私隱、想減少雲端依賴的個人用戶,或者要做流動工作流驗證的小團隊。

  • 原生 Android 代理框架,重點在裝置內執行而非遙控手機介面
  • 沿用 OpenClaw 啟發,但定位更貼近直接 mobile deployment
  • 提供 APK,可在手機內完成設定、工具管理與通道連接
  • 論文數據提到,相比最強基線有 11.5% 相對任務成功率提升,完成時間減少 94.9%
  • 相關脈絡包括 OpenClaw,以及以 Large Language Model(LLM)agent 為核心的 session、memory、skills、tools 架構

PalmClaw最值得留意的地方,在於它把手機代理由「會操作畫面」改成「直接調用裝置能力」。對想把 AI 助理放進日常通訊與個人裝置流程的人來說,這種 local-first、明確工具邊界的設計,比純粹追求花巧自動化更接近可長期使用的方向;現階段平台重心明確落在 Android,跨平台與生態覆蓋仍要看後續發展。
項目主頁 · GitHub · Paper

Categories: 開源, 香港理工大學, Agentic, Gemini, 香港, Discord, OpenClaw, Anthropic, Skill 技能

MetaView 補回生成的空間感

只用一張相就想轉出大幅度新視角,最難是畫面似真之餘仲要守住空間比例。MetaView 針對的正是這個卡位。

teaser

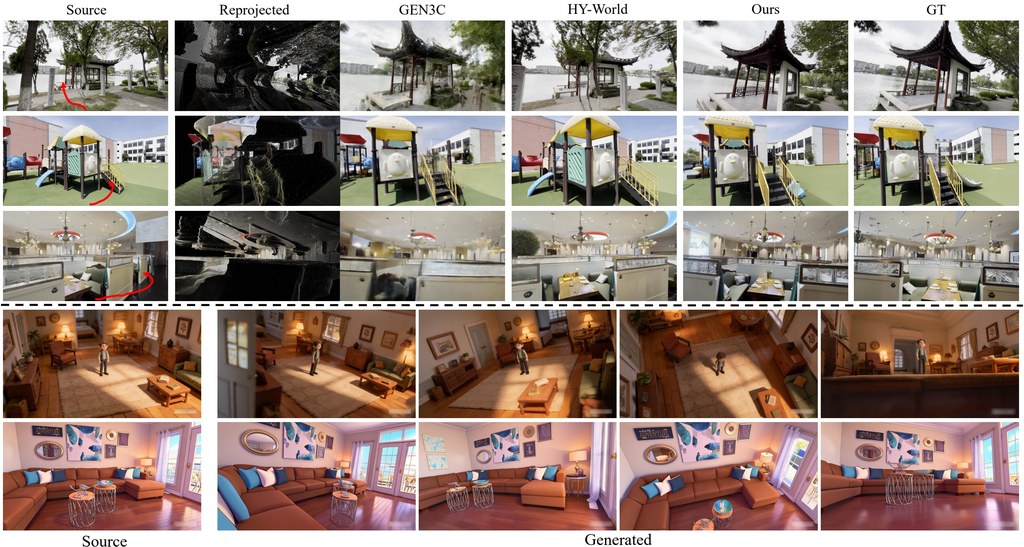
單靠一張圖片生成大角度新視角,很多方法一轉得遠就會出現結構鬆散、比例飄移,鏡頭控制亦未必準。MetaView 屬於影像生成框架,集中處理 monocular novel view synthesis,目標是在不做顯式 3D reconstruction pipeline 的前提下,仍然保住 geometry consistency 同可控的 camera pose rendering。

它的取向幾清楚:唔想被重建流程綁死泛化能力,但又唔接受純 implicit 方法常見的 scale drifting。項目把 Depth Anything 3 提供的 implicit geometry priors 接到 pretrained MM-DiT backbone,做法是加入 non-invasive parallel attention layers;同時再用 modified RoPE,配合 PRoPE 為 z-axis 留出額外子空間,把場景尺度固定在較一致的 3D metric space。

對研究團隊、做 novel view synthesis、3D-aware image generation,或者需要從單張圖控制鏡頭輸出的工作流,這個項目值得留意。現有資訊較像研究原型:README 與 project homepage 已提供 paper、demo 與 model 入口,但未見完整安裝與部署細節,所以現階段較合理的理解方式,是先用 demo 看大視角轉換與 spherical poses control 的效果,再等待公開模型與程式流程補齊。

  • 單張圖片輸入,主打大幅度 viewpoint changes 下仍保持高保真輸出
  • 不走 explicit 3D reconstruction pipelines,換取更高彈性與泛化空間
  • 用 Depth Anything 3 幾何先驗補結構,再用 modified RoPE 處理 scale anchoring
  • 比較對象包括 ViewCrafter、Gen3C、Voyager、PE-Field、HY-World、Lingbot-World

MetaView 在具挑戰性的 monocular large viewpoint changes 測試中,表現優於多個 reconstruction-based 與 implicit 方法,強調的是 geometry consistency、precise controllability 與 generalization。現階段較適合把它視為一個方向鮮明的研究項目:它不是單純追求更靚畫面,而是嘗試把單圖生成長期欠缺的空間尺度感補回來。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, Image, 影像模型, 香港, 3D

AMID 把醫學影像建模流程交畀代理協作

AMID唔係只幫你諗模型,而係想連驗證、提交物料同審計痕跡一併產出。你可以把它理解成面向醫學影像比賽與研究任務的自動化建模工作流。

AMID logo

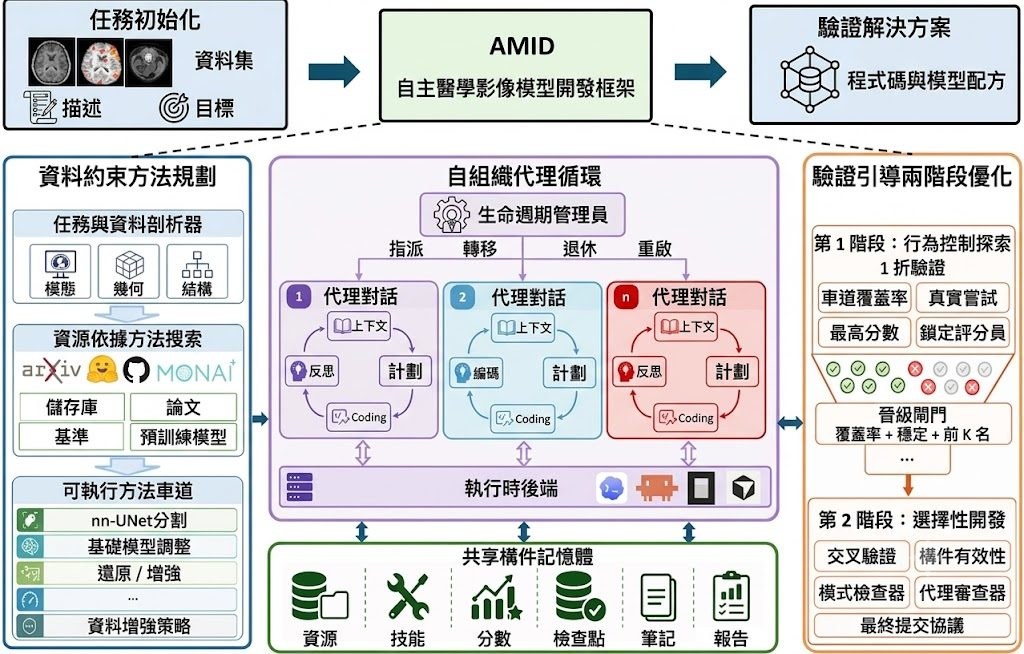
醫學影像建模最麻煩的位,往往唔係只係揀網絡,而係每個任務都有唔同資料形態、指標、切分規則同提交要求。AMID把呢個痛點拉到枱面:它屬於一個 autonomous multi-agent framework,目標唔係產生一段建議文字,而係交出可訓練、可推理、可驗證、可提交的完整模型產物。

現有通用 MLE agent 往往沿用比較粗略的搜尋與試錯範式,先提方案、再寫碼、再靠結果反覆修補;作者認為放到醫學影像場景,呢種做法容易忽略資料條件、驗證協議同提交格式。AMID改用 Data-Conditioned Method Planning,先按任務資料與可運行資源整理出可執行的 method lanes,再用 Verification-Guided Two-Stage Optimization 由早期廣泛探索,轉去後期集中追蹤有潛力路線,同時持續檢查 metric computation、validation protocol 同 prediction artifacts。

呢種取向的差異,在於它把「做得出分數」同「流程可核對」放埋一齊處理。對醫療 AI 團隊、挑戰賽參賽者,或者要同時管理 2D 影像、3D volumes、segmentation masks、class labels 等異質資料的人,AMID的吸引力在於減少人手串接流程的時間;代價是它目前仍以技術報告與任務解法報告為主,README亦寫明 source code 尚未釋出,暫時未到可以直接部署測試的階段。

效能方面,AMID用 ReX-MLE 的 20 個 medical imaging challenge tasks 做基準,比較對象包括一般用途 MLE systems,同時拿 human-designed challenge solutions 作參照。作者指出它整體表現優於被評測的通用系統,部分任務接近或追平人手設計方案;現階段較適合把它理解成一套清晰的方法論與工作流藍圖,而唔係即裝即跑的開源工具。

  • 核心定位係 autonomous multi-agent framework,處理醫學影像模型開發與驗證交付
  • 主要方法包括 Data-Conditioned Method Planning 同 Verification-Guided Two-Stage Optimization
  • 輸出唔止模型建議,仲包括 training code、inference code、weights、prediction files 同 audit trail
  • 基準測試來自 ReX-MLE 的 20 個任務,整體表現優於通用 MLE systems
  • 目前已公開 technical report 同 20 份 solution reports,source code 尚未發布

相關模型與系統脈絡方面,AMID直接對比的是 general-purpose MLE systems,同時以 human-designed challenge solutions 作為高水位參考。它未有把重點放在單一 backbone 或某個固定醫學影像模型,而是把多代理規劃、優化與驗證流程包成可重複的方法,呢點比單次調參工具更值得留意。

GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 多模態模型, 模型訓練, 微軟, Image, 影像處理, 框架, 香港, Medical醫學, 3D, Dataset 數據集

SpectraReward:用 MLLM 反讀圖片做文生圖獎勵

想提升文生圖結果,但又唔想另外訓練獎勵模型,SpectraReward提供了一條更直接的路。它用預訓練 MLLM 反過來讀圖還原提示詞,作為生成好壞的依據。

Og image

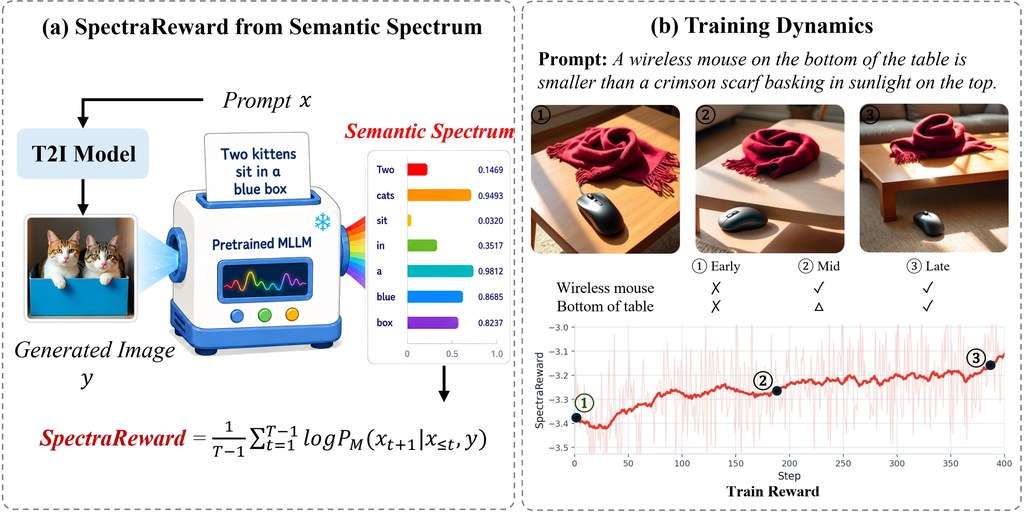
文生圖訓練最麻煩的一環,往往不是生成本身,而是怎樣穩定判斷圖片有冇跟足提示詞。SpectraReward 屬於影像生成 reinforcement learning 的獎勵方法,處理的正是這個問題:它不靠人工偏好標註,也不用再微調 reward model,而是借用預訓練 Multimodal Large Language Models(MLLMs)本身已有的圖文對齊能力,直接替生成結果打分。

核心做法很直觀:先讓 MLLM 看生成出來的圖片,再檢查它能否把原本的 prompt「讀返出嚟」。SpectraReward 用一次 image-conditioned、teacher-forced forward pass,計算 prompt 的平均 log-likelihood,數值越高,代表圖片越能還原文字意圖。相比常見做法要模型直接評分、回答拆解後的驗證問題,這個方法少了額外訓練步驟,也減少了設計評分流程的負擔。

項目亦提出 Self-SpectraReward,對 BAGEL 這類 unified multimodal models(UMMs)尤其有意思。做法是讓同一個模型的 understanding branch,為 generation branch 產生的樣本評分,形成 self-reward。這種安排的重點不在模型愈大愈好,而在 reward 與 policy 是否真正對齊;資料指出,這種內部對齊效果有時可追平,甚至超過更大型的外部 MLLMs。

  • 不需要 preference labels,也不需要 reward-model fine-tuning
  • 只用一次 MLLM forward pass,就可計出 training-free reward
  • 把「圖片能否還原 prompt」變成可量化的獎勵訊號
  • Self-SpectraReward 適合 BAGEL 類 unified multimodal models(UMMs)

從結果描述來看,reward 提升時,複雜場景生成質素也同步改善,表示這個訊號不只理論上合理,亦能推動可見的畫面進步。對正在做 text-to-image generation、影像模型強化學習,或想減少外部獎勵模型依賴的讀者來說,SpectraReward 提供了一種更省步驟、但仍保留語義判斷能力的路線。文中提到的模型包括 MLLMs,以及 BAGEL 這類 unified multimodal models。

項目主頁 · GitHub

Categories: 香港大學, 北京大學, 字節跳動, 多模態模型, 模型訓練, Image, 影像模型, txt2img, 香港

Motion4Motion:免訓練跨物種動作轉移

想將人的動作套到熊貓、鵝,甚至家具身上,Motion4Motion 提供一種毋須骨架與額外訓練的做法。它把重點放在畫面中的運動流,而唔係角色骨骼。

Og image

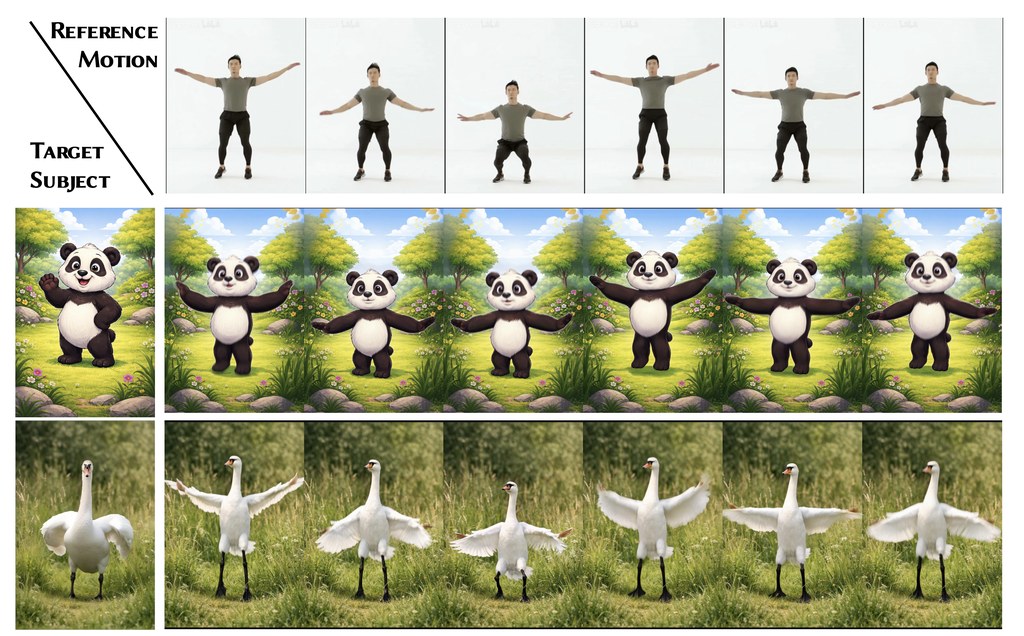
當角色外形差很遠,傳統動作轉移最易卡在骨架對唔上:人、鵝、熊貓根本冇共同骨骼模板,結果常見問題包括動作僵硬、身份漂移,或者腳步滑動。Motion4Motion 屬於影像生成/視頻模型方向的研究,直接避開骨架表示,改為從來源影片抽取密集 motion flow,再把動作帶到另一個目標主體身上。

呢個項目的可取之處,在於 training-free。它唔需要為跨物種或跨拓撲角色另行訓練模型,而係建基於凍結的 Diffusion Transformer(WAN-T2V)做兩階段推理:先找出來源影片主體的運動軌跡,再用 TransPE(Transferring Positional Encoding)把重定向後的位置信息注入注意力過程,令目標外觀跟住動起來。

重點可以整理成幾項:
– 毋須 skeleton,較易處理 human → panda、human → goose 呢類外形差異大嘅轉移
– 毋須額外訓練,推理時完成動作遷移,部署門檻較低
– 用 pixel-level motion flow 取代骨架驅動,減少骨架對齊失效帶來的限制
– 建基於預訓練視頻 diffusion transformer,保留生成式模型對外觀細節的表達能力

它會先用 Grounded SAM-2 在來源首幀取樣主體錨點,再靠 diffusion features 建立來源與目標之間的對應,並以 point tracker 追蹤時間上的軌跡。之後在去噪階段重用目標主體的 K/V,配合來自重定向 motion flow 的 RoPE 位置編碼,令 self-attention 按新動作重組畫面。

現有資料指出,Motion4Motion 在多組實驗與應用展示中勝過強基線,亦示範到跨物種轉移,甚至可出現「教枱行路」呢類非典型案例。適合留意角色動畫、視頻生成、動作重定向工作流嘅讀者;不過目前簡介主要集中在研究展示,具體穩定性與邊界情況仍要等更完整實驗細節支持。

項目主頁

Categories: 香港科技大學, 清華大學, 模型訓練, Video, 框架, 教學

Page 4 of 15
1 2 3 4 5 6 15