VerseCrafter 精準控制鏡頭

VerseCrafter 是一套以 4D 幾何控制驅動的影片擴散模型,目標在單張參考圖上同時掌控相機運動與多目標的三維軌跡,讓生成的影片在視角變化與物體遷移間保持高度一致。讓使用者能夠像操控遊戲或電影一樣,精確控制鏡頭和物體的運動,從而生成逼真的動態影片。 一般的 AI 影片模型通常難以同時掌控鏡頭移動和多個物體的動作,VerseCrafter 透過一種全新的表示法解決這個問題:1.  動態世界模擬:它不只是畫出一連串的畫面,而是先在一個隱藏的 3D 空間中建立場景的基礎結構(例如背景點雲),然後加上時間軸,變成 4D。2.  精準控制:鏡頭:你可以指定鏡頭要怎麼飛行(例如從左邊飛到右邊,或是繞著物體旋轉)。你甚至可以指定畫面中的物體要如何移動、旋轉。

VerseCrafter 是一套以 4D 幾何控制驅動的影片擴散模型,目標在單張參考圖上同時掌控相機運動與多目標的三維軌跡,讓生成的影片在視角變化與物體遷移間保持高度一致。讓使用者能夠像操控遊戲或電影一樣,精確控制鏡頭和物體的運動,從而生成逼真的動態影片。

一般的 AI 影片模型通常難以同時掌控鏡頭移動和多個物體的動作,VerseCrafter 透過一種全新的表示法解決這個問題:1.  動態世界模擬:它不只是畫出一連串的畫面,而是先在一個隱藏的 3D 空間中建立場景的基礎結構(例如背景點雲),然後加上時間軸,變成 4D。2.  精準控制:鏡頭:你可以指定鏡頭要怎麼飛行(例如從左邊飛到右邊,或是繞著物體旋轉)。你甚至可以指定畫面中的物體要如何移動、旋轉。

Categories: 香港大學, 騰訊, 視頻模型, 影像處理

ProEdit:開源圖片及影片編輯

ProEdit 透過 KV-mix 在注意力層融合源/目標特徵,及 Latents-Shift 擾動潛在空間,實現高保真編輯。 支援 FLUX、HunyuanVideo 等模型,同時亦整合 Qwen3-8B 解析自然語言指令。 ProEdit 解決傳統反轉編輯過度依賴源圖的問題,能準確變換主體屬性如姿態、數量、顏色,同時保持背景一致。 適用於圖像替換(如老虎變貓、襯衫變毛衣)與影片動態編輯(如紅車變黑車、鹿變牛)。適合 AI 內容創作者、影片後製,plug-and-play 相容 RF-Solver 等工具,在多項基準測試達 SOTA 效能。

ProEdit 透過 KV-mix 在注意力層融合源/目標特徵,及 Latents-Shift 擾動潛在空間,實現高保真編輯。 支援 FLUX、HunyuanVideo 等模型,同時亦整合 Qwen3-8B 解析自然語言指令。

ProEdit 解決傳統反轉編輯過度依賴源圖的問題,能準確變換主體屬性如姿態、數量、顏色,同時保持背景一致。 適用於圖像替換(如老虎變貓、襯衫變毛衣)與影片動態編輯(如紅車變黑車、鹿變牛)。適合 AI 內容創作者、影片後製,plug-and-play 相容 RF-Solver 等工具,在多項基準測試達 SOTA 效能。

ProEdit: Inversion-based Editing From Prompts Done Right

Categories: 香港中文大學, 香港大學, 視頻模型, 影像模型, 影像處理

WorldWarp 非同步視訊擴散影像模型

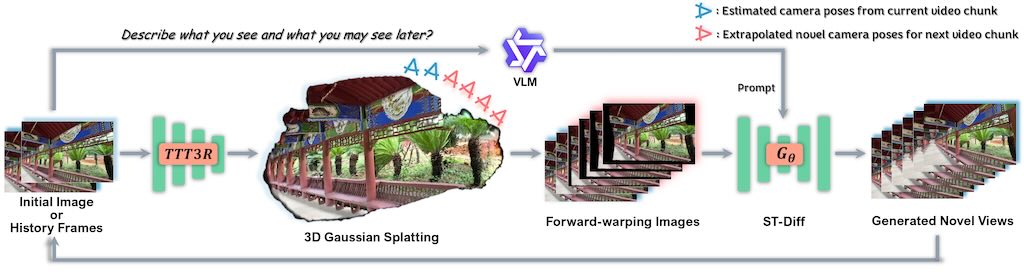
為了建立幾何基礎,WorldWarp 維護了一個透過高斯擴散(3DGS)建構的線上三維幾何緩存。透過將歷史內容明確地扭曲到新的視圖中,該快取充當結構支架,確保每個新幀都遵循先前的幾何形狀。然而,靜態扭曲不可避免地會因遮蔽而留下空洞和偽影。 WorldWarp 使用專為「填充和修正」目標設計的時空擴散(ST-Diff)模型來解決這個問題。 WorldWarp 的核心創新在於空間變化的噪音調度:空白區域接收完整的噪音以觸發生成,而扭曲區域接收部分噪音以實現精細化。透過在每個步驟動態更新 3D 緩存,WorldWarp 能夠保持視訊片段之間的一致性。因此,它透過確保 3D 邏輯引導結構,而擴散邏輯完善紋理,從而實現了最先進的保真度。

為了建立幾何基礎,WorldWarp 維護了一個透過高斯擴散(3DGS)建構的線上三維幾何緩存。透過將歷史內容明確地扭曲到新的視圖中,該快取充當結構支架,確保每個新幀都遵循先前的幾何形狀。然而,靜態扭曲不可避免地會因遮蔽而留下空洞和偽影。

WorldWarp 使用專為「填充和修正」目標設計的時空擴散(ST-Diff)模型來解決這個問題。

WorldWarp 的核心創新在於空間變化的噪音調度:空白區域接收完整的噪音以觸發生成,而扭曲區域接收部分噪音以實現精細化。透過在每個步驟動態更新 3D 緩存,WorldWarp 能夠保持視訊片段之間的一致性。因此,它透過確保 3D 邏輯引導結構,而擴散邏輯完善紋理,從而實現了最先進的保真度。

Categories: 開源, 香港理工大學, 影像模型, 影像處理

Spatia 可更新空間的影片生成

Spatia,一個感知空間記憶的視頻生成框架,它將三維場景點雲顯式地保存為持久的空間記憶。 Spatia 基於此空間記憶迭代生成影片片段,並透過視覺 SLAM 不斷更新它。這種動態-靜態解耦設計增強了整個生成過程中的空間一致性,同時保持了模型生成逼真動態實體的能力。此外,Spatia 支援顯式相機控制和三維感知互動式編輯等應用,為可擴展的、記憶驅動的視訊生成提供了一個基於幾何基礎的框架。

Spatia,一個感知空間記憶的視頻生成框架,它將三維場景點雲顯式地保存為持久的空間記憶。 Spatia 基於此空間記憶迭代生成影片片段,並透過視覺 SLAM 不斷更新它。這種動態-靜態解耦設計增強了整個生成過程中的空間一致性,同時保持了模型生成逼真動態實體的能力。此外,Spatia 支援顯式相機控制和三維感知互動式編輯等應用,為可擴展的、記憶驅動的視訊生成提供了一個基於幾何基礎的框架。

Categories: 香港科技大學, 視頻模型

SemanticGen 加入語意生成影片

SemanticGen 首先在高層語義空間中生成視頻,然後在 VAE 潛在空間中細化細節。SemanticGen 的核心觀點是,鑑於影片中固有的大量冗餘訊息,視訊生成應首先在緊湊的語義空間中進行全局規劃,然後再添加高頻細節——而不是直接對大量的底層視訊標記進行建模。

SemanticGen 首先在高層語義空間中生成視頻,然後在 VAE 潛在空間中細化細節。SemanticGen 的核心觀點是,鑑於影片中固有的大量冗餘訊息,視訊生成應首先在緊湊的語義空間中進行全局規劃,然後再添加高頻細節——而不是直接對大量的底層視訊標記進行建模。

Categories: 香港中文大學, 影像處理

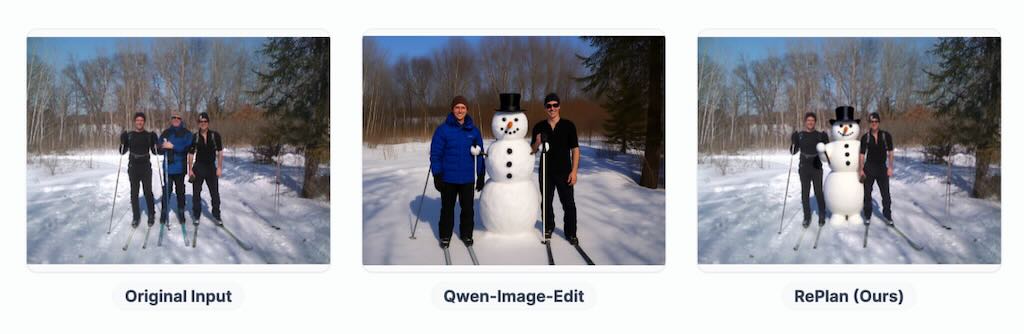
RePlan 圖像編輯框架

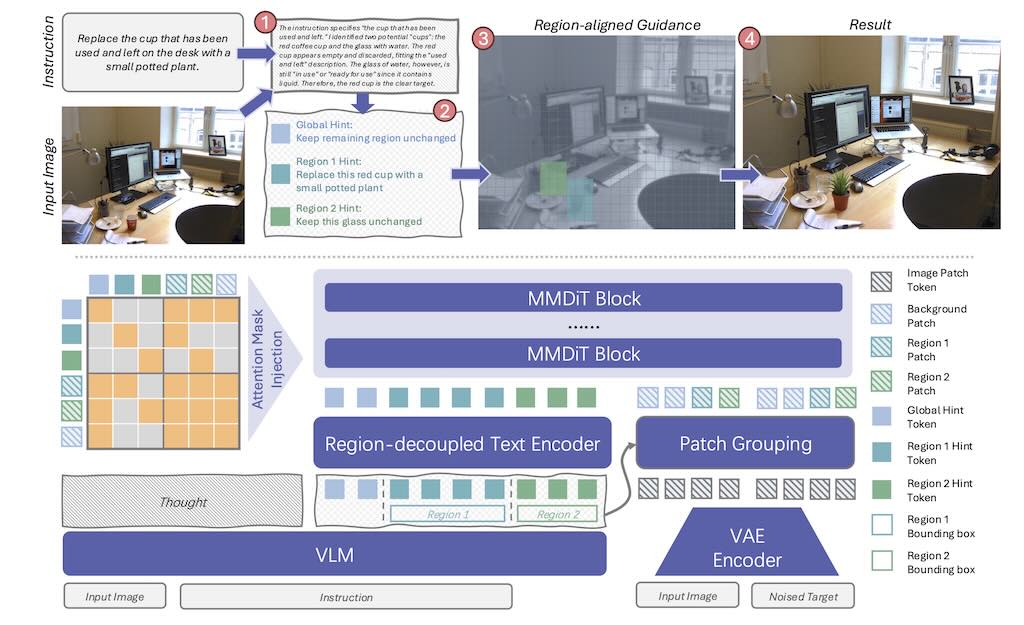
RePlan 是一個基於指令的圖像編輯框架,專門解決指令-視覺複雜度(IV-Complexity)挑戰,透過視覺語言規劃器與擴散編輯器結合實現精準區域編輯。 框架採用「規劃-執行」策略:VLM 規劃器透過逐步推理分解複雜指令,生成邊界框與區域提示;編輯器使用無訓練注意力區域注入機制,支援單次多區域並行編輯,避免迭代 inpainting。

RePlan 是一個基於指令的圖像編輯框架,專門解決指令-視覺複雜度(IV-Complexity)挑戰,透過視覺語言規劃器與擴散編輯器結合實現精準區域編輯。

框架採用「規劃-執行」策略:VLM 規劃器透過逐步推理分解複雜指令,生成邊界框與區域提示;編輯器使用無訓練注意力區域注入機制,支援單次多區域並行編輯,避免迭代 inpainting。

Categories: 開源, 香港中文大學, 香港科技大學, 騰訊, 影像模型, 影像處理, Python, 新聞

Light-X 修正相片/影片光渲染及視角

Light-X 是個視訊生成框架,它能夠從視訊中實現可控渲染,並同時控制視角和光照。 Light-X 提出一種解耦設計,將幾何形狀和光照信號解耦:幾何形狀和運動通過沿用戶定義的相機軌跡投影的動態點雲來捕獲,而光照線索則由始終投影到相同幾何形狀的重新光照幀提供。這些明確的、細粒度的線索能夠有效地解耦,並指導高品質的光照。 為了解決缺乏配對的多視角和多光照視頻的問題,Light-X 引入了Light-Syn,這是一種基於退化和逆映射的流程,它利用自然場景下的單目視頻素材合成訓練對。此策略產生了一個涵蓋靜態、動態和 AI 生成場景的資料集,確保了訓練的穩健性。大量實驗表明,Light-X 在聯合相機光照控制方面優於基線方法,並且在文字和背景兩種條件下均優於以往的視訊重光照方法。

Light-X 是個視訊生成框架,它能夠從視訊中實現可控渲染,並同時控制視角和光照。

Light-X 提出一種解耦設計,將幾何形狀和光照信號解耦:幾何形狀和運動通過沿用戶定義的相機軌跡投影的動態點雲來捕獲,而光照線索則由始終投影到相同幾何形狀的重新光照幀提供。這些明確的、細粒度的線索能夠有效地解耦,並指導高品質的光照。

為了解決缺乏配對的多視角和多光照視頻的問題,Light-X 引入了Light-Syn,這是一種基於退化和逆映射的流程,它利用自然場景下的單目視頻素材合成訓練對。此策略產生了一個涵蓋靜態、動態和 AI 生成場景的資料集,確保了訓練的穩健性。大量實驗表明,Light-X 在聯合相機光照控制方面優於基線方法,並且在文字和背景兩種條件下均優於以往的視訊重光照方法。
httpv://www.youtube.com/watch?v=ui9Lg2H–0c
Categories: 開源, 香港中文大學, 影像處理

AnyTalker 多人對話唇形同步影片

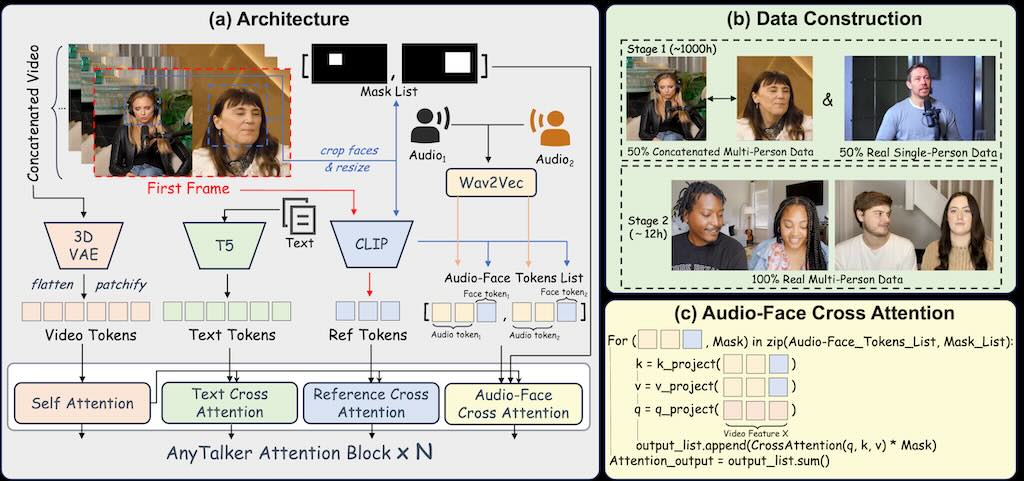
AnyTalker,一個基於音訊的多人對話的開源視訊生成框架。它採用靈活的多流結構,既能擴展身份規模,又能確保身份之間的無縫互動。

AnyTalker,一個基於音訊的多人對話的開源視訊生成框架。它採用靈活的多流結構,既能擴展身份規模,又能確保身份之間的無縫互動。

Categories: 開源, 香港科技大學, 數字人, 影像處理

UniVerse-1 同步生成有聲影片

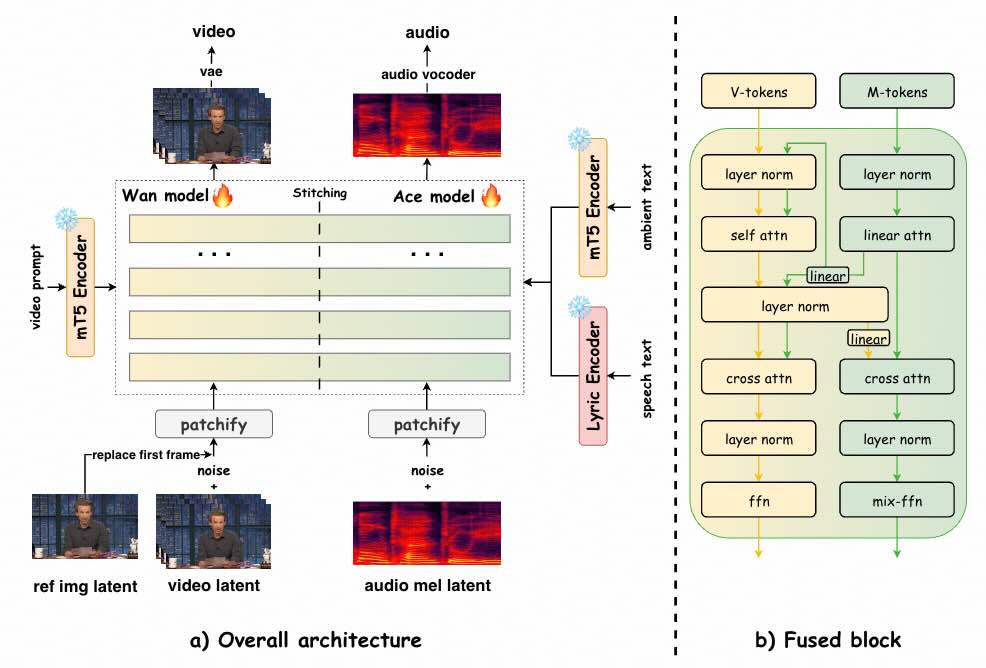
UniVerse-1 是個類似 Veo-3 的模型,可根據參考圖像和文字提示同時產生同步音訊和視訊。

UniVerse-1 是個類似 Veo-3 的模型,可根據參考圖像和文字提示同時產生同步音訊和視訊。

  • 統一音視頻合成:具有同時生成音訊和視訊的強大功能。它能夠解析輸入提示,產生完美同步的視聽輸出。
  • 語音音訊產生:此模型可直接根據文字提示產生流暢的語音,展現了其內建的文字轉語音 (TTS) 功能。至關重要的是,它能夠根據生成的特定字元調整語音音色。
  • 樂器演奏聲音生成:此模型在創造樂器聲音方面也非常熟練。此外,它還提供了「邊彈邊唱」的功能,可以同時產生人聲和樂器音軌。
  • 環境聲音生成:此模型可以產生環境聲音,產生與視訊視覺環境相符的背景音訊。
  • 第一個開源的基於 Dit 的音訊視訊聯合方法:我們是第一個開源基於 DiT、類似 Veo-3 的聯合視聽生成模型。

Categories: 開源, 香港科技大學, 多模態模型, 視頻模型

DeepCode AI 驅動的開發平台

DeepCode 是個 AI 驅動的開發平台,可自動執行程式碼產生和實作任務。我們的多代理系統能夠處理將需求轉化為功能齊全、結構良好的程式碼的複雜性,讓您專注於創新,而不是實現細節。 DeepCode 透過為常見的開發任務提供可靠的自動化來解決這些工作流程效率低下的問題,從而簡化從概念到程式碼的開發工作流程。https://github.com/HKUDS/DeepCode

DeepCode 是個 AI 驅動的開發平台,可自動執行程式碼產生和實作任務。我們的多代理系統能夠處理將需求轉化為功能齊全、結構良好的程式碼的複雜性,讓您專注於創新,而不是實現細節。

DeepCode 透過為常見的開發任務提供可靠的自動化來解決這些工作流程效率低下的問題,從而簡化從概念到程式碼的開發工作流程。
https://github.com/HKUDS/DeepCode

DeepCode: This FREE Agentic AI Coder is INSANE!
Categories: 開源, 香港大學, Vibe Coding, 編程

Page 13 of 15
1 11 12 13 14 15