Socratic-Skill-Learning:Agent 技能能否真正跨任務重用?南京大學提出 SSL

SSL 讓 Agent 在導師指導下自行練習及編寫技能,並以新任務測試 transferable Skills 是否真正遷移。

NJU-LINK

Agent 從一次任務學到的做法,未必能直接套用到新情境;SSL(Socratic Skill Learning)把這種「學會與重用」拆開,讓 Student 練習、提問及編寫 Skill,再由全新的 solver 接手未見任務。南京大學 NJU-LINK 將它定位為可重用 Agent Skills 的學習框架,關鍵不是複製完整答案,而是保留程序及其適用條件。
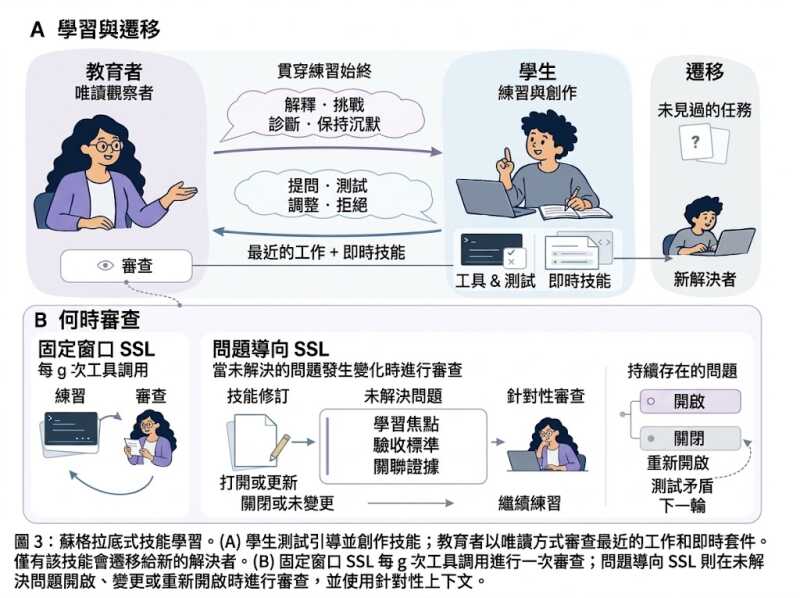
流程由 Educator 介入指導,但 Student 仍是環境操作者及 Skill 作者,可以質疑、測試和修改建議。Fixed-Window SSL 會按固定間隔檢視進度;Issue-Guided SSL 則追蹤仍未解決的問題,隨 Skill 版本變化集中檢視,避免每輪都重新教訓。

評測工具 SkillTransferBench 涵蓋 35 個任務系列、408 個可執行個案及 6 個領域;主評估使用 22 個系列、155 個 held-out cases,並以新 solver session 測試遷移。Fixed-Window SSL 的 utility 為 0.801,高於無 Skill 的 0.723、Trace2Skill 的 0.761,以及 SKILL-KD 的 0.751;Issue-Guided SSL 達 0.805,較 Fixed-Window SSL 節省 61.7% Educator tokens,但整體流程仍需 Node.js 22.19+、Docker 及 OpenAI-compatible API 支援。

  • 讓 Agent 自己提問、測試和修訂 Skill
  • 以未見任務及新 solver 檢查技能是否可遷移
  • 比較固定間隔與問題導向兩種複核方式
  • 提供跨 Qwen、DeepSeek、Kimi 等模型的評測

這套方法較適合研究 Agent 教學、技能記憶及長期工作流程的團隊,而不只適合聊天機器人。它沒有直接把大型模型換掉,而是處理更實際的問題:如何把一次成功任務轉成可攜、可審核的 Skill,同時控制導師介入所帶來的額外成本。
GitHub · 數據集

Categories: 開源, 南京大學, Agentic, 模型, Qwen, OpenAI, DeepSeek, API, 框架, 教學, 工具, Dataset 數據集, Kimi, Skill 技能

CoEvo-RSI:讓模型跟上會進化的 Agent Harness

CoEvoX 讓模型與執行框架同步演化,改善 AI Agent 的能力與工作流程互相錯配及自我進化(RSI - Recursive Self-Improving)的問題。

CoEvoX framework

當 Agent 的執行流程不斷改變,模型可能未學懂新要求,也可能因 Harness 限制而用不出原有能力。CoEvoX 屬於 LLM agent 的模型—Harness 共演框架,透過共同演化歷史檔案,協調模型檢查點、執行框架與實驗結果。

每輪流程由 meta-agent 編輯新 Harness,從歷史檔案選擇或合併模型 checkpoint,再用拒絕取樣軌跡進行 SFT;只有通過驗證的改善組合才會晉升。TIMR(Turn-level Interface Mismatch Rate)用來診斷逐回合的介面錯配,亦令模型選擇不再只看單一模型能力。

• Qwen3.5-9B 經 CoEvoX 調整後,部分失效歸因測試超越更大型模型
• 評估涵蓋多代理失效歸因、角色感知 text-to-SQL 及智能家居指令
• Held-out 測試避免同時參與訓練與演化選擇
• 結果並非全面領先,部分演算法生成或 When 指標仍落後其他方法

失效歸因結果中,CoEvoX 在 Hand-Crafted 的 Who、Pro 的 Who,以及 TraceElephant 的 Who 分別取得 68.39%、69.43% 和 70.78%,但在 TraceElephant When 只有 28.92%,低於 GSPO 的 38.36%。這反映共演化能改善特定工作分工,卻未必對所有推理步驟同樣有效。

項目較適合研究 recursive self-improving agents、模型訓練及 Harness 設計的團隊,用來測試模型與工作流程是否互相配合。提供的資料沒有完整安裝、執行指令或部署流程,亦不應直接假設可隨意下載;目前較合理的理解是把它視為附有實驗框架與評估方向的研究項目。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, 框架

Muse-CharacterSheet-H3:MiniMax H3 角色表工作流

生成多角度、背景移除及排版一次完成,減少 ComfyUI 製作角色設定表的繁瑣步驟。

Repository image for muse-collective-26/Muse-CharacterSheet-H3

將五個角度的生成結果自動拼成一張角色設定表,Muse Character Sheet H3 這個 ComfyUI 工具組把 MiniMax H3 的多視角生成、文字儲存、影像轉換及背景處理連成一套工作流。對遊戲美術、角色設計與虛擬內容製作團隊而言,它省去逐格裁切、調整比例及手工排版,但仍需自行準備模型權重與合適的 ComfyUI 環境。

  • 提供 Standard 與 Enhanced 兩套工作流。
  • CHUNK/CUT 介面會把姿勢描述編譯成 H3 六段式 Reference-mode 提示格式。
  • Muse Character Sheet Compositor 可把 Close-up、Front、Left Profile、Right Profile、Back 五格自動並排。
  • Windows 安裝包已整合三個 Muse 工具節點,不需另下載獨立 utility ZIP。

Enhanced 版本在 H3 生成後加入 Qwen image refinement 與 DLSS enhancement;Standard 則以背景移除及選取畫面組成設定表,不依賴 DLSS,適合較簡單或未配置相關環境的流程。標準流程不再要求 WAS Node Suite 或原有 ComfyUI-RMBG 套件,但若其他工作流仍使用,就不應直接刪除。

背景移除輸出 IMAGE、MASK 與 MASK IMAGE;模型權重則另有使用條款。組合設定表支援 16:9、4:3、1:1、3:2 及 21:9,工具會按比例處理裁切,Close-up 佔完整寬度,其餘四個角度排列在側。

Windows 測試可下載完整 ZIP,將資料夾放入 custom_nodes,再執行 Install-Windows.bat;Git 必須在 PATH,模型則按清單另行下載。從前安裝過獨立工具資料夾的環境,應把備份移出 custom_nodes,避免同一節點重複註冊;安裝器不會自動刪除舊資料夾。

GitHub

Categories: 開源, ComfyUI, 模型, Qwen, Image, 工具, MiniMax

Xiaomi-Lens-0 讓 4B 視覺模型標註出答案

這個 4B 多模態模型把文字回答與像素級定位放在同一套推理中,適合需要理解物件、指出位置及分割影像的場景。

Xiaomi-Lens-0 recorded outputs across six task domains

要讓模型回答「紅色杯子在哪裡」之餘,同時準確框出甚至分割杯子,傳統多模態模型往往要串接多個模型。Xiaomi-Lens-0 試圖把這兩步合而為一:它以 Qwen3.5-4B 為基礎,在生成文字的過程中解讀 <|mask|> token,再由輕量解碼器輸出對應區域,令文字答案與視覺定位可以同步產生。

這個 4B 多模態模型主要處理 Referring Expression Comprehension、Referring Expression Segmentation、多實例定位、Reasoning Segmentation、具身指令指代及細緻感知等六類任務。它既能以邊界框指出物件,亦能輸出像素遮罩,適合影像標註、搜尋、選取區域及具身操作前的人工檢查。

  • 以 4B 規模結合文字回答、邊界框與像素級遮罩
  • 支援六類定位及視覺推理場景
  • 可在 Hugging Face Spaces 試用,亦公開模型權重與 LensBench
  • 提供每個遮罩獨立輸出及熱力圖等推理設定

模型在八個 RefCOCO 系列分割上的平均 referring comprehension 提升 5.6 分,並在八個細粒度感知測試中取得較高分數;項目頁另列出 RefCOCO 驗證集 Prec@0.5 為 94.6。LensBench 包含 4,800 個 instruction-level 樣本,涵蓋 1,200 個配對單位及四個領域。

代價是輸出遮罩需要額外視覺解碼,而模型規模仍屬輕量,複雜推理和高解析影像表現應按測試結果判斷。研究團隊已提供線上示範、模型權重及程式碼,適合想試驗視覺 grounding 的模型開發者、影像工具團隊和具身智能研究人員。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, Qwen, Image, 影像處理, 工具, 小米-Xiaomi

Scene-Designer:智能 3D 場景生成與設計

Scene-Designer 把場景生成、質素評估與反覆修正放進同一套 Agent 訓練流程,減少無效改動。

Scene-Designer bear logo

3D 場景生成最難的地方,往往不是砌出物件,而是知道場景是否合理,以及修正錯誤時避免愈改愈亂。Scene-Designer 是一個面向 Agentic 3D Scene Generation 的研究框架,目標正是讓模型學習設計場景、評審質素,再按評語作有效修正。

  • 以 Scene-OTA-35K 的 Observation–Thought–Action 軌跡學習設計與修改流程。
  • 透過 Scene-OTC-15K 的 Observation–Thought–Critic 經驗,比較場景質素。
  • 用 Branch-ranking reward 比較同一父場景產生的分支。
  • 以 Improvement reward 判斷子場景是否真正優於原場景。

Causal Trajectory Consolidation 會移除沒有下游貢獻的無效操作,同時保留有效決定及必要中間狀態。Scene perturbations 則刻意加入佈局偏差、功能退化和物理違規,再建立偏好比較,令模型不只是 spotting 錯誤,而是學習指出哪個場景較好。

Scene-GRPO 結合分支排名與改進獎勵,讓代理在相同起點的候選場景中選擇較佳設計,並減少沒有帶來實際進步的反覆修改。這種做法比只追求最終生成結果的訓練多了一層質素判斷,亦直接回應通用模型「識錯但不懂有效修正」的問題。

研究團隊比較了模型與 GPT-5.2 在成對場景比較及四場景偏好排序上的表現;首頁亦提供十組 prompt-to-scene 示範。不過,公開資料未交代完整安裝流程,Hugging Face 上已列出 Scene-Builder-Qwen3-VL-8B-Instruct 模型與 Scene-OTC-Bench 資料集,較適合具 3D 生成、Agent 訓練及模型評估經驗的團隊先行研究。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, OpenAI, 影像模型, World-Action Model, 框架, 3D, Dataset 數據集

RAP-25K 用 AI 把論文自動排版成為海報

清華、港大、美團等團隊把 25,435 對 NeurIPS、ICLR、ICML 論文與海報反解為可填空嘅 HTML 模板,等 AI 唔再從零設計版面,而係取用人類做過嘅版型再改內容。

做會議海報本質係一次迷你視覺代碼:一篇論文要做成 Poster,要同時處理摘要、視覺排版同程式實現。RAP 將呢件事變成可量度嘅任務,開放俾模型訓練同評測。

佢屬於一個資料集加框架嘅組合:核心係 PosterReverse-25K,由 NeurIPS、ICLR、ICML(2022–2026)合共 25,435 套論文同海報組成,每份海報會被自動 pipeline 反解成帶類型、可填空嘅 HTML/CSS,連摘要同三層分類(領域/任務/方法)都一齊整理好。配套仲有一份 RAP-150 測試集,每個領域留 10 篇俾公平比較。

同類做法多數只標註版面框或者小量樣本,要靠 VLM 或人手評分。RAP 嘅差別係每個樣本都可以渲染同原海報直接對比,做到客觀驗證,唔再靠主觀評審。佢提供兩條路線:PosterRAG 係免訓練嘅多智能體流程,會先檢索真實模板再填入新內容;另一條就用同一批 triplet 對 Qwen3.8-27B 做全參數 SFT 加 GRPO 訓練。

對研究人員同會議籌備團隊最直接:寫完一篇論文想快速整海報,可以利用檢索模板避開從零排版;做視覺代碼、版面生成或 VLM 訓練嘅團隊,都能直接用呢批已驗證 triplet 做監督。項目提供 Hugging Face Space demo 同模型權重。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架, Dataset 數據集

OpenGCUA 讓電腦代理跨越 GUI 限制

OpenGCUA 把視覺操作、AX Tree、API 與指令整合,讓代理按任務選擇完成工作的方式。

OpenGCUA. Open the full stack of generalist computer use. GPT-6 made computer use the frontier. We make it open. Tested

當電腦代理不再只靠滑鼠點擊,處理複雜工作便可以同時讀取畫面、Accessibility Tree、應用程式 API 和命令列。OpenGCUA 是一個開源 Computer-use agents(CUAs)項目,建構 generalist computer-use agent(GCUA)完整堆疊,解決 GUI-only 代理在效率和操作彈性上的限制。

模型會按任務決定要觀察甚麼、採取哪種行動,以及如何整理上下文;除了 GUI 操作,也能呼叫 app API、執行 shell commands,並透過 code execution 把多個步驟組成帶有迴圈和條件的程式。OSWorld 整合範例提供 screenshot-action 和 code-action 路徑,macOS 14+ harness 則以選單列應用程式在本機裝置執行代理,仍屬 preliminary。

OpenGCUA 亦提供 Cross-Device SDK,嘗試用同一套 programming interface 連接電腦、瀏覽器和手機。這比固定規則的工作流更靈活,但也代表命令、API 和 GUI 權限需要更嚴格的隔離;項目目前仍在逐步開放模型、harness、SDK、trajectories、效率優化和評估工具。

OSWorld-v2 的 82 個 offline tasks 中,八個 frontier models 的平均 partial score 由 GUI-only execution 的 45.3 提升至 64.9,增加 19.6 分;每項任務平均步數減少 53%,六個模型的 output tokens 亦減少 27.2%。較弱模型獲益較大,例如 GLM-5.3-Flash 增加 35.2 分,DeepSeek-V4.1-Flash 增加 29.8 分。

  • 同時支援 GUI、AX Tree、CLI、API 和 code execution
  • 附有八個模型的 evaluation trajectories,包括 GPT-6 Astra、Claude Opus 5 和 Gemini 3.8 Flash
  • 可用 OSWorld 整合範例研究 screenshot-action 與 code-action
  • macOS harness 和 Cross-Device SDK 方便研究本機及跨裝置工作流

研究 Computer-use agents、需要分析代理行為,或希望把電腦、瀏覽器和手機操作納入同一工作流的團隊,會較容易從中受益。項目適合用作研究和實驗基礎,未宜直接視為成熟的日常自動化產品;本機執行、權限控制、模型相容性及仍在開發的模組,都會影響部署難度。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, Qwen, DeepSeek, Gemini, API, 工具, Mac, 編程, Anthropic, Dataset 數據集

InfoVis 簡報生成與編輯能力整合到 9B 模型

InfoVis 讓同一個模型處理簡報生成、素材參考、模板控制與局部編輯,開源評測已接近 Nano-Banana-2。

overview

製作簡報圖像時,你可以用文字生成整頁投影片,也可以提供風格參考、內容素材或原有投影片作修改。InfoVis 屬於開源影像模型項目,集中處理文字轉投影片、模板條件生成、多圖像內容生成,以及按指令編輯投影片四類工作,減少不同模型之間切換所帶來的流程斷裂。

模型以 FLUX.2-klein-base-9B 為基礎,經過 slide-native continual pretraining、四任務混合 continual pretraining,再進行 task-specific SFT,最後把不同分支合併成單一模型。這種做法換來較完整的任務覆蓋,但同一模型要同時兼顧文字準確度、版面美感、內容對齊和精準編輯,效果仍會受提示內容及輸入素材質素影響。

VisSlideBench 收錄 1,527 個人工篩選案例,分別檢查內容忠實度、指令遵循、美感、語義一致性和簡報質素等指標。InfoVis 整體得分 7.94,略低於專有的 Nano-Banana-2(7.99),但在所有 11 項指標均領先受評開源模型;相較原始 FLUX.2-klein-base-9B,專門訓練帶來 1.6 分整體提升,美感仍是它與專有模型之間較明顯的差距。

項目提供 Hugging Face Space 的線上示範,再按需要下載模型權重、程式碼、InfoVis-Data 和 VisSlideBench 作本地研究或評估。這個項目較適合需要大量製作簡報草稿、產品提案、教學投影片的設計及內容團隊;本地執行 9B 模型則要自行準備相容的圖像生成環境,儲存庫資料未列出統一的硬件要求。

  • 四合一工作流:文字生成、模板控制、多圖像接地生成及指令式編輯由同一模型處理。
  • 專用訓練資料:提供超過 13M continual-pretraining records 及 1.9M SFT records。
  • 可驗證評測:VisSlideBench 同時公開資料集及評估程式碼。
  • 主要取捨:開源模型中表現突出,但整體仍稍低於 Nano-Banana-2,美感差距較大。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Google, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 教學, 庫, 中國, 蘋果, Dataset 數據集

SCOPE 讓文字提示詞按語意學習

文字轉圖像不再把同一分數平均分給每個字詞,SCOPE 按物件、數量與關係調整提示詞優化方向。

Uniform token GRPO versus SCOPE span credit.

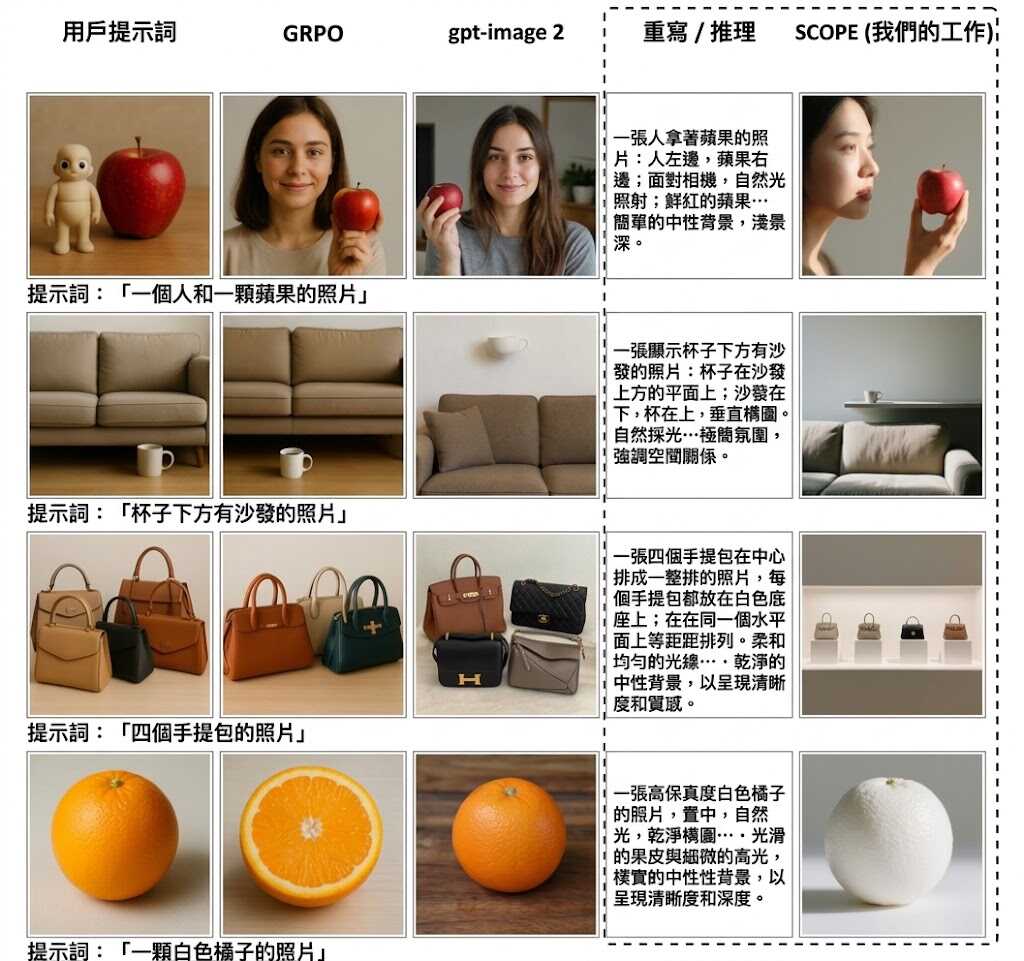
當提示詞包含物件、數量、屬性和關係時,逐個 subword token 套用同一個圖像分數,往往難以知道哪段文字真正需要修改。SCOPE 是一個開源的文字轉圖像提示詞優化項目,利用 GRPO(Group Relative Policy Optimization)讓語言模型重寫提示詞,同時保留凍結的圖像生成器作評分基準。

每組提示詞會由 pi_theta 產生 N-1 個改寫版本,並加入原始提示詞作第 N 個成員;預設 N 為 8。Qwen-Image 以同一個 diffusion seed 生成 512 x 512 圖像,使用 20 steps 和 CFG 4.0,再由 GenEval 回傳 0 或 1,減少不同隨機結果對比較造成的干擾。

SCOPE 的差異在於把回饋由 token 層面提升至語意片語。項目會在每個 phrase 內池化 log pi_theta 與 log pi_old 的差值,將 span coefficient 限制在 0.8 至 1.2,再把片語 token 權重正規化至平均值 1;tags 和垂直線則維持權重 1。原始提示詞分數低於預設 tau 1 時,採用截斷 reward gap;達到門檻後,改用改寫群組的 clipped z-score。

  • 訓練流程:原始提示詞會參與評分及 advantage 計算,但不直接更新參數。
  • 策略穩定性:pi_old 是上一個 optimizer step 的凍結副本,第一步會與 pi_theta 相同。
  • 適合情境:需要改善物件數量、屬性或空間關係表達的文字轉圖像研究與實驗。

測試時可觀察 reward service 產生的圖像、logs/node-RANK/內的安裝與訓練記錄,以及每項工作使用的 service.token;該 token 權限設定為 0600。項目更接近研究型訓練框架,而不是即開即用的圖像生成介面,使用者需要準備 Qwen-Image、評分服務及足夠的生成資源,亦要留意 GenEval 的二元分數未必能涵蓋所有美學或語意品質。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, Image, 提示詞, 框架, Mac, Python, Tokenize

DeltaStreamer 讓串流影片可以回看再作答

影片播放過後仍可追查關鍵細節,DeltaStreamer 以記憶、規劃和視覺回放串起串流理解流程。

DeltaStreamer

影片一路播放,問題卻可能在關鍵畫面消失後才出現;DeltaStreamer 屬於 agentic framework,處理串流影片理解中「記住甚麼、何時回查」的難題。它以 change-aware memory 保存變化,再配合 query-driven planning 和 targeted visual replay,讓系統按問題重新檢查相關片段,而不是只依賴當時留下的文字描述。

對直播問答、影片監察和互動助手而言,這個流程比單純累積長篇摘要更適合處理後來才提出的問題。項目亦提供 AI-Tongdan 作為應用例子,支援持續觀察、上下文問答和彈幕建議;不過它是框架,不是獨立的新基礎模型,所用模型與推理配置仍要按儲存庫內容自行核對。

OVO-Bench 中,DeltaStreamer 的 overall score 為 66.07,Real-Time、Backward 及 Forward 分數分別為 72.23、67.72 和 58.25。它高於列出的全開源 online MLLMs 與 video agents 多個結果,但仍低於 Gemini 3 Flash 的 64.02 嗎? [sic]

項目主頁 · GitHub

Categories: 開源, 字節跳動, Agentic, AI productions, 模型, 多模態模型, Qwen, Video, 框架, 庫

Page 3 of 21
1 2 3 4 5 … 21