Trace 用可驗證資料重做視覺推理訓練

想訓練視覺模型識得真係推理,而唔係靠題型記憶,Trace提供咗一套可重播、可核對的資料生成方法。它不只出題,連答案點樣得來都一併保留。

trace mark

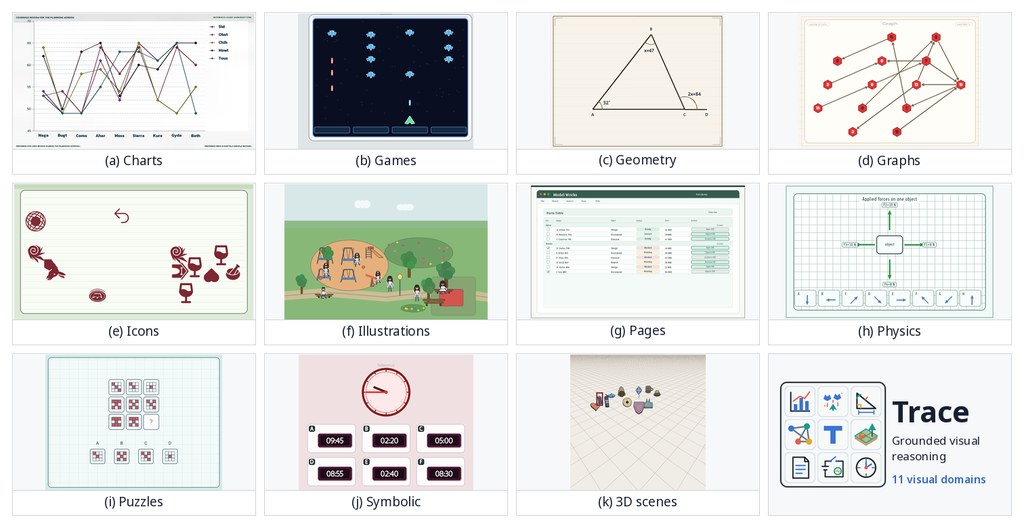
很多視覺推理資料集都只交付圖片同答案,模型答啱咗,未必代表推理過程真係站得住腳。Trace把重點放在可驗證 post-training:它屬於一個資料集兼生成環境,針對的問題是怎樣穩定產生 grounded visual-reasoning 任務,並且讓答案、標註與驗證流程互相對得上。

它採用一條很清晰的生成路線:domain → scene grammar → task program。現有做法常見是先有人手整理題目,或者由圖像與文字鬆散配對,再用最終答案做監督;Trace則用 deterministic seed 先建立 semantic scene state,再由 task program 從同一個狀態推導 typed answer、verifier state,最後才渲染圖片與提示。這種 shared-state 設計的分別,在於題目不是「生成完再補標註」,而是從源頭就把圖像、問題、答案同 execution trace 綁定。

對研究團隊來說,這個取向很有吸引力,因為它同時照顧訓練、檢查同重播。每個例子除了 image、prompt、typed answer,還有 image-space annotation、verifier metadata 同 execution trace;對想做 RLVR、後訓練驗證,或者想分析模型到底錯在觀察、計算還是規則理解的人,資料密度比一般 benchmark 高得多。

  • 收錄 11 個 visual domains、277 個 scene grammars、1,000 個任務
  • 已公開 66,000 個 generated examples,亦提供 Hugging Face dataset 與模型檢查點
  • 驗證不只看最終答案,還保留 verifier state 與 replayable execution trace
  • 以 Qwen2.5-VL-3B、Qwen2.5-VL-7B 做 post-training,兩個尺度都有明顯提升

數字上,它在 2,000 個未見過、但由同一批 task programs 生成的新例子上,將 Qwen2.5-VL-3B 由 24.45 提升到 41.05,Qwen2.5-VL-7B 由 34.25 提升到 51.55。這些結果首先說明 Trace對同分佈泛化有幫助;首頁亦提到用 64,000 個 Trace instances 訓練後,對 24 個外部 benchmarks 的 macro-average 也有改善,但摘要資訊未列完整分項,解讀時仍要看原始報告。

Trace最適合被理解為一個用來建構可核對視覺推理訓練資料的基礎項目,而不只是另一個出題庫。它的取捨也很明確:換來高度可驗證與可重播,代價是任務分佈由 scene grammar 同 task program 明確界定,較適合研究訓練方法、評測設計同模型行為分析,未必等同自然世界的開放式視覺理解。
項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 模型訓練, Qwen, DeepSeek, Image, Dataset 數據集

DocOps 直擊文件代理真功夫

文件代理唔止要答啱內容,仲要改得啱格式同結構。DocOps將評測焦點放回原生文件本身,較易看清代理係真識做事,定只係識講答案。

DocOps benchmark overview

改 Excel、Word、PowerPoint 同 PDF,最難唔係生成一段合理回覆,而係交返一份可用、冇整爛結構的原生文件。DocOps屬於 benchmark 類型,針對 document-operation agents 而設,重點不是問答得分,而是檢查代理能否把文件改到指定狀態,同時保住公式、樣式、大綱、書籤與格式有效性。

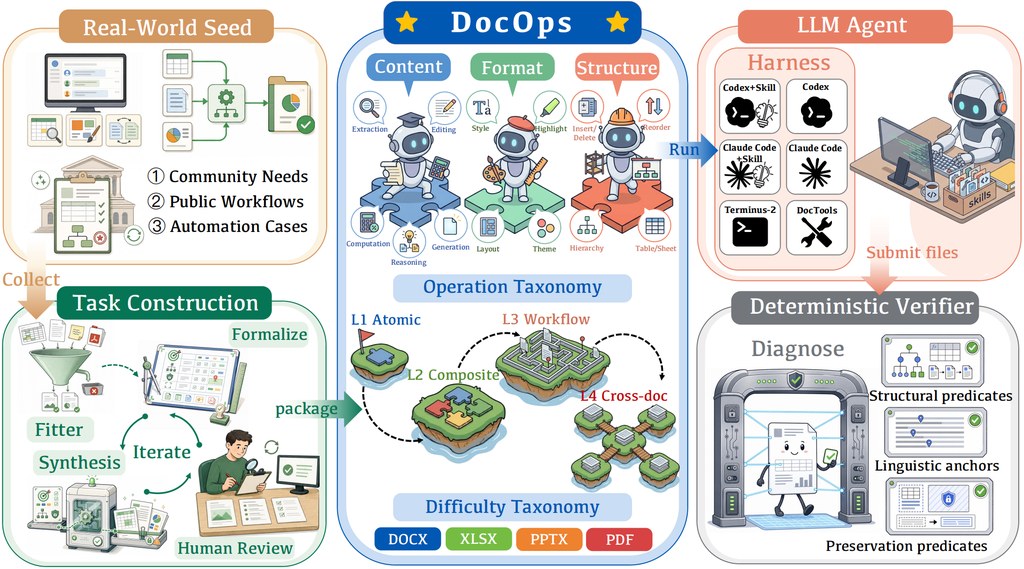
現有評測常落在兩個範式:static document understanding 把文件當成唯讀材料做擷取或問答;workflow-oriented software evaluation 則把文件當成在應用程式之間流轉的附屬品。DocOps反過來把「文件本身」放回中心,用 Harbor 格式整理 210 個可執行任務,再用 deterministic artifact-level verifiers 直接驗最終檔案狀態,這種設計比只看可見文字更能捉到破壞性修改與狀態遺漏。

它的取向相當鮮明:不是追求聊天式流暢回覆,而是拆解 document manipulation 到 content、format、structure 三個維度,再按 L1 到 L4 拉開難度,涵蓋局部原子操作、同文件組合操作、單文件流程,到跨文件工作流程。對研究 agent 能否長步驟維持全局一致性的人來說,這個分層比單一總分更有診斷價值。

  • 收錄 210 個 Harbor tasks,覆蓋四種常見文件格式
  • 內建 deterministic verifiers,驗證原生檔案而非只看輸出文字
  • 提供 DocumentTools、Terminus-2、Codex、Claude Code 等 execution harnesses
  • 支援 skill-on / skill-off 評測,較易分辨工具能力與模型能力

這個 GitHub 項目已包 task、skills、harnesses 同 Docker base images,重點在重現 benchmark run,而不是單獨提供某個辦公自動化工具。現有結果亦說明門檻不低:例如 GPT-5.5 在不同 harness 的表現有明顯落差,Claude Sonnet 4.6、DeepSeek-V4-Pro 等模型亦未見接近滿分,反映文件操作代理距離穩定處理端到端工作仍有一段距離。對做 Agentic 評測、辦公自動化代理、或想比較 skill 與模型邊界的團隊而言,DocOps的參考價值很高。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, Robotic, 軟件, Anthropic, Meta, Dataset 數據集, 百度, Skill 技能

Voicebox 本地語音克隆完整工作台

想喺自己部機完成語音克隆、朗讀同聽寫,Voicebox 幾乎把整條語音 I/O 流程收進同一個桌面項目。它吸引人的地方,不只係多模型,仲有本地私隱同跨平台部署。

Voicebox

把語音克隆、TTS、聽寫同 agent 語音互動放埋一個桌面介面,正正擊中不少內容創作、無障礙輸入同 AI 工作流嘅痛點。Voicebox 屬於本地優先嘅開源語音工具項目,重點唔係單做一種聲音生成,而係將完整 voice I/O stack 放到 Mac、Windows 同 Linux 上運行,令模型、錄音同聲音資料都留喺自己部機內。

它最有競爭力嘅地方,在於把雲端常見嘅兩段流程合併:一邊做語音輸出,一邊做全域聽寫,仲可以接到 MCP-aware AI agent。對比只做 TTS 或只做 dictation 嘅服務,Voicebox 提供嘅係一個較完整工作台;代價亦明顯,本地推理對硬件、模型管理同快取安排有一定要求,想追求最省心體驗,未必比純雲端方案輕鬆。

支援面向相當廣,內建 7 個 TTS engines,包括 Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、HumeAI TADA 同 Kokoro,亦提供 zero-shot cloning 同 50+ preset voices。23 種語言加上後製效果,例如 pitch shift、reverb、delay、chorus、compression 同 filters,令它唔止適合做旁白,對要快速試聲線、做角色語氣、整理語音筆記嘅小團隊同個人創作者都幾有用。

  • 本地執行係核心價值,私隱敏感內容唔使上傳雲端
  • 一個項目包辦 voice cloning、speech generation、dictation 同 agent 語音介面
  • 支援多個 TTS engines,同一段內容可按聲線、語氣同語言需要切換
  • Chatterbox Turbo 可處理 [laugh]、[sigh]、[gasp] 等 paralinguistic tags,Qwen CustomVoice 可用自然語言控制演繹方式

安裝方式以桌面應用為主,官方已提供下載、文件同 troubleshooting,理解上接近本地 AI studio,而唔係單一模型倉庫。現有資料未見統一基準分數或嚴格 benchmark,對聲音相似度、延遲同穩定性,仍要視乎你選用邊個 engine、樣本質素,同埋會唔會改用 local or remote inference;但作為把多語音模型、克隆流程同輸入輸出控制整合起來嘅開源項目,它已經比只提供單點功能嘅工具更接近可長期放入工作流。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, Agentic, MCP, Qwen, Clone, Mac, Linux, 語音

xHC 點樣把 Transformer 殘差流擴到 16 路

想把 Transformer 做得更聰明,未必要一味加深加闊。xHC 揀咗另一條路:把殘差流擴成 16 路,但只更新其中 4 路,換取更實際的擴展效率。

xHC architecture overview

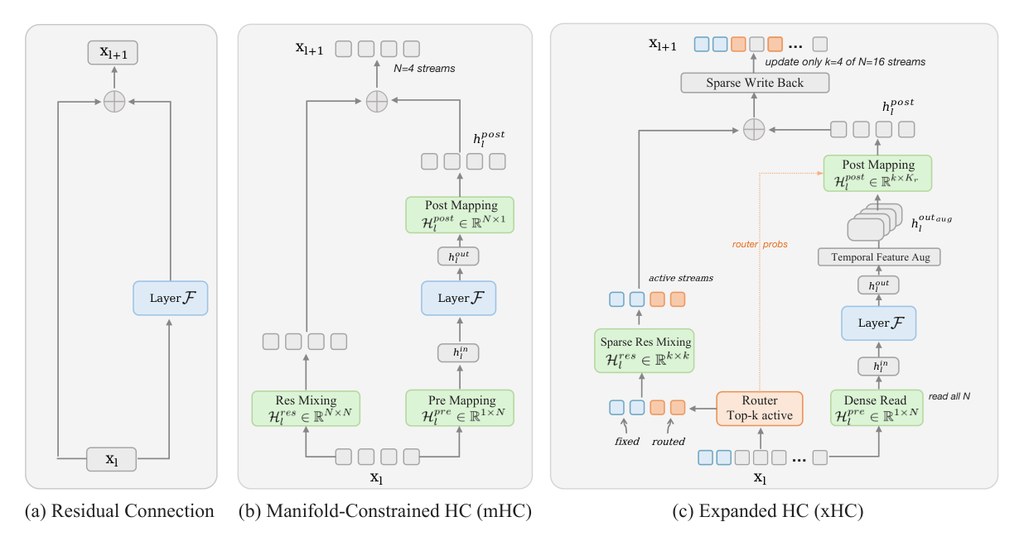
當 Hyper-Connections (HC) 想再往上加殘差流數量,卡位唔係理念,而係成本同資訊開始重複。xHC 屬於模型結構研究項目,針對 Transformer residual stream 擴展到更多平行 streams 時,點樣避免效益遞減同計算量暴增。

xHC 唔係把所有 streams 都密集更新,而係保留對全部 N=16 streams 的讀取,再只對 k=4 個 active streams 做稀疏更新。咁樣一來,HC-family 在 N>4 時常見的 O(N^3C) residual-mapping 成本,被壓到 O(k^3C);另一邊再用 temporal feature augmentation,補回單一 write-back vector 餵唔飽多路 streams 的問題。

xHC 是首個在 HC-family 裡面把有效擴展推到 N=16 的做法,主打場景係想喺 width、depth 之外,再增加一條 memory-scaling 軸。對研究 Transformer 架構、訓練大模型,或者想理解稀疏更新點樣換取更高擴展性的團隊,呢個項目有參考價值;而 xHC-Flash 則進一步為部署考慮,透過跨連續 sublayers 共用 full-state 運算,減少 memory traffic。

  • 模型結構,處理的是 Transformer 殘差流擴展到多路後的效率與有效性問題。
  • 主要差異在於「全量讀取、局部更新」;唔係盲目加 streams,而係控制真正需要更新的路數。
  • temporal feature augmentation 用 causal depthwise convolutions 提供多尺度局部特徵,令新增 streams 冇咁易變成冗餘。
  • xHC-Flash 反映項目唔只停留喺理論設計,而係有顧及較大規模訓練同部署時的記憶體流量。

重點放喺 18B scale 的訓練損失與下游表現。數字細節未在片段中完整展開,但方向很清楚:xHC 想證明,殘差流可以擴得更闊,而且唔需要用成倍密集更新去換。對關注模型結構創新的人嚟講,它最值得睇的地方唔係單一 benchmark 分數,而係把 HC 與 mHC 推過 N=4 之後,仍然維持可計算、可擴展。

GitHub · Paper

Categories: 開源, 模型訓練, Dataset 數據集

Facial-Expression-Prompting:幫 AI 影片角色演得更可信的提示詞 Skill

想拍角色反應戲,但提示詞只寫到情緒名?這些 Skill 會把動機、微表情同鏡頭節拍補完整,令 AI 影片生成更似一場表演。

Repository image for zhouwei713/facial-expression-prompting

情緒寫得太粗,AI 影片角色往往只會交出一個「表情」,而唔係一段有起伏的反應。呢個 GitHub 項目定位好明確:它係一個為人物表演而設的提示詞 Skill,專門把模糊情緒拆成可拍、可生成、可放入文生視頻與圖生視頻模型的演出指令,處理的是角色點樣由看到事件、壓住反應,再慢慢洩露情緒。

最有用的地方不只是擴寫字數,而係先補足角色點解會有反應。它用五個問題建立因果鏈,再把眼神、眼瞼、眉間、嘴角、下顎、呼吸、姿態同聲音排成時間軸,連鏡頭、光線、時長同負面約束都一併整理。對 Seedance、Kling、Runway、Veo 呢類模型來講,呢種寫法比單一句「她很傷心」更容易生成連貫畫面。

同類做法常見是堆情緒形容詞,或者直接放大表情強度;呢個項目反而重視克制、遞進同角色自我控制,所以特別適合特寫、關係戲、對白反應同微表情場景。代價亦好清楚:它偏向劇情演出導向,唔係追求高速出稿的萬用提示詞模板,使用者最好本身知道角色處境,先能發揮得更準。

  • 支援完整視頻模式同表演片段模式,前者補全整段提示詞,後者可插入既有腳本
  • 適合 Seedance、Kling、Runway、Veo 等 AI 視頻模型
  • 重點唔在誇張表情,而在可見的情緒轉折、微表情同鏡頭配合
  • 會按表演節拍決定時長,而唔係固定把每段反應寫成同一秒數

這個 Repo 可理解成一個可直接複用的 Agent Skill/提示詞模板項目,而唔係獨立模型或推理服務。它較適合內容創作者、短片導演、角色動畫設計者,或者要反覆修改人物反應戲的團隊;當目標係令 AI 生成的角色「有心事」而不只是「有表情」,呢個項目的取向相當實用。

GitHub

Categories: 開源, Agentic, AI productions, Video, txt2img, 提示詞, Skill 技能

Google 開源表格基礎模型 TabFM:零樣本處理混合欄位資料

你可以把它理解成一個專門為表格資料設計的基礎模型,由 Google Research 開源,無需訓練即可做分類與迴歸,對於常用 scikit-learn 的團隊特別友善。

Repository image for google-research/tabfm

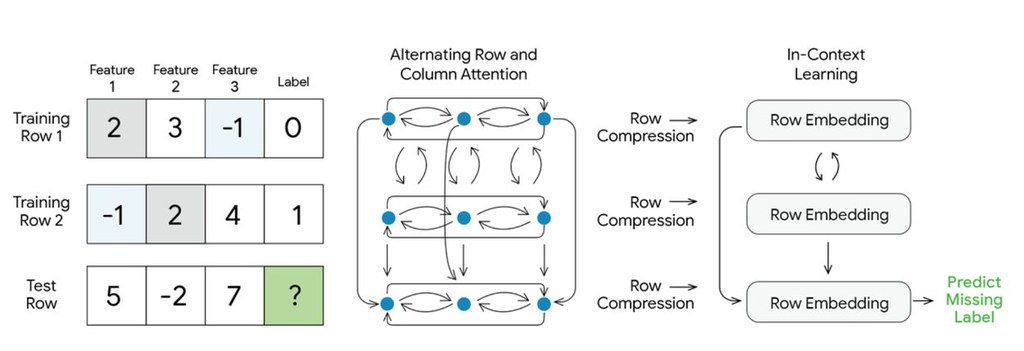
對熟悉表格資料分析的人來說,每次換資料集就得重新訓練模型,是一個長期存在的痛點。TabFM 想解決的就是這個卡位:透過 in-context learning,把訓練資料當作「上下文」直接餵進模型,省掉逐個資料集做參數訓練的步驟,支援數值與類別混合欄位的零樣本分類與迴歸。

這個項目屬於模型與框架混合性質的開源工具,以 scikit-learn 風格的 API 呈現,因此熟悉 fit、predict、predict_proba 的人可以幾乎無痛地接入。它提供 v1.0.0 預訓練權重,使用者可選擇 JAX(含 Flax 0.12.7 的 flax.nnx API)或 PyTorch(torch 2.12.1)作為後端,權重會自動從 Hugging Face Hub 下載。

與傳統監督式表格模型相比,TabFM 的差異在於「即時預測、不需要再訓練」這個取向,特別適合快速原型設計或資料集頻繁變動的場景;不過它的實際效果仍取決於預訓練權重對目標領域的覆蓋程度。中小型資料團隊、需要處理多種表格欄位類型的研究者,以及想用統一介面同時跑分類與迴歸任務的人,較容易從中受惠。

效能方面,由於原文提供的評測細節有限,難以斷言它在所有基準上的強弱;採用 GPU 版本時推理速度會明顯提升,但 CPU 環境亦可運行。需注意此項目並非 Google 官方支援產品,定位偏向研究原型,正式部署前應自行評估穩定性與資料合規性。

重點摘要:

  • 零樣本推論:無需在自己資料上訓練參數,靠 in-context learning 即時產生預測
  • scikit-learn 相容 API:可用熟悉的 fit、predict、predict_proba 流程接入
  • 混合欄位支援:同時處理數值與類別特徵,免去額外前處理設計
  • 雙後端選擇:可依環境需求在 JAX(Flax)與 PyTorch 之間切換
  • 開源但非官方產品:定位為研究性質,部署前宜自行驗證效果與合規

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Google, API, Python, Dataset 數據集

FunASR 工業級語音辨識:支援廣東話

想在本地架一個 OpenAI 相容嘅語音轉文字 API?ModelScope 嘅 FunASR 將 SenseVoice、Paraformer、Fun-ASR-Nano 等模型收喺同一個 Python 接口,仲支援 vLLM 加速同 MCP 接入 AI Agent。

Repository image for modelscope/FunASR

如果你做過語音相關項目,大概率遇過呢種情況:開源模型散落喺唔同倉庫、部署方式各異、要接入 Agent 仲要自己寫 WebSocket 中間層。FunASR 就係針對呢類工程痛點嘅工業級語音識別工具包,屬於開源框架,由阿里達摩院維護,提供統一 Python 接口,將 ASR、VAD、標點恢復、說話人分離、情感偵測同音訊事件辨識串成一條流水線。

旗艦模型 Fun-ASR-Nano 係基於 LLM 嘅解碼架構,覆蓋中、英、日三語以及中文方言群組;針對 31 種語言嘅場景可以用 Fun-ASR-MLT-Nano-2512;鍾意多語言又有 LLM 解碼能力嘅,亦有 Qwen3-ASR(52 種語言、0.6B/1.7B 參數)。如果想要更輕量、非自迴歸嘅選擇,Paraformer 同 SenseVoice 仍係穩陣起點,前者適合生產線串流,後者額外送情感同音訊事件標籤。

funasr-server 一行指令就可以拉起 OpenAI 相容嘅轉寫 API,本地聽返 localhost:8000,配合 vLLM 仲可以做到 2-3 倍 LLM 解碼加速同 tensor parallel 批次推理。Agent 整合係另一個重點:MCP Server 可以直接接入 Claude 或 Cursor,OpenAI API 接口又同 LangChain、Dify、AutoGen 無縫對齊。最近幾個版本(v1.3.18 至 v1.3.22)就專門執緊 SRT/字幕分段、長時 WebSocket 連線、verbose_json 回傳呢啲工程細節。

要留意嘅取捨係:Fun-ASR-Nano 需要 GPU;新環境第一次 import funasr 已唔再強行依賴 PyTorch,但用 AutoModel 仍然要先裝 torch。FunASR 比較適合需要私有語音 API、字幕生成、長會議轉寫、或想將語音能力塞入 Agent 工作流嘅團隊開發者。

重點摘要:

  • 統一 Python 接口整合 ASR、VAD、標點、說話人分離、情感偵測
  • Fun-ASR-Nano 旗艦模型支援 31 種語言及中文方言,Fun-ASR-MLT-Nano 覆蓋更廣
  • funasr-server 提供 OpenAI 相容 API,搭配 vLLM 可達 2-3 倍加速
  • 內建 MCP Server 支援 Claude/Cursor,亦可接入 LangChain、Dify、AutoGen
  • 近期版本持續優化字幕分段、WebSocket 長連線、verbose_json 回傳等工程細節

以下是其對粵語支持的詳細信息:

  • UniASR模型:這是一個專為粵語設計的語音識別模型,能夠處理簡體中文的粵語語音識別任務。
  • ITN模型:用於對粵語語音識別結果進行擬文本正則化後處理,以提高識別結果的準確性。
  • VAD模型:語音端點檢查模型,用於檢測長語音片段中有效語音的起止時間點,這對於粵語方言的語音識別同樣重要。
  • 訓練語料:為了提高模型的準確性和適用性,通常會使用大量的粵語語料進行訓練,以便模型能夠更好地理解和識別粵語中的特有詞彙和表達方式。
  • 離線功能:Funasr提供了離線語音識別模型,這意味著即使在沒有網絡連接的情況下,也能夠進行粵語語音識別。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, Qwen, NVIDIA, API, IDE, LangChain, Python, 語音, Dataset 數據集

Krea 2 Outpaint:外擴 LoRA 補畫面

想將圖片自然延伸到更大畫布,又唔想主體走位,呢個 Krea 2 Outpaint 就係針對呢個卡位而來。它唔只做補邊,重點係知道原圖應該擺喺新畫布邊個位置。

Og image

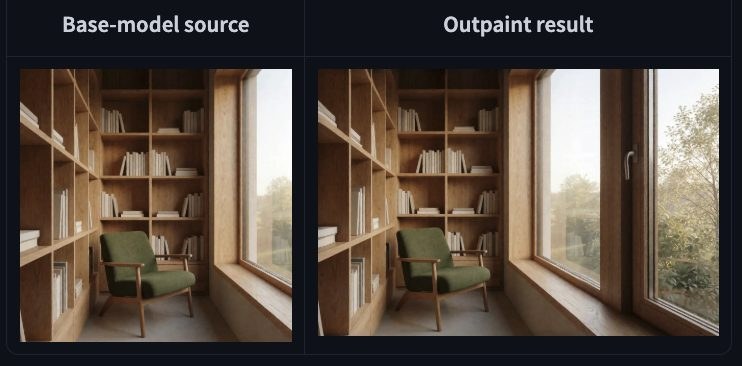
畫面外擴最怕兩件事:原圖內容被改壞,或者延伸後透視、光線同結構接唔上。呢個項目明確建立在 Krea/Krea-2-Turbo 之上,並以 Krea 2 Raw 作訓練目標,形式係一個 rank-32 的 LoRA,用嚟做 image-to-image outpainting,重點唔係單純參考原圖,而係連原圖要放喺新畫布邊個區域都一併編碼。

它的做法是把來源 latent tokens 加上來自目標 bounding box 的 rotary coordinates,令 denoiser 能理解「已知畫面屬於整張新圖的哪個位置」。所以它比一般 image-reference adapter 更適合做左貼右擴、上貼下擴,甚至置中後向兩邊延伸,對透視、光照、紋理連續性的控制更直接。

檔案資訊相當清楚,但重點不在量化版本。頁面列出 krea2_outpaint_rank32.safetensors、pipeline.py、outpaint.py、example.py,另有授權與雜湊檔;同時明確說明 Hugging Face 自動產生的 Diffusers snippet 及一般 LoRA importer 不相容,要用隨附腳本與自訂 pipeline。這代表它不是即插即用型 LoRA,而係帶有功能性介面的適配器。

  • 基礎模型已指明為 Krea/Krea-2-Turbo,並針對 distilled 8-step inference 設計。
  • 核心差異在 registered reference_placements,可指定原圖在目標畫布的位置。
  • 已測試寫實、水彩、stylized 3D 等場景,涵蓋橫向、縱向與置中延伸。
  • 頁面沒有提供 GGUF、mmproj、llama.cpp、Ollama、LM Studio 或量化等資訊。

使用取向上,它更像為 Krea 2 編輯流程補上一個 UI 版的外擴能力,而唔係通用本地推理模型。由於依賴 diffusers 與自訂程式碼,適合已經在 Python 圖像流程中工作、需要穩定控制構圖位置的人。

項目主頁 · 模型

Categories: 開源, 視覺模型, Image, 影像模型, 影像處理, Ollama

MobileWan 把 5B 影片生成壓進手機

想在手機級硬件跑到接近伺服器級的影片生成,MobileWan正面回應了這個難題。它不是再縮細模型,而是重組Wan2.2-5B的推理方式,換取畫質與記憶體之間較少妥協。

MobileWan logo

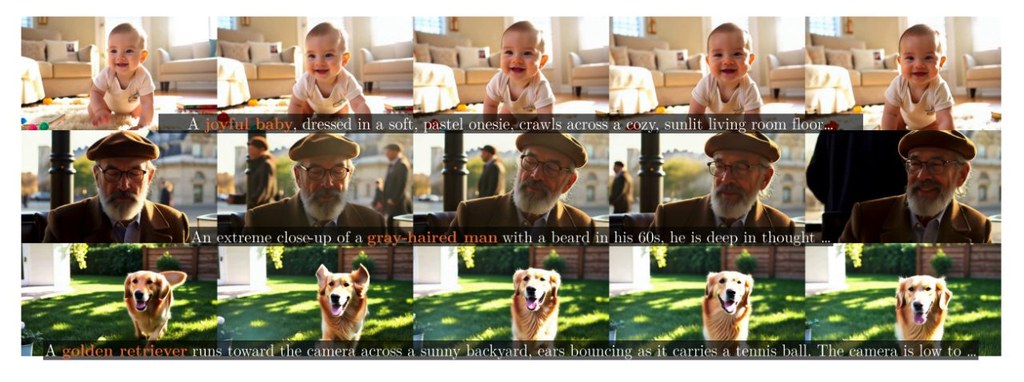
手機影片生成常見的痛點,不是能不能出片,而是畫質、動作連貫性與記憶體限制往往只能三選二。MobileWan屬於模型推理工具加輕量化模型方案,核心是在保留Wan2.2-5B基礎能力的前提下,讓單一提示詞影片生成更接近流動裝置可承受的範圍。

目前只支援 Snapdragon®
8 Gen. 5 NPU:不走細模型路線,而是把 Wan2.2-5B 改寫成更節省記憶體的推理形式。項目公開的是 inference-only sampler,會先做 hybrid-attention surgery,再套用已封裝的 self-attention head-pruning 計劃,之後才載入 MobileWan transformer 權重;換句話說,重點不是訓練流程,而是怎樣把既有大模型壓到可部署狀態。

資料顯示,MobileWan 以 recurrent distillation、causal linear attention 同記憶體優化解碼去支撐流動裝置生成,官方亦給出 5 秒、480×832、16 FPS、端到端約 20 秒延遲,以及 VBench 83.79 的成績。這些數字反映它追求的是「手機可跑,同時畫質不要跌得太明顯」,而不是只用極低參數換取能執行便算。

  • 支援單一提示詞影片生成,重點放在推理與部署而非訓練
  • 基於 Wan2.2-5B,透過 hybrid-attention surgery 與 head pruning 減低負擔
  • 可選 scheduler,包括 flow euler、unipcm 或 pipeline 預設方案
  • 生成流程提供 seed、略過既有輸出、較高品質 MP4 輸出等控制項目

這個項目的參考價值高;但它目前聚焦單一提示詞輸出,亦未見完整訓練鏈公開,適合拿來驗證推理路線,未必等同即插即用的產品方案。

項目主頁 · GitHub · 模型

Categories: 開源, 視頻模型, Video

Film space:用 iPhone 走出 AI 鏡頭路徑

想為 AI 影片保留真人運鏡感,Film space 提供一個幾直接的方法。你可以先喺 3D 場景排位,再用 iPhone 把走位同鏡頭移動錄成參考片段。

Film space

拍 AI 風格化影片時,最難控制的往往唔係畫風,而係鏡頭點樣郁、人物點樣企。Film space 把呢個問題拆得幾務實:它屬於 3D 預演工具,用 iPhone ARKit 把你真實行走時的裝置移動,轉成可錄製的虛擬鏡頭路徑,之後再交畀 Seedance 2.0 呢類工具做 AI style transfer 參考。

它的定位唔係直接生成影片,也唔係完整剪接系統,而係補上 AI video workflow 入面最易失真的一段:先用虛擬 studio 做 blocking,再用手機走一次鏡頭。相比純文字提示詞或者只靠模型自己猜運鏡,Film space 換來的是更清楚的鏡頭方向感;代價是你需要親身拿住 iPhone 進行錄製,而且目前明顯偏向單機、裝置端流程。

部署方式:整個流程在裝置上完成,建議橫向畫面使用,錄好的片段會存入相簿,再帶去後續生成工具。場景編排包括棋盤地板、格線、座標軸,亦可加入 human stand-ins 來模擬人物站位;去到 Camera mode,手機的移動、轉向與傾斜會直接變成鏡頭運動,配合 35mm、50mm、75mm、200mm 焦段預覽,對做分鏡、音樂錄像、短片測鏡頭的人尤其有幫助。

  • 把 blocking、走位同運鏡參考集中在同一個 iPhone 流程處理
  • 重點唔在生成畫面,而在為 Seedance 2.0 等模型提供更穩定的鏡頭參考
  • 以 ARKit 驅動 Camera mode,保留真人手持鏡頭的節奏感
  • 有基本 lens simulation 同 stand-ins,足夠做前期預演,但未見到進階場景製作能力

效能數據同正式 benchmark 目前未有公開,因此較難量化追蹤精度或錄製穩定性;現有資訊較能確認的是工作流設計,而唔係模型級指標。Film space 最適合用來做前期測試、概念驗證同低成本鏡頭預演,尤其當你想保留真人運鏡感,但又準備把最終畫面交畀 AI 重新風格化,這個項目的價值就會幾明顯。

GitHub

Categories: 開源, AI productions, Video, 工具, 3D, Dataset 數據集

Page 58 of 119
1 … 56 57 58 59 60 … 119