Diffusion Studio:智能影片剪輯工作流

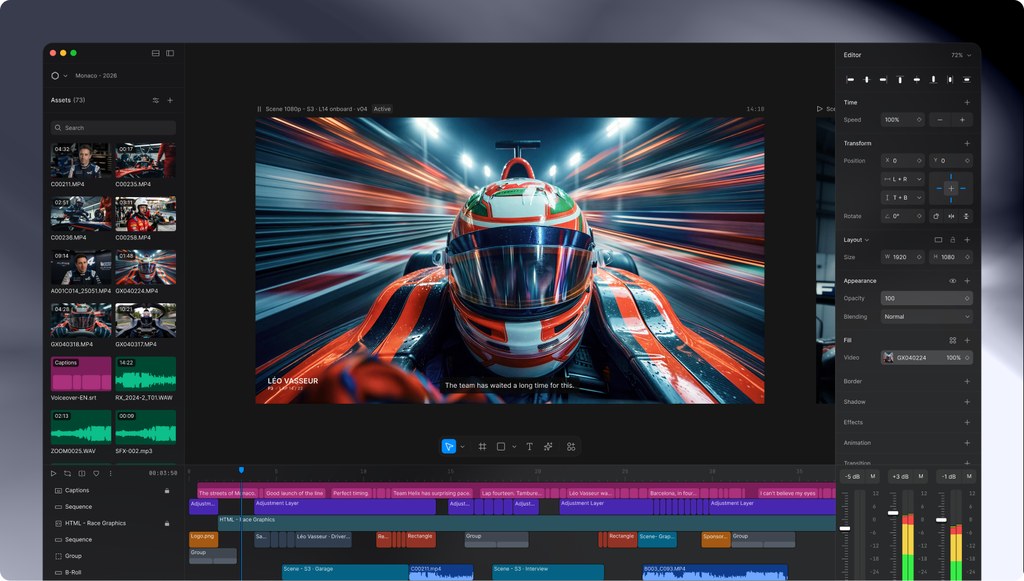
Diffusion Studio 將時間軸剪輯與 SolidJS 程式碼互相同步,讓 AI agents 可以直接協助製作影片。

Diffusion Studio

想用自然語言叫 AI 整理素材、剪出精華片段,甚至加入動態圖像和旁白,Diffusion Studio 提供了一條由命令列控制影片編輯器的工作流。它屬於開源影片編輯工具,核心是以 SolidJS modules 作為文件來源,處理由原始片段到成片的剪輯、合成和影片理解。

畫布與程式碼可以雙向修改:在畫布調整內容,變更會寫回程式碼;直接編輯程式碼,影片畫布亦會重新繪製。配合 dapi CLI,Claude Code、Codex、Cursor、Copilot 或 Gemini CLI 等 agents 能以文字指令操作時間軸,亦可要求系統摘要影片、搜尋場景,或找出附有時間戳的引述。

  • 影片剪輯、Motion graphics、社交平台短片重製
  • 以程式碼宣告圖片、影片和 voiceover,再合成到時間軸
  • 由命令列觀看及聆聽素材,交由 agents 協助處理
  • 可在 macOS Apple Silicon 使用桌面版本,並透過 skills 接入工作流

相比只在時間軸介面操作的編輯器,程式碼成為可保存、修改和交給 agents 處理的文件來源,較適合需要重複產出、批量改版或以生成式資產組成影片的團隊。代價是使用者要同時理解畫布、SolidJS modules 和 CLI 的關係;項目資料亦未提供獨立性能指標或完整平台支援範圍,不能單憑介紹判斷長片剪輯效率。

Diffusion Studio 連接 AI agents 之後可透過程式碼與影片時間軸進行編輯。內容創作者可先下載 macOS Apple Silicon 版本,再安裝官方 skills,透過自然語言要求建立影片,並在畫布中檢查結果;熟悉編程的團隊則可直接維護可重用的影片程式碼。
GitHub

Categories: 開源, Agentic, AI productions, IDE, Mac, 蘋果, Skill 技能

VoxEMW:把 Mac 變成 1.3 秒回應的私人語音助手

VoxEMW 將語音處理放在 Apple Silicon Mac,手機只需透過瀏覽器或 iOS 客戶端對話,回應速度與音色克隆是最大賣點。

Repository image for emwstudio/VoxEMW

對住手機講完一句話,約 1.3 秒後便聽到固定角色用克隆聲線回答,VoxEMW 屬於開源語音助手項目,處理判停、轉寫、對話調度及語音合成,解決語音對話延遲高、角色聲線難以保持的問題。Mac 負責主要語音管線,只有 LLM 大腦經 DeepSeek API 上雲,日常成本相對可控。

整套流程由 Silero 加 SmartTurn 負責判斷何時真正講完,Qwen3-ASR-0.6B-hf 在 MPS 上轉寫,再由 DeepSeek v4-flash 產生回覆,Qwen3-TTS-1.7B-Base 以 MLX 6bit 執行零樣本音色克隆。參考聲音配合逐字台詞便可註冊角色,首段聲音約 0.5 秒生成;中途打斷時,已播放及已聽內容會寫回上下文,對話較不容易斷層。

一块 4090 跑通 AI 视频通话全栈:Qwen3.8-27B 本地部署,对话时延 2 秒

項目需要 Apple Silicon Mac 作本地伺服器,實測以 M5、16GB 記憶體可以流暢運行,模型及環境約需下載 4GB。瀏覽器可直接連接本機介面;iPhone 或 iPad 則要透過局域網 HTTPS/WSS 連線,並自行處理 TLS 證書、Xcode 簽署及免費帳戶七日側載限制。

• 回應最快 1.26 秒,中位數約 1.6 秒,實際速度仍受網絡及 API 影響
• VAD、STT、TTS 留在本機,DeepSeek API 按 token 收費
• 支援流式字幕、空回覆重試及語音中斷後續接
• 全屏星空會隨說話及聲波變化,增加角色互動感

相比全程雲端方案,VoxEMW 減少語音資料離開家中 Mac,但需要一部 Apple Silicon Mac 長期運行;相比完全離線方案,DeepSeek API 帶來額外費用及資料傳輸考慮。適合想建立固定聲線角色、研究低延遲語音管線,或有 Mac 作家庭伺服器的開發者,普通使用者則要先接受證書、模型環境及 API 金鑰設定等門檻。

GitHub

Categories: 開源, 文字轉語音, Qwen, DeepSeek, API, 框架, Mac, 語音, 蘋果

needle:14MB 本地工具模型,專攻結構化操作

Needle 2 把工具呼叫、裝置操作和結構化抽取收進單一 14MB 引擎,本地跑完整對話只需約 28MB RAM。它適合要低記憶體、離線部署又要輸出 JSON 的工作流。

Needle

Needle 2 屬於用於 tool calling 的小型模型,同時處理 device use 和 structured extraction。它把輸入文字轉成可直接接入工作流的結構化結果,適合在本地裝置、隔離網絡環境或資源很緊的情況下部署。

這個 Python package 提供 inference、LoRA fine-tuning 和 export,安裝後會先從 Hugging Face 下載一次 engine,再在本機快取,之後不再依賴網絡。開發者只要描述工具,模型就會按 schema 產生 JSON,並用 byte-level grammar 收窄輸出範圍,減少格式跑偏。

This 14MB AI Model Runs Locally — Needle 2 Explained

它和同類小模型的取捨很明確:45M 參數、單一 14MB binary,換來的是極低記憶體佔用和離線運行能力;官方測試也顯示,它會和 FunctionGemma 270M、LFM2.5 230M 及 Apple FM 互有勝負,但體積小得多。另一個做法是加入 confidence score,低於門檻就可以交回人工或上層流程處理。

  • 單一引擎打包,部署時不用分開管理權重檔
  • 以 JSON 與 schema 約束輸出,方便串接工具鏈
  • 支援大量工具目錄,但每輪只取 top five
  • 256-token sliding window 令記憶體維持在約 28MB
  • 適合離線裝置、邊緣設備和需要穩定結構輸出的團隊

GitHub · 模型

Categories: 開源, 模型, 模型訓練, Python, 庫, 蘋果

JoyAI 把即時串流影片編輯推向 720p

影片逐幀抵達便可按文字指令修改,JoyAI-Video-Edit 以 30.19 FPS 連接即時攝影與生成式編輯。

JoyAI-Video-Edit teaser

直播畫面或上載影片不必等到完整片段準備好,便能一邊輸入自然語言指令、一邊看到修改結果。JoyAI-Video-Edit 屬於開源影片生成及影像處理模型,處理的是影片串流中延遲高、必須預先知道片長,以及難以維持連貫性的編輯流程。

它支援主體修改、局部區域調整、背景替換、風格轉換、動作改變和參考影像引導,適合互動示範、直播效果及需要即時預覽的創作工具。系統以 Multimodal Large Language Model(MLLM)條件編碼器、causal video Variational Autoencoder(VAE)及 16B-parameter Multimodal Diffusion Transformer(MMDiT)組成,逐段處理新抵達的畫面。

同類影片生成方法往往先取得完整影片,再一次過進行離線處理;JoyAI-Video-Edit 改用 autoregressive diffusion,配合 aligned autoregressive distribution matching distillation、long-horizon optimization、bounded Key-Value state(KV-state)inference 和 deployment-oriented scheduling,換取串流速度。不過,這種設計仍要留意長時間輸出可能出現的 temporal drift,而且消費級 GPU 支援仍列為待辦工作。

部署基準在 720×1280 解像度達到 30.19 FPS end-to-end throughput,代表系統已接近互動式影片處理所需的速度,但不能直接等同於所有硬件和指令下都能保持相同表現。Hugging Face 提供 JoyAI-Video-Edit checkpoint,GitHub 同時提供部署程式碼和線上 Demo,較適合具備 GPU 資源、希望整合影片工作流,或研究 Computer Vision 與串流生成的團隊。

  • 即時串流:畫面逐幀處理,不要求預先提供完整影片或固定片長。
  • 指令範圍廣:涵蓋主體、局部、背景、風格、動作及參考影像編輯。
  • 速度指標:720×1280 下達到 30.19 FPS 的完整流程吞吐量。
  • 部署取捨:透過 bounded KV-state inference 控制計算量,但消費級 GPU 支援仍未完成。
  • 適用人群:影片工具開發者、直播創作者及需要即時預覽的研究團隊。

GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, Google, NVIDIA, Video, 蘋果, Dataset 數據集

Color Pass-Through 重新做色彩校準

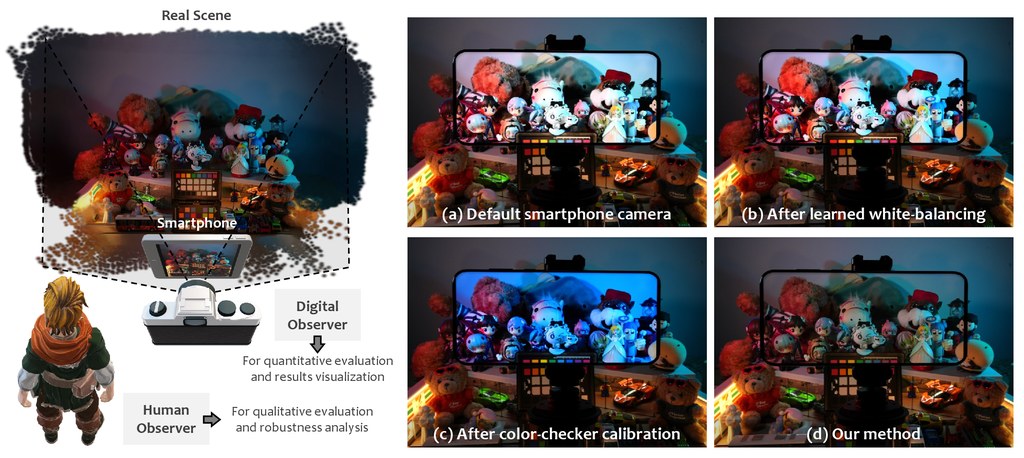
想令手機畫面更接近眼前真景,難處往往唔係相機或螢幕單獨夠唔夠準,而係兩者夾埋之後會一路累積偏差。Color Pass-Through就係針對呢個落差,將整條 camera-display 路徑一齊學起來。

Color Pass-Through teaser

想像你透過手機或頭戴裝置睇現場畫面,明明場景喺眼前,畫面顏色同亮度卻總有一層隔膜。Color Pass-Through 針對的正正係呢種 camera-display 不一致:它屬於影像處理研究項目,以端到端方式學習固定裝置上的 camera-display 路徑,目標唔係單獨校正相機或螢幕,而係令人經過裝置觀看時,感知上更接近真實場景。

作者明確反對傳統 ICC workflow 呢種兩段式校準範式。舊做法會先分開處理相機同顯示器,再靠預先定義的中介色彩空間接駁,誤差容易逐步累積;Color Pass-Through 改為直接學完整投影路徑,並為每位觀察者做 one-step calibration。呢個取向的好處係更貼近人眼最終見到的結果,代價就係它依賴特定 device pair,同時帶有 observer-specific 設定,泛化方式同傳統標準化流程唔一樣。

目前公開資訊顯示,項目已放出完整 training and inference pipeline,並提供兩款支援裝置的 pretrained checkpoints,所以較合理的理解方式係:它首先係研究原型,其次先係可重現的程式碼。資料集仲準備公開,Android toy example 亦仍在開發中,部署重點暫時仍然放喺已支援裝置上重現論文結果,而唔係即插即用地套入任何手機。

  • 核心改動係把 camera 與 display coupling,唔再經固定中介色域分開校正
  • 以每位使用者一次校準換取更貼近主觀觀感的色彩與亮度表現
  • 人類評分提升 +2.0 分(5 分制),亮度 4.32/5,色彩 4.03/5
  • 定量結果亦有明顯優勢,PSNR、ΔE、STRESS 在兩款商用手機上都優於列出的基線

同類方法很多時會加強 white balance、ColorChecker mapping,或者在既有 ISP 後面再補一層修正;這個項目則直接把問題重寫成特定裝置、特定觀察者的整體感知重建。對做 AR/VR pass-through、顯示校準、計算攝影研究的人最有參考價值,尤其當重點唔係標準色彩流程有幾完整,而係人眼最後見到的畫面到底似唔似真景。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 華為, 模型訓練, 蘋果, Dataset 數據集

GraphVid 把圖生影片拆解成圖節點關係圖

GraphVid 用一張關係圖重新組織影片生成流程,讓畫面之間的動作轉折更像被刻意安排,而非逐格拼湊。

Og image

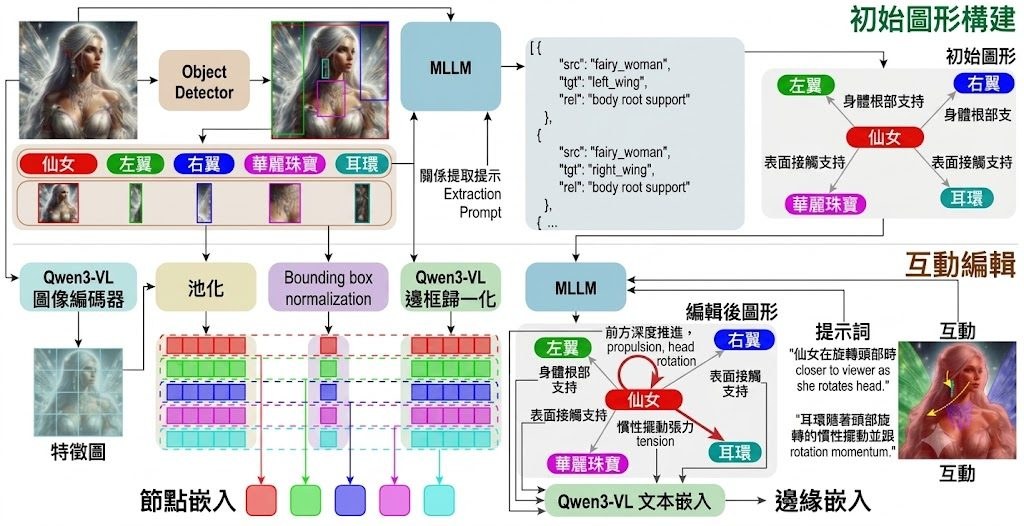
PLAN-Lab(伊利諾伊大學厄巴納-香檳分校)開源的 GraphVid 採用 Diffusers 框架,用 Stable Diffusion 類的 Diffusion Pipeline 配 bfloat16 精度載入,適用於 CUDA 與 Apple MPS 裝置。這個名稱裡的「Graph」不是社群網絡圖,而是把影片拆成多個關鍵畫面節點,再用一張小型關係檔 graph.pth(約 118 MB)描述節點之間如何銜接——模型先理解這些畫面該怎樣排序與過渡,再交由 transformer、VAE 等模組逐段生成。

頁面沒有公開 base model 來源,也沒有說明訓練資料或評測指標,因此難以判斷它的整體品質,只能從架構面推測它把控制粒度從「逐幀文字描述」轉移到「節點拓樸」。使用 DiffusionPipeline.from_pretrained 配合 torch_dtype=torch.bfloat16,屬於現今影片擴散模型常見的省記憶體做法。

從模型卡提供的程式碼範例可見,GraphVid 直接接受文字 prompt 即可生成畫面,毋須手動編排節點,這層抽象對一般使用者比較友善;進階用家則可透過 graph.pth 微調節點關係,控制運鏡節奏。整個 gvc_ckpt_folder 容量約 64.3 GB,包含 scheduler、text_encoder、tokenizer、transformer、VAE 等標準組件,搭配 Hugging Face 提供的 Colab / Kaggle 範例即可快速試跑。

  • 關係圖驅動:以 graph.pth 定義畫面節點與時序關係,再交由擴散模型生成影片。
  • Diffusers 相容:透過 DiffusionPipeline 載入,支援 bfloat16 與 CUDA / MPS。
  • Apache-2.0 授權:可自由下載研究與再分發,但頁面未提供量化版本。
  • 硬體需求高:完整 checkpoint 約 64.3 GB,建議使用高階 GPU。
  • 缺乏評測數據:原始頁面沒有提供基準分數或與其他影片模型的直接比較,採用前宜自行測試。

若以本地消費級 GPU 試跑,建議先把 torch_dtype 設為 bfloat16,並留意 VRAM 是否足以容納 transformer 與 VAE 的權重;想進一步壓縮,可留意社群後續是否釋出量化或 LoRA 版本。

項目主頁

Categories: 開源, Google, NVIDIA, Stable Diffusion, Image, 框架, 教學, Python, 蘋果

OpenWorker – Andrew Ng 開發桌面 AI 龍蝦

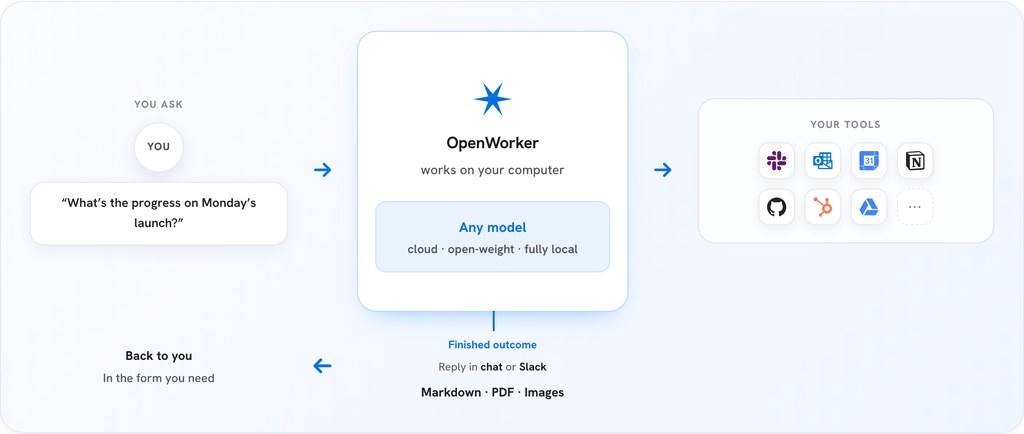
OpenWorker 係一個開源嘅桌面 AI 同事,由 Andrew Ng 團隊開發,強調本地執行、帶自己嘅模型 API key,並且會產出真正嘅成品而唔止係聊天回覆。

How OpenWorker works

對好多打工仔嚟講,最大嘅困擾唔係 AI 唔夠聰明,而係佢只識得「答問題」而唔識得「做完件事」。OpenWorker 嘅切入點正正喺呢度:佢定位係一個會跑喺你電腦上面嘅 AI 同事,可以幫你整理 calendar、寫 follow-up email、甚至自動出一份 customer brief,最後畀你一份可以直接開嚟用嘅文件,唔係一串對話。

OpenWorker 由 Andrew Ng(吳恩達)相關團隊推出,引擎建基於佢哋自己開發嘅 Python 開源庫 aisuite,呢個庫提供統一嘅 chat-completions API 以及支援工具調用(tool calling)、MCP 等功能。簡單講,OpenWorker 唔係從零寫起嘅 wrapper,而係將 aisuite 包成一個真正面向桌面用戶嘅應用,並且喺原本 aisuite 倉庫入面開發咗一段時間之後,先搬出嚟獨立成 repo。

目前支援 macOS(Apple Silicon)以及 Windows 10/11,用家可以貼上自己嘅 API key 去用 OpenAI、Anthropic、Google Gemini、DeepSeek、Kimi、Qwen、Mistral 等模型,亦可以經 Ollama 完全本地跑開源模型。所有嘢都喺本機行,只有用家授權嘅 model call 或者連接工具先會接觸到網絡。對於注重私隱或者公司政策唔畀數據出 cloud 嘅人,呢個係一個幾實際嘅選擇。

OPENWORKER: The Free AI Desktop Agent That Isn't Locked to One Model

佢亦內建 25+ 個整合,包括 GitHub、Slack、Jira、Notion、Linear、HubSpot、Outlook、Gmail、Google Calendar 等,亦支援任何可以經 MCP(Model Context Protocol)接駁到嘅工具。最令筆者欣賞嘅係佢嘅審批機制:寫訊息、發送郵件、執行 shell 指令呢類「對外有影響」嘅動作,全部都要先經你確認先至會執行,唔會自己靜靜雞撳掣。

以下係幾個用家會比較關心嘅重點:

  • 定位係桌面 AI 同事,目標係交到「成品」而唔止係聊天回覆,例如 HTML brief、Markdown 報告、排好嘅 calendar 更新等。
  • 完全開源、MIT 授權,由 Andrew Ng 團隊開發,引擎建基於佢哋嘅 aisuite 開源庫。
  • 模型自選,支援多間主流 cloud provider,亦可以經 Ollama 完全本地執行開源模型。
  • 重視私隱,對話、token、API key 都儲喺本機 secret store,唔需要登入亦可以用。
  • MCP + 審批機制,所有對外動作(發訊息、執行指令)都會先問過你先做,減低「AI 自行撳掣」嘅風險。

如果你係一個人或者小型團隊,想搵一個可以幫你「跑手」而唔係淨係「傾偈」嘅 AI 工具,又唔想將公司敏感資料送去閉源服務,OpenWorker 算係一個值得試嘅選擇。佢而家仲喺 open beta,官方表示會自動更新、不斷執吓啲 bugs,畀用家提交 issue。適合想認真將 AI 融入日常工作流、對私隱同可控性有要求嘅人。

項目主頁 · GitHub

Categories: 開源, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Ollama, Python, Anthropic, 蘋果, Kimi

ABot-World 把互動世界模型帶上桌面 GPU

ABot-World想解決的,不是再做一段更長影片,而是讓生成世界可以持續回應操作。你可以把它理解成一個開始接近可玩狀態的互動式世界模型示範。

ABot World 0

影片生成做到流暢並不罕見,但能一邊接收操作、一邊把世界延伸落去,門檻就高得多。ABot-World定位屬於模型加示範工具,核心處理的是 action-conditioned world rollout:用戶輸入動作之後,系統持續生成可探索的世界,而唔係播完就停的被動片段。

呢個項目的取向相當鮮明:它唔係先追求超高畫質,而是把「可互動、可持續、可在單張桌面顯示卡跑起來」放到前面。官方公開的數字是單張 NVIDIA RTX 5090 可在 720P、16 FPS、1.2 秒延遲、19GB GPU 記憶體下運行,配合 LongForcing training 減少 scene lock-in,令 rollout 期間可以擴展新場景同動態,唔使靠 prompt switching 硬接續。

測試方式算直接:項目已提供本地 gradio demo,同時有線上版 ABot World Studio;想自己部署,它在 Ubuntu 22.04、CUDA 13.3、NVIDIA RTX 5090 環境驗證過,並要先下載 ABot-World-0-5B-LF checkpoint。換句話說,現階段較適合把它理解成高階桌面 GPU 上的研究型互動系統,而唔係一般消費級硬件都能順手跑的輕量工具。

幾個重點值得留意:
– ABot-World-0-5B-LF 已公開,屬於 causal student model
– 互動重點在連續探索,不是固定長度 video generation
– 本地推理與線上 playground 都已提供,驗證路徑清楚
– Bidirectional Teacher Model 仍未釋出,生態暫時未算完整

適合研究 world model、interactive video generation、Agentic 模擬環境,或者想為遊戲原型與具身智能測試場景找參考的團隊。現階段的吸引力在於它把「無限 rollout」和「單桌面 GPU 即時推理」放到同一個項目內。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視頻模型, 世界模型, 模型訓練, Google, NVIDIA, Video, Linux, 蘋果

OpenCoF 用影片學會推理

推理未必只靠文字一步步寫出來,OpenCoF 把重點放到影片幀與幀之間的連續變化。它想證明,生成影片本身都可以成為推理過程。

Repository image for xinyan-cxy/OpenCoF

文字 Chain-of-Thought (CoT) 之外,OpenCoF 把推理搬到影片時間軸上,主打 Chain-of-Frame (CoF) reasoning:模型不是靠外部工具拆步驟,而是在連續生成的畫面裡理解因果、規則同狀態變化。這屬於一個研究型框架,核心想處理的問題,是現有影片生成模型多數只見過一般影片資料,未必學到穩定的時序推理能力。

作者對既有做法的批評很明確:以往影片模型通常用通用影片語料訓練,缺少專門針對 CoF reasoning 的監督,因此即使畫面能動起來,都未必真係「識推」。OpenCoF 於是補上兩層東西:先有 OpenCoF-17K 這個包含 17,312 段影片、覆蓋 11 類任務的資料集,再用它把 Wan2.2-I2V-A14B 經 LoRA 微調成 Wan-CoF,之後再加上 Visual Reasoning Tokens (vt) 與 Textual Reasoning Tokens (tt) 兩種設計。

OpenCoF 先用資料監督驗證影片推理能否被教出來,再用 token 設計補強中間推理狀態,而不是一開始就堆很多複雜推理機制。公開資訊顯示,Wan-CoF 單靠資料監督,已經在 MME-CoF、Gen-ViRe、VIPER、RULER-Bench 四個外部 benchmark 全面勝過基線;Wan-CoF vt 與 Wan-CoF tt 則再向前一步,但兩者偏重不同,vt 較擅長低階視覺線索,tt 較著重高階語意先驗。

  • OpenCoF-17K 由四條資料整理流程建成,兼顧規則型任務、程序生成場景與真實影片多樣性
  • Wan-CoF 以 Wan2.2-I2V-A14B 為底,靠 LoRA 微調驗證資料本身已可提升推理表現
  • Wan-CoF vt / Wan-CoF tt 分別從視覺 latent 與文字條件序列加入 reasoning tokens,走兩條互補路線
  • 評測覆蓋 MME-CoF、Gen-ViRe、VIPER、RULER-Bench,結果指向同一件事:時序監督對影片推理有明顯幫助

OpenCoF 適合研究團隊、做視覺推理評測的人,或者關注 Video reasoning 與 Video generation 交界的開發者參考:儲存庫已公開論文與方法框架,但 code、dataset 同 model checkpoints 仍在內部審核,暫時未能直接下載測試;現時較合理的理解方式,是先把 OpenCoF 視為一個針對 CoF reasoning 的資料與訓練範式,等正式釋出後再判斷重現成本與落地價值。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 字節跳動, 視覺模型, 多模態模型, 視頻模型, Video, 蘋果, Dataset 數據集

LiveEdit:串流影片編輯走向即時化

LiveEdit 把文字指令變成串流影片編輯,重點放在速度與畫面穩定。它嘗試兼顧即時反應,以及背景與非編輯區域的保留。

Image 1

LiveEdit 是一個 diffusion-based streaming video editing 系統,屬於影片編輯模型與方法項目。它的核心任務是根據來源影片加上文字指令,逐段完成 causal chunk-by-chunk editing,並盡量保留背景與沒有修改的區域。

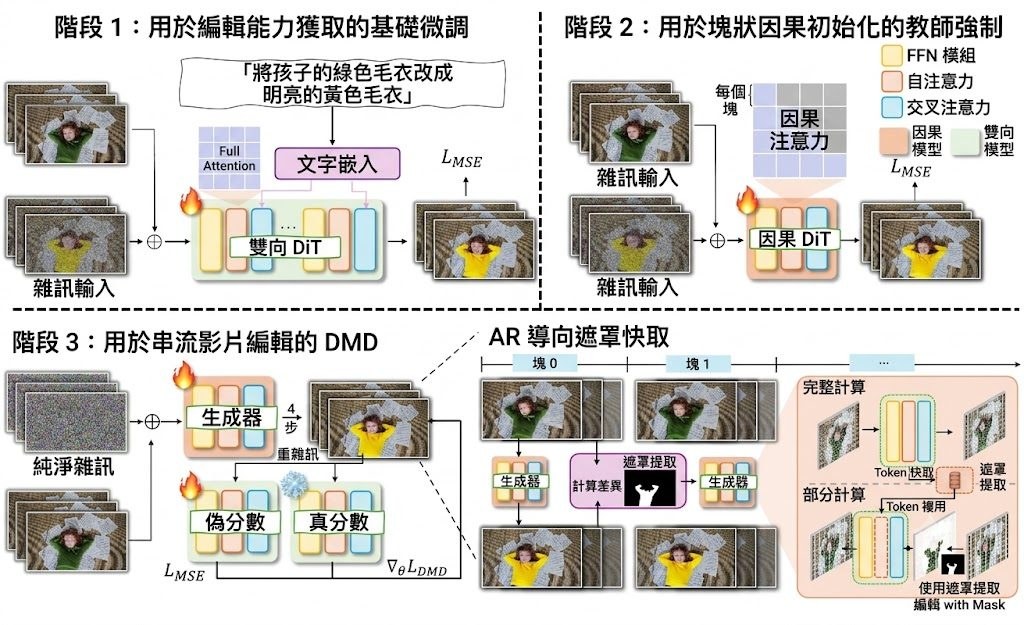
這個項目不是追求離線影片慢慢算到最靚,而是針對接近即時的串流編輯。它建基於 Wan2.1 和 Self-Forcing codebase,並用 three-stage distillation,把雙向編輯 teacher 的能力轉移到串流 student,再配合 AR-oriented Mask Cache 減少重複運算,換來較低延遲。

部署與測試資訊算是完整,提供 inference scripts、training code、checkpoint instructions,也講明建議在 Linux 配合 NVIDIA GPUs 執行;單 GPU 可做 inference,多 GPU torchrun 主要用於訓練。輸入方式是準備一個 JSON,填入 source video 路徑和 instruction,然後配合已釋出的權重與 Wan2.1 base model 進行推理。

有一個相當關鍵的參考值:項目頁列出 12.66 FPS,並表示透過 4-step distilled diffusion generation 達成 real-time streaming inference。這個成績對互動式影片編輯很重要,不過公開資訊未見更完整的硬件條件、顯存需求或不同解析度下的比較,因此判斷效能時仍要保留一點。

  • 重點不是一般文字生片,而是保留原片內容的串流影片編輯
  • 主要技術包括 three-stage distillation、Causal DiT、AR-oriented Mask Cache
  • 已公開 inference 與 training 程式碼,也提供 Hugging Face checkpoint 指引
  • 已知較適合 Linux、NVIDIA GPU 環境,研究團隊或影像生成工程師較易受益
  • 相關模型與基礎包括 Wan2.1-T2V-1.3B、bidirectional editing teacher、streaming student

整體來看,LiveEdit 的價值在於把 streaming video editing 做得更接近可互動系統,而不只是展示級效果。它較適合研究即時影片編輯、互動內容製作、直播視覺處理或需要低延遲生成的團隊;一般用家若想直接在圖形介面一鍵開用,現有資料未提供管理後台整合、免手動設定流程,仍然比較像面向研究與開發者的項目。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Video, 框架, Linux, 蘋果

Page 3 of 4
1 2 3 4