teardown:把機器原理變成可拆解的 3D 模擬器

想了解引擎、手錶或挖掘機怎樣運作,可以讓 Claude Code 生成一頁式模擬器,邊看機器運轉,邊拆開部件追蹤數值。

Mellis HB-7 robotic bee simulator

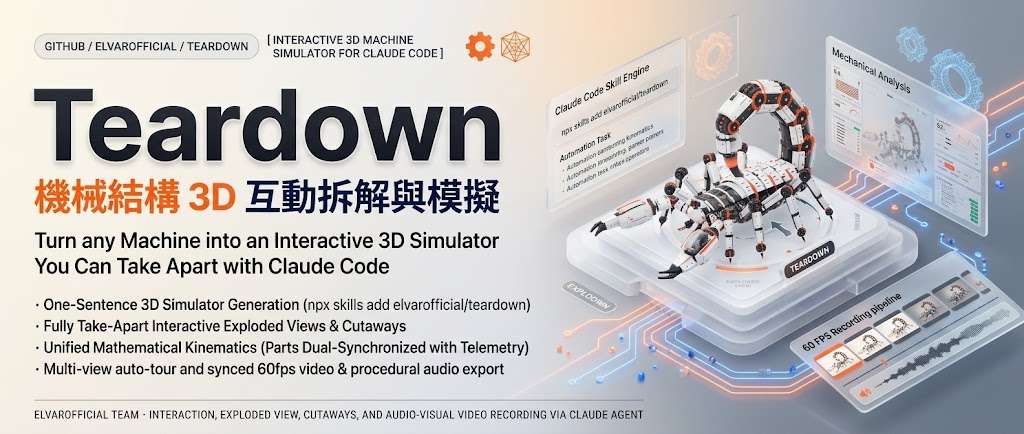
想弄清楚四衝程引擎如何運作,單看文字或靜態圖解未必容易掌握部件之間的關係。teardown 是一項 Claude Code skill,會按自然語言指示生成離線 HTML 3D 模擬器,讓機器在畫面中央運轉,周邊面板同步顯示數值,亦可按鈕打開正在工作的部件。

使用者可在 Claude Code 以日常語句描述想了解的機械,例如機械手錶或液壓挖掘機臂,再要求生成模擬器;項目亦附有 V8 引擎、Cessna 飛機和 Strandbeest 機械生物三個例子,可用 Node.js 建成單一 HTML 頁面。安裝需要 Node.js 20 或更新版本,以及 Playwright 的 Chromium;影片輸出另需 ffmpeg,聲效製作則需 Python。主要使用方式是透過 Claude Code 提出描述。

生成的頁面會把 three.js 和字體內嵌,方便離線開啟;模擬器閒置時會自動巡覽,亦可把畫面逐格輸出成 60 fps MP4,並配上時間軸聲效。相較只提供動畫的展示頁,它把機械運作、即時數值與可拆解部件放在同一介面。

較適合製作互動式教學素材、概念展示或機械原理解說的教育工作者、設計師和工程團隊。要留意,生成品質會受描述與 Claude Code 產出影響;若內容用於工程驗證或安全判斷,仍需另行核實模型設定與數據。

  • 以自然語言要求 Claude Code 建立機械 3D 模擬器。
  • 單一離線 HTML 頁面包含機器動畫、數值面板和部件拆解互動。
  • 可將模擬器畫面輸出為 60 fps MP4,並加入程序化聲效。
  • 內附 V8 引擎、Cessna 飛機及 Strandbeest 三個示例。
  • 文件未提供物理準確度評測,生成結果不宜直接當作工程驗證。

GitHub

Categories: 開源, AI productions, 模型, Video, 教學, 3D, Python, 安全, Anthropic, 動畫, 聲效, Skill 技能

video-shotcraft:用一張產品圖製作可編輯的宣傳片

video-shotcraft 將 Claude Code 或 Codex 接到影片製作流程,以 Remotion 排版真實產品截圖,交付可編輯 MP4。

video-shotcraft logo

只要向 Claude Code 或 Codex 提出「替產品製作宣傳片」,video-shotcraft 便會擷取產品真實頁面,選取鏡頭、編排故事線,再以 Remotion 動畫化。最終輸出 MP4、瀏覽器編輯器 Motion Workbench,以及剪映可編輯草稿,方便後續修改。它不是端到端影片生成模型,而是一套整合截圖、動態配方、節拍與音效的 agent skill。

  • 以真實截圖及文案作畫面素材,保留品牌外觀與文字清晰度
  • 提供 124 張 recipe cards,涵蓋 150 種鏡頭及預覽
  • 流程涵蓋 storyboard、Remotion 動畫、節拍同步、聲效及逐格檢查
  • 可交付 MP4、Motion Workbench 與剪映草稿

這種做法與文生影片模型的分別,在於每一幀都由程式碼繪製,而不是生成抽象影像;代價是成品取決於頁面素材、shot recipe 的覆蓋範圍及 Remotion 排版,創意空間主要來自鏡頭選擇和動態組合。36.2 秒的 ready template 可供快速改稿,但較長或講解密集的產品影片仍需要重新編排內容。

產品團隊、獨立開發者及需要反覆製作版本宣傳片的 marketing 部門,都可從「保留可編輯性」中受益。工程師可用現有網站截圖建立視覺稿,內容團隊亦可沿用剪映草稿調整節奏,省去由錄屏再逐段重做動畫的時間。

一行 “幫我安裝這個 skill:https://github.com/Vincentwei1021/video-shotcraft” 便完整安裝。適合希望將影片製作納入 coding agent 工作流、而非直接生成寫實片段的團隊。

項目主頁 · GitHub · 作品展示

Categories: 開源, Agentic, AI productions, Video, Image, Vibe Coding, 編程, Anthropic, 動畫, 聲效, Skill 技能

SoulX-Singer 把零樣本歌聲合成

想快速試一把未見過的歌手聲線,SoulX-Singer提供咗幾近成品級嘅路線。它唔只唱得準,連跨語言同改詞後的人聲一致性都放埋入同一套流程。

SoulX-Logo

做歌聲生成,最難往往唔係「唱到」,而係未見過的聲線仍然要自然、準音、像本人。SoulX-Singer正是朝住呢個矛盾而來的開源模型項目,重點放在 zero-shot singing voice synthesis:唔使為每位歌手再微調,都可以用參考聲線配合旋律或樂譜生成歌聲。

它的定位幾清楚:一邊照顧創作控制,一邊盡量保住音色身份。你可以用 melody-conditioned 的 F0 contour 控制音高走向,亦可以用 score-conditioned 的 MIDI notes 對齊節奏與音符;對於需要改詞、換語言、保留同一把聲去做 demo、作曲草稿或虛擬歌手內容的人,這種控制方式比只靠文字描述更實際。README 亦提供 Hugging Face 模型與線上示範,部署理解上屬於下載預訓練權重後做推理的典型流程。

同類做法常見取捨,是控制愈細,聲線就愈易散;複製音色愈強,跨語言和改詞後又可能變得生硬。SoulX-Singer把 timbre 與 content 盡量拆開處理,目標是讓 Cantonese、Mandarin、English 之間仍能維持歌手辨識度,這點比單純追求「像真」更有產品意味。項目另外還有從 SoulX-Singer 微調而來的 SoulX-Singer-SVC,處理 singing voice conversion,直接由原始歌聲音訊轉換成目標歌手風格,連歌詞或 MIDI 標註都可省去。

  • 支援 F0 contour 與 MIDI 兩種控制,適合作曲草稿與精修流程
  • 主打 zero-shot,未見過的歌手聲線都可生成,減少逐人微調成本
  • 42,000+ 小時對齊人聲資料覆蓋 Mandarin、English、Cantonese
  • 可做改詞編修與跨語言合成,同時維持音色一致性
  • 另設 SoulX-Singer-SVC,補上 audio-to-audio 轉換場景

現有資料未完整列出量化指標細節,但項目已公開技術報告、arXiv 與示範頁,代表它不只停在概念展示。對音樂 AI 團隊、虛擬歌手內容製作、語音與歌聲研究者而言,SoulX-Singer吸引之處在於它把可控性、跨語言與免微調三件事放入同一條生成鏈,而限制則仍要留意倫理風險、聲線授權,以及最終作品是否需要後期混音補足細節。

GitHub · 模型

Categories: 開源, 模型, Audio, 聲效, 音樂

LatentOmni 想重寫影音推理方式

這個項目嘗試讓模型不只靠文字思考,而是直接結合聲音與畫面推理。對複雜影音理解來說,方向相當值得留意。

LatentOmni

LatentOmni 是一個面向影音多模態大語言模型的研究項目,重點不是叫模型先把線索全都翻成文字再慢慢推理,而是讓聲音與畫面的資訊在同一個潛在空間內一起運作。簡單講,它想保留更多原始感官訊號,減少中途只靠語言猜答案的情況。

這個方向要解決的問題很明確:不少模型在看影片、聽聲音後,雖然能描述內容,但一遇到需要同時對齊時間、事件因果或細節關聯的題目,表現便會下跌。LatentOmni 提出的做法,是把文字推理流程與影音潛在狀態交錯進行,並用 OSPE 這類時間同步設計,幫助模型對準聲畫節奏。

從使用角度看,現時這個 GitHub 儲存庫仍以論文與概念介紹為主,訓練程式、推論程式、模型權重和資料集尚未正式釋出。因此較適合先拿來了解新一代多模態推理方法,或者作為研究與技術評估的參考,而不是立即部署到產品流程。

  • 核心亮點是統一聲音與畫面的潛在推理,而非只輸出文字式思路
  • 加入特徵層級監督與 OSPE,目標是保留時間對齊與跨模態關聯
  • 配套資料集為 LatentOmni-Instruct-35K,用來訓練交錯式影音推理軌跡
  • 論文指出它在多個影音推理基準上,表現優於明確文字 CoT 基線

整體來看,這個項目最吸引之處,是它把「模型怎樣思考」由文字中介,推前到更接近原始聲畫訊號的層面。適合關注 MLLM、影音理解、跨模態推理的人留意;若你想比較相關模型,也可把它與依賴文字 CoT 的開源多模態模型放在同一條線上觀察。不過現階段公開內容有限,性能細節仍應以論文報告為準,評估時要保持審慎。

GitHub: https://github.com/yfanDai/LatentOmni

Paper: https://arxiv.org/pdf/2605.22012

Categories: 開源, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 影像處理, 聲效, 中國

wvs-code:用影片與聲音驗證模型是否真懂內容

Thud 用介入式測試,檢查多模態模型是靠真實音訊,還是只看畫面線索。適合做研究、評測與訓練資料整理。

Repository image for rakanWen/wvs-code

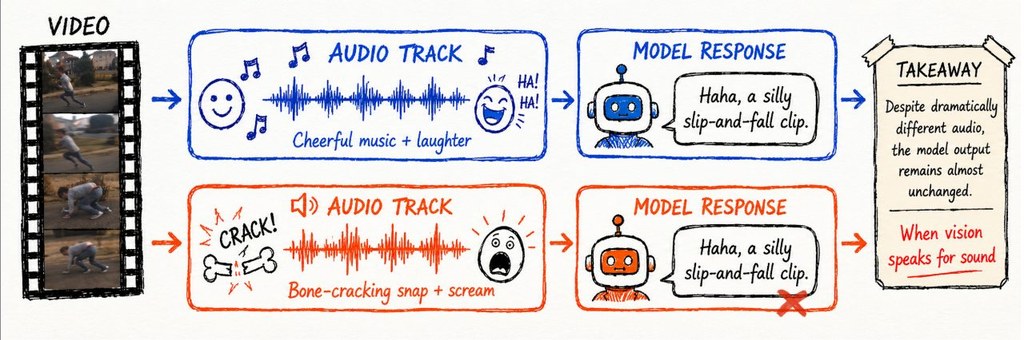
專案《When Vision Speaks for Sound》t提供官方程式碼,核心目標不是做一般影音問答,而是檢查支援影片的多模態模型,究竟有沒有真正理解聲音,還是只靠畫面和語意猜答案。它提供模型、評估介面和訓練流程,方便研究者重現實驗或改造自己的測試方式。

儘管支援視頻的多模態大語言模型(video-capable MLLMs)進步很快,但研究發現它們在視頻中表現出的「音頻理解」能力往往是由視覺驅動的:模型其實是依靠視覺線索來推斷、甚至幻想出聲音相關的資訊,而不是真正去檢查或分析音頻串流本身 。

這個問題普遍存在於:

最先進的開源全能模型(omni models)

主要閉源模型供應商(如 Google 和 OpenAI)的頂級模型

換句話說,這些模型看起來能「聽懂」視頻中的聲音,但實際上它們只是「看」畫面來猜聲音是什麼,並沒有真正處理音頻數據,因此容易產生錯誤或幻覺(hallucinate)。

先準備好影片和音訊資料,再把資料登記到 LLaMA-Factory 的資料設定中,之後就可以用它的 SFT 或 DPO 格式去訓練。專案也支援把樣本寫成 ShareGPT 風格,讓每條資料同時帶上 <video> 和 <audio>,方便模型學習在多模態情境下作答。

它比較特別的地方,在於採用介入式診斷框架 Thud,專門測試模型是否真的有做音訊驗證,而不是只走視覺捷徑。這種設計對研究「模型到底看了甚麼、聽了甚麼」特別有用,也比單純準確率更能揭示模型行為。

  • 可用來評測影片語音、音畫同步、時間延遲等問題
  • 適合做多模態模型研究、除錯和基準測試
  • 支援 SFT 與 DPO 訓練流程
  • 可接入 LLaMA-Factory 一起使用
  • 相關模型與框架重點包括 Thud、LLaMA-Factory 以及多種可處理影片的多模態模型

整體來說,這個專案更像是一套「檢查工具」,而不是面向一般用家的應用程式。對做 AI 研究、影音理解評測,或者想分析模型有沒有偷懶靠畫面猜答案的人,會特別有參考價值。

GitHub: https://github.com/rakanWen/wvs-code

Paper: https://arxiv.org/pdf/2605.16403

Categories: 開源, 模型, 視覺模型, 影像處理, 框架, 聲效

YingMusic-Singer 改歌詞也不用重唱

你可以把它理解成一個把歌詞、旋律和歌聲編輯放在同一條流程的框架,適合處理需要快速改詞、改旋律的歌聲生成工作。免手工對齊與零樣本能力,但 beta 版已停用,現時要改用 beta 分支。

pipeline

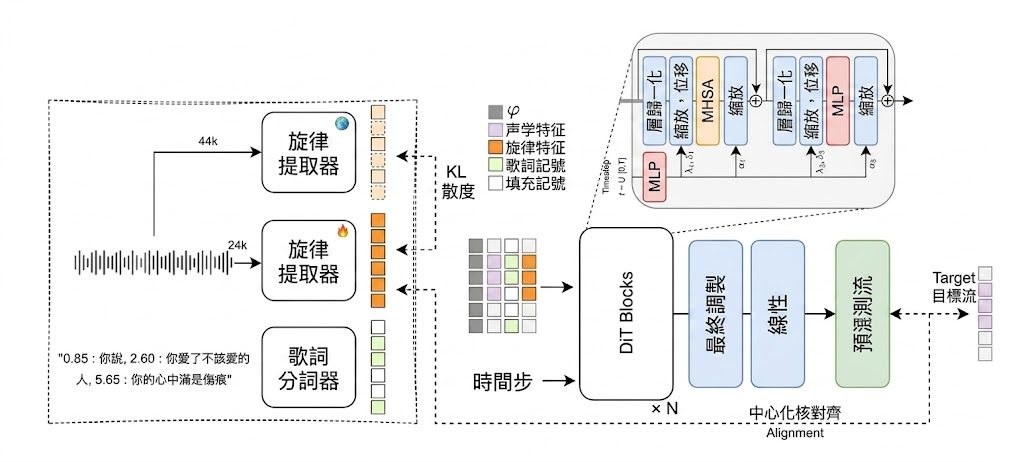
YingMusic-Singer 是一個 Zero-shot Singing Voice Synthesis (SVS) 與編輯框架,目標是解決歌聲合成裡最麻煩的對齊和標註成本。它把「用參考旋律生成新歌詞」和「直接改寫既有歌聲」放在同一套流程內,對要做快速原型、音樂內容改稿、或批量製作不同版本歌聲的團隊特別有吸引力。

它的核心做法是 Annotation-free Melody Guidance,不用再依賴昂貴的 phoneme-level alignment,亦不需要人工補 MIDI 標註。使用時可以餵入參考音訊,讓系統自動抽旋律;亦可以直接輸入 MIDI,令旋律來源更彈性。令它比傳統要逐句對齊的做法輕身很多,但也意味著成品質素會更依賴參考旋律本身是否清晰。

  • 支援 zero-shot 合成與編輯,兩種流程放在同一個框架內
  • 可由參考音訊自動抽旋律,亦可直接用 MIDI
  • 不需要針對目標聲線再做微調
  • beta 版已停用,現時要改用 beta 分支

技術上,它採用 Diffusion Transformer (DiT) 式生成模型,再配合預訓練旋律抽取模組,由參考音訊導出 MIDI 資訊,然後再做受控生成。加入 Flow-GRPO reinforcement learning 去改善發音清晰度、旋律準確度和音樂性,但現有公開資料未見完整量化表格。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 語音, 聲效, 音樂

PrismAudio 視訊立體聲模型框架

PrismAudio 是一套影片生音訊框架,把強化學習帶進 V2A 任業,並以 Chain-of-Thought 拆開語意、時間、美感、空間四個目標,讓生成結果更貼合人類偏好。

以往 Video-to-Audio(V2A)模型總要在語意對不對、聲畫同步、音色好唔好聽、空間定位準唔準四個指標之間拉鋸,往往一個 loss function 包起晒,結果邊樣都做唔好。PrismAudio 想處理嘅就係呢個「目標纏結」問題。

佢最特別嘅做法係把生成過程拆成四個專門嘅 Chain-of-Thought 模組,分別對應語意、時間、美感、空間,每個模組配對一組針對性嘅 reward function,再用 RL 聯合優化。換句話講,模型唔再係靠單一總分亂試,而係四個維度各自有指引。

訓練成本係 RL 常見痛點。PrismAudio 提出 Fast-GRPO,用 ODE 同 SDE 混合採樣,比起一般 GRPO 實現大幅減低開銷,令多維度 RL 訓練變得貼地。

團隊亦同步推出 AudioCanvas 基準,包含 300 個單事件類別同 501 個多事件樣本,比現有數據集更貼近真實多樣場景。喺 VGGSound 同 AudioCanvas 上,PrismAudio 都拎到四個感知維度嘅 SOTA。

配搭 Sora 2、Veo 3 等頂級影片生成模型時,PrismAudio 可以補上立體聲音軌,令短片多一層沉浸感。對做 AI 影片、數字人、內容創作嘅人來說,多咗一件可以直接嵌入成片流程嘅音訊工具。

重點摘要

  • 首次把強化學習引入 V2A 生成流程。
  • 四個 Chain-of-Thought 模組對應語意、時間、美感、空間 reward,拆解目標纏結。
  • Fast-GRPO 以 ODE-SDE 混合採樣降低 RL 訓練成本。
  • 自建 AudioCanvas 基準涵蓋更多真實多事件場景。
  • 喺 VGGSound 同 AudioCanvas 上四個感知維度都達到 SOTA,並可配合頂級影片模型輸出立體聲。
  • 語義合理性(Semantic)
  • 音視同步性(Temporal synchrony)
  • 音質美感(Aesthetic quality)
  • 空間準確度(Spatial accuracy)

作者的關鍵點是:現有模型通常把這些目標混在一個損失函數裡,會造成「目標互相干擾」(objective entanglement),而 PrismAudio 用 分解式 Chain‑of‑Thought(CoT)推理+多維度強化學習(RL) 來避免這個問題。

項目主頁

Categories: 開源, 視覺模型, 聲效

LTX-2 影音片生成模型

LTX-2 是 Lightricks 開發的 DiT 基礎音訊影片生成模型,整合影片與音訊的同步生成功能,具備一次推論即可產出同步音訊與影片的能力。模型採用 190 億參數,另外提供 fp8、nvfp4 等壓縮量化版本,以及 190 億參數的蒸餾版本與 LoRA 微調版。所有模型都以 safetensors 格式提供,代碼與模型權重均在 Hugging Face 上公開,使用 ltx-2-community-license-agreement 授權,屬於開源模型。可直接於本地使用 PyTorch 或 Diffusers 套件呼叫,亦支援 ComfyUI 整合,適合多階段上采樣流程。


LTX-2 是 Lightricks 開發的 DiT 基礎音訊影片生成模型,整合影片與音訊的同步生成功能,具備一次推論即可產出同步音訊與影片的能力。模型採用 190 億參數,另外提供 fp8、nvfp4 等壓縮量化版本,以及 190 億參數的蒸餾版本與 LoRA 微調版。所有模型都以 safetensors 格式提供,代碼與模型權重均在 Hugging Face 上公開,使用 ltx-2-community-license-agreement 授權,屬於開源模型。可直接於本地使用 PyTorch 或 Diffusers 套件呼叫,亦支援 ComfyUI 整合,適合多階段上采樣流程。

New #1 open-source AI video generator is here! Fast + 4K + audio + low vram
https://infernews.com/comfyui-ltx-2-video/
Categories: 開源, 視頻模型, 聲效

Meta 推出開源 SAM 音訊

Meta 的 SAM Audio 是首個統一的多模態模型,能從複雜音頻或視頻中精準分離特定聲音。 SAM Audio 支持文字提示(如「狗叫聲」或「人聲」)、視覺選擇(如點擊視頻中樂手)或時間範圍提示,來隔離目標聲音並生成殘餘音頻。 它適用於音樂、語音和一般環境音,超越傳統單一工具。 模型基於 Flow-Matching Diffusion Transformer,在 DAC-VAE 潛在空間運作,提供小(500M 參數)、基(1B)和大(3B)版本。 它能同時生成目標與殘餘音軌,支援真實世界場景如去除背景噪音。

Meta 的 SAM Audio 是首個統一的多模態模型,能從複雜音頻或視頻中精準分離特定聲音。

SAM Audio 支持文字提示(如「狗叫聲」或「人聲」)、視覺選擇(如點擊視頻中樂手)或時間範圍提示,來隔離目標聲音並生成殘餘音頻。 它適用於音樂、語音和一般環境音,超越傳統單一工具。

模型基於 Flow-Matching Diffusion Transformer,在 DAC-VAE 潛在空間運作,提供小(500M 參數)、基(1B)和大(3B)版本。 它能同時生成目標與殘餘音軌,支援真實世界場景如去除背景噪音。

Categories: 開源, Python, 聲效

NVSpeech 處理副語言聲音

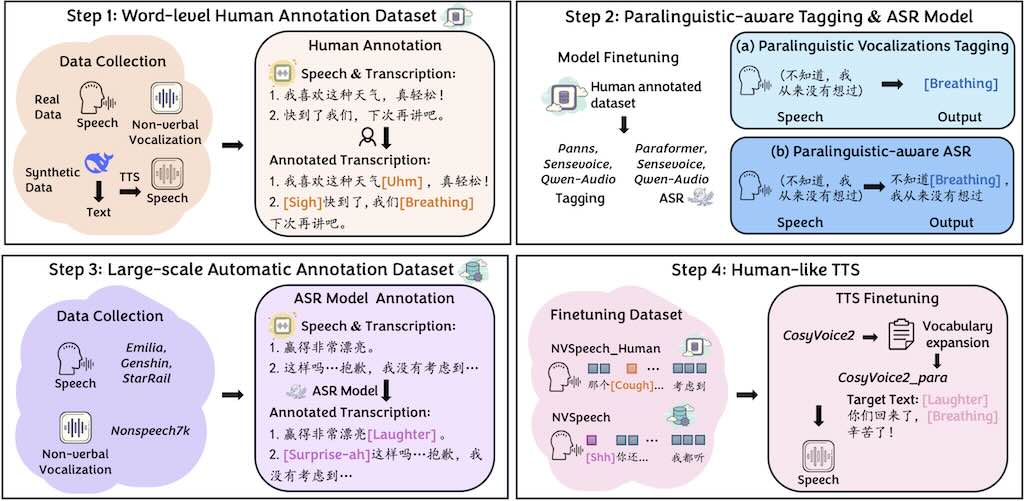
NVSpeech 用於處理副語言聲音(paralinguistic vocalizations),包括非語言聲音(如笑聲、呼吸)和詞彙化插入語(如「uhm」、「oh」)。這些元素在自然對話中至關重要,能傳達情感、意圖和互動線索,但傳統自動語音辨識(ASR)和文字轉語音(TTS)系統往往忽略它們。

NVSpeech 用於處理副語言聲音(paralinguistic vocalizations),包括非語言聲音(如笑聲、呼吸)和詞彙化插入語(如「uhm」、「oh」)。這些元素在自然對話中至關重要,能傳達情感、意圖和互動線索,但傳統自動語音辨識(ASR)和文字轉語音(TTS)系統往往忽略它們。

Categories: 開源, 香港中文大學, 模型, Mac, 語音, Win, 聲效

Page 1 of 2
1 2