MRPO:醫療多模態推理訓練新路線

MRPO 不是再追最終答案分數,而是直接修補推理中途出錯的位置。醫療 VQA 表現因此更穩,也更有可遷移性。

alt text

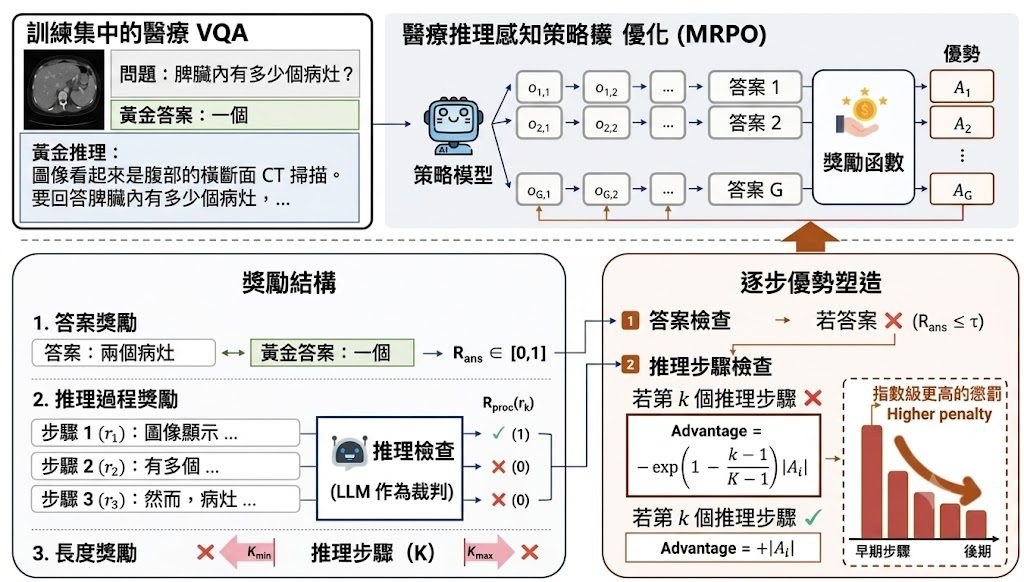
MRPO 是一個用於醫療多模態推理的強化學習框架(reinforcement learning framework)。它要解決的問題不是單純答對與否,而是醫療 VQA 過程中推理鏈一早出錯,之後一路連鎖失誤,令最後答案偏離。

現有 post-training 做法多數偏向 outcome-centric,主要看 final answer correctness 或 sequence-level preferences。作者認為這種範式的問題是 sparse credit assignment,模型知道答錯,卻未必知道究竟由哪一步開始失準;MRPO 因而改寫 GRPO-style advantages,結合 answer-level reward 與 step-wise process rewards,並在最終答案錯誤時,對較早出現的 invalid steps 給予更大懲罰。

這個設計的取向很明確:它不是只罰錯答案,而是重新分配學習訊號,優先修正最早發生的推理錯誤,避免 failure cascades 擴大。README 提到,MRPO 在三個 multimodal LLM backbones 上都優於 standard GRPO 與另一個近期 RL baseline;在 Qwen3-VL-8B-Instruct 上,更以只用 13K training samples 超過較大的醫療 MLLMs,例如 HuatuoGPT-Vision-34B,分數高出 2.79。

  • 核心方法:以 answer-level reward 加 step-wise process rewards 重整 GRPO-style advantages
  • 主要差異:重點放在 first failure,而不是只看最後有冇答中
  • 已公布內容:完整 reinforcement learning recipe、code、datasets 同 infrastructure
  • 可重現方式:項目提供環境腳本、資料下載與前處理流程,訓練資料包含 image、problem、solution 欄位
  • 相關模型:Qwen3-VL-8B-Instruct、HuatuoGPT-Vision-34B,以及 README 提及的另外兩個 multimodal LLM backbones

量化結果最值得留意的是推理質素分析。MRPO 將 early-stage reasoning failures 由 64.0% 降到 13.0%,反映它不只是把答案分數推高,而是令中途推理較少一開始就偏離;這對醫療影像問答尤其重要,因為錯誤往往不是出在最後一句,而是前面觀察與判斷已經失焦。

這個項目較適合研究醫療 AI、醫療影像問答、multimodal reasoning post-training 的團隊參考,也適合想比較 RL 訓練配方差異的人閱讀與重現。它現階段更接近研究原型與訓練方法展示,不是即裝即用的臨床產品;重點價值在於,它把「模型哪一步開始諗錯」正式納入訓練訊號,為醫療 MLLMs 提供一條比只看最終答案更細緻的優化方向。
項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, OpenAI, DeepSeek, Image, 框架, Medical醫學

TAP:先學動作,再學指令的 VLA 路線

這是一個針對 Vision-Language-Action 模型訓練瓶頸提出的新框架。它用較少專家示範,換取接近大型資料訓練的操作能力。

TAP Framework Overview

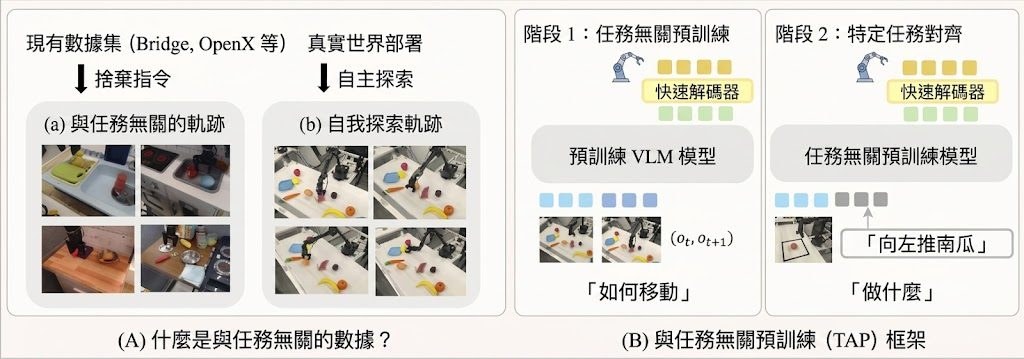
TAP(Task-Agnostic-Pretrain) 是一個 Vision-Language-Action(VLA)模型訓練框架,屬於研究原型兼訓練方法。它要處理的核心問題,是 VLA 長期依賴大量 expert demonstrations,導致機械操作能力難以用較低成本擴展。

現有做法多數直接把「how to move」與「what to do」一齊學,通常需要 observation、instruction、action 這類完整示範資料;作者認為這種固定範式混淆了 physical competence 與 semantic alignment 兩個目標,結果是語言標註被過度用喺本來可以自我監督學習的動作能力上。Task-Agnostic Pretraining(TAP)因此改成兩階段:先用無標註互動資料透過 self-supervised Inverse Dynamics 學 transferable motor priors,再用少量 expert demonstrations 做 task-specific alignment。

這種取向同標準 behavior cloning、以大量網路或專家軌跡堆出來的 VLA 路線唔同。TAP 的取捨很明確:它未必追求一次過把語義和動作全學齊,而是先把可遷移的「點樣郁」拆出來,換來更低標註成本,同時提高對背景、視角變化的穩定度;代價是整個方法仍然要靠第二階段示範去把語言指令對齊到具體任務。

項目已經交代了測試方式:這不是即裝即用應用程式,而是要跟住論文設定,載入 HuggingFace 提供的模型,重現兩階段訓練,再用 SIMPLER benchmark 與真實 WidowX-250s 場景驗證。數字上,TAP-20k 在 SIMPLER 的 Avg-All 為 33.32%,高過 Standard BC 的 23.15%;真實環境中只用 200 個 expert demos,面對 background texture shift 仍有 45% success,viewpoint variation 亦有 20%,而部分 baseline 會跌到 0%。

  • 用 self-supervised Inverse Dynamics 先學動作先驗,減少對語言標註依賴
  • 以約 30 小時 autonomous play 加少量 expert demonstrations,對比 1M+ expert trajectories 路線更慳資料
  • 在 SIMPLER benchmark 勝過 Standard BC,接近或超過部分現有 VLA 模型
  • 對 visual distractors、background texture shift、viewpoint variation 的抗干擾能力較強
  • 相關模型包括 RT-1-X、OpenVLA、Nora、Octo,以及 README 提到的 TAP-20k

項目較適合做 Embodied AI、robot learning、VLA 訓練流程研究的團隊參考,尤其係想用學術規模算力驗證新訓練路線的人。它現階段更像一套值得跟進的方法論,而唔係面向一般用戶的完成品工具。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, 教學, Clone, Dataset 數據集

Higgs TTS 3:4B 多語語音生成模型

這是一個主打對話語音生成的 4B TTS 模型,支援 100+ 語言與 zero-shot voice cloning。並提供清楚架構與限制,但未見 GGUF 量化檔。

Og image

這是一個文字轉語音模型 Higgs TTS 3 4B;暫沒有標明它是基於哪個 base model 微調而成。它主要用來把模型回應轉成更接近對話風格的語音,而不只是朗讀文字,並支援 zero-shot voice cloning、情緒、語氣、停頓同 sound effects 控制。

模型核心是約 4B 參數的 autoregressive decoder,規格包括 36 layers、hidden size 2560,以及 GQA 32/8。音訊端先由 Higgs Tokenizer 編碼成 8 個 codebooks、25 fps 的 audio tokens,再透過 delay pattern、multi-codebook fused embedding 同 multi-codebook fused head 處理,最後還原成 24 kHz waveform;這種設計重點在於同時建模文字與音訊 token,讓語音表達更連續。

訓練序列長度為 8,192 tokens,對長句、多輪語音回應會有幫助。語言覆蓋超過 100 種,並提到 102 種語言做到單位數 WER/CER,其中 85 種達到低於 5 的水準,代表它不只追求可讀性,亦重視跨語言穩定度。

  • 定位清楚:偏向 voice chat 與 expressive conversational speech,而非單純 TTS 朗讀器。
  • 控制能力完整:可直接控制 emotion、style、prosody、pauses 與 sound effects。
  • 多語能力強:支援 100+ 語言,102 種語言有公開 WER/CER 描述。
  • 授權限制明確:只開放 research and non-commercial use,商業用途需另取授權。

模型未提供 GGUF 格式、量化級別、檔案大小、mmproj、llama.cpp、Ollama 或 LM Studio 支援資訊,也未見 v2 檔名變更、chat template 注意事項與 MTP draft speculation 相關內容;這些多數屬於 LLM 或多模態推理頁面常見資訊,並非此 TTS 頁面的重點。使用上更值得留意的是授權條款與風險限制,包括未經同意的 voice cloning、冒充、詐騙、選舉誤導與生物識別監控都被禁止。

項目主頁 · 模型

Categories: 開源, 文字轉語音, 模型, Audio, Clone, 語音

ABot-M0 用 600 萬軌跡訓練機械人操作

ABot-M0 是面向機械人操作的 VLA foundation model,結合大型資料與新動作學習方法。它重點解決機械人資料分散、控制不穩定和跨任務泛化問題。

ABot-M0 model overview

這是一個面向機械人操作的 Vision-Language-Action(VLA)foundation model,名為 ABot-M0。它主要用來讓機械人根據視覺與指令完成操作任務,並處理資料分散、動作表示不一致,以及控制模型訓練效率偏低的問題。

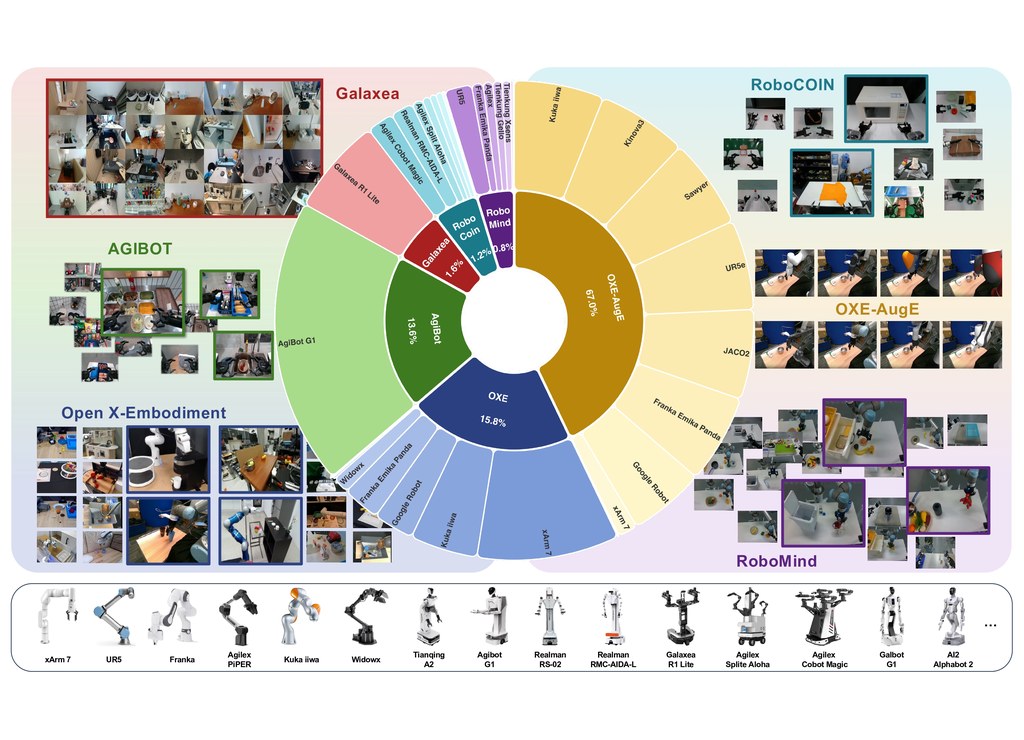
ABot-M0 的基礎來自 UniACT-dataset。這個資料集整合 6 個公開資料來源,包含 OXE、OXE-AugE 與 AgiBot-Beta,合共超過 600 萬條 trajectories、9,500 小時以上互動資料,並覆蓋 20 多種機械人形態;資料亦經過清理、標準化與統一,將動作轉成 end-effector 座標系中的 delta actions,旋轉則採用較穩定的 rotation vector 表示。

它和常見 diffusion 式控制方法的主要差異,在於採用 Action Manifold Learning(AML)。一般 diffusion model 多數學習預測 noise,ABot-M0 則直接做 Direct Action Prediction(a-prediction),輸出乾淨的動作序列;這種做法把學習重點由「擬合噪聲」轉成「投影到可行動作流形」,理論上更有效率,也更有助提升解碼速度與 policy stability。

另一個實用方向是模組化 3D perception。ABot-M0 支援 plug-and-play 模組去加強 3D 空間理解,對涉及精準位置、姿態與複雜操作步驟的任務會更有幫助;同時,它亦用「pad-to-dual」策略統一 single-arm 與 dual-arm 任務,令同一模型可覆蓋更廣的操作場景。

  • 整合超過 600 萬條 trajectories,資料規模相當大
  • 以 UniACT-dataset 統一不同來源與不同機械人表示方式
  • 採用 Action Manifold Learning(AML),直接預測動作而非噪聲
  • 支援 plug-and-play 3D perception 模組,提升複雜任務精度
  • 適合關注 robotic manipulation、VLA 與通用機械人控制的讀者

現有資料重點放在方法設計與資料規模,具體基準分數與完整比較結果在這份內容中未完全展開。即使如此,ABot-M0 已清楚展示一條很具代表性的路線:先用大規模統一資料打底,再用更貼近可行動作結構的學習方式,提升機械人操作模型的泛化與穩定性。

項目主頁

Categories: 開源, 模型, 視覺模型, 多模態模型, VLA, Robotic, 3D, Dataset 數據集

Headroom:幫 AI agent 壓縮上下文

這個項目專注減少 AI agent 的 token 消耗,同時盡量保留答案品質。它適合想降低成本、加快回應的開發團隊。

Headroom in action

Headroom 是一個給 AI agents 與 LLM 應用使用的庫兼代理工具,核心角色是把送進模型前的上下文做壓縮。它主要解決長對話、工具輸出、日誌、RAG 片段與檔案內容太長,令 token 成本、延遲與上下文容量很快爆滿的問題。

這個項目不只提供 Python 與 TypeScript 內嵌式 compress(messages) 用法,亦提供 proxy 模式與 MCP server,代表它可以直接插入現有流程,未必需要大改程式。README 提到 zero code changes 的代理方式,對已有多語言系統的團隊尤其實用;另外它走 local-first 與 reversible 路線,取向明顯是先保留可控性,再追求節省 token。

和一般只縮短輸入文字的做法相比,Headroom 的差異在於它同時處理模型輸出,會減少重複客套、重述程式碼,以及在例行步驟略過過深的「thinking」。這種取捨有助壓低來回 token,但也代表較依賴它對內容重要性的判斷;對需要完整推理痕跡或逐字保留輸出的流程,部署前應先做回歸測試。

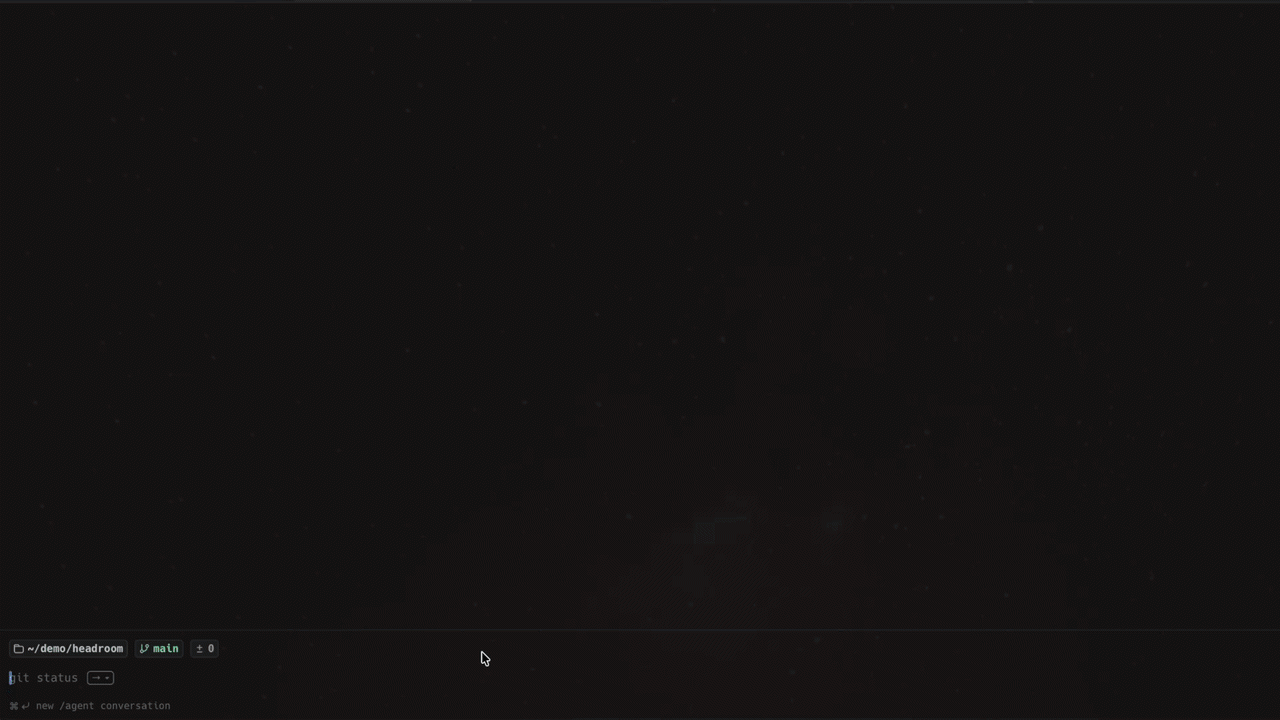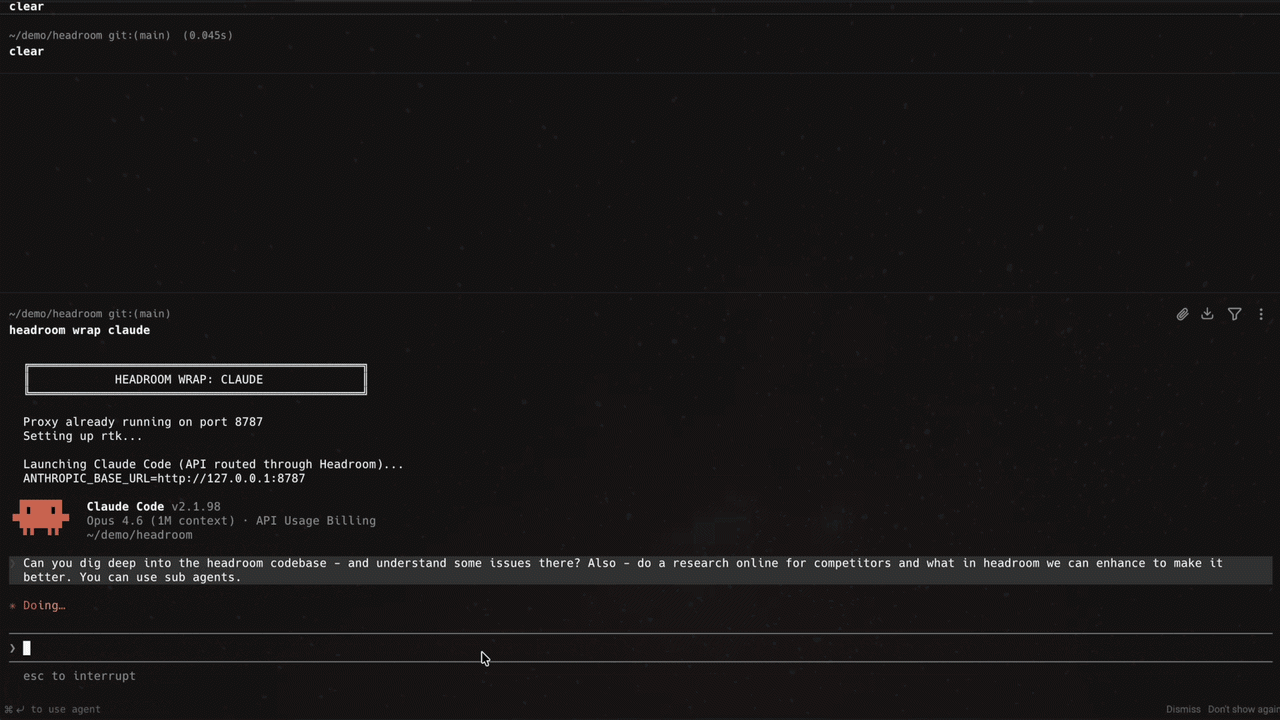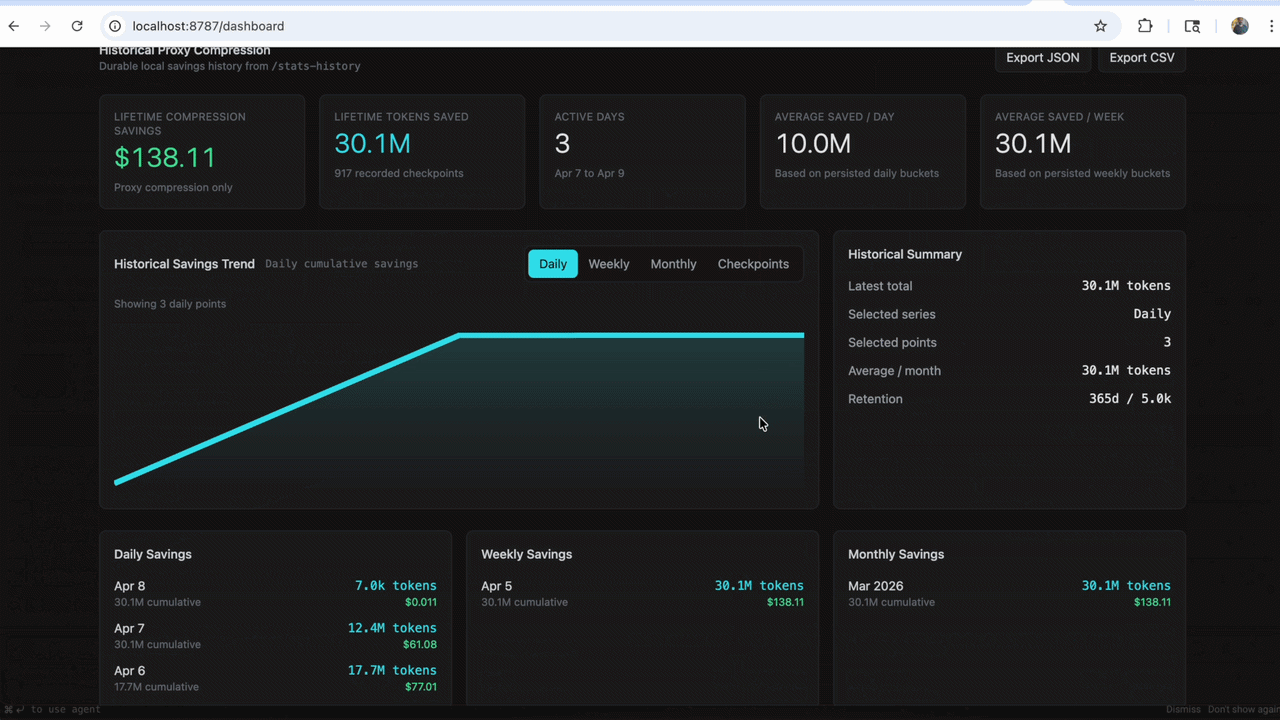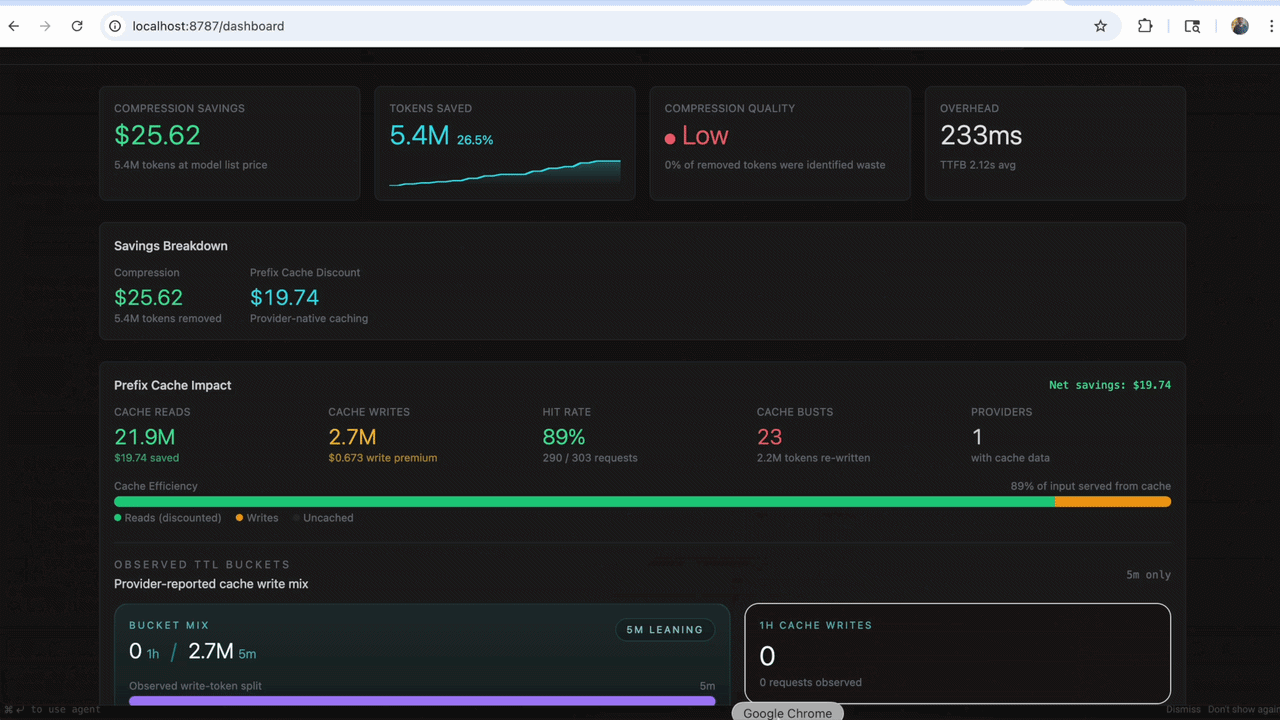
結果列出的數字是 60–95% fewer tokens,示例亦有 10,144 壓到 1,260 tokens,同時保留相同問題結論;不過這些結果較適合視為官方展示,具體效果仍會受任務類型影響。較容易受益的情境包括多步驟 agent、跨工具調用、RAG 對話系統,以及 Claude、Codex、Gemini 之間需要共享記憶的團隊協作流程。

  • 支援 Library、Proxy、MCP server 三種接入方式
  • 可壓縮對話、工具輸出、logs、RAG chunks 與檔案內容
  • 提供 cross-agent memory,支援 Claude、Codex、Gemini 共用與去重
  • headroom learn 會整理失敗 session,寫入 CLAUDE.local.md、CLAUDE.md、AGENTS.md 或 GEMINI.md
  • 相關模型包括 Kompress-v2-base,而整體定位較接近 agent 基礎設施,不是單一聊天模型

整體來看,Headroom 最有價值的地方不在於再做一個包裝 LLM 的介面,而是把「上下文壓縮」獨立成基礎層。對經常被 token 成本、上下文長度與 agent 記憶雜訊拖慢的項目,它屬於值得優先測試的一類工具。

GitHub

Categories: 開源, Agentic, RAG, MCP, 模型, Gemini, Python, , 編程, Anthropic

Qwen-RobotManip 如何把機械臂訓練推向通用化

這是一個面向機械人操作的 Vision-Language-Action 基礎模型。它嘗試用統一對齊與大規模資料訓練,提升跨場景與跨機械平台泛化能力。

Og image

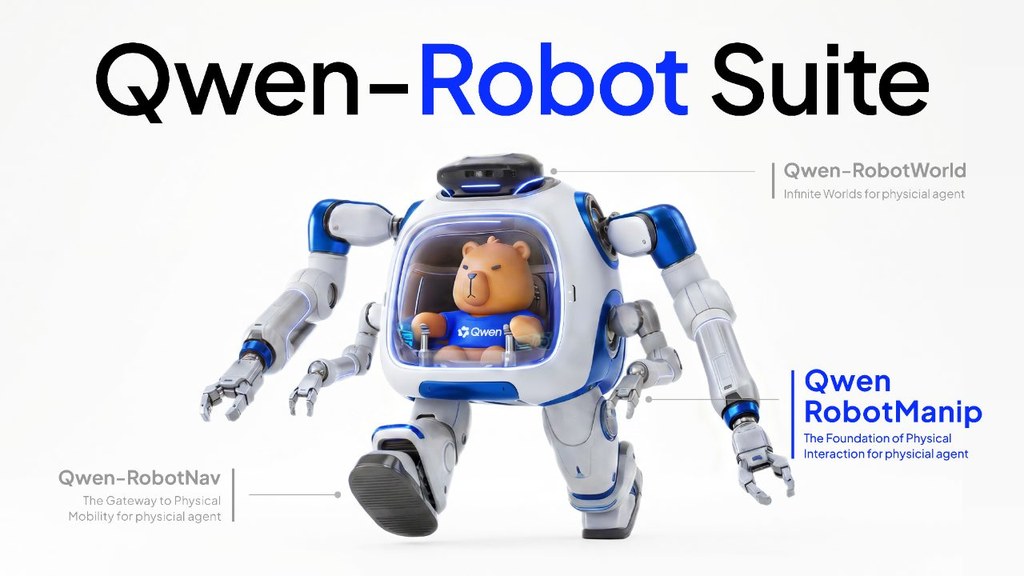
這是一個機械人操作模型,名為 Qwen-RobotManip,屬於建基於 Qwen-VL 的 Vision-Language-Action foundation model。它主要處理機械臂操作資料分散、昂貴而且難以統一訓練的問題,目標是讓模型在未見過的任務、場景與機械平台上仍能保持可用表現。

它的核心做法,是把操作學習中的表徵、動作與行為三個層面放進同一套 alignment framework。研究團隊同時建立 human-to-robot synthesis pipeline,將第一身手部示範影片轉成 15 個平台可用的 robot trajectories,再配合多來源資料整理流程,整合真實機械人、合成資料與人類示範影片,形成約 38,100 小時 pretraining corpus。

和常見只集中單一機械平台、單一資料來源,或偏重分佈內表現的做法相比,Qwen-RobotManip 更著重 genuine generalization。評估上亦沒有停留在一般 benchmark,而是加入多個 OOD 設定,包括 RoboCasa365、LIBERO-Plus、EBench、RoboTwin-Clean2Rand、RoboTwin-IF 與 RoboTwin-XE,用來檢查指令跟隨、擾動穩健性、錯誤恢復,以及 cross-embodiment knowledge transfer。

重點可整理為:
– 建基於 Qwen-VL,面向 robotic manipulation 的通用基礎模型
– 以 unified alignment framework 整合 heterogeneous manipulation data
– 使用 human-to-robot synthesis pipeline,覆蓋 15 個機械平台
– 只依靠 open-source robotic manipulation datasets 與 human demonstration videos,未提及私有資料收集
– 在多個 OOD 評測中優於過往 state-of-the-art models,包括 π0.5,並在 RoboChallenge 排名第一

這個項目較適合關注 robotic manipulation、VLA、跨機械平台遷移與機械人資料擴展流程的人閱讀。現有資料顯示,它不單是再加大訓練規模,而是先解決資料對齊問題,令擴充規模之後的訓練信號不會互相衝突,這也是它能在真實機械平台驗證泛化能力的關鍵。

項目主頁 · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, VLA, Robotic, 框架

ConvFill:即時語音代理的雙模型方案

ConvFill 用本地小模型先開口,再由雲端大模型補上答案。它想解決語音代理常見的「快但唔夠準,準但唔夠快」拉扯。

Teaser

ConvFill 是一個用來建立語音代理的開源系統與研究原型。能夠實現即時回應和準確回答——這兩個目標通常難以兼顧。它將本地運行的小型快速語言模型與在後台進行繁重推理的大型雲端模型相結合,使代理能夠立即開始對話,並在資訊可用時自動填充合理的答案。此程式碼庫包含完整的系統、一個即時語音演示、七個即用型模型以及訓練您自己的模型所需的一切資源。

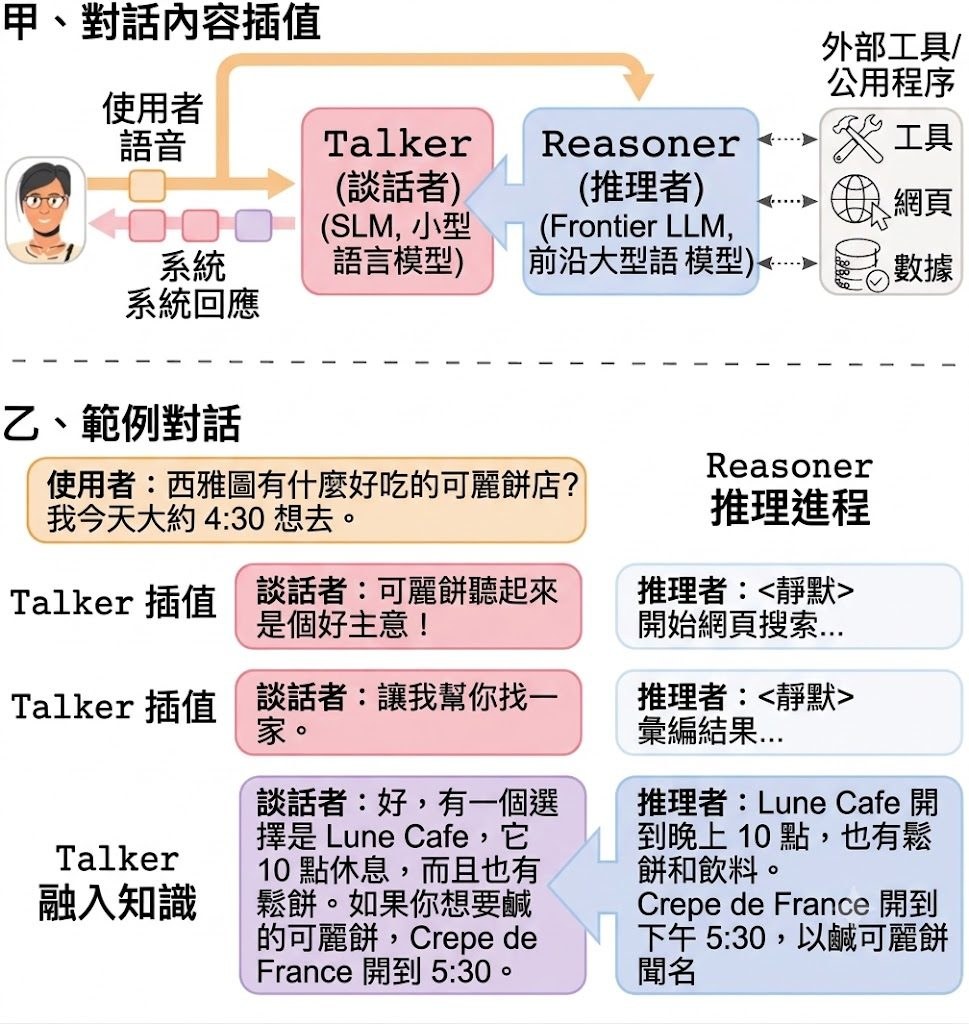
現有做法通常要麼直接等大型模型完整生成,回應較慢;要麼改用較小模型追求低延遲,但複雜查詢、文件搜尋同工具調用能力會明顯下降。ConvFill 提出 conversational infill 這個新任務,將 Talker 與 Reasoner 分工:Talker 先即時說話,Reasoner 在背景處理慢工序,再把精簡知識流式交回 Talker 融入回答。

ConvFill 不是單純做語音介面,而是重新安排推理時序。Talker 可用 135M 到 1.7B 參數的小模型,在手提電腦或手機本地運行;Reasoner 則可接 Claude、GPT 或 Gemini。儲存庫已提供 live voice demo、七個現成模型,以及訓練自家 Talker 所需內容,理解上可視為「本地即時對話層 + 雲端能力層」的組合。

  • 內置七個已微調 Talker,涵蓋 Qwen、Llama、Gemma、SmolLM 家族
  • 配套 ConvFill dataset,含 290,571 個經驗證訓練樣本,覆蓋六個領域
  • Reasoner 可替換為 Claude、OpenAI 或 Gemini,毋須為更換 Reasoner 重新訓練
  • 論文指出系統可維持 millisecond-level time-to-first-response,準確度與對應 frontier Reasoner 的差距縮至 6.3% 內

受益最明顯的,會是想做客服、助理、查詢式語音介面或需要邊說邊找資料的團隊。它未必適合完全離線、又要求深度推理的場景,因為關鍵能力仍依賴雲端 Reasoner;但對希望保留本地回應速度,同時接入大模型能力的項目,這套設計比單模型方案更有工程上的彈性。

GitHub · Paper

Categories: 開源, 模型, Qwen, OpenAI, Gemini, LLaMa, 語音, Anthropic, 蘋果, Dataset 數據集

PhysisForcing 提升機械人世界模擬可靠性

這是一個強化影片生成物理一致性的訓練框架,用來改善機械人操作模擬的可信度。

Teaser Figure

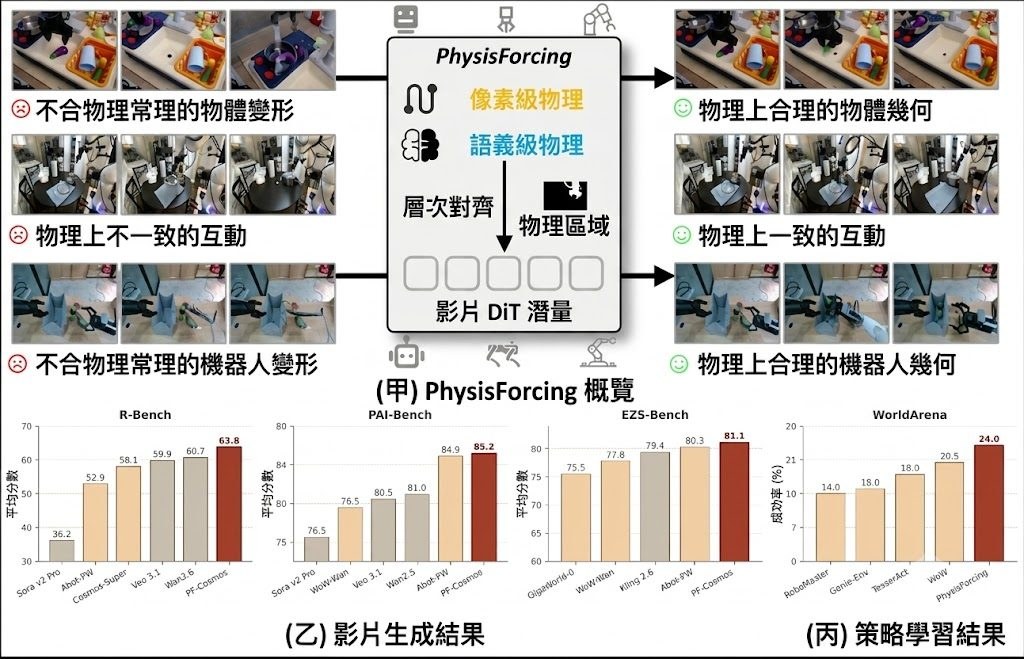
這是一個用於機械人操作的世界模擬訓練框架,名為 PhysisForcing。它主要解決影片生成模型在模擬抓取、推動與物件互動時,常出現動作軌跡不連續、物件變形和互動不合物理規律的問題。

PhysisForcing 的做法不是單靠生成更像真的畫面,而是把訓練重點放在與物理相關的區域,並同時加入像素層與語意層兩種約束。像素層的 trajectory alignment loss 會用參考點軌跡監督 DiT features,語意層的 relational alignment loss 則利用凍結的影片理解編碼器,對齊區域之間的互動關係,令機械臂與物件之間的時空關聯更穩定。

和一般通用影片生成模型,或只針對機械人資料做微調的方法相比,這個框架更集中處理「物理合理性」而非單純畫面觀感。它可套用在標準 diffusion video backbones 之上,已展示於 Wan2.2-I2V-A14B 與 Cosmos3-Nano 這兩個基礎模型。

  • 核心重點是分層物理對齊:同時改善運動一致性與互動關係一致性
  • 適合用於 embodied world simulation、robotic manipulation 與下游動作規劃
  • 在 R-Bench、PAI-Bench、EZS-Bench 都較強基線有提升
  • R-Bench 上,Wan2.2-I2V-A14B 提升 +22.3%,Cosmos3-Nano 提升 +9.2%
  • 納入 WorldArena action-planner protocol 後,closed-loop success rate 由 16.0% 升至 24.0%

這項工作對需要用影片模型做機械人訓練、模擬驗證或策略學習的人較有參考價值,因為它不只改善生成片段的外觀,亦提升作為 world model 的可用性。現有資料顯示,物理對齊後的影片表徵亦能帶動下游 policy success,說明這類方法不只是視覺修飾,而是直接影響機械人操作結果。

項目主頁 · Paper

Categories: 開源, 北京大學, 模型, 視頻模型, 世界模型, 模型訓練, NVIDIA, Video, Robotic, 框架

EO-WM:把衛星影像預報變成天氣驅動的世界模型

EO-WM 以物理引導的潛在影片擴散架構預測未來衛星觀測,並針對極端天氣下植被退化與天氣響應準確度提出全新基準。

EO-WM overview

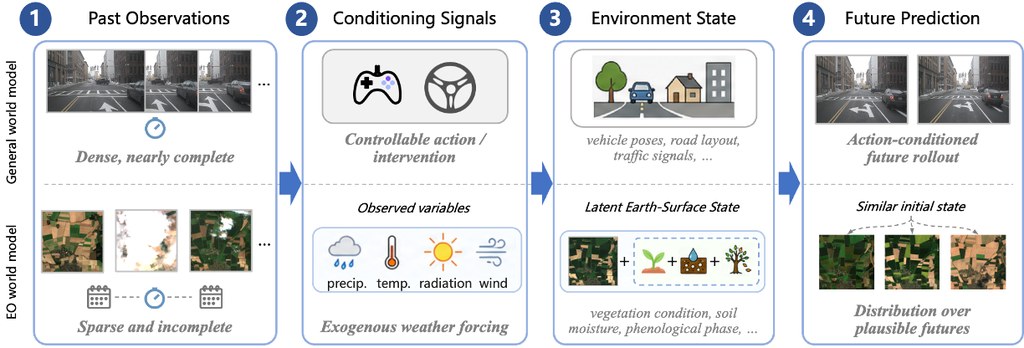
這是一個結合物理知識的影片擴散世界模型(EO-WM),專門用於多光譜衛星影像的概率預測。整體目標是把地球觀測(Earth Observation, EO)預報重新定位為「部分可觀察、天氣驅動的世界建模」任務,在稀疏衛星上下文與未來氣象條件下預測地表動態,並支援災害監測、作物產量預估及植被變化追蹤等下游應用。

過去的 EO 預測方法分為兩類:決定式模型把不確定性壓縮成單一未來影像,擴散式方法則往往把天氣變量當成籠統的條件輸入。這兩種做法都難以正確反映「氣象條件如何改變地表狀態」這個核心問題,而且現有 benchmark 多聚焦於像素重建準確度,未能衡量模型在改變天氣條件時是否會產生方向正確的響應。EO-WM 為了解決這個落差,引入一個 EO 專屬 VAE 把稀疏衛星觀測編碼為潛在影片 token,再用擴散 Transformer(diffusion transformer)經由獨立條件路徑同時處理三種信號:氣候基線(climatological baseline)、天氣異常(weather anomaly)與累積物理壓力(cumulative stress),並持續將空間上下文重新注入影片 token 流。

在評測方面,作者提出兩個以 EarthNet2021 為基礎的診斷式 benchmark:Extreme Summer Benchmark 衡量極端熱浪與乾旱下植被退化的嚴重程度感知能力,引入 TN-MAE 與 Drop Amplitude Error;Seasonal Matched-Pair Benchmark 則衡量當天氣條件改變時預測方向與幅度是否正確,以 Divergence Reproduction Ratio、Directional Hit Rate 與 Paired Divergence Correlation 為指標。報告結果顯示 NDVI 下降幅度的預測誤差相對減少 5.63%,方向命中率相對提升 7.80%,同時在像素級 ENS、P-MAE、N-MAE 等指標上仍具競爭力。

這個項目對遙感研究者、農業監測團隊及氣候風險分析團隊特別有價值,因為它同時提供模型與基準資料,讓外界可在統一的評測框架下比較不同方法的天氣響應能力。從工程角度來看,架構設計強調物理分離條件與空間重注入,而非單純堆疊參數,這種取捨有助於提高極端情境下的可解釋性。需留意的是,目前 GitHub 倉庫主要釋出 benchmark CSV 與 Earthformer 參考評測腳本,模型權重與完整訓練流程屬於配套資源,重現完整結果仍需自行準備 EarthNet2021 的 extreme 與 seasonal 切分資料。

重點摘要:

  • 重新定義 EO 預報範式:把衛星影像預測視為天氣驅動的世界建模,而非純粹的影像重建。
  • 物理分離條件:天氣信號被拆分為基線、異常與累積壓力三條獨立條件路徑。
  • 診斷式 benchmark:Extreme Summer 與 Seasonal Matched-Pair 兩個基準專門檢驗模型在天氣改變下的響應正確性。
  • 可量化的天氣敏感度:NDVI 下降誤差降低 5.63%,方向命中率提升 7.80%,標準指標仍具競爭力。
  • 目前釋出內容:以 benchmark CSV 與評測腳本為主,完整訓練流程需搭配 EarthNet2021 資料集。

GitHub · Paper

Categories: 開源, 香港大學, 香港理工大學, 模型, 世界模型, Stable Diffusion, 框架, 香港, , 深度學習

LISA:讓 ControlNet 訓練快 2.78 倍的正則化方法

香港科技大學團隊提出的 LISA 正則化技術,能在不增加推理成本的前提下,加速視覺條件可控生成模型的訓練並提升生成品質。

Arxiv

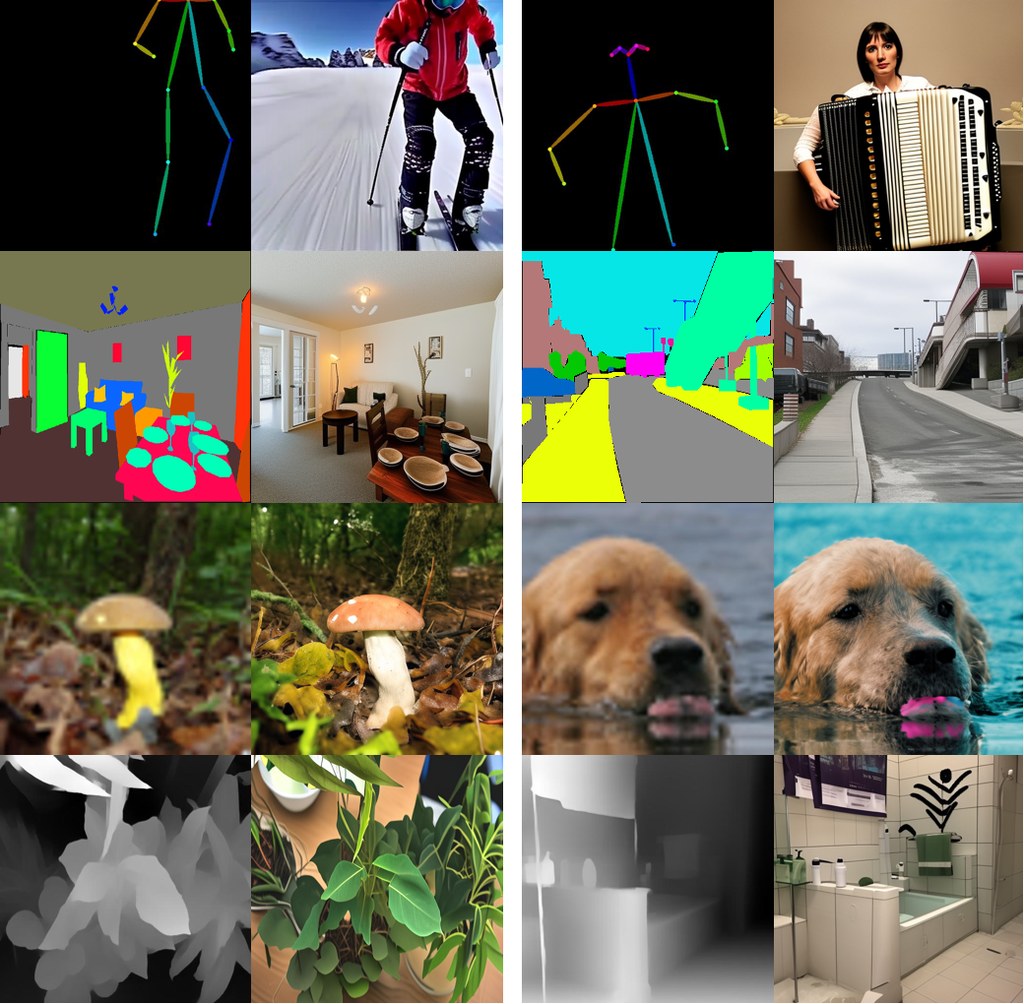
LISA(Likelihood Score Alignment)是一種訓練正則化方法,專門用於加速視覺條件可控生成模型(例如 ControlNet)的訓練過程,同時提升最終生成結果在感知品質與條件遵循度上的表現。

現有做法普遍採用「雙分支範式」(dual-branch paradigm):訓練一個側網絡(side network)來編碼視覺條件,再將其中間層特徵融合到凍結的預訓練主網絡中。這個範式雖然效果顯著,但側分支的角色定位與訓練效率長期未被深入研究。LISA 從基於分數的生成建模(score-based generative modeling)角度重新審視這個範式:主網絡負責提供先驗的無條件分數(unconditional score),側網絡則透過隱式方式貢獻似然分數(likelihood score)。

LISA 的核心做法是從側網絡的指定層提取特徵,透過一個輕量級解碼器(decoder)將其投影到分數潛在空間(score latent space),然後計算解碼器輸出與近似似然分數目標之間的距離,作為額外的正則化損失(regularization loss)。這個設計讓側網絡的特徵在條件建模中更加解耦(disentangled),且推理階段無需任何額外計算。

根據論文實驗結果,LISA 在多種圖像與影片任務、不同網絡架構(UNet/DiT)以及擴散與流匹配模型上均表現穩定,能夠實現超過 2.78 倍的訓練收斂加速(例如在 ControlNet 上),同時帶來可忽略的額外訓練成本與零推理成本。

這項技術特別適合需要快速迭代 ControlNet 或類似條件控制模型的團隊,例如從事姿態引導圖像生成、組合條件生成或可控影片生成的研究人員與開發者。

重點摘要:

  • 方法類型:訓練正則化技術,適用於雙分支視覺條件可控生成框架
  • 核心創新:將側網絡特徵對齊近似似然分數目標,取代純粹依賴擴散損失的訓練方式
  • 訓練效率:在 ControlNet 等場景實現超過 2.78 倍的收斂加速
  • 推理成本:零額外推理開銷,解碼器僅在訓練階段使用
  • 適用範圍:圖像與影片生成任務,兼容 UNet 與 DiT 架構,支援擴散與流匹配模型

GitHub · Paper

Categories: 開源, 香港科技大學, 華為, 模型, 視覺模型, 模型訓練, 框架, 香港, IDE, 深度學習

Page 14 of 37
1 12 13 14 15 16 37