Canvas360 把全景生成拉回可用水平

全景圖最易穿崩嘅位置,往往唔係畫質,而係左右接縫同空間感。Canvas360 針對呢個痛點落手,想令文字生成同後續修補都更連貫。

teaser

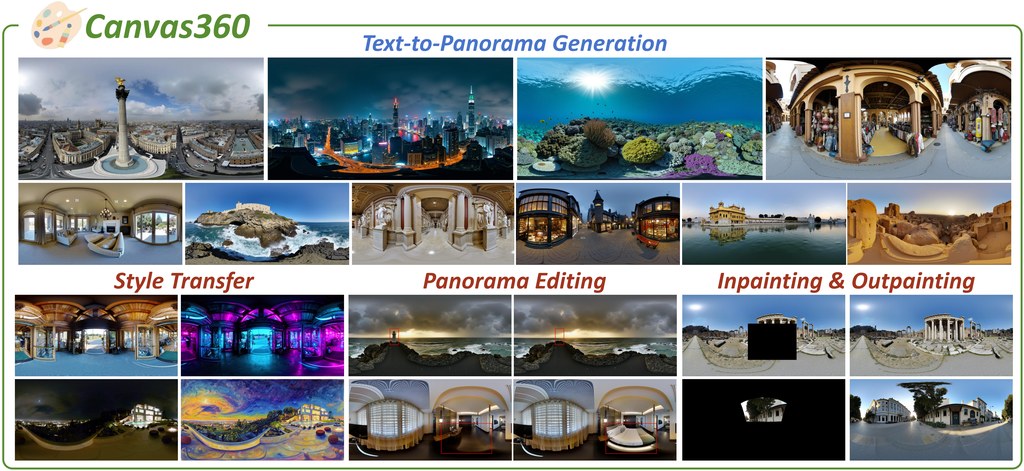
最值得留意嘅地方,在於佢唔只想生成一張闊圖,而係想處理 360 度全景最常見嘅破綻:左右邊界接唔上、透視變形唔自然、補圖後空間結構散開。Canvas360 屬於影像生成框架,建基於 FLUX,處理嘅係 text-to-panorama image generation,同時延伸到 inpainting、outpainting、editing 同 style transfer 呢類全景工作流。

現有做法多數先把全景當成一般平面圖片生成,再靠後處理減少接縫;作者認為呢種範式忽略咗 panoramic projection 本身嘅幾何特性,所以容易喺邊界、深度關係同局部結構出現錯位。Canvas360 用 two-stage framework 重組呢件事:先做 geometry-aware pretraining,引入 parallel RGB-depth pretraining,再配合 continuous position encoding、circular latent padding 同 per-block feature synchronization,將 360 度連續性直接放入模型學習過程。

同類項目相比,Canvas360 嘅取向唔係單純追求更華麗嘅畫面,而係優先修正全景生成最影響可用性嘅一致性問題。項目亦補上 Canvas360Dataset,提供 1M paired panoramic samples,支援 style transfer、inpainting、outpainting 同 editing,反映作者唔止做單一模型改良,仲想連訓練資料結構一併補強。

  • 核心定位係 FLUX-based framework,主打 text-to-panorama image generation 同全景補全
  • 關鍵方法包括 geometry-aware pretraining、continuous position encoding、circular latent padding
  • 已公開 inference code 同 training code,但 model weights 與 online demo 仍然未釋出
  • 需要 base model black-forest-labs/FLUX.1-dev,並可配合自備 LoRA 跑生成或下游任務
  • 相關比較對象包括 PanFusion、SMGD、PAR、WorldGen、HunyuanWorld、DiT360,以及 FLUX.1-Kontext-dev、FLUX.2-dev、Qwen-Image-Edit

測試同現階段較接近研究型項目而唔係即開即用服務。儲存庫已提供 inference.py 同 inference_downstream.py,代表你可以在本地環境配好 PyTorch、依賴套件、FLUX.1-dev 存取權同 LoRA 後,直接驗證文字生成全景,或者試全景補圖與延展;不過權重未公開,所以現時更適合研究團隊、全景影像工具開發者,或者想研究 360 度生成方法嘅人先行閱讀同跟進。現有介紹強調結果比多個舊方法更少接縫瑕疵、結構更清晰,但儲存庫內容未見完整量化指標表,判斷性能仍要等論文與權重進一步公開後先更穩陣。
項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 模型, 視覺模型, 模型訓練, Stable Diffusion, Image, 影像模型, 框架, Python, Dataset 數據集

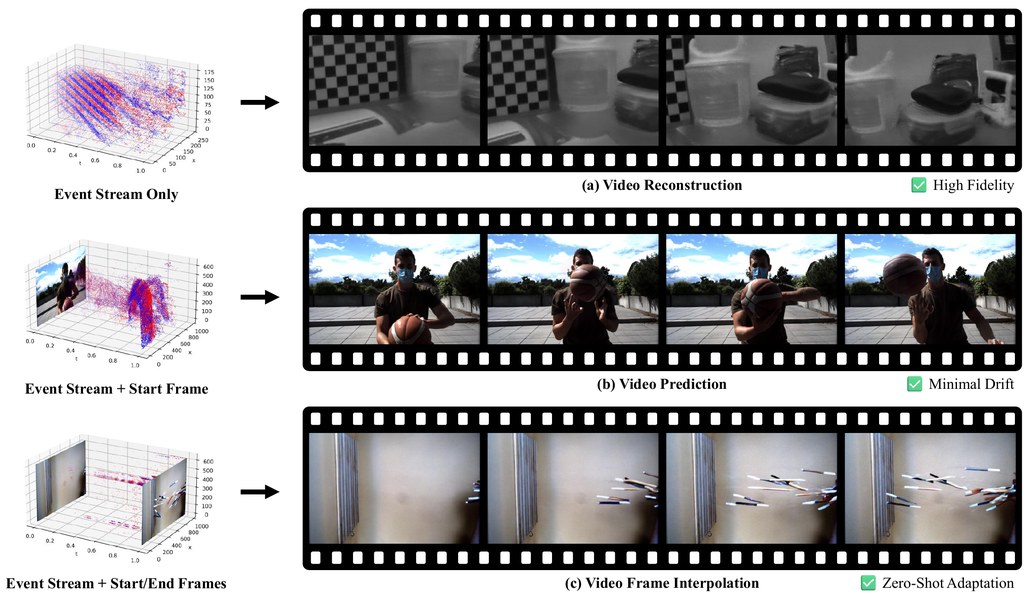
LongE2V 把事件流變成穩定長影片

LongE2V 針對事件相機最難處理的長時序穩定度落手,想同時做好重建、預測與補幀。你可以把它理解成一套用 video diffusion model 補回連續畫面的研究型框架。

Logo

事件相機資料本身又稀疏又碎,畫面一拉長,很多方法不是紋理發糊,就是前後段落開始飄。LongE2V 走的是研究型模型/框架路線,目標不是只修一段短片,而是把 sparse event streams 轉成較穩定的長影片,並且同時處理 reconstruction、prediction 同 frame interpolation。

同類做法常見兩條路:一類用 regression methods,速度直接但容易損失細節;另一類雖然有 generative models 的畫質優勢,長序列又容易出現 temporal drift。LongE2V 把 pre-trained video diffusion priors 拉進 event-based video 任務,再加上 Autoregressive Unrolling、Adaptive Context Switching,以及插幀用的 Reencoding Alignment with Cross Residual Correction,核心取向很清楚:接受系統更複雜,換取較長時間的一致性同感知品質。

部署環境以 Python 3.10 為基礎,Linux 加 NVIDIA GPU,同時依賴整理好嘅資料結構;訓練要每段 sequence 準備 images/.png、voxels/.npz 同 cogvlm_prompts.txt,推理前亦要確保 voxel 檔名、數量同資料夾完全對齊,因為多一個或少一個 voxel 檔,都會改變事件切塊方式,直接影響訓練同推理結果。

重點整理如下:
– 同一套框架覆蓋 reconstruction、prediction、frame interpolation,減少每個任務各自維護一套模型的割裂情況
– reconstruction / prediction 以 ECD、MVSEC、HQF 為主,interpolation 用 BS-ERGB 同 HQF
– 空事件區間會寫入 zero voxels,避免時序長度對不上
--reverse-time --reverse-polarity 產生的 voxels_reverse 只供 interpolation 測試使用,唔需要帶入 reconstruction、prediction 或訓練
– 在 real-world benchmarks 上優於多個 state-of-the-art 方法,並強調 temporal coherence 同 zero-shot generalization

相關模型包括 E2VID、FireNet、ET-Net、SPADE-E2VID、SSL-E2VID、HyperE2VID、VDM-EVFI、CBMNet-Large 同 TLXNet+。LongE2V 較適合做事件相機、視覺生成、機械感知或學術重現的團隊參考;它吸引之處在於把三類任務收進同一個 video diffusion framework,但代價是資料前處理要求嚴格、硬件門檻偏高,整體更像面向研究與實驗室工作流。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, NVIDIA, Video, 框架, Linux, Python

TESSERA 把全年衛星影像壓成地表嵌入圖

想用衛星資料做分類或預測,最麻煩往往不是模型,而是前處理。TESSERA把一整年 Sentinel-1 與 Sentinel-2 壓成每像素 embedding,先替下游分析省走一大截工夫。

banner

做地表分類、樹冠高度預測,或者想先整理一塊區域的衛星時序資料,卡位通常出在雲遮、感測器差異同時間序整理。TESSERA 屬於地球觀測 foundation model,核心做法係把一年份 Sentinel-1 同 Sentinel-2 觀測壓成 10m 解析度、逐像素的 representation(embedding)map,讓後續任務直接食用較穩定的特徵,而唔使每次由原始影像重新清洗。

TESSERA 同常見只做 cloud-free composite 或單時點特徵抽取唔同。作者明顯想保留 temporal-spectral 訊息,將不規則觀測、光學與雷達資料一齊編碼,所以它較像先建好一層通用地表表示,再交畀分類、回歸或視覺化項目使用;代價係流程唔算輕量,現階段亦仍然係 alpha,對外存取有限。

部署流程分成資料預處理、推理、再把輸出的分塊結果拼回最終 representation map;輸入會包括 ROI 的 TIFF、Sentinel-1/2 的起止日期,而且目前 downsample rate 只支援 1,即維持 10m 解析度。README 亦提到要先看完整教學,並涉及 Docker 與一定硬件需求,較適合有遙感或資料工程能力的團隊測試。

  • 把全年 Sentinel-1 與 Sentinel-2 壓成逐像素 embedding,而唔係只輸出單次影像結果
  • 適合接駁土地分類、樹冠高度預測、表示視覺化等下游任務
  • 目前偏研究與內部測試階段,外部使用門檻仍然存在
  • 10m resolution、TIFF 輸入、按時間範圍抽取資料,工作流相對完整但較重

相關模型 TESSERA 前身為 BTFM;延伸資料亦顯示 TESSERA v2 研究緊 pixel-wise EO foundation models 點樣擴展,並包含 0.5B、1B,以及訓練中的 2B 模型,再蒸餾成較細的 student。當中 21M 參數的 distilled 版本主打 embeddings-as-data 部署,仲提供 MATRYOSHKA representations,16 維前綴已可保留大部分 128 維表現。對想長期經營遙感特徵底座的團隊,呢個方向比逐任務重訓更有吸引力。

項目主頁 · GitHub · Paper

Categories: 開源, Embedding, 模型, NVIDIA, Dataset 數據集

CrossViewTokenFusion:乳房 X 光雙視角分類新路線

同一個病灶在兩張乳房 X 光角度入面,線索未必一致。CrossViewTokenFusion 想處理的,正正是點樣保留兩個視角各自訊息,再逐層交換關鍵證據。

Repository image for PartAI-Projects/CrossViewTokenFusion

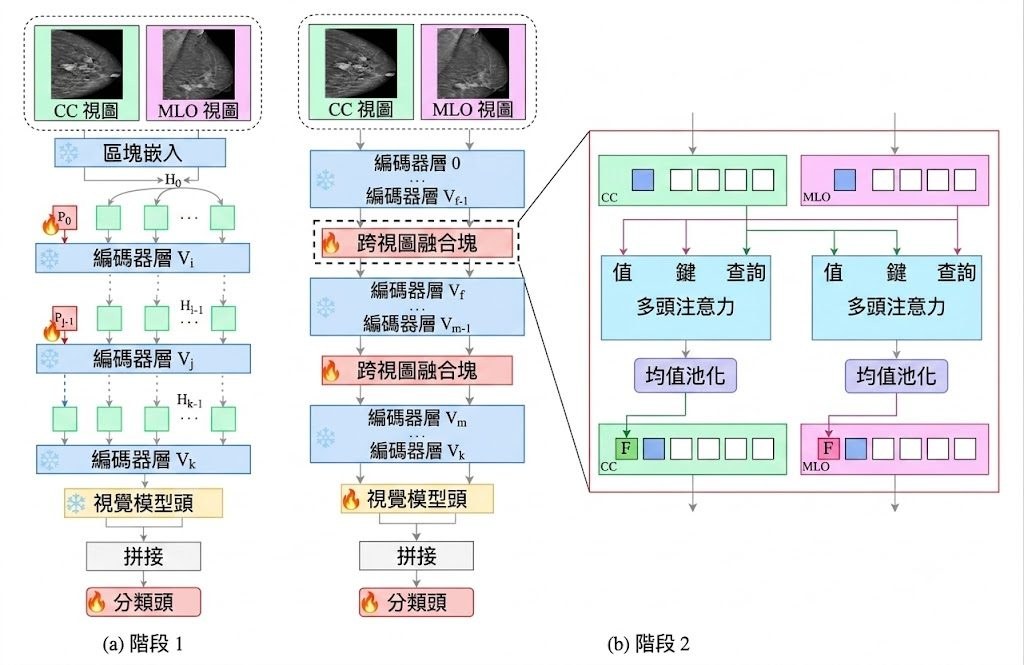
臨床判讀乳房 X 光唔會只望單一角度,但不少多視角方法仍然偏向把特徵提早合併,或者只做一次 cross-attention,結果容易把 view-specific 線索同共享資訊混埋。CrossViewTokenFusion 屬於醫學影像分類模型/研究原型,針對 dual-view mammography classification,重點係讓 CC 與 MLO 兩個視角以 token 為單位逐步交換資訊,而唔係一開始就粗略融合。

項目建基於 frozen MedSigLIP vision model,採用兩階段流程:先做 deep prompt learning 適配,再做 cross-view token-based fusion。作者批評既有 multi-view learning 常見的 feature-level aggregation 同 single-stage cross-attention 互動太淺,於是改用 dedicated fusion tokens 作為中介,透過 cross-attention 在多個 transformer 深度反覆傳遞雙向訊息,之後再把 fusion tokens 放回 token sequence 繼續細化。

部署要求先準備 VinDr-Mammo 或 CMMD(Chinese Mammography Database),再做 preprocessing、stage 1 訓練、stage 2 訓練,最後載入 checkpoint 測試。

它比較適合做醫學影像研究、醫療 AI 團隊驗證多視角融合設計,未見到直接面向臨床系統的封裝介面。

  • 舊範式多數用 feature-level aggregation 或單層 fusion;這個項目改為 multi-depth token 互動
  • 以 frozen vision transformer backbone 配合 prompt learning,取向係少改主幹、多做適配
  • 公開資料集包括 VinDr-Mammo 同 CMMD,方便學術重現與橫向比較
  • VinDr-Mammo BI-RADS classification 達到 50.40% F1-score、0.8090 AUC
  • 相比 dual-view fusion baseline,二分類設定下 AUC 提升 0.10

它的價值係重新定義雙視角點樣溝通:保留各自結構,再用 fusion tokens 逐層傳遞互補證據。

GitHub · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Medical醫學

SciReasoner 想把科學推理拉回結構本身

做蛋白質、分子同材料推理,只靠文字序列往往唔夠。SciReasoner把3D結構直接變成可推理證據,重點是答案背後的科學線索都盡量保留。

SciReasoner architecture overview

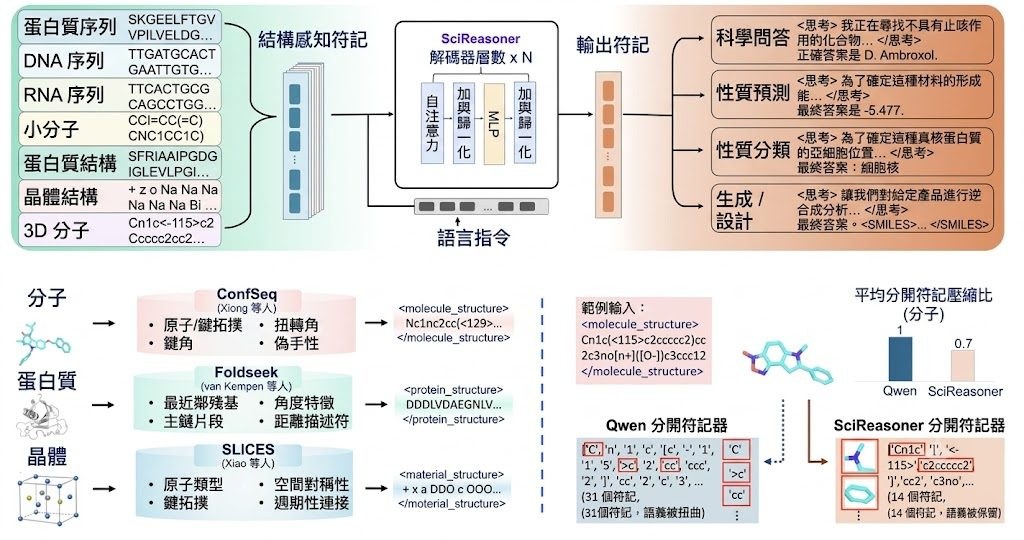
只看文字去判斷蛋白質功能、分子反應性或材料性質,經常會漏掉真正關鍵的空間結構。SciReasoner屬於多模態 scientific foundation model,針對的正是這個落差:把 protein structures、3D molecules、crystals、sequences、formulas 同 text 轉成可對照的 structure-aware evidence tokens,再用來做 scientific QA、prediction、classification 同 generation/design。

與科學資料先「文字化」再交畀大型語言模型處理的做法不同。作者明確押注 native structural reasoning,保留 Foldseek 3Di、ConfSeq、SLICES 呢類結構編碼,令模型唔係淨係讀描述,而係可以沿住 residues、fragments、conformers 甚至晶體配位環境去推理;官網展示的 traces 亦反映出,項目希望連推理路徑都可以檢查,而唔只係輸出答案。

GitHub 上的 models 同 demo 仍標示為 coming soon。換句話說,眼前較合理的理解方式係先把它當成研究型項目:閱讀 benchmark、看案例 traces,判斷它是否適合生物資訊、化學資訊或材料 AI 團隊之後的評測與整合方向,而唔係即刻下載部署到生產流程。

  • 在 86 個評測任務入面,67 個做到 state-of-the-art,對比 generalist LLM baselines 有 75 個任務表現最好
  • 與已發表的 specialist 方法相比,在 33 組比較入面有 26 組持平或更好
  • 範圍唔只化學,亦覆蓋 proteins、DNA/RNA、small molecules、3D molecular structures 同 inorganic crystals
  • traces 可檢查,雙盲專家評分中,與 DeepSeek-V4-Pro 相比有 98% 判斷屬 preferred 或 comparable

相關模型方面,SciReasoner以 Qwen3-14B 初始化,再對齊 domain-native structural vocabularies。對需要跨蛋白質、核酸、分子同材料做統一推理介面的團隊,呢個方向幾有吸引力;限制同樣明顯,因為公開模型與可直接測試的 demo 尚未提供,現階段更適合當成值得追蹤的研究項目,而唔係可即用工具。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 南京大學, 模型, 多模態模型, Qwen, DeepSeek, 香港, Medical醫學, 3D, 中國, Dataset 數據集

LingBot-World 2.0 把互動世界拉長

想像一個會持續生成、又跟得上操作節奏的互動世界模型。LingBot-World 2.0吸引人的地方,在於它同時追求連續性、速度與可玩性。

teaser

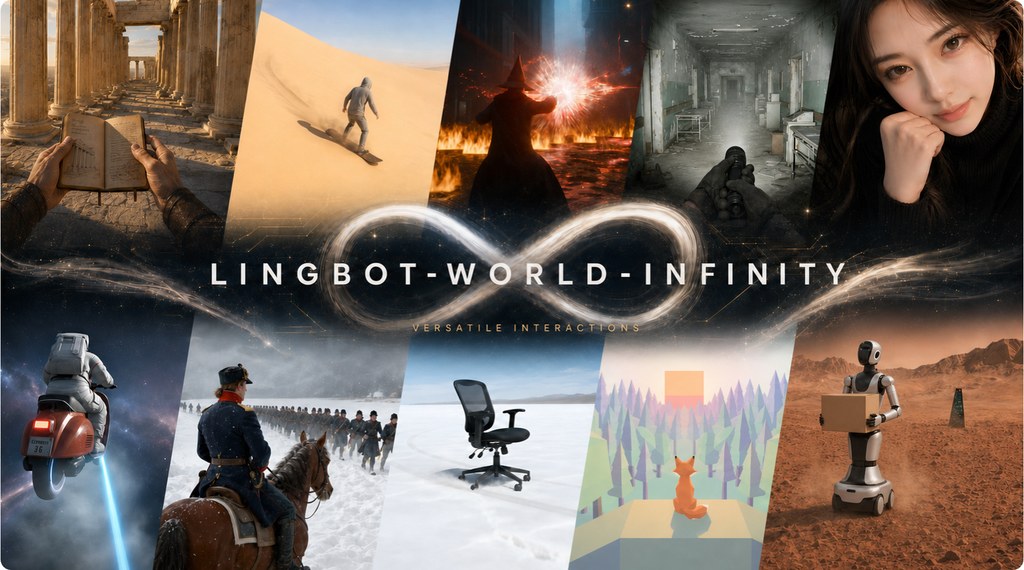
最值得留意的,不是單純生成影片,而是它嘗試把世界模型做成可持續互動的系統:畫面不只要動,還要在長時間互動下維持一致,並且跟得上即時操作。LingBot-World 2.0,也叫 LingBot-World-Infinity,定位上屬於模型項目,處理的是互動式世界生成容易愈玩愈散、反應又唔夠快的問題。

同類做法很多時偏向短片段展示,或者重視視覺效果多於操作連續性;這個版本反而把焦點放在「interaction horizon」拉長,同時保住輸出穩定度。它亦加入 agentic harness,由 pilot agent 規劃角色行為、director agent 補出新環境元素,方向上更接近可演進的遊戲式世界,而唔只係被動播放內容。

現階段最容易理解的試法,是先經 Reactor 的 Web 版本或 LingGuang 的流動平台體驗即時版;README 亦提供 Hugging Face 與 ModelScope 上的模型頁面。官方說明指出,平台版本方便試玩,但完整能力仍以官方設置為準,換句話說,公開體驗較適合感受互動節奏,未必等同完整表現。

  • 支援長時間互動,主打 unbounded interaction horizon
  • 提供即時變體,官方稱可驅動 720p、60 fps 影片串流
  • 動作與事件更豐富,包括攻擊、射箭、施法、射擊等互動
  • 以 pilot agent 與 director agent 分工,推進角色與場景演化

現有資料未見完整基準表或系統化對比結果,性能描述主要來自項目方公開說明,所以較適合把它視為一個展示取向鮮明的前沿模型。相關模型目前可見的是 lingbot-world-v2-14b-causal-fast;而從 Robbyant 整體路線來看,它亦與 LingBot-Vision、LingBot-Depth、LingBot-VLA、LingBot-Video 等項目一起指向 embodied AI 與世界模型的長線布局。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 多模態模型, 世界模型, Video, VLA

DeepSeek-V4-Flash 本地 GGUF 版

想喺本地跑 DeepSeek-V4-Flash,重點唔只係能否啟動,仲要留意量化後準確度、記憶體門檻同對話模板是否貼近官方表現。呢個版本主打用 GGUF 格式換取更易部署,但硬件要求仍然偏高。

Og image

最值得先講的是,它明確基於 deepseek-ai/DeepSeek-V4-Flash 製作,屬於面向本地部署的 GGUF 量化版本,處理的是大型語言模型喺本機執行時常見的記憶體壓力與部署門檻。頁面同時提醒要配合最新版本的 llama.cpp 或 Unsloth Studio,否則 DeepSeek-V4 可能無法正確運行,代表它對推論框架版本有一定依賴。

Unsloth 把焦點放喺量化後仍盡量保持原模型表現,並提到改良了 DeepSeek-V4 的 chat jinja template,經過超過 4000 段對話測試後,效果與官方 baseline 等效。對使用者來說,呢點比單看可唔可以載入更重要,因為同一個模型換咗模板後,回答風格、工具調用格式甚至思考開關行為都可能出現明顯差異。

檔案資訊方面,頁面清楚列出 UD-Q8_K_XL 屬於 full precision lossless 的建議選項,大小約 162GB,而且只比 Q4 的 UD-Q4_K_XL 大 7GB。描述亦提到 3-bit 可喺 110GB Mac、RAM 或 VRAM 配置運行,full precision lossless 則需要大約 168GB RAM;不過目前提供內容未見完整 GGUF 檔名清單、各量化級別大小、mmproj 附加檔案或上下文長度細節,因此無法逐一確認。

  • 已確認 base model 是 deepseek-ai/DeepSeek-V4-Flash
  • 建議使用最新 llama.cpp 或 Unsloth Studio
  • UD-Q8_K_XL 約 162GB,主打 lossless
  • 3-bit 版本可面向約 110GB 記憶體配置
  • chat template 經 4000+ 對話測試,目標貼近官方 baseline

同類模型比較上,呢個項目的差異不在重新訓練,而在於 GGUF 量化封裝、Unsloth Dynamic 2.0 量化方法,以及對 DeepSeek-V4 對話模板的修正。頁面提到 Unsloth Dynamic 2.0 準確度優於其他主流 quants,但未附上完整對比分數; v2 更新內容、檔名變更、MTP draft speculation 支援、Ollama 與 LM Studio 的具體載入方式,現有資料只足以確認支援方向,未足以逐項下定論。

項目主頁 · 模型

Categories: 開源, 模型, DeepSeek, Mac, Ollama

[技術文章] Gemma 4:更快更慳算力的多模態開放模型

Gemma 4 想解決的,不只是模型夠唔夠大,而是點樣同時兼顧推理、多模態同部署效率。你可以把它理解成一組更貼近開發與裝置落地需要的 Gemma 新世代模型。

Hero image preview

Google 正式發佈 Gemma 4 技術報告文章:

當模型要同時處理文字、圖片同音訊,常見做法多數靠獨立 encoder 加上大型語言模型組合;能力雖然完整,但記憶體佔用、推理速度同長上下文成本都容易變重。Gemma 4 Technical Report 針對的正是呢個矛盾:唔只追求更強表現,亦想把多模態理解、推理能力同計算效率放到同一條路線上處理。

Gemma 4 屬於 open-weight、natively multimodal language models,涵蓋 dense 同 Mixture-of-Experts(MoE)架構,規模由 2.3B 到 31B。報告最值得留意的對比,在於作者唔再只沿用「更大模型加外掛模組」呢種固定範式,而是加入 thinking mode,令模型先產生 reasoning trace 再回答;同時用長上下文優化、KV cache sharing,以及在 12B 版本引入 unified, encoder-free architecture,把 raw audio 同 image patches 直接投影到 LLM embedding space。

呢種設計帶來的好處幾實際:一方面,長上下文下的記憶體壓力有機會減輕,報告提到 global KV cache footprint 最多可減 37.5%;另一方面,模型亦提供用 quantization-aware training(QAT)訓練的量化版本,盡量在不明顯犧牲品質下減少參數記憶體佔用同延遲。另有 autoregressive multi-token prediction(MTP)drafter head,配合 speculative decoding 提升解碼速度。

  • 支援文字、圖片、音訊,多個型號覆蓋不同硬件需求
  • 以 thinking mode 加強數學、編程等重推理任務
  • 透過 p-RoPE、KV cache sharing 等方法改善長上下文效率
  • 12B 型號採用 encoder-free 路線,減少獨立 encoder 帶來的記憶體碎片化

性能方面,報告指 Gemma 4 在 STEM、多模態同長上下文 benchmark 有明顯進步,亦在 Arena 等 human-rated tasks 接近更大型的 frontier open models。原始資料未提供安裝步驟或完整使用流程,但已清楚交代模型系列的核心取向:用較可控的成本,換取更接近前沿水準的多模態推理能力,並以 Apache 2.0 授權開放。

Paper

Categories: Embedding, 模型, 多模態模型, 模型訓練, Google, Gemini, Image, Audio, Dataset 數據集

SenseNova-Vision 把視覺任務收進同一模型

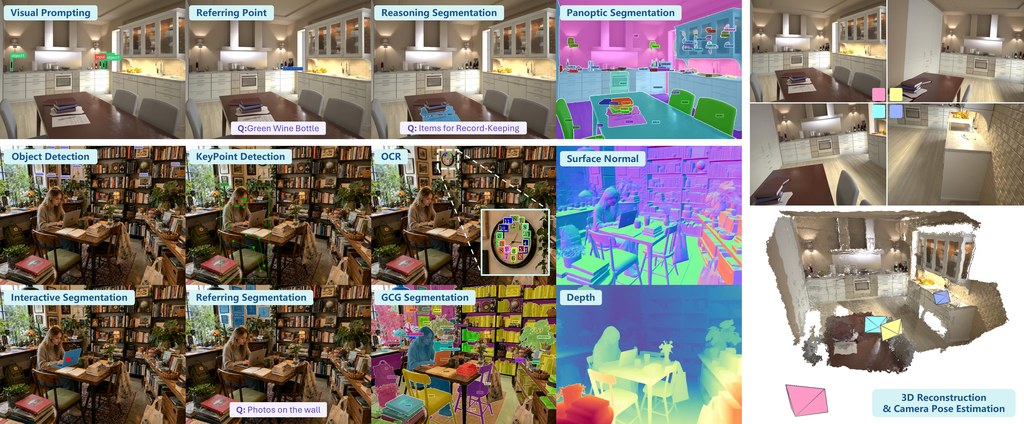
同一個模型同時處理框、點、OCR、分割同深度圖,SenseNova-Vision想解決的正是視覺流程太分散的老問題。你可以把它理解成一個用生成方式統一多種電腦視覺輸出的模型項目。

SenseNova-Vision handles diverse vision tasks in a unified model

做視覺項目最麻煩的,往往不是單一任務做不到,而是偵測、OCR、分割、深度估計同多視角幾何各有各套輸出格式。SenseNova-Vision把這些工作收斂到 unified multimodal model(UMM)的生成介面之內,屬於多模態模型項目,重點是用自然語言指令加可選視覺提示,統一處理結構化理解與密集預測。

它的取向幾明確:不再為每類視覺任務各自設計頭部與輸出器,而是把 boxes、points、OCR strings、keypoints、camera parameters 交由文字生成,把 segmentation masks、depth maps、surface normals、multi-view point maps 交由影像生成,亦支援文字加影像混合回應。這種做法的好處是工作流一致,代價則是推理解碼與評測轉換要做得夠穩,否則通用性未必等於每一項都最強。

目前公開內容包括推理程式、模型權重 SenseNova-Vision-7B-MoT、資料集 SenseNova-Vision-Corpus-50M,以及可試用的 Demo。要理解它點樣測試,最直接是先用 Demo 看同一張圖在不同指令下可否輸出可解碼結果,再配合倉庫的 Evaluation Guide 對標準 benchmark 檢查文字、影像或混合輸出的還原能力。

  • 同一模型覆蓋 結構化視覺理解、分割、dense geometric prediction 與 multi-view visual geometry
  • 輸出形式統一:文字、影像、混合文字影像都可作為回應
  • 已公開資源完整:inference code、SenseNova-Vision-7B-MoT、SenseNova-Vision-Corpus-50M、Demo
  • 適合場景明確:研究團隊、視覺產品原型、要整合多任務流程的工程工作

這個項目最適合不想為每個任務維護一套模型堆疊的團隊,尤其是同時要做偵測、文字辨識、分割與幾何估計的組合型流程。現有資料指出它在多類視覺任務上有不錯結果,但倉庫摘要未列出完整數字;現階段更值得留意的,是它用可解碼生成格式統一 benchmark 輸出的能力,這比單看某一項分數更能反映其定位。

GitHub · 模型

Categories: 開源, 模型, 多模態模型, Image, 影像處理, 香港, Dataset 數據集

SIEVE 點樣揀出更值錢的機械人示範數據

示範數據愈多,未必代表 VLA 訓練效果愈好。SIEVE 想做的,是先拆開動作結構,再挑出更值得保留的片段與軌跡。

Repository image for ChangtiWu/SIEVE

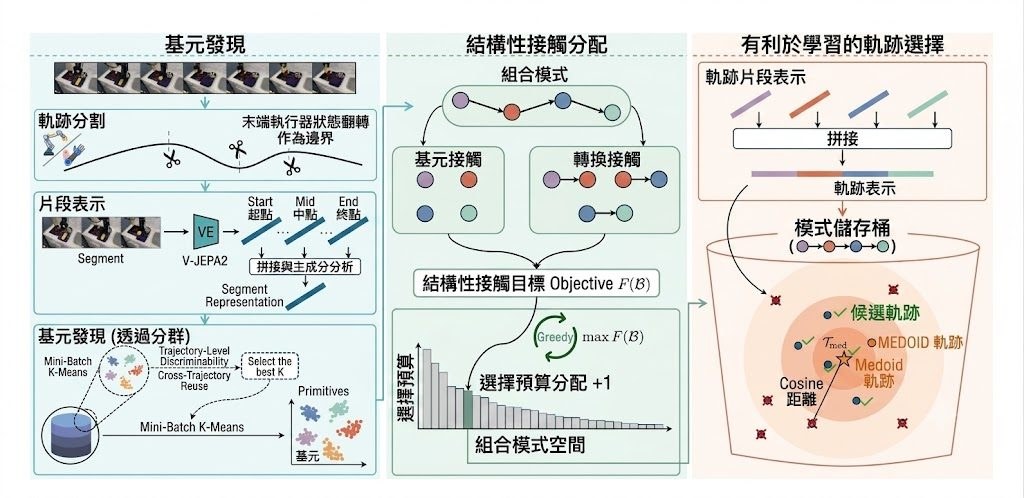
機械人示範資料最常見的問題,不是數量不夠,而是重複、嘈雜,甚至長段任務其實只是不斷重演相似動作。SIEVE 屬於一個面向 imitation learning 的資料篩選工具,同時帶有研究方法性質,重點不是逐條 trajectory 粗略評分,也不是只看 state-action,而是把長任務拆成可重用的 visuo-motor primitives 與 transition interfaces,再決定哪些 episode 更值得留下來訓練 VLA 模型。

它批評的舊範式相當明確:現有 data selection 方法多數只在 trajectory level 或 state-action level 做判斷,因而忽略長時序行為內部可重用的結構。SIEVE 的做法是先用 end-effector pose 與控制訊號做 segmentation,再抽取 V-JEPA 特徵、用 PCA 壓到預設 256 維、以 MiniBatchKMeans 找出 primitive pattern,之後按 cluster-sequence pattern 做兩階段 episode selection,最後可以匯出回 LeRobot 格式,方便直接接回原本訓練流程。

這種取向的好處,在於它不是單純挑「最好」或「最乾淨」的示範,而是優先保留結構覆蓋度與可重用性。論文提供的訊息亦相當直接:SIEVE 在多個 datasets、benchmarks 與 VLA models 上,都比競爭性的 baseline 更穩定,甚至在只用 50% demonstrations 和 50% training steps 的情況下,表現可以超過 full-data training。當然,這也代表它較適合已有一定規模示範資料、並且願意先跑一輪離線整理流程的團隊,而不是追求即插即用的小型腳本。

  • 以 LeRobot v2 資料根目錄作輸入,支援單一或多個 dataset
  • 流程由 segmentation、feature extraction、dimensionality reduction、clustering、selection 組成
  • 特徵抽取依賴 V-JEPA,輸出中間結果到 Zarr,再匯出選中的 LeRobot episodes
  • 核心差異是按 reusable structure 揀數據,不是只按整條 trajectory 或逐步 state-action 打分

部署理解上,這個項目更像一條可重複執行的離線資料處理 pipeline,而不是一個直接提供推理服務的套件。適合用來整理大型 robot demonstration corpus、為 VLA imitation learning 減少冗餘訓練樣本;相關模型與技術脈絡包括 Vision-Language-Action (VLA) models、V-JEPA,以及輸出端相容的 LeRobot。

GitHub · Paper

Categories: 開源, 香港科技大學, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, 影像處理, Robotic, 香港, 中國, Dataset 數據集

Page 12 of 37
1 10 11 12 13 14 37