Light-Omni 想把長影片 Agent 變得更快

面對長影片互動,Light-Omni唔再靠一輪輪搜尋同推理。它把記憶、檢索同回應壓縮成較輕量流程,重點放在速度同連續互動。

Light-Omni

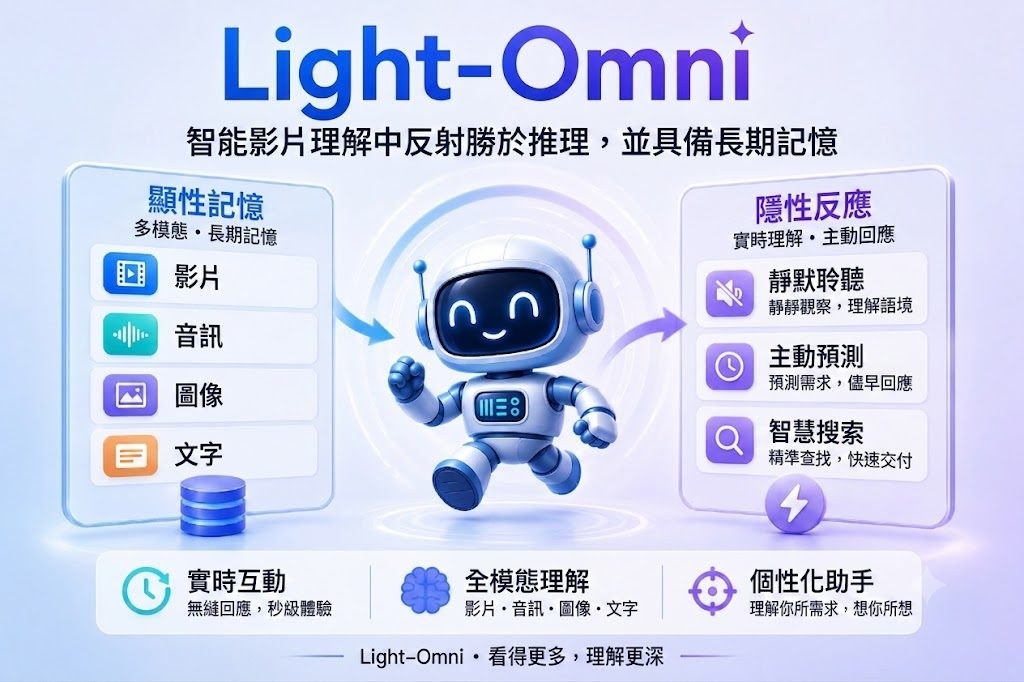
長影片互動最易卡住的位,不是模型看不懂,而是每次都要重新搜尋線索、反覆推理,回應自然會慢。Light-Omni把這件事改寫成一個Agentic video understanding研究項目:用長期多模態記憶處理視覺、語音與文字串流,目標是讓代理在連續對話中更快決定要直接回答、提取記憶,還是補足證據。

現有做法常採用作者所說的 detective-style iterative reasoning,一邊規劃、一邊搜尋、一邊聚合證據;好處是步驟清楚,代價是延遲高、計算開銷大。Light-Omni提出 reflexive video understanding,核心不是拉長 reasoning loop,而是以單次 forward pass 產生全域脈絡與 retrieval embeddings,再配合 Generation AdapterMemory AdapterReaction Adapter 三個模組,分別負責回應、長期記憶整理,以及預測何時檢索。

這個取向的價值很直接:它不是追求最繁複的推理鏈,而是優先解決互動代理在長影片場景的反應速度。項目建基於 Qwen2.5-Omni,示範則用 Qwen3-Omni-30B-A3B-Instruct;記憶設計包含 identity profiles、semantic memory、episodic memory,並加入 sleep-time memory consolidation,把較長時段的觀察壓成緊湊全域狀態,同時保留近期細節。

  • 相比 M3-Agent,平均準確率提升 2.4%
  • 速度達 12.1x,加強長影片互動的即時性
  • GPU 記憶體效率提升 2.6x,較適合資源有限的部署
  • 倉庫附有 eval.py、Flask/Socket.IO demo、Hugging Face 模型與訓練資料

想驗證這個項目,現時可沿三條路理解:先看 web demo 感受反應方式,再用倉庫內的 eval.py 配合 logs/ 檢查長影片 benchmark 結果,最後參考 thirdparty/ 內已修補的 transformersms-swift 組件做訓練或推理環境配置。較受用的讀者會是做多模態代理、長影片理解、記憶檢索,或者需要低延遲互動系統的研究團隊;它仍屬研究原型,效能數字主要來自項目提供的 benchmark 與示範,部署前仍要按自己的影片長度、硬件條件與任務形式再核實。
項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, Embedding, 模型, 多模態模型, Video, Dataset 數據集

PixWorld 把 3D 重建與生成收在同一路線

想由幾張視角圖重建場景,或者直接做 text→3D、image→3D,PixWorld 把兩條路合併成同一個模型。它的吸引力不只在速度,亦在於訓練目標更貼近 3D 場景本身。

PixWorld teaser

做 3D 場景時,很多方法會把重建同生成分開處理,PixWorld 就反其道而行,把兩者收進同一個開源框架式研究項目:同一個 end-to-end pixel-space diffusion model,同一趟 forward pass,同時兼顧 reconstruction 同 generation。對想比較 text→3D、image→3D 同多視角重建流程的人來說,這種設計最大意義在於少一層轉換,也少一套彼此割裂的模型心智負擔。

它批評的舊範式很明確:不少做法先進 latent space,要經過 VAE/RAE,再由 3D decoder 還原成 3D 表示;PixWorld 則直接在 rendered multi-view images 上施加 pixel-space flow-matching loss,令優化目標更貼近 3D scene fidelity,而唔係先對準中介 latent target。作者再加上一個 geometry perception loss,借助 frozen 3D foundation model 的 π³ / VGGT feature space,補回純 2D photometric loss 同 perceptual loss 對 3D 結構監督不足的問題。

它會把 posed multi-view inputs 分成 clean views 同 noisy views:前者走 reconstruction,後者走 generation,並由 two-stream diffusion transformer 處理,最後解碼成 pixel-aligned 3D Gaussian representation。這個取向的好處,是把 3D reconstruction、text→3D 同 image→3D 放到同一個表示與訓練框架;代價則是項目目前仍偏研究原型,README 已提到 cleaned RealEstate10K、DL3DV、ACID datasets 以及 PixWorld-480P-4steps distilled weights 與 inference code 尚未完整釋出。

  • 類型定位:屬於模型導向的開源項目,處理 3D scene generation 與 reconstruction 分裂成兩套流程的問題。
  • 主要差異:直接在 pixel space 訓練,避開 VAE/RAE 中介表示,並加入 geometry-aware 監督。
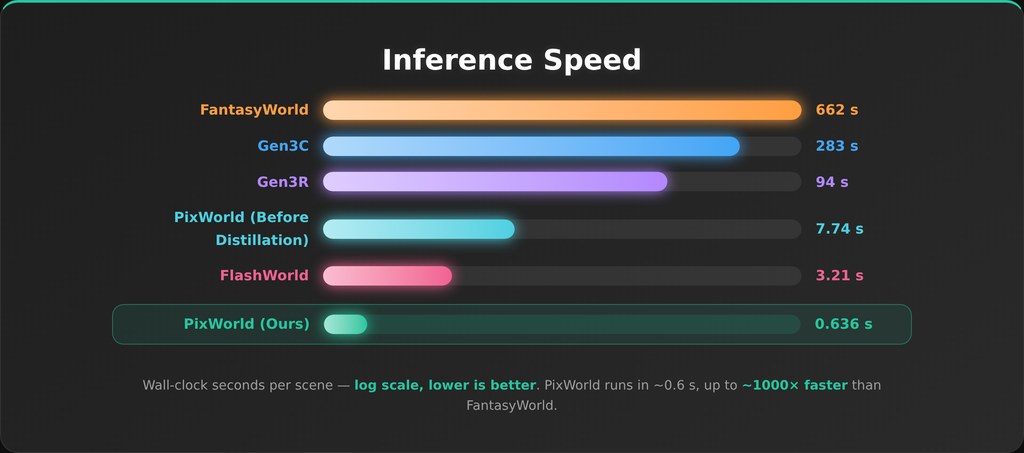
  • 已知表現:distilled 4-step 版本每個 scene 約 0.6 秒,官方稱相對 diffusion-based world generators 峰值可達約 1000× 加速。
  • 重建指標:提供 71.04 WorldScore average,以及 RealEstate10K 4-view reconstruction 的 26.21 dB PSNR。
  • 相關模型與模組:two-stream diffusion transformer、pixel-aligned 3D Gaussian、frozen 3D foundation model π³ / VGGT。

現階段較適合研究 3D world generation、3D Gaussian Splatting、multi-view reconstruction 的團隊先用來判斷方法價值,而唔係即刻當成完整生產工具部署。可惜目前公開資訊仍以論文、示範頁與方法介紹為主,未見完整安裝、評測腳本與權重發布,因此較合理的理解方式,是把 PixWorld 視為一條很有方向感的新路線:它不只是追求更快,還試圖重新定義 3D 生成與重建應該共用同一套訓練目標。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 模型訓練, Image, 3D

LingBot-Vision 補強密集空間感知

想做深度估計或語意分割,但又唔想每個下游任務都重訓視覺編碼器,LingBot-Vision正是針對這個卡位而來。它把邊界、形狀同語意區域一併學好,重點放在更可靠的空間特徵。

Boundary-centric masked modeling

做深度估計、語意分割或者影片物件分割時,最麻煩往往唔係有冇大模型,而是編碼器抽出的特徵夠唔夠貼近物件輪廓。LingBot-Vision屬於模型,更準確地說是自監督預訓練的 Vision Transformer 視覺骨幹,處理的是密集空間感知裏面「語意有了,但邊界唔夠準」這個老問題。

它的取向幾明確:唔係一味追求分類式語意表示,而是用 masked boundary modeling 去逼模型同時保留空間結構與語意訊息。凍結後的 patch tokens 已經可以直接支援輕量 readout,涵蓋 depth estimation、semantic segmentation、video object segmentation,亦作為 LingBot-Depth 2.0 的 visual encoder 初始化,這種設計比起只偏重全局語意的 ViT 骨幹,更適合需要逐像素判斷的工作流。

這個項目較接近「取用預訓練骨幹再接下游任務」的用法,而唔係即裝即用的完整應用。模型已放到 Hugging Face 與 ModelScope,較合理的理解方式,是把不同尺寸的 LingBot-Vision 權重接入現有 dense prediction pipeline,先測 frozen features 的表現,再決定需唔需要額外微調。

  • 重點不在生成內容,而在提高 dense spatial perception 的特徵品質
  • 已公開多個相關模型:ViT-S/16、ViT-Base、ViT-L/16,以至 1.1B 參數的 ViT-g/16
  • 支援的方向包括 depth estimation、semantic segmentation、video object segmentation、depth completion
  • 與同類做法相比,更重視 boundary-faithful features,而唔係只強化高層語意表示

受益最大的會是做機械人視覺、3D 感知、影像理解基建的團隊,尤其當你手上已有 segmentation 或 depth 項目,只差一個更穩定的 encoder。性能方面,README 用「substantial performance gains」形容 LingBot-Depth 2.0 在換上 LingBot-Vision 編碼器後的提升,但公開內容未列出完整基準數字,所以現階段較值得先留意其特徵可遷移性,以及在邊界敏感任務上的潛力。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, Video, VLA, 影像處理, Robotic, 3D

GigaWorld-1:機械人世界模型開源路線圖

GigaWorld-1 不只是模型,亦是一套圍繞機械人世界模型的訓練與推理流程。它的重點是用模擬 rollout 協助評估 robot policy。

GigaWorld-1 Teaser

GigaWorld-1 是一個面向 robot world models 的開源工具鏈與研究原型。它主要用來訓練、推理、處理資料,並把世界模型當成 robot policy evaluation 的替代評估器,減少每次都要落真機做 rollout 的成本。

現有做法通常依賴真實機械人測試,或者用偏重短片畫質的 video world models 觀察結果;作者認為這種範式未必足夠反映 policy 是否可靠,因為短期視覺真實感不等於長時序、動作一致的 rollout 準確度。這個項目連同 WMBench 一齊提出較清晰的評測框架,重點放在 long-horizon、action-faithful rollout consistency,而不是只看畫面似唔似真。

和一般只放模型權重的 GitHub 項目相比,GigaWorld-1 較完整地公開了訓練、inference、資料處理、checkpoint conversion 及 LoRA merge 流程,取向明顯偏向可重現與可擴充。基礎模型亦不是由零開始孤立建立,而是結合 Wan、Diffusers、Helios、Genesis 等元件,反映它更像一條可調整的工作流程,而不只是單一模型展示。

  • 重點不在短期畫面好看,而在 rollout 是否長時間維持動作一致性
  • 提供 training、inference、data processing、checkpoint conversion、LoRA merge 等完整流程
  • 相關模型與元件包括 WanDiffusersHeliosGenesis
  • 配套有 ToyDataset、CVPR 2026 WorldModel Track Dataset 與 WMBench benchmark

部署思路相對明確:環境以 Python 3.10+、PyTorch 2.x、Linux 為主,再按 README 準備資料、模型與推理流程;需要下載模型或資料時,亦已有獨立工具說明。硬件需求未算輕量,但首頁提到 1.3B / 5B 變體與低於 24GB 記憶體的生成設定,代表它並非只面向超大規模研究機構。

較適合受益的群體,是做 embodied AI、robotics、world model research 的團隊,以及想建立 policy evaluator 管線的人。現有資訊顯示它背後有 12,000+ 小時訓練影片、324,000+ 模擬 rollout 配對真機執行,以及 7 類 video world models、4 種 action representations 的比較;這些數字未必等於任何場景都會即插即用,但足以說明它的價值在於提供一套有 benchmark 支撐的評估方法,而不只是再多一個生成模型。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 世界模型, 模型訓練, Video, VLA, Robotic, 框架, Linux, Python, Dataset 數據集

騰訊 Hy3 295B 參數 MoE 開源新模型

騰訊混元團隊推出 295B 參數 MoE 語言模型 Hy3,支援 256K 上下文,主打 Agent 能力與高效推理。

Og image

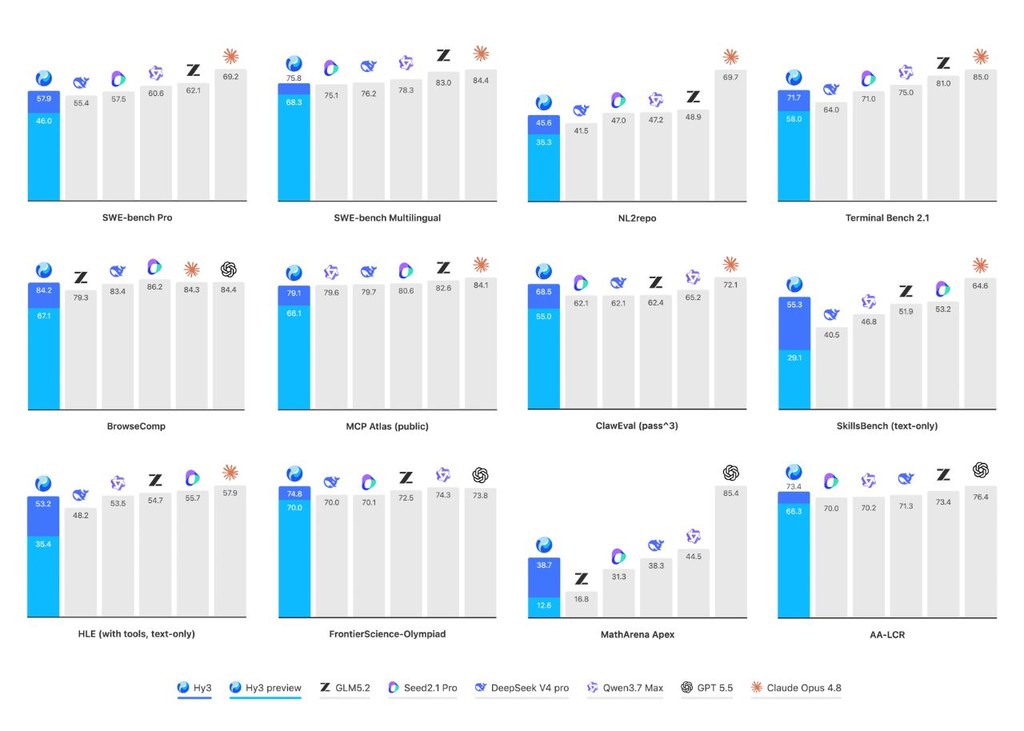
Hy3 是由騰訊混元(Tencent Hy)團隊開發的大型語言模型,屬於 Mixture-of-Experts(MoE)混合專家架構,總參數量達 295B,每次推理僅啟用 21B 活躍參數,並額外配備 3.8B 嘅 Multi-Token Prediction(MTP)層參數。此模型基於 Hy3 Preview 進行後訓練擴展,從 50 多個產品團隊收集意見後,以更高品質數據及更大規模強化學習(RL)完成優化。頁面未明確標示 Hy3 係基於邊個外部基礎模型(base model)進行微調,但模型採用原生 MoE 設計,整體架構並非由其他既有模型衍生。

Hy3 共有 80 層非 MTP 主體層加 1 層 MTP 層,採用 GQA 注意力機制(64 個查詢頭、8 個 KV 頭,head dim 128),隱藏維度為 4096,中間層維度 13312,上下文長度支援 256K token,詞表大小為 120832。MoE 部分配置 192 個專家,每次推理啟用 top-8 專家,目前僅提供 BF16 精度版本。

Hy3 官方推薦使用 vLLM 及 SGLang 兩種高效推論框架,頁面亦提供針對兩者嘅部署指南及 finetuning 流程。由於模型體積龐大,即使只有 21B 活躍參數,完整 BF16 權重對消費級 GPU 而言仍然極具挑戰性,需要多張高階加速器才能承載。

Tencent Hy3 (Fully Tested) + Fully Free API: BEATS GLM-5.2?

值得留意嘅係,Hy3 配備 MTP 層參數,可配合 speculative decoding 等加速技術提升 token 生成效率,呢類進階功能適合追求低延遲嘅應用場景。

  • 模型類型:295B 參數 MoE 語言模型,每次啟用 21B 參數
  • 上下文長度:256K token,詞表 120832
  • 精度支援:目前僅提供 BF16 版本,未見 GGUF 或 AWQ 等量化檔案
  • 部署框架:官方推薦 vLLM 與 SGLang
  • 核心強項:Agent 能力、推理表現,以及 MTP speculative decoding 加速潛力

項目主頁

Categories: 開源, 騰訊, 模型

TasteGap:量度人類與 LLM 的 Research Taste

這是一套研究構思評測工具,用來比較人類與 LLM 想法分佈有幾唔同。它唔係只看新穎度,而是追蹤研究口味偏向。

Repository image for ziyuuc/TasteGap

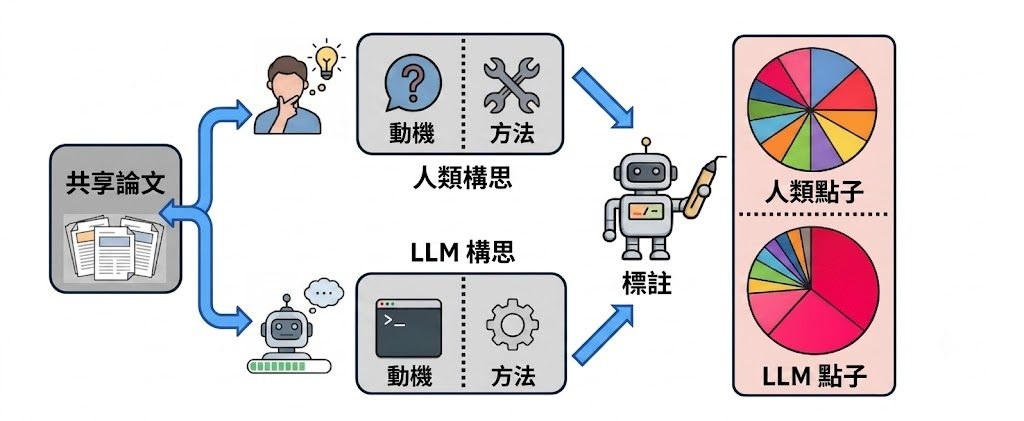
TasteGap 是一個研究評測工具與研究原型,核心工作是比較人類研究者與 Large Language Models(LLMs)生成研究構思之間的差距。它並非處理單篇提案好唔好,而是同一批文獻背景下,人類與模型會傾向提出邊類動機、邊類方法,從而量度所謂 research taste。

現有做法多數用 novelty、feasibility 或專家偏好去評分單個 idea,作者認為呢種固定範式只能判斷「像不像好主意」,但未必見到分佈偏差。TasteGap 改用 shared literature context:先從高質論文反推一組可能啟發該論文的 related works,再要求 LLM 從相同材料生成新 idea,之後用 two-axis research-taste taxonomy,分別標註 motivation 同 method,對比 human ideas 與 LLM ideas 的整體分佈。

GitHub 儲存庫目前提供 evaluation code,而唔係完整訓練框架。安裝理解上相當直接:準備 Python 依賴、設定 config.json 內的 generation 與 labeling 模型、填入 OpenAI 或兼容 API 端點,再用 JSONL 輸入跑 generate_ideas.pylabel_research_taste.py;要重現完整資料,則需另外下載 Hugging Face 上的 IdeaSeed。輸入記錄包含 paper title、URL、domain、related works,以及人類參考 proposal 的 motivation 同 method,代表這個項目設計重點是可重跑比較,而唔係單次展示結果。

作者提出的主要判斷幾清楚:不同 LLM 生成的 idea sets 都出現一致 distributional gap。LLM ideas 較集中在 bridge-like opportunities 同 synthesis methods,人類論文參考分佈就覆蓋更廣,表示模型可以提出合理點子,但研究取向仍然較窄,亦有系統性偏移。

  • 不是一般 brainstorming 工具,而是用來量度 ideation 分佈差異的評測項目
  • 保留 human ideation 與 LLM ideation 在相同文獻脈絡下的可比較性
  • 研究口味以 motivation 與 method 兩條軸線標註,分析角度比單純打分更細
  • GitHub 內容偏向生成與標註流程,完整資料需配合 IdeaSeed dataset
  • 適合做 AI for science、LLM ideation、科研流程研究的團隊作內部基準

TasteGap 沒有綁定相關模型,只要求在 generationlabeling 填入可用模型,並支援 OpenAI-compatible endpoint。這種設計方便團隊橫向比較不同 LLM,但現階段儲存庫未提供完整效能表或基準腳本整理頁,因此不算是交付即用型產品。

GitHub · Paper

Categories: 開源, 模型, OpenAI, Gemini, API, 工具, Python, Anthropic, Dataset 數據集

VLA-Corrector 補救機械人動作失誤

這是一個為 Vision-Language-Action 政策加入即時修正能力的推理框架。重點不在重訓模型,而是在偏差出現時及時截斷舊動作。

VLA-Corrector logo

VLA-Corrector 是一個面向 Vision-Language-Action(VLA)政策的輕量推理框架。它用來處理由 action chunking 帶來的開環盲點:環境已經變了,機械人卻仍照住排隊中的舊動作繼續做。

它的做法不是改寫整個 VLA 模型,而是把 backbone 凍結,再外掛一個 latent dynamics corrector。系統先用 Latent-space Vision Monitor(LVM)監察預測中的視覺特徵變化,當觀察到的畫面持續偏離預測,就會截斷過時動作,並透過 Online Gradient Guidance(OGG)重新規劃下一步。

這種取向與每一步都重算一次動作的 closed-loop 方法不同,重點是保留長 action horizon 的效率,同時在偏差累積時才介入。代價是它依賴 latent mismatch 偵測是否可靠,較像在效率與反應速度之間取平衡,而不是追求全程最敏捷控制。

  • 項目定位:屬於機械人控制推理框架,針對 action-chunked VLA policies 的修正與重規劃。
  • 部署理解:現有資訊顯示它應接在既有 VLA policy 後面運作,較像推理期增強模組,不是獨立基礎模型。
  • 適合場景:接觸密集 manipulation、抽屜對位、抓放物件這類容易受干擾的任務較能受益。
  • 核心組件:Latent-space Vision Monitor(LVM)負責偵測偏差,Online Gradient Guidance(OGG)負責觸發後的修正重規劃。

公開資料提到 real-robot demonstrations,例如抽屜對位與把積木放入不同碗中,並展示人在執行途中施加干擾後的恢復能力。不過 README 片段未列出完整數字指標、安裝步驟或支援哪些 VLA backbone,因此較合理的理解是:這是一個研究原型,已清楚展示方法與效果,但整合到不同機械人堆疊前,仍需自行確認相容性與評測流程。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 多模態模型, VLA, Robotic

Supra-Router-51M:AI 嘅智能分流

51.7M 參數嘅微型路由模型,自動判斷請求該交由本地小型模型定雲端大型模型處理。

Og image

Supra-Router-51M 係一個基於 SupraLabs/Supra-1.5-50M-Base-exp 基礎模型微調而成嘅小型語言模型(SLM),定位係多模型生態系統嘅邊緣路由閘道。佢嘅主要用途係分析用戶輸入嘅提示詞,判斷該請求適合由本地小型模型處理,定係需要轉交雲端大型模型,從而優化整體運算資源分配。

模型採用 Multi-Task Sequence Generation(多任務序列生成)嘅方法,唔係單純做二元分類。佢會先輸出一連串結構化資訊,包括語義領域(Domain)、複雜度評分(Complexity 1-5)、數學需求(Math)、程式碼需求(Code),最後先輸出路由決定(Route)。呢種設計令模型喺做最終判斷前,先建立內部特徵激活圖,避免細模型容易出現嘅權重崩塌問題。

訓練方面使用咗 SupraLabs/Prompt-Routing-Dataset 數據集(992 筆樣本),訓練 5 個 Epoch,但喺 Epoch 3(eval_loss 為 0.1342)已達到峰值後就回退保存,避免後段過度擬合。支援序列長度達 3840 tokens,使用 bfloat16 精度,喺 CPU/GPU 都能做到次毫秒級推論速度。推論時必須用 greedy decoding(do_sample=False)以確保決策穩定性。

使用時需要將用戶查詢包裝喺特定格式(Task: [Prompt] Analysis:)入面,模型會輸出 pipe-separated 嘅結構化字串,包含完整嘅提示詞遙測資訊。配合 FastAPI 等閘道框架就可以部署成生產環境嘅自動分流系統。

由於模型只有 51.7M 參數,運行門檻極低,適合邊緣裝置同需要即時決策嘅場景,但佢嘅路由準繩度仍然受制於訓練數據集規模較細呢個限制。

重點摘要:
– 基於 SupraLabs/Supra-1.5-50M-Base-exp 微調,僅 51.7M 參數
– 採用多任務序列生成架構,先分析提示詞特徵再決定路由
– 訓練數據集 992 筆,3840 tokens 序列長度,次毫秒級推論
– 支援 FastAPI 閘道部署,需使用 greedy decoding 確保穩定
– 適合邊緣裝置資源調度,限制係訓練數據規模較小

項目主頁

Categories: 開源, 模型, 框架, LLaMa, Dataset 數據集

LiveEdit:串流影片編輯走向即時化

LiveEdit 把文字指令變成串流影片編輯,重點放在速度與畫面穩定。它嘗試兼顧即時反應,以及背景與非編輯區域的保留。

Image 1

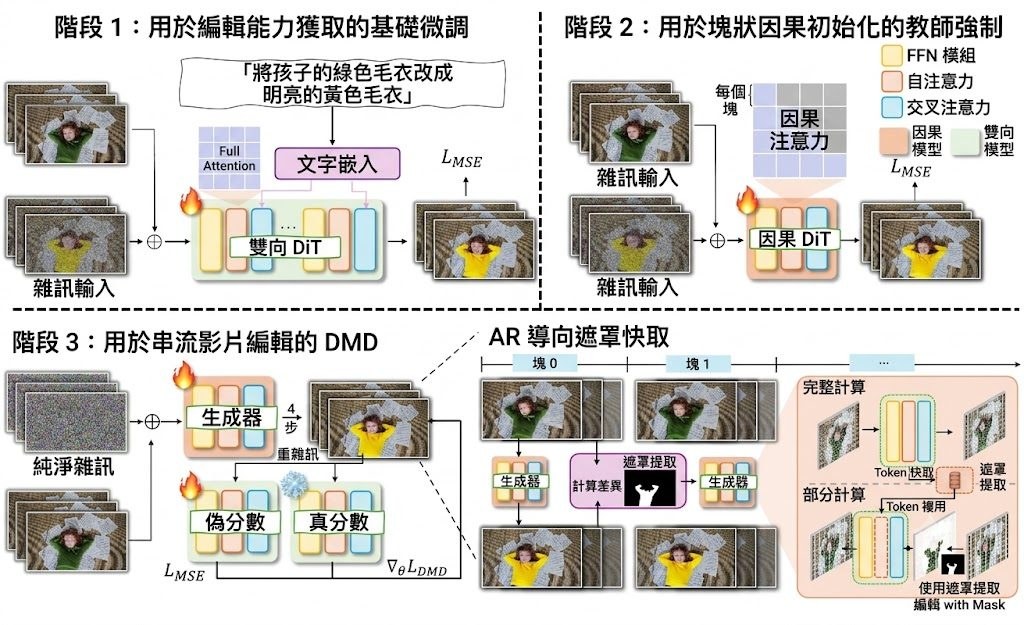
LiveEdit 是一個 diffusion-based streaming video editing 系統,屬於影片編輯模型與方法項目。它的核心任務是根據來源影片加上文字指令,逐段完成 causal chunk-by-chunk editing,並盡量保留背景與沒有修改的區域。

這個項目不是追求離線影片慢慢算到最靚,而是針對接近即時的串流編輯。它建基於 Wan2.1 和 Self-Forcing codebase,並用 three-stage distillation,把雙向編輯 teacher 的能力轉移到串流 student,再配合 AR-oriented Mask Cache 減少重複運算,換來較低延遲。

部署與測試資訊算是完整,提供 inference scripts、training code、checkpoint instructions,也講明建議在 Linux 配合 NVIDIA GPUs 執行;單 GPU 可做 inference,多 GPU torchrun 主要用於訓練。輸入方式是準備一個 JSON,填入 source video 路徑和 instruction,然後配合已釋出的權重與 Wan2.1 base model 進行推理。

有一個相當關鍵的參考值:項目頁列出 12.66 FPS,並表示透過 4-step distilled diffusion generation 達成 real-time streaming inference。這個成績對互動式影片編輯很重要,不過公開資訊未見更完整的硬件條件、顯存需求或不同解析度下的比較,因此判斷效能時仍要保留一點。

  • 重點不是一般文字生片,而是保留原片內容的串流影片編輯
  • 主要技術包括 three-stage distillationCausal DiTAR-oriented Mask Cache
  • 已公開 inference 與 training 程式碼,也提供 Hugging Face checkpoint 指引
  • 已知較適合 Linux、NVIDIA GPU 環境,研究團隊或影像生成工程師較易受益
  • 相關模型與基礎包括 Wan2.1-T2V-1.3B、bidirectional editing teacher、streaming student

整體來看,LiveEdit 的價值在於把 streaming video editing 做得更接近可互動系統,而不只是展示級效果。它較適合研究即時影片編輯、互動內容製作、直播視覺處理或需要低延遲生成的團隊;一般用家若想直接在圖形介面一鍵開用,現有資料未提供管理後台整合、免手動設定流程,仍然比較像面向研究與開發者的項目。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Video, 框架, Linux, 蘋果

oMLX:把 Mac 變成本地 LLM 控制台

oMLX 針對 Mac 本地 LLM 部署而設,重點不是模型本身,而是讓快取、載入與切換更省心。

oMLX

oMLX 是一個針對 Apple Silicon 的本地 LLM 推理工具,也是帶有圖形介面與 CLI 的伺服器管理項目。它主要解決的不是「能不能跑模型」,而是怎樣在 Mac 上較穩定地管理多個模型、保留 KV cache,並減少重複計算帶來的等待時間。

這個項目的取向很明確:用選單列介面處理常見操作,再配合終端機與 Apple Shortcuts 控制同一個服務。安裝路線亦相當直接,macOS 用戶可透過 .dmg 安裝,另有 Homebrew 方式;日志位置、背景服務與 CLI shim 都已交代,對需要長時間開著本地模型的人較友善。

Finally, The CORRECT Way to Run Local AI on a Mac

它和一般本地 LLM server 的差異,在於分層 KV cache 設計。oMLX 把常用內容留在 RAM 的 hot tier,不夠位時再轉去 SSD 的 cold tier,並以 safetensors 格式保存;即使伺服器重啟,遇到相同前綴內容仍可重用快取,這對長對話、編程輔助和工具調用尤其有價值。

只需點擊一下,即可直接從管理面板設定 OpenClaw、OpenCode、Codex、Hermes Agent、Copilot 和 Pi。無需手動編輯配置。

  • 支援 hot tier(RAM)與 cold tier(SSD)分層快取
  • 可自動以 LRU 方式卸載較少使用的模型
  • 管理介面可手動 load/unload 模型
  • 提供選單列操作、CLI 與 Apple Shortcuts 整合
  • 適合需要長上下文與多模型切換的 Mac 工作流程

現有資訊提到 continuous batching、context limits 與基準測試頁面,但 README 片段未列出具體數字,所以性能判斷宜保持審慎。可確定的是,它較適合在本地做持續開發、配合 Claude Code 一類工具,並集中管理「常駐小模型+按需切換大模型」的團隊或個人環境;相關模型方面,內容明確提到 everyday models、heavier models,以及可選的 GLM-5.2、MiniMax M3 原生 custom kernels 支援。

GitHub

Categories: 開源, Agentic, 模型, 框架, Mac, 蘋果

Page 13 of 37
1 11 12 13 14 15 37