AesCode 以圖像生成資訊網頁

生成式 AI 做海報或儀表板時,常要在視覺美感與文字、數據正確之間取捨。AesCode 把圖片生成器當作設計參考,再輸出可編輯、可驗證的 HTML 與 CSS。

Infographics generated as editable HTML and CSS by AesCode

想用 AI 製作簡報、海報、儀表板或網頁,往往不只要內容齊全,版面層次和配色也要合適。AesCode 是一個視覺程式碼生成模型,透過圖片生成器提供美感參考,再把結果寫成可編輯、可驗證的 HTML 與 CSS;文字和數據仍以使用者提示為準,避免把參考圖中的錯誤內容照搬進成品。

AesCode 不把參考圖片當成正確答案,而是訓練模型分開處理內容要求與視覺線索。它先用設計圖表示文字、圖表、表格和版面區域之間的關係,再以多項可程式化檢查評估執行結果、文字、邊界、圖表數據、版面及留白;視覺評分則採用與設計圖連結的評分規準,並把不同評分渠道分開處理。

簡單講,就係「用 AI 將內容變成有設計感、而且可以修改嘅 HTML/CSS」:你提供文字要求,可以再加一張參考圖片,佢就生成資訊圖、簡報頁、海報或者儀表板,而唔係只生成一張平面圖片。

訓練從既有的 8B 和 32B 模型出發,並非從零訓練;項目提供 AesCode-8B 與 AesCode-32B 模型。首頁列出 3,000 個冷啟動監督微調示範和約 7,408 個強化學習提示,並提醒提示數量不等於完整強化學習生成次數。使用者可透過公開模型測試生成結果,再按需要修改 HTML 與 CSS;複雜插圖和照片則保留為語義佔位區,圖表交由 ECharts 處理,未涵蓋的視覺素材可在後續流程交給圖片生成器或人工補上。

測試結果顯示,移除推理階段的參考圖片後,AesCode-8B Visual 分數只下降 1.0 分,基礎模型則下降 19.6 分;即使政策模型推理時看不到參考圖,採用參考圖評分訓練後,僅依提示生成的 Visual 分數仍由 25.17 升至 69.71。AesCode-32B 在 GDB/lica、SlidesBench 和 Design2Code 的 14 項指標均高於 Qwen3-VL-32B 基礎模型,提升較多的項目集中在設計相關指標;這些結果支持設計能力能遷移至其他基準,但不代表每種版面都能一次生成妥當。

  • 參考圖片提供版面與風格線索,不作為文字和數據的事實來源。
  • 設計圖把元素及其對齊、包含和排列關係納入評估。
  • HTML 與 CSS 保留編輯空間,適合需要後續人工調整的設計工作。
  • 複雜插圖採用佔位區,圖表使用 ECharts,生成範圍因此有所限制。

需要大量製作資訊圖像、簡報或儀表板的設計與內容團隊,可以把 AesCode 納入生成及後期修改流程;熟悉 HTML、CSS 的開發者亦較容易檢查版面並修正細節。它的優勢在於把視覺指引轉化為可修改的程式碼,而非交付一張難以局部調整的平面圖;若成品需要精細插畫或照片,仍要安排額外素材生成或人工處理。
項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, Qwen, 微軟, Image, Dataset 數據集, UI/UX, 強化學習

Jeva 把可變選項決策搬到本地模型

面對候選答案會增減、排序又不應影響結果的任務,Jeva 以本地 4B 模型處理選擇、否定及評分。

Null-aware · Permutation-invariant · Option-scalable · Cacheable

候選答案數量不固定、選項次序不應改變判斷,正是 Jeva 嘗試處理的場景。它屬於開源本地決策模型,輸入狀態和 typed questions,輸出候選機率、Boolean probability 或 expected rubric score,亦能表達「沒有合適答案」。

Jeva 以共享語言編碼器獨立處理 state 和每個 option,再由 compact decision stack 只更新 state,對完整 option memory 作集合式判斷。這讓候選集合可以改變而毋須固定 label vocabulary;排序候選只會同步排列機率,不會改變語義身份。

模型權重可從 Hugging Face 載入本地推理,項目目前要求 Linux x86_64、NVIDIA GPU、CUDA 12.8 及 PyTorch 2.9.1。加速 kernel 可能在第一次請求時編譯,亦提供較慢的 reference installation;evaluation 和 fine-tuning 文件可用來延伸測試。

可重用的 option vectors、projected keys/values,以及完整 option tuples,適合候選內容反覆重組的分類、審核和評分流程。代價是硬件與 CUDA 環境要求較高,而項目提供的評估資料需要按自身任務重新核對,不能只憑模型名稱推斷效果。

  • 集合式決策: 候選數量可變,無需為每套選項重建輸出層。
  • Permutation symmetry: 重排候選只會重排對應機率。
  • Null awareness: 分開估計答案是否存在,以及候選之間的競爭。
  • 計算重用: 可快取整組選項,或重用個別 option 表示。
  • 適合場景: 本地化的選擇、審核、狀態判斷和 rubric 評分工作流。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, NVIDIA, Linux, Python

Urbex 讓城市級 3D 定位改用主動搜尋

Urbex 讓視覺語言代理在城市級 3D 場景自行搜尋證據,毋須預先建立物件候選框,定位能力與效率取捨更值得檢視。

Urbex logo

面對城市級 3D 場景,逐一比較預先產生的物件候選框容易拖慢搜尋,也會受候選品質限制。Urbex 屬於開源的 Agentic 視覺模型項目,將 3D grounding 改成主動空間搜尋,讓 vision-language agent 按需要查詢地標、縮放區域、切換斜視角,再提交目標 bounding box。

它不是只靠一次影像判斷,而是在互動式 multi-view environment 逐步收集證據。Reinforcement learning 同時訓練定位和搜尋決策,模型會學習應該檢查哪裏、何時縮窄範圍,以及幾時足以作答;這免除對 precomputed instance proposals 和 ground-truth boxes 的依賴,但每次搜尋仍要承受多步操作成本。

CityRefer 測試中,Urbex 的 ND Hit@1、Hit@3、Hit@5 為 25.8、39.2、42.3,NO 對應為 23.9、36.9、40.7,搜尋時間約 3.2 秒。相較 CityAnchor 的 32.1 秒,速度明顯較快;模型亦在 STPLS3D-Refer 取得 zero-shot 結果,反映跨場景泛化潛力,但不能直接等同於所有城市環境都同樣穩定。

• 支援 CityRefer 訓練及單查詢互動式 3D 推理
• 提供 Hugging Face 的 Urbex-4B 模型和 Urbex-Data 數據集
• 可透過 Colab notebook 試用預測視圖
• 安裝需要 Linux、Python 3.11、CUDA 12.8 及 C++ 編譯器

研究城市建模、3D 視覺定位或多模態代理的團隊,較適合用它測試 candidate-free grounding;想快速驗證概念的人則可先用 Colab。完整訓練需要 CUDA 12.8、Megatron Core、Transformer Engine 和 FlashAttention,硬件及環境門檻明顯高於單純推理,因此本地部署前應先確認 GPU、編譯工具和數據下載流程。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Image, 工具, 3D, Linux, Python, Dataset 數據集, 強化學習

VideoJev 加速影片理解,問答推理快逾百倍

VideoJev 把時間定位與選擇題影片問答放進同一個評分介面,減少生成式回答的延遲。

VideoJev

處理長片段、重複提問或需要找出事件時間的工作時,VideoJev 不必逐字生成答案,而是直接比較候選時間區間和答案選項。這個項目屬於影片理解模型,實際處理 temporal grounding 與 multiple-choice video QA,並將兩項任務放進同一個決策介面。

它以共享影片計算配合 Cached inference 和 Joint inference:前者保留已處理的視覺資訊,方便後續查詢;後者讓多條問題在一次 forward pass 中完成。相較依靠 autoregressive decoding 的 video multimodal large language models,直接候選評分較適合大量、結構清晰的判斷,但不負責自由生成長篇答案。

  • VideoJev-4B 建基於 Qwen3.5-4B,VideoJev-35B-A3B 建基於 Qwen3.6-35B-A3B
  • 兩個模型均提供 BF16、Safetensors 權重及 Hugging Face checkpoint
  • 三個 temporal grounding benchmark 的 mIoU,較各自 backbone 分別提升 6.7 和 10.8 分
  • 四個影片問答 benchmark 在 Thinking mode 維持相近表現,推理速度提升超過 100 倍

研究結果亦量得 temporal grounding 約 2.8 至 3.1 倍加速,顯示它較適合影片搜尋、內容索引、監控片段定位,以及需要連續提出多條問題的視覺代理工作流。試用可按儲存庫提供的環境設定,透過 Transformers 的 AutoModel、AutoProcessor 載入 Hugging Face 權重,再以示範影片測試;不過儲存庫資料未交代硬件門檻,BF16 模型的記憶體需求仍需按部署環境自行確認。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, AI productions, 模型, 多模態模型, Qwen, Video, 庫, Dataset 數據集

CineRecon 以 Blender 重建實景影片

CineRecon 將影片重建變成可檢驗的 Agent 任務,要求模型由參考影片建立可編輯、可動畫化的 Blender 場景。

CineRecon logo

由完整參考影片出發,Coding Agent 透過 Blender MCP 撰寫及修改 Python,反覆比對渲染畫面,再建立包含幾何、材質、角色動作與鏡頭動畫的可編輯場景。CineRecon 屬於影片重建 benchmark,處理的是模型能否將時間連續的影像內容還原成可修改的 3D 工作成果,而不只是產生相似畫面。

項目以三個重建層級拆開能力差異:Proxy 只要求位置、互動及鏡頭運動,Simplified 再保留可辨認形狀和主要外觀,Detailed 則加入特色形狀、材質和細節。三個層級都要求相同的主體動作、事件及攝影機行為,方便分辨模型是只掌握構圖,還是能重建完整視覺內容。

  • 50 段參考影片,切分成 360 個評估片段
  • 35,836 筆獨立 checklist 記錄,按層級擴展至 49,668 項檢查
  • 評估 Camera、Static、Dynamic 三類一致性
  • 支援畫面選取、時間戳對齊、並行評分、續跑及分數彙總

評分由獨立 VLM judge 對齊參考與渲染影片,按片段 checklist 檢查 11 個類別,並以 Camera、Static、Dynamic 三個同等權重維度計算結果。這比單一影像相似度更能揭示鏡頭是否跟足、物件是否保持穩定,以及動作和事件有沒有在正確時間發生。

測試需要 Python 3.10 或以上,支援 Linux 及 macOS;項目提供資料、提示詞、驗證工具和離線 smoke test,但不包含 Agent launchers。團隊可先用離線流程確認資料與評分管線,再接駁 Blender MCP 和隔離 worker 執行重建;研究模型能力時,CineRecon 的價值在於把「看似相似」拆成可追蹤的鏡頭、靜態內容和動態內容,而不是只比較最後一段影片。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, MCP, 模型, 視覺模型, Video, Image, 提示詞, Vibe Coding, 工具, Mac, 3D, Linux, Python, 編程, Anthropic, 動畫, Dataset 數據集

LensErase 超精確移除物件,水印

只需圖片與 mask,LensErase 便可移除物件、文字或水印,再按周圍內容補回較自然的畫面。

logo mark

移除圖片中的水印、文字或多個物件時,難處往往不在於遮走目標,而是要同時處理陰影、反光及原本被遮住的背景。LensErase 以 foundation model 形式處理這類影像擦除工作,輸入一張圖片和一個 mask,輸出清理後的結果,適合海報整理、圖片修復及內容再利用等場景。

項目配套的 LensErase-100M 包含 101.07M 組對齊的 input–mask–target 三元組,涵蓋一般圖片、水印、大範圍 mask、視覺文字及海報五類資料,另有 140K 組 SFT samples 和 19K 組 RL samples。高解析度資料會由 GPT-5.6 Sol 檢查 mask 有效性、編輯正確性、重建效果及非目標內容保留程度。

LensErase-Bench 收錄 500 個案例,毋須指定唯一的 ground-truth target,改以 Removal、Inpainting、Preservation 和 Cleanliness 四個維度評估,當中完整移除目標及相關效果佔總分 40%。較貼近擦除任務的實際情況,因為同一個遮罩可能存在多個合理的背景補全方案。

  • 支援物件、視覺文字、水印及其相關效果的移除
  • 以 LensErase-100M 支援 pretraining、SFT 及 RL
  • 以 LensErase-Bench 評估移除、補全、保留和畫面潔淨度
  • 提供與 GPT-Image2.5-Sunburst、Flux2-Erase 及多個開源模型的比較
  • 頁面目前只表示 Code coming soon,未提供安裝、下載或使用流程

項目展示了跨場景和多物件擦除能力,亦包括海報及反射等較複雜案例。對需要批量清理素材、保留非目標結構的影像工作流;不過使用者仍需等待程式碼及更多可重現資料。

項目主頁

Categories: 開源, 北京大學, 模型, 模型訓練, 微軟, OpenAI, Stable Diffusion, Image, Dataset 數據集, 強化學習

Multics:開源多玩家世界模型

Multics 是騰訊 ARC Lab 與港大合作的多玩家影片生成世界模型,靠分層通訊機制讓同一個訓練版本直接推廣到 6、8、10 人,玩家與鏡頭控制互不干擾。

Repository image for TencentARC/Multics

打機時如果有 4 個、6 個甚至 10 個玩家走在一起,畫面要保持連貫,又要讓每個人各自控制鏡頭與動作,舊做法往往一加人就 O(N²) 爆計,或出現互相干擾。Multics 正是針對這個卡位:來自騰訊 ARC Lab 與香港大學的開源世界模型,採用 Player → Group → Global 的分層通訊,動態根據最近鏡頭軌跡分組,限制無關事件直接混合。共享的 group-token 參數令用 4 人數據訓練的模型,可以直接推廣到 6、8、10 人而毋須重新訓練。

對於做多人遊戲原型、模擬訓練環境或敘事影片的團隊,這個項目直接省掉「人數一變就要重訓模型」的麻煩,同時降低自注意力計算量,GPU 開銷壓得較低。它的代價是依賴 NVIDIA GPU、CUDA 12.8 與 Linux 環境,安裝需用 uv 同步依賴,並從 Hugging Face 下載包含 VAE、tokenizer 與 4-player checkpoint 的完整推理包。

Repository 提供 inference.py 配合 YAML 配置,可選擇 4-player 範例或擴展到多人數測試,原始資料未列出具體的玩家數上限驗證結果,只說明同一個 4 人 checkpoint 能支援 10 人輸出。代碼以 Apache 2.0 授權,研究與商業應用皆可改作。

重點摘要:

  • 騰訊 ARC Lab 與香港大學共同開發的多玩家影片生成世界模型
  • 分層通訊機制降低注意力計算成本,避免無關玩家互相干擾
  • 共享參數設計讓 4 人訓練版本直接支援 6、8、10 人,毋須重新訓練
  • 推理需 Linux + CUDA 12.8 + NVIDIA GPU,模型權重經 Hugging Face 發佈
  • 適合多人遊戲畫面合成、模擬訓練、互動敘事等需要可擴展多視角的工作場景

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 騰訊, 模型, 世界模型, 模型訓練, NVIDIA, Video, 香港, Linux, Tokenize

Agent Sociodrama:以社交方式強化 Agent

北航與南洋理工團隊提出 Agent Sociodrama,追蹤多智能體對話中的情緒與關係演變,再以 Trajectory-Guided Persona Recasting 重新分配角色,部分場景準確率提升達 83.3%。

Repository image for lululu896/Agent-Sociodrama

多個 LLM agent 組隊做任務時,常出現一些尷尬的社交故障:掌握關鍵資訊的角色不發言、意見領袖把答案鎖死在錯處、有人越界卻無人制止。北京航空航太大學與南洋理工大學的合作研究 Agent Sociodrama,正是要把這些「社交病徵」量化,再對症下藥。

這個項目的核心做法是把每一次對話拉成兩條可追蹤的軌跡:每個 agent 的情緒狀態 S,以及彼此之間有向、不對稱的關係 R。系統在六款主流骨幹模型、五個社會情境中重播這些軌跡,檢驗它們是否符合社會學經典模式,並比對人類評審的判斷。當軌跡顯示團隊運作出現結構性偏差,便啟動 Trajectory-Guided Persona Recasting(TPR)診斷失敗根源,重新調整各 agent 的人格設定再重跑任務。

四個協作基準測試中,TPR 在異質與隨機初始的團隊組合上皆有改善,準確率最高提升 83.3 個百分點;在分散資訊合作及混合動機議題類任務中,三個場景擊敗 SOTOPIA 與 AgentVerse,Pareto 比率領先最多 37.5%。對於需要模擬談判、群體決策或角色扮演的研究團隊,這套框架把「為何對話走偏」變成可分析的數據,而非只能靠事後觀察。

目前已公開 fidelity 與 recasting 兩組實驗的處理結果、重算表格的腳本,以及 Tavern 繼承糾紛與 Lost at Sea 兩個完整對話範例;模擬引擎與 TPR 控制器則待論文獲接收後釋出。要快速理解這套方法,可以直接看 fidelity_tavern 資料夾內 Claude Sonnet 4.6 驅動的五位 agent 九輪對話,逐輪檢視 S 與 R 的更新。

  • 追蹤情緒狀態 S 與有向關係 R,建立可量化嘅多 agent 社交軌跡
  • 以社會理論模式同人類評審交叉驗證社交保真度
  • TPR 自動診斷團隊失敗並重塑人格,喺四個基準平均顯著提升表現
  • 已釋出數據、重現腳本同完整對話範例,方便本地分析

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, World-Action Model, 框架, Anthropic

WOVEN:把視覺世界模型放入多模態 LLM 的新訓練範式

WOVEN 提出視覺轉換推理(visual transition reasoning)框架,用約 2,000 條受控樣本就能讓多模態 LLM 在 22 個外部基準上進步最多 27.3 個百分點。

WOVEN

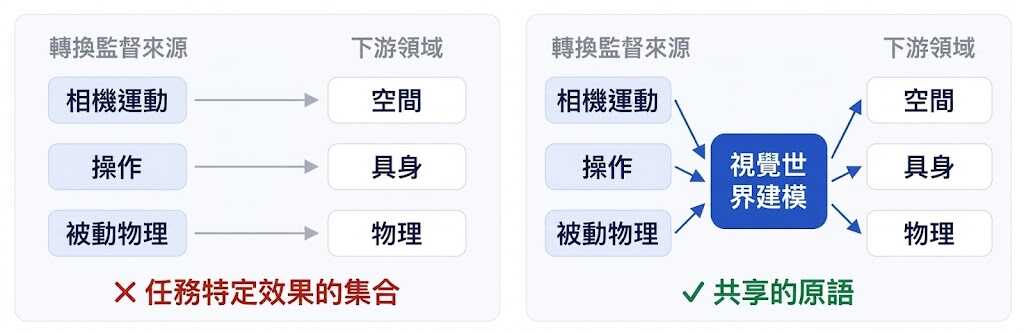
Multimodal LLMs 在空間推理、具身操作、物理常識、時間理解等多個範疇長期被當作獨立問題處理。WOVEN 把這些差距收斂到同一個原語:視覺轉換推理(visual transition reasoning),也就是在狀態—動作—新狀態 (s, a, s′) 中,根據已觀察部分推斷未觀察部分。這個框架既是訓練素材,也是一個評測基準。

WOVEN 內含 36,076 條四選題,覆蓋 20 種場景、5 種動作、8 種推理類型,並用影片生成模型嘅 rollout 構建。研究團隊在 Qwen2.5-VL-3B-Instruct 上以監督微調(SFT)加上 GRPO 訓練,11 個約 2,000 條嘅受控子集分別針對一類動作同推理家族,最終令 26 個外部基準中嘅 22 個出現提升,幅度最高達 27.3 個百分點,呢個幅度令人意外。

WOVEN 嘅分類包含前向動力學、逆向動力學、反事實移除、反事實替換、結果預測、線索預測、時間排序同時間相鄰性八種,並設計咗單因子受控變化、反事實 rollout、錯誤類型誘餌同三類測試集以排除偏差。研究者亦喺不同模型規模同模型家族上做咗複現。WOVEN 將視覺世界建模定義為可重用嘅原語,並非單一任務嘅效果集合。對做視覺推理、具身智能同多模態基準建設嘅團隊,呢套資料同訓練食譜提供咗一個統一切入點。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, Video, 框架

CrossTimeEdit-release:用衛星變化還原歷史街景,補回城市記憶

CrossTimeEdit 把歷史街景生成改成有證據約束的影像編輯,利用新舊街景與衛星變化重建城市過去面貌。

CrossTimeEdit teaser

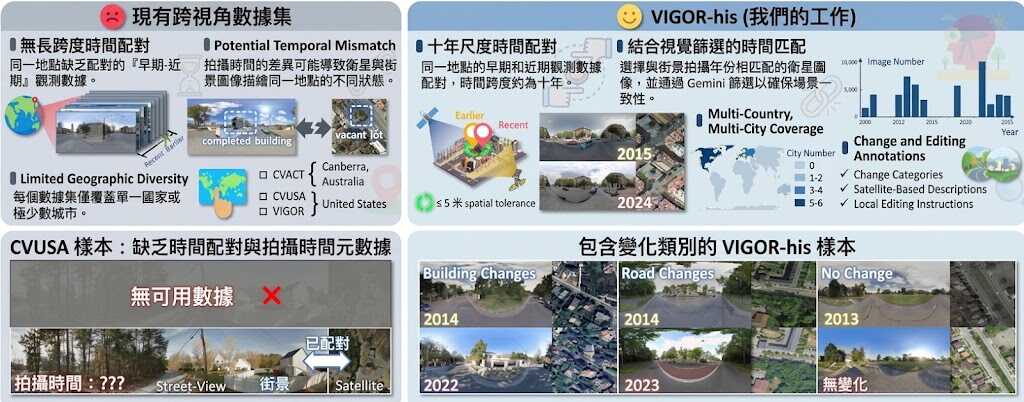
街景資料未必記錄到城市每次改建,CrossTimeEdit 便把近期街景、不同時期的衛星影像和跨視角資訊結合,推算較早期的街道外觀。這個項目屬於視覺生成模型及跨視角資料集,實際處理的是在保留未改變背景的同時,重建建築、道路或其他城市元素的歷史變化。

核心資料集 VIGOR-his 收錄來自三大洲 11 個城市的 43,653 組位置級四元組,配對早期與近期街景、衛星影像,並加入變化分類、衛星變化描述及局部編輯指令。模型以近期街景固定視角和場景內容,再把不同時期的衛星差異當成變化證據,較單純依賴文字提示的生成方式更適合處理具地理關聯的重建工作。

CrossTimeEdit 以 FLUX.2 [Klein] 4B 為起點,先進行 Supervised Fine-Tuning (SFT),再以 Online Reinforcement Learning (RL) 優化。訓練獎勵同時考慮 Instruction Alignment (IA)、Background Preservation (BP) 及 Quality and Physical Plausibility (QP),並透過 Flow-GRPO 與 GDPO 在不同獎勵維度之間作平衡,減少只追求畫面逼真而破壞場景一致性的取捨。

  • VIGOR-his 提供約十年跨度的跨視角城市資料
  • 模型同時保留未變背景及重建指定變化
  • 評估涵蓋指令符合度、背景保留和物理合理性
  • 整體三項編輯指標較預訓練基線提升 17.12%
  • 相比跨視角生成模型,在場景一致性、視覺真實感及感知質素上更佳

城市歷史研究、地理資訊分析、舊城改建記錄和地圖內容補全都可能受益於這套方法,但生成結果仍屬推算,不能取代真實歷史影像。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Stable Diffusion, Image, 庫, LoRA, 強化學習

Page 11 of 59
1 … 9 10 11 12 13 … 59