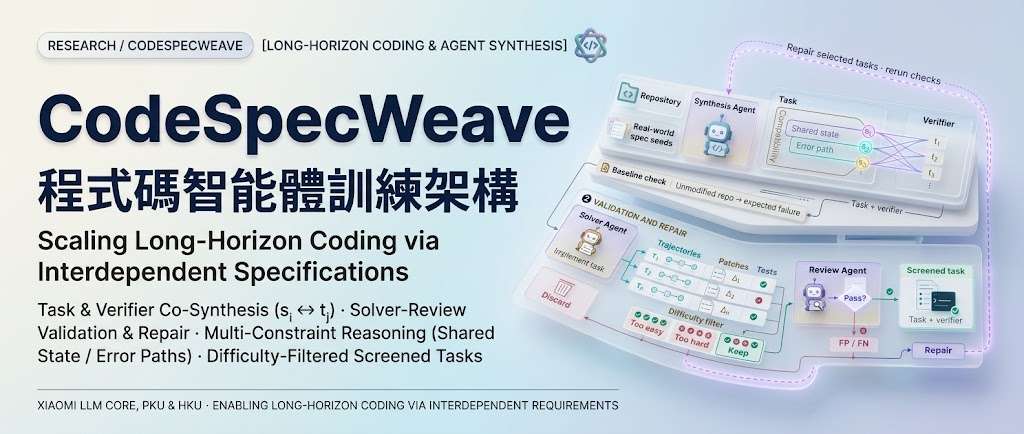
CodeSpecWeave:寫碼容易,了解需求才是關鍵

CodeSpecWeave 將互相影響的軟件要求編織成可執行訓練任務,測試編程代理能否維持整體行為一致。

Paper pipeline: task and verifier synthesis, baseline check, solver trials, difficulty filtering, trajectory review, and repair followed by revalidation.

新增一項功能,可能同時改變狀態、介面、錯誤處理路徑和執行次序。CodeSpecWeave 是一個面向 Computer-use agents 的編程代理訓練與評測項目,處理的正是這類不能逐項解決的長流程編程工作,要求代理在同一份實作中兼顧互相牽動的限制。

項目建立更貼近真實軟體工程的任務,用來訓練與評估 AI 程式開發代理(coding agents)。它不是一般的寫程式工具或線上 IDE,而是一套「產生開發任務、建立驗證測試、訓練及評估 AI」的研究框架。

網站用交易分配功能作例子:AI 不只要依金額比例分配資源,還必須同時確保總量守恆、最低分配額、四捨五入順序穩定,以及保留舊版單一收款人的行為。某一項需求單獨看似做對,整個功能仍可能不符合規格。

CodeSpecWeave 因此刻意讓需求共享狀態、執行路徑及生命週期限制,測試 AI 能不能把整組約束一起處理,而不是只寫出局部正確的程式碼。

  • 將獨立要求連結成 shared decision space
  • 同時檢查功能語意、狀態一致性和介面兼容
  • 以 executable tests 評估跨要求的聯合推理
  • 涵蓋真實 repository 與保留作評測的工程任務

項目主頁

Categories: 北京大學, Agentic, 模型, 模型訓練, World-Action Model, 香港, 軟件, 編程, Dataset 數據集, 小米-Xiaomi

System 1+2:AGI 也要先估互動價值再花算力

多想幾步、多試幾次,都有成本。研究構想讓 AI 先估計哪些互動有價值,再投入資源執行。

Hero image preview

AI 代理搜尋資料、執行程式或讓機械人試走一步,都要付出成本,卻未必帶來有用結果。清華大學團隊提出 System-1/System-2 協同設計構想,希望在執行前先篩選值得投入的互動。

成本較低的 System-1 按預期價值排列互動的優先次序,再由成本較高的 System-2 執行較困難的工作。這個構想把資源分配提前,讓增加推理、訓練或探索次數之前,多一道價值判斷。

它涵蓋的場景包括:

  • 語言模型推理:判斷哪些推理步驟值得繼續投入。
  • AI 代理:篩選搜尋、程式執行及應用程式介面(Application Programming Interface,API)呼叫。
  • 機械人與強化學習(Reinforcement Learning,RL):優先探索可能提供學習訊號的經驗。

對互動成本高、數據取得慢的研究與開發工作,這個構想提供了分配預算的思路。不過,所提供節錄未交代價值預測器的具體實作或量化結果,仍未能判斷它能節省多少成本,以及會否錯過有用的探索。

項目主頁 · Paper

Categories: 清華大學, Agentic, 模型, 模型訓練, API, World-Action Model, Robotic, 框架, 軟件, 編程, AGI, 強化學習

FrameForge「換場景、不換主角」統一三種影像生成

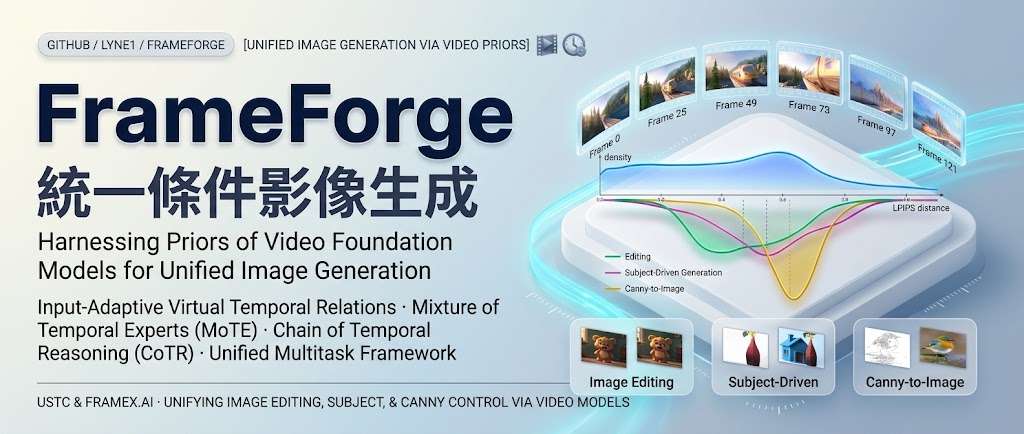
FrameForge 把 HunyuanVideo 1.5 的影片時間帶入影像生成,讓同一套模型處理主體生成、邊緣圖生圖和指令式編輯。

Repository image for Lyne1/FrameForge

同一張參考圖可以用來保留主體、遵循 Canny 邊緣結構,或按照文字指令改變內容,但三種任務對「要保留多少、要改變多少」的要求並不相同。

FrameForge 是一個「給它一張參考圖,再用文字指示生成或修改圖片」的 AI 研究專案。它的特色是借用影片模型理解畫面變化的能力,來處理靜態圖片。

它用同一個模型處理三種工作:

功能 你提供什麼 可以做什麼
參考主體生成 一張人物、動物或物件的參考圖,加上文字描述 保留主體的辨識特徵,重新生成不同場景,例如把同一隻狗放到海灘上
邊緣圖轉圖片 一張 Canny 邊緣圖,也就是描出物件輪廓的線條圖,加上文字描述 依照既有輪廓、姿勢與構圖生成完整圖片
文字指令修圖 原始圖片,加上修改指令 改變動作、加入物件或轉換風格,例如「把貓的動作改成睡覺」,同時盡量保留其餘內容

這三種功能分別適合「保留是誰/是什麼」、「保留畫面結構」以及「修改指定內容」的需求;不是每次都從文字重新生一張毫無關聯的圖。

技術上有兩個重點:
– MoTE:動態選擇不同的虛擬時間間隔,對應不同程度的畫面變化。
– CoTR:加入一個潛在中間狀態,作為原圖轉換到目標圖的中間路徑。

官方已提供推論程式及模型下載方式,環境需要 Linux、Python 3.10 和支援 CUDA 的 GPU;公開流程以 512 × 512 輸入及輸出圖片、50 次去噪步驟運行,部分模型下載也需要先申請存取權。

注意「同一個模型整合三類圖片工作流程」,可作為評估自建圖像生成/編輯服務的 PoC 起點。官網目前提供的是研究結果與部署入口,不能直接視為已具備完整產品能力。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, NVIDIA, Stable Diffusion, Video, Image, 影像模型, Linux, Python, 庫, 中國, LoRA

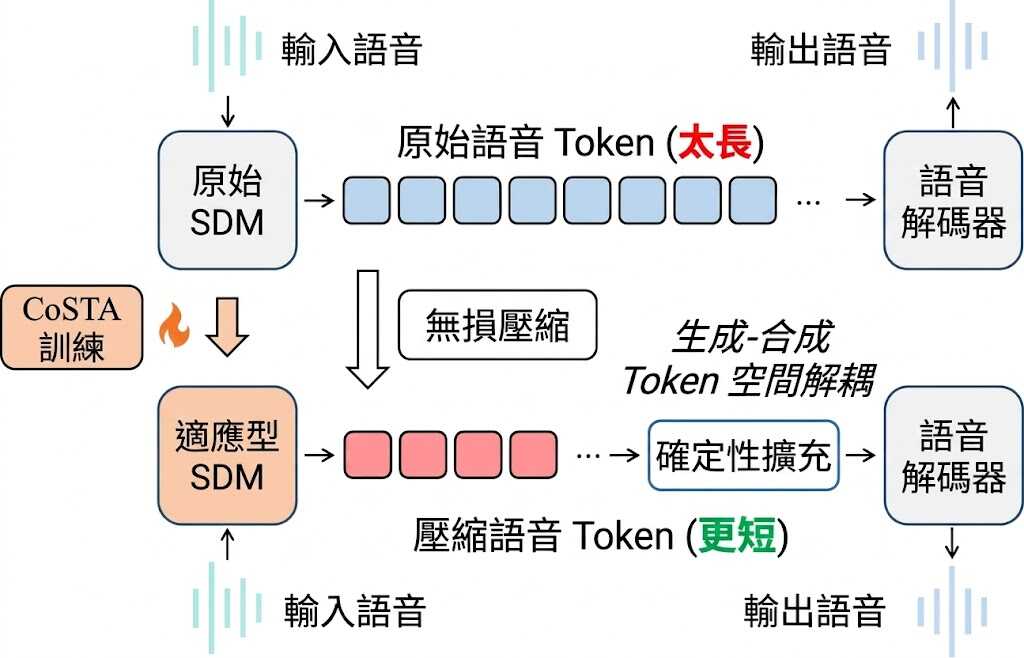
CoSTA:壓縮語音生成序列,提升對話模型推理速度

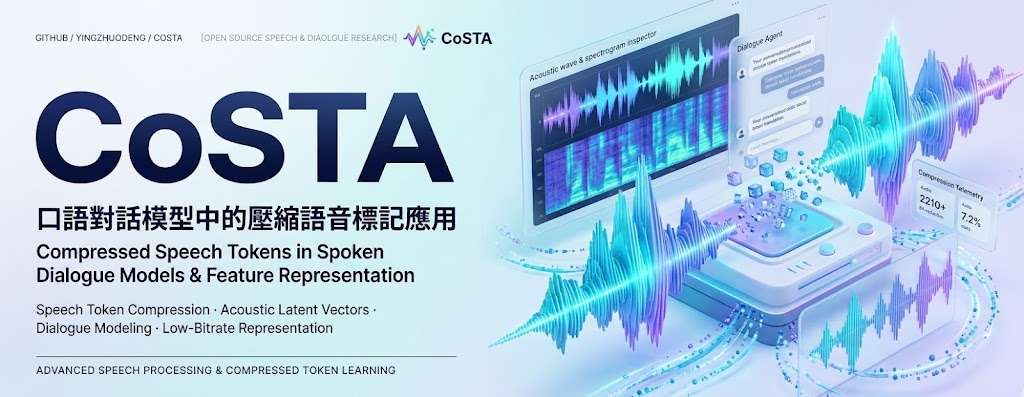
語音對話模型可以先產生較短的語音 token 序列,再還原成原有格式的合成波形。CoSTA 在中英文基準測試中提升生成速度,並保留原有語音 tokenizer 和 decoder。

CoSTA separates compressed speech-token generation from original-token synthesis.

語音對話模型要逐個生成語音 token,序列較長時會拖慢回應。CoSTA 是一套語音模型適配方法,透過壓縮生成序列加快推理,同時保留原有語音 tokenizer 和 decoder,讓壓縮後的 token 可在合成波形前還原。

CoSTA 使用 byte-pair encoding(BPE)學習合併語音 token,並以原有 token 的 embedding 和 LM head 權重平均值初始化新增詞彙。適配分階段進行:先訓練發音,再調整語音對話輸出,讓模型生成交錯的文字與語音內容。它改變的是生成時使用的 token 空間,而非取代負責語音合成的原有元件。

在中英文基準結果中,CoSTA-ZH 的壓縮序列保留原 token 數量的 66.81%,擴展後語音 token 生成速度為每秒 101.99 個;CoSTA-EN 分別為 70.17% 和每秒 99.05 個。兩者相對 Step-Audio 2 mini 的速度為 173.63% 和 165.94%;這些結果反映特定基準測試,不能直接當成所有模型或硬件上的延遲保證。

對已有語音對話模型、希望提高回應速度而不重建語音合成流程的研究團隊,CoSTA 提供了一條可評估的適配路徑。GitHub 提供程式碼與論文連結,但模型權重及資料集仍標示為即將推出,現有資訊亦未列出完整安裝及測試流程。

  • 壓縮自回歸生成用的語音 token 序列,再於合成前確定性還原。
  • 保留原有語音 tokenizer 和 speech decoder。
  • 中英文基準測試均報告高於 Step-Audio 2 mini 的生成速度。
  • 權重與資料集尚未提供,現階段難以直接復現完整流程。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型, 模型訓練, Audio, 語音, Tokenize

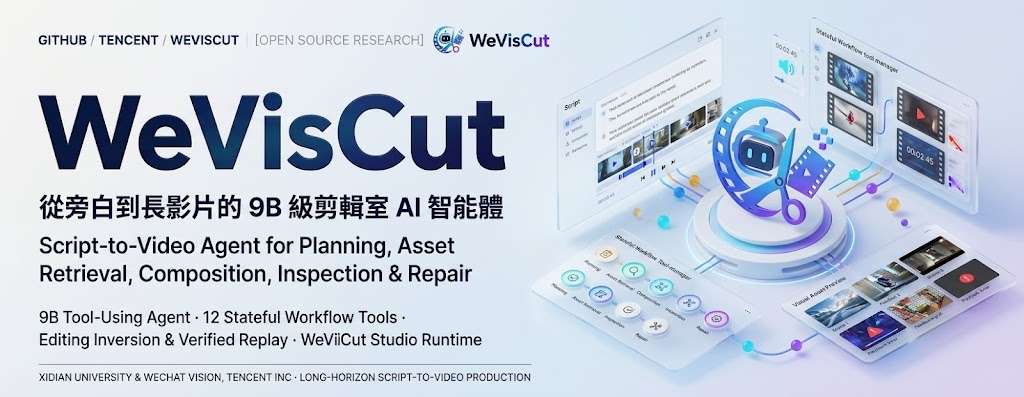
WeVisCut 單一 9B 模型自主剪出多分鐘知識影片

由文章或旁白稿生成多分鐘影片,WeVisCut 讓模型逐步選擇剪輯工具,並可在時間線上修改成片。運行 9B 模型約需 24 GB NVIDIA GPU。

WeVisCut

把知識文章或旁白稿變成多分鐘影片,通常要處理分段、鏡頭、配音、素材、字幕和配樂。WeVisCut 是一個長流程影片剪輯 Agent,由單一 9B 模型讀取剪輯狀態,每次呼叫一項工具,逐步完成製作;它處理的是長篇內容轉成可編輯成片的流程,而非只生成單一畫面或短片段。

模型不依照寫死的階段流程前進,而是按當前狀態決定下一步;防護規則只會拒絕不合法的操作,不會代替模型選擇。每次任務通常約有 12 次工具呼叫,涵蓋文章分段、鏡頭規劃、語音合成、素材檢索、動畫模板、配樂、檢查、修正及合成。檢查與反思本身也是工具,模型可按檢查結果修補未達要求的部分。

Studio 提供八條同步時間軌,成片完成後仍可手動編輯,也支援暫停與續做、聊天修改、單鏡頭重製及版本回退。這讓內容團隊能把它用作長篇解說影片的初剪與修改工作台;成片仍需要人手確認素材、旁白和敘事是否合適。要運行 bf16 9B 模型,項目列出的硬件需求約為 24 GB NVIDIA GPU;只開啟介面、不執行模型則不需 GPU。資料未提供完整安裝及素材服務設定流程,不能只憑這些資訊判定部署所需的全部硬件與外部服務。

評估使用 100 項保留任務,整體分數為 90.5;項目亦報告,每分鐘成功輸出的生成 token 數約比 Claude Opus 5 少 33 倍。這些數字反映項目設定下的測試結果,不足以單獨證明不同影片類型或工作環境都能得到同樣成效。訓練資料則由 3,750 個完成影片項目還原剪輯意圖,再經驗證重播整理出 134,771 個訓練例子;開放的資料建構流程可供研究長流程工具操作的團隊參考。

  • 輸入知識文章或旁白稿,輸出多分鐘剪輯影片。
  • 單一 9B policy 每次呼叫一項工具,按編輯狀態自行規劃後續動作。
  • Studio 保留可編輯時間線,支援逐鏡修改與版本回退。
  • bf16 9B 模型約需 24 GB NVIDIA GPU;純介面模式毋須 GPU。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Video, 工具, 語音, Anthropic, 動畫

WebAnything 把真實網站重建成可重設的測試環境

從網站獲其內容重建互動網站,能在可重設的環境中完成任務。

WebAnything concept logo

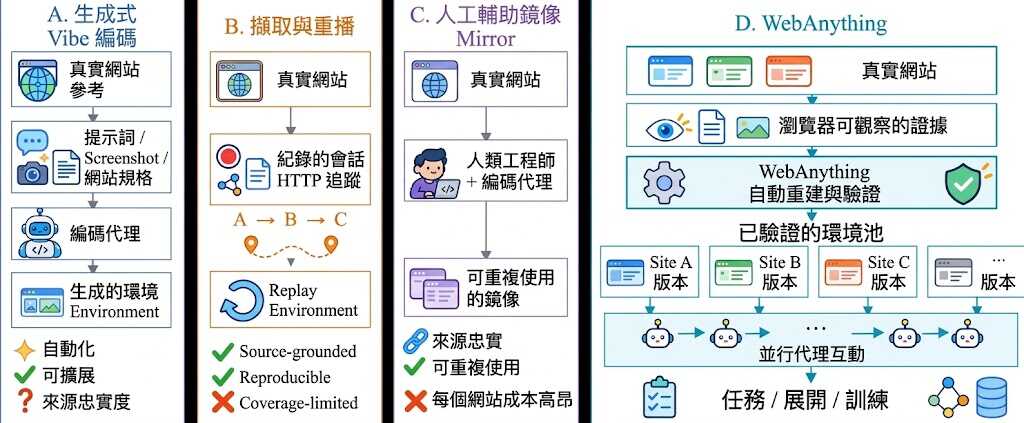
要訓練或評測 Web agent,截取網站畫面並不足夠,代理還要能操作控制項、切換頁面並完成多步任務。WebAnything 是一套研究程式碼,將網站證據轉成可執行、可重設的代理環境,目標是保留任務流程,而不只是重現畫面。

建構流程先由 Builder 透過瀏覽器探索網站,記錄頁面狀態、互動資料、DOM、畫面截圖及網絡資源,再重建環境。候選環境會先凍結,交由 Verifier 獨立檢查;發現實作錯誤或證據不足時,系統會針對問題修正。Full 模式適合追求較廣覆蓋,JIT 則按代理任務需要建構環境,兩者在完整度與建構成本之間作取捨。

項目分析了 6,172 個獲接納的來源任務執行紀錄,平均每個任務使用 10.4 個工具步驟,中位數為 8 步;34.7% 的任務超過 10 步,最長達 89 步。這些數字反映任務包含多步互動,但不能單獨代表重建保真度或代理能力;評估亦分別涵蓋歷史頁面狀態的保真度,以及模型在指定基準測試中的下游效用。

  • 適合研究 Web agent 訓練與評測、需要可重複網站任務環境的團隊。
  • Builder 和 Verifier 使用支援 Responses API 的模型服務;兩者需配置模型 ID、API URL 及 API key。
  • 本機需安裝 Chromium,瀏覽器操作由 Playwright 支援;代理亦需要終端機存取權。README 未列出最低 CPU、記憶體或 GPU 規格,不能據此判定具體硬件門檻。
  • 儲存庫提供建構流程及 244 個歷史網站項目的清單,但網站原始碼與第三方媒體存放在外部 artifact store,並未隨儲存庫附上。

Web agent 提供 Python 套件、命令列工具及設定流程,並可把本機 agent skill 安裝給 Codex 或 Claude Code;這個 skill 不是 MCP server。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 模型訓練, Qwen, API, 工具, Python, 庫, Anthropic, 中國, Dataset 數據集, Skill 技能

VibeGame:把文字變成可試玩的遊戲

輸入遊戲構想後,VibeGame 會協調代理製作、審查及試玩,亦可按後續要求修改;目前聚焦 2D 網頁遊戲。

VibeGame system teaser

把文字構想變成可玩的 2D 網頁遊戲,再逐步修改玩法,是 VibeGame 這套多代理開發系統的工作。它適合遊戲原型製作,並非獨立模型;已開源的實作以 Phaser 為基礎。

Adversarial Agent Team 由統籌代理協調分工,將生成與審查分開,透過靜態審查及端到端執行驗證檢查成果。AI-native game engine 把項目表示為結構化文字,讓代理直接編輯,並以 frame-synchronous control 按自己的節奏逐幀試玩。

  • 支援 Claude Code 或 Codex,至少需要一款代理命令列介面(Command-Line Interface,CLI)。
  • Python 需要 3.12 或以上;未提供完整安裝流程。
  • 未列出處理器、記憶體、顯示卡或顯示記憶體需求,不能據此判定硬件門檻。

training-free self-evolution 會從成功項目提煉可重用骨架、模組及協作約定,累積開發知識而毋須重新訓練模型。示範涵蓋格鬥與地牢遊戲,但未提供量化成功率或效能比較;端到端 3D 製作仍屬待完成項目。

項目主頁 · GitHub

Categories: 開源, 南京大學, Agentic, 模型, 多模態模型, 模型訓練, 3D, Python, Anthropic

OmniShowcase:維持物件形態生成 360°影片運鏡

幾張多角度參考圖,就能引導 Wan2.1 生成沿不同鏡頭路徑移動的物件影片,並盡量保持外觀與立體結構一致。現階段程式碼與資料集尚未公開,硬件需求亦未交代。

Repository image for justin4ai/OmniShowcase

想把一件商品或角色放進不同場景,再沿環繞鏡頭拍成影片,難處是視角轉到參考圖以外時,物件外形容易走樣。OmniShowcase 是一個影片生成模型項目,利用少量多視角圖片生成同一物件的影片,鏡頭路徑涵蓋完整 360° 環繞,目標是維持物件身份與 3D 結構。

它以 Wan2.1 image-to-video 模型為基礎,透過輕量 LoRA 調整生成模型。流程會由四張參考圖重建物件,再渲染成一組表面法線圖作為條件;生成影片時,鏡頭不必逐格對齊這組法線圖,提示詞可指定其他運鏡路徑。這令模型能沿指定路徑生成影片,而不只是重播固定的旋轉角度。

  • Showcase-4K 是合成訓練資料集,涵蓋 12 種鏡頭運動及 88 種路徑配置。
  • ShowcaseBench 是評測資料集,提供影片對應的來源網格與鏡頭參數,方便檢查生成結果。
  • 項目展示環繞、螺旋下降、弧線移動、推近及拉遠等運鏡;目前提供的資訊未列出量化評測分數。
  • 訓練資料、評測集、推理程式碼及訓練程式碼均尚待公開,暫時未能按文件安裝或執行。

這種方法適合商品展示、角色視覺化及需要多角度鏡頭素材的內容製作,也可供研究多視角條件影片生成的團隊參考。代價是生成品質依賴參考圖的 3D 重建與表面法線條件。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Image, 提示詞, 3D, Dataset 數據集, LoRA

Google Genie 4:即時探索與互動世界模型

Genie 4 可按文字或圖像提示生成可探索的 3D 世界,讓研究人員測試 AI 如何在變化中的環境裡理解場景和採取行動。

Hero image preview

輸入一段描述或一張圖像,AI 便能生成可探索的 3D 世界,並隨玩家的操作即時改變場景。Google DeepMind 推出的 Genie 4 是一個世界模型研究項目,目標是建立能模擬環境、回應互動場景,為訓練和研究具身 AI 提供測試空間。

Genie 4: A new generation of world simulation

這類場景並非預先錄製的影片:玩家可以移動和探索,模型則持續生成後續畫面。研究人員可藉此觀察 AI 能否掌握環境的空間關係,並在多種情境中持續採取合適行動;不過,生成結果能否長時間保持一致,仍是世界模型需要面對的挑戰。

Genie 4 延續 Google DeepMind 的 Genie 系列研究。官方介紹聚焦於模型生成互動世界的能力,但未提供足以比較不同模型的完整量化評測,因此不宜單憑展示內容推斷它已能穩定支援所有模擬或訓練工作。

  • 可由文字或圖像提示生成可探索的 3D 世界。
  • 場景會隨玩家輸入即時變化,而非只播放固定影片。
  • 可用於研究 AI 的場景理解與行動能力。
  • 長時間維持世界一致性的能力及量化表現,仍需更多資料評估。

對具身 AI、遊戲環境生成和世界模型研究者而言,Genie 4 提供一種建立互動測試場景的方向;一般使用者則可透過生成世界,直觀感受模型如何把提示轉化為可操作的環境。

項目主頁

Categories: AI productions, 模型, 世界模型, 模型訓練, Google, Video, Image, 3D

Work Agents 將數碼工作拆成可驗證成果

跨應用程式完成工作,不能只看模型答得對不對;Work Agents 把代理流程、能力與可驗證成果放進同一研究脈絡。

Work Agents: Systems, Capabilities, and Optimization

當 AI 要跨應用程式完成多步工作,交付可核實、能供後續使用的成果,比單次答對更重要。Work Agents 是配合調查研究整理的開源閱讀清單,收錄數碼工作代理的系統、訓練、環境、記憶、基準與官方資源,並非可直接安裝的代理軟件。

研究以工作持續性(work persistence)和工作開放性(work openness)描述工作條件,並分成對話(Conversation)、單一步驟(Atomic Action)、多步(Multi-step)、工作流程(Workflow)及工作區(Workspace)五類。它也梳理 foundation models(基礎模型)與 runtime harnesses(執行時框架)的單獨或協同優化,評估則聚焦成果能否符合要求並供下游使用。

你可由 GitHub 清單挑選論文、基準和工具;暫未有可直接執行的代理或統一安裝、測試流程,不能當成部署指南。

  • 整理代理系統、訓練方法、環境與記憶研究
  • 涵蓋五類數碼工作及相關評測資源
  • 比較模型、執行框架及兩者的協同優化
  • 以可驗證、能供下游使用的成果作評估焦點

產品團隊和自動化流程負責人可用它整理能力缺口與評測方法。清單沒有同一環境下的性能數字,具體效果仍要回到各研究與工具核實。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港大學, 香港科技大學, 清華大學, Agentic, 模型, 模型訓練, 框架, 香港, 軟件, 工具, 庫

Page 2 of 38
1 2 3 4 … 38