ComfyUI-Omnichar:用 .char 讓角色跨模型保持一致

ComfyUI-Omnichar 把角色參考圖、描述和 LoRA 收進同一個 .char,方便在圖像與影片模型之間保持人物連貫。

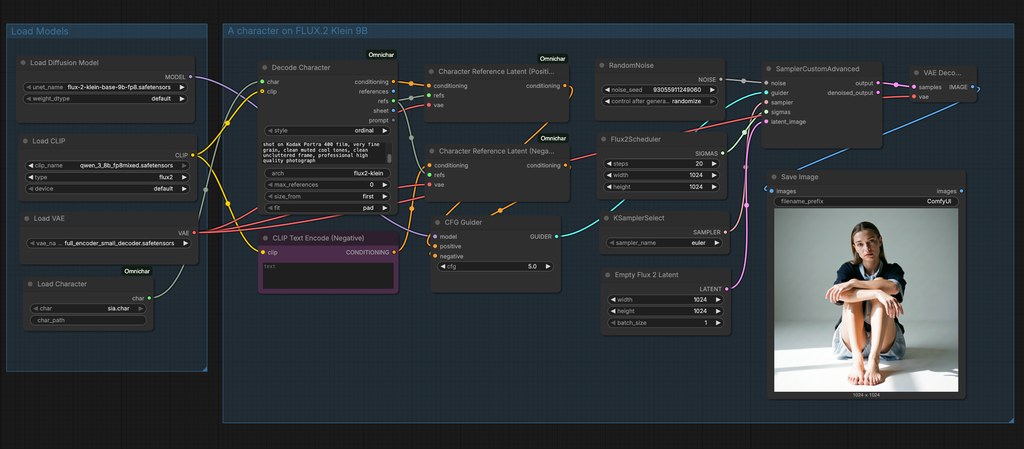
Omnichar nodes in a ComfyUI graph

同一角色要跨圖像與影片模型維持相同面孔、服裝和身形,ComfyUI-Omnichar 以可攜式 .char 檔案處理這個問題。它屬於 ComfyUI 自訂節點工具,讓角色資料不必隨每個工作流程重新整理。

.char 可保存參考圖、鎖定描述,以及可選的訓練 LoRA;檔案可以由 Omnichar Studio、Omnichar Cloud 或 Encode Character 建立,再交給 FLUX.2、MiniMax H3、Krea2、klein9B 及 klein4B 使用。相較於每次手動接入參考圖,這種方式把角色資料、圖片順序和提示詞編號固定下來,代價是工作流程需要配合支援 references 的模型。

  • 透過 Load Character 讀取 .char 檔案
  • Encode Character 可分別加入 face、body 和 cloths 參考圖
  • Decode Character 可輸出 conditioning、references 和 prompt
  • 角色附有 LoRA 時,可同時套用至 MODEL 和 CLIP

安裝需要 ComfyUI、Python 3.10+ 和 omnichar-sdk;.char 檔案放入 ComfyUI/models/characters/ 後,便可由載入節點選取。需要共用 Omnichar Studio 資料夾時,也可設定 INLINE_CHARACTERS_DIR,讓兩邊讀取同一批角色檔案。

生成結果仍會受所選模型、參考圖質素和 GPU 資源影響。對需要製作連續角色插畫、分鏡、短片或多模型內容的創作者,.char 的集中管理會比散落在不同 workflow 的參考圖更容易維護;偏好完全手動控制的人,則未必需要加入這層封裝。
GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, Stable Diffusion, API, Video, Image, 提示詞, 工具, Content Creator, Python, MiniMax, LoRA

Awesome-Video-Generation-Post-Training:影片生成後訓練研究,一個持續更新的索引

影片生成模型的競爭已延伸到後訓練與對齊,這項目把論文、數據集及評測基準集中整理。

timeline

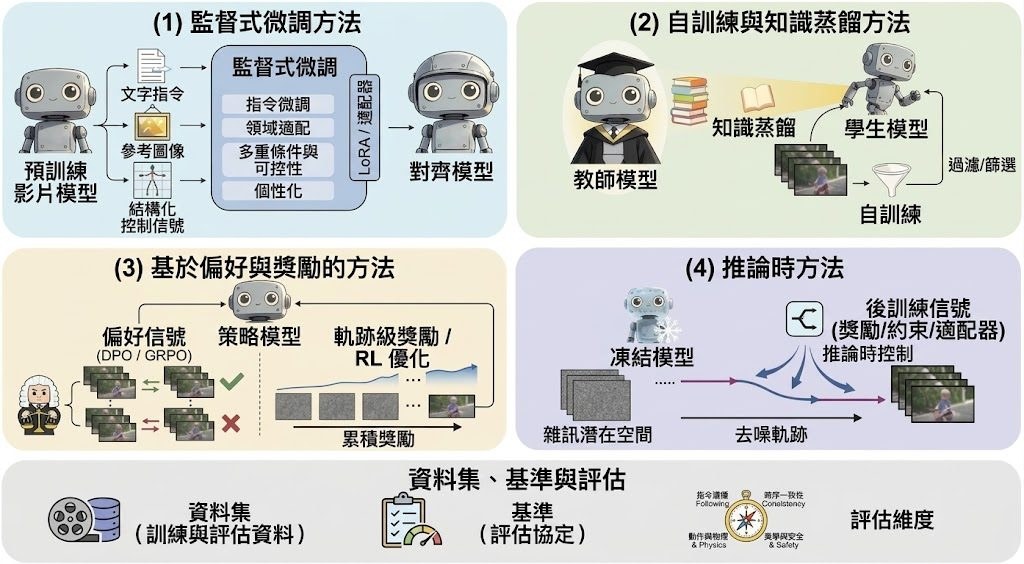
當影片生成模型由「能夠生成」走向「更符合指令、更穩定、更易評估」,研究者需要追蹤的不只是預訓練架構。Awesome-Video-Generation-Post-Training 是一個研究資料整理項目,集中收錄影片生成的 post-training、alignment、相關數據集及 evaluation benchmarks,亦配套一篇 Video Generation Models: A Survey of Post-Training and Alignment 綜述論文。

它不提供可直接執行的生成模型,主要在於縮短研究資料搜尋時間。你可按分類閱讀近期論文、對照不同後訓練方法,再沿着數據集與評測基準追查研究如何衡量影片品質、指令遵從及對齊效果;項目內容會持續更新,亦接受透過 pull request 補充論文、修正資料或建議分類。

  • 資料範圍:聚焦影片生成的 post-training 與 alignment 研究
  • 配套資源:整理相關 datasets 及 evaluation benchmarks
  • 閱讀方式:適合由綜述論文入門,再按分類深入原始研究
  • 參與方式:可提交 pull request,補充或修訂索引內容

對研究生、影片模型開發團隊及需要整理文獻的工程師而言,這項目比零散搜尋更方便建立研究地圖。它的限制亦很清楚:索引本身沒有統一跑分、推理介面或安裝後即可測試的模型,性能判斷仍要返回各篇論文查看實驗設定與指標。

GitHub

Categories: 開源, AI productions, 模型, 視頻模型, 模型訓練, Video, World-Action Model, Dataset 數據集

OneStreamer 讓串流影片懂得記憶與適時回應

影片畫面離開視窗後,OneStreamer 仍可保留具時間線索的證據,並自行判斷何時已有足夠資訊回應問題。

OneStreamer

直播影片一閃即逝,畫面離開模型的視覺視窗後,之後的提問仍可能需要引用那些細節。OneStreamer 屬於串流影片大型語言模型,處理的正是記錄證據、理解新畫面,以及在資料足夠時主動回應之間的取捨。

它以 Qwen3-VL-4B-Instruct 為基礎,OneStreamer-4B 透過 Proactive Hierarchical Caption Memory(PHCM)保存局部細節和已完成事件摘要,再配合近期畫面作答,減少重看歷史影片特徵的需要。Proactive State Transition Learning(PSTL)則保留輸出錨點,挑選具代表性的狀態變化與持續狀態,只有 27.5% 標註狀態 tokens 需要監督。

你可從 Hugging Face 取得 OneStreamer-4B 模型及 OneStreamer-1M 數據集,配合串流影片、問答或字幕資料測試;儲存庫目前提供模型、數據集和示範頁面,但完整推理指令未在提供內容中列出,因此部署前仍需確認執行框架、硬件需求和輸入格式。OneStreamer-1M 合併串流字幕、串流 QA 及整理後的開源資料,共有 1.16M 筆互動記錄。

八項涵蓋線上感知、記憶和主動回應的基準測試中,OneStreamer-4B 在比較方法中取得最高的整體結果;這對需要持續觀看教學、監控或家庭影片的團隊較有參考價值,但生成式記憶仍可能受字幕品質、延遲和錯誤累積影響。

  • PHCM 同時保留局部細節與完成事件摘要
  • PSTL 針對回應時機和重複等待狀態作訓練
  • 模型、數據集及示範頁面均已公開
  • 八項基準測試涵蓋感知、記憶與主動回應
  • 適合研究串流影片理解及長時間上下文的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 南京大學, AI productions, 模型, 視覺模型, 模型訓練, Qwen, Video, 框架, 教學, 庫, Dataset 數據集

AutoGUIWorld:跨平台 GUI Agent 訓練場景及模型

以圖像生成模擬 GUI 狀態轉換,降低建立跨平台對真實軟件環境的依賴。

GUI Agent 要學懂跨平台操作,往往受限於收集資料時能夠安裝和重設的軟件環境。AutoGUIWorld 會生成 Windows、macOS、Ubuntu、Chrome、Android 或 iOS 的 GUI 場景,再由模型規劃點擊、開啟、切換等動作,透過圖像編輯生成每一步的畫面。它屬於面向 Computer-use agents 的資料生成框架,在毋須逐一啟動真實應用程式的情況下,建立有畫面、有動作、有座標標註的訓練軌跡。

AutoGUIWorld 把語意規劃和畫面轉換分開。Meta Planner 先按場景建立任務及動作序列,Voyager 讀取最新的乾淨截圖,描述下一個視覺狀態,再交由獨立的模型 adapter 處理文字、視覺和圖像生成或編輯;grounding backend 則負責找出指向目標的位置。每條軌跡會保留 obs_k.png、帶有目標框的 act_k.png,以及記錄任務、計劃、動作、畫面對應、grounding boxes 和 provenance 的 meta.json,方便日後檢查和重用。

  • 覆蓋 Windows 11、macOS、Ubuntu 24.04、Chrome、Android 和 iOS 場景
  • 技術報告使用的 AutoGUIWorld 訓練集包含 79,266 個 grounded and filtered examples
  • 支援 LocateAnything-3B、MAI-UI 或視覺語言 backend 進行 pointing grounding
  • 固定 random seed 可重現結構化場景,但模型輸出的文字和像素仍可能改變
  • 生成資料不會在真實桌面執行動作,也不會自行驗證任務是否完成

雖然 AutoGUIWorld 以視覺生成換取更快的場景擴展和較低的環境管理成本。代價是生成畫面未必等同真實軟件狀態,圖像模型也可能產生不合理的介面轉換,因此項目提供 scene validity、action alignment 和 transition fidelity 等品質檢查,但不能把這些檢查視為真實執行結果。

目前公開結果集中在資料生成和模型訓練流程。用家可隨時以軌跡微調 Qwen3.5-35B-A3B ,建立合成訓練資料。對只需要真實操作成功率、而且不能接受模擬畫面偏差的工作流程,仍應把真實環境測試放在資料生成之後。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Image, 框架, 軟件, Mac, Linux, Win, Dataset 數據集, UI/UX

DyRAD 讓雷達透過多視覺重建動態駕駛場景

DyRAD 把錄製雷達資料轉成可重新渲染的動態場景,連感測器位置、物件動作和規格變更都能納入測試。

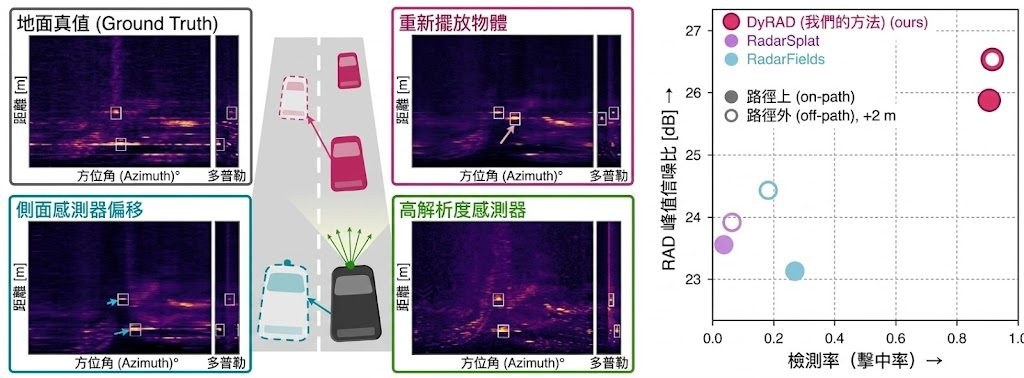
DyRAD re-simulation: from a measured radar frame, DyRAD renders a laterally shifted sensor, a repositioned object and a

由已錄製的雷達、感測器姿態和物件框,DyRAD 可以生成原本沒有記錄過的新視點,甚至模擬車輛橫向移動、物件重新定位或更高解析度的感測器。這個項目屬於開源雷達新視點合成模型,處理的是自動駕駛系統缺乏非原路線觀測資料的問題。

它把靜態背景反射點與跟隨剛體物件軌跡移動的動態反射點分開建模,並用 range–azimuth–Doppler (RAD) 中的 Doppler 速度約束物件追蹤。反射點不會直接吸收雷達訊號擴散,而是經由 point-spread function (PSF) 渲染;PSF 取自 Hamming-FFT 的距離及 Doppler 處理,以及 RADIal 的 beamformer response,令場景幾何與感測器特性分離。

這個取捨令同一個重建場景可以轉移到不同雷達規格,毋須重新擬合,亦較適合閉環測試和感測器配置研究;代價是需要姿態、物件框和雷達校準等資料,Boreas 更只支援 range–azimuth,未能完整利用 Doppler。項目支援 RADIal、Boreas 及具備偏移視點真值的 synthetic benchmark,可按 README 提供的設定訓練、載入 checkpoint,再以 held-out metrics 和重新擬合流程檢查結果。

• 支援完整 RAD tensor,而非只重建距離及方位
• Doppler 同時作為輸出和動態軌跡監督訊號
• 可測試 lateral sensor shift、物件編輯及高解析度感測器
• Project page 指出其 RAD PSNR 和 detection hit rate 高於 RadarSplat、RadarFields
• 適合自動駕駛、雷達感知及模擬資料團隊研究非原路線測試

對需要驗證感知模型在新路線、新感測器或場景變更下表現的團隊,DyRAD 提供比單純錄播更有彈性的資料生成方式。不過結果仍受初始標註、物件軌跡品質、雷達校準和合成視點真值限制,未能取代真實道路測試。

項目主頁 · GitHub

Categories: 開源, 模型訓練, NVIDIA, Dataset 數據集

JEV 以結構化決策加速大規模 AI 資料處理

面對海量合約、日誌或文字資料,JEV 以結構化輸出換取更快速度與較穩定的程式整合。

處理數萬份合約、系統日誌或其他非結構化資料時,逐字生成文字容易帶來延遲、格式錯誤和難以判斷的信心。JEV 是由 TypeSafe AI 開發的 System One Model(系統一模型),透過 API 直接輸出預先定義的結構化決策,針對大規模資料分類與資料抽取而設計。

JEV 不以自由文字作為主要輸出,而是採用 Parallel Sampling(平行採樣)一次產出多項結果,端到端反應時間約為 70 至 500 毫秒。Type-safe 結構可限制欄位、數值範圍和可選項目,減少傳統 Large Language Model (LLM) 常見的解析、重試及幻覺風險;輸出亦會附帶校準後的信心分數。

它採用 RLCD(Reinforcement Learning for Calibrated Decisions,機率校準決策強化學習),讓程式可按信心分數安排自動處理或人工覆核。以併購盡職調查為例,系統可批次分析 50,000 份合約,抽取控制權變更條款、司法管轄區和風險等級,再把低信心結果交由律師檢查。

• 適合批次分類、標籤及結構化資料抽取
• 輸出格式預先定義,方便接入資料流水線
• 可用信心分數設計人機協作分流
• 取捨是它不負責撰寫長篇法律意見書等自由文字內容

JEV 的輸入價格約為每百萬 Token 0.042 美元,輸出 Token 免費;速度、成本和格式穩定性仍需按資料類型及 API 工作量驗證,不能直接視為所有 LLM 工作的替代品。

項目主頁

Categories: 模型, 模型訓練, 工具

Physis-Lang 讓影片模型理解物理因果

影片畫面看似合理,動態卻可能違反物理規律。Physis-Lang 以可演化的物理語言,改善影片資料整理、訓練與生成。

Physis

當影片模型能生成融化中的牛油,卻未必理解升溫、重力與形變之間的關係,Physis-Lang 便嘗試補上這個落差。這個由 NVIDIA、MIT 與 University of Oxford 研究團隊提出的 Video World Model 研究項目,把物理因果、相互作用、支配原理與結果寫進共享語言表示,協助模型生成更合理的世界演化過程。

Physis-Lang 不只描述畫面發生了甚麼,還要求字幕交代事情為何發生。例如牛油融化的描述會進一步指出升高的溫度提供熱力,熱力促成融化,而重力令牛油向下塌成淺層液體。物理概念會經由 Physics-aware critic 找出遺漏或缺乏視覺證據的說法,再由 agent 修訂共同的 captioning guidelines,captioner 本身則維持不變。

整套方法連接資料整理、模型訓練與推理:模型失敗會轉化成物理領域查詢,再透過 language-guided retrieval 找出能補足缺口、而且視覺內容多樣的影片;演化後的語言會重新製作訓練字幕,並擴展 inference prompts,同時加入針對場景的 negative descriptions,減少不合理動態。

  • PhysCapBench 收錄 246 段經審核的物理影片及 3,794 個人工驗證 assertions
  • 評估字幕對物理細節的 precision、recall 與 F1
  • Physis-Lang · Cosmos3-Super 在 Physics-IQ 公開排行榜列第一,平均分數為 48.2 ± 1.4
  • Physis-Lang · Cosmos3-Nano 列第二,平均分數為 43.3 ± 1.5

這項研究適合關注 Video World Models、物理推理和影片生成可靠性的讀者。排行榜結果顯示,加入可演化的物理語言後,Cosmos3 系列模型在相關評測中取得進展,但分數只反映指定基準,並不代表所有影片場景都能避免物理錯誤。

項目主頁

Categories: Agentic, 世界模型, 模型訓練, NVIDIA, Video, 框架

ThinkV2V 讓影片編輯先思考再生成

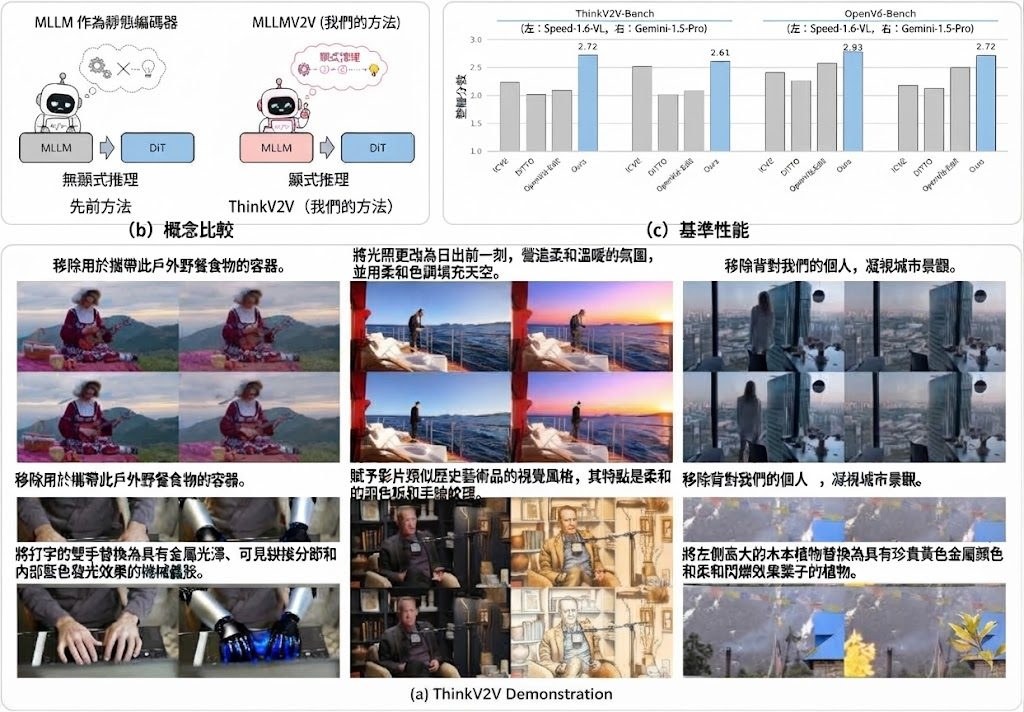
ThinkV2V讓多模態模型先理解影片中的因果與隱含意圖,再交由DiT完成較複雜的指令式影片編輯。

ThinkV2V Overview

面對「按場景關係修改影片」這類指令,單靠文字語意對齊往往不足。ThinkV2V屬於推理導向的影片編輯框架,讓Multimodal Large Language Model(MLLM)先分析來源影片與指令,再把推理結果轉成DiT影片生成器可用的條件訊號,處理物件關係、時間變化及隱含意圖。

MLLM並非只擔任靜態語意編碼器,Qwen3-VL-8B-Thinking負責理解和推理,connector則把相關特徵對齊至DiT條件空間;原始文字嵌入、MLLM隱藏狀態及來源影片的VAE特徵會一同交由ThinkV2V-5B執行編輯。訓練由穩定的基本編輯逐步過渡至高解像度及推理密集案例,推理階段亦會生成多個候選計劃,再由MLLM篩選較可靠的一個。

  • 適合場景:需要根據時間脈絡、物件互動或因果關係修改影片的工作流程。
  • 評估資源:提供ThinkV2V-150K訓練數據集及ThinkV2V-Bench,後者包含308個樣本和5類推理密集編輯,預設支援720p。
  • 執行條件:Python 3.10、CUDA 12.x、PyTorch 2.6.0,並以torchrun或accelerate進行多GPU運算。
  • 資料限制:OpenVE-HQ-1M與ThinkV2V-150K主要是metadata釋出,下載腳本不會一併取得OpenVE-3M影片資料。

項目需要同時準備ThinkV2V、Qwen3-VL-8B-Thinking、Wan2.2-TI2V-5B及Lucy-Edit-Dev等權重,並按儲存庫指定的data與weights結構放置,較適合有CUDA多GPU環境及影片生成經驗的研究團隊。它相較只把MLLM當編碼器的做法,換取更深入的指令理解,但推理、多候選篩選及多模型權重亦會增加顯存、時間和安裝成本;儲存庫提供模型、資料集與基準測試,卻未在提供內容中列出可直接引用的量化領先幅度,不能只憑架構宣稱全面勝過其他影片編輯器。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 字節跳動, AI productions, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, 框架, 香港, Python, 庫, Dataset 數據集

RSIGame:生成遊戲及自行測試與進化

RSIGame 讓 AI 由遊戲構想開始反覆遊玩、找錯和改寫程式,直到品質提升飽和,再保留最佳版本。

RSIGame

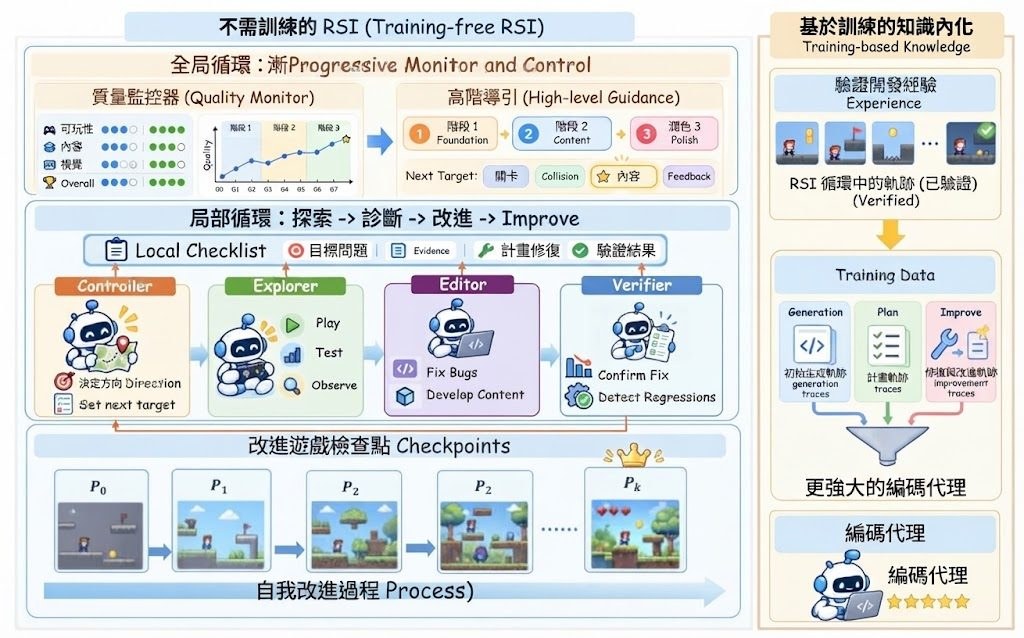
由一句高層遊戲構想開始,系統會自行產生可玩的版本,透過 AI agents 反覆遊玩、檢查問題,再改寫遊戲程式。RSIGame 屬於 autonomous agentic game development framework,實際處理的是生成遊戲難以持續修正、容易只迎合少量測試案例的問題。

RSIGame 把流程分成 local loop 和 global loop:前者執行 explore-diagnose-improve,廣泛探索遊戲、整理問題優先次序,再按證據修改;後者追蹤整體品質、保存最佳 checkpoint,並在長時間開發中識別停滯或回退。測試指引亦會逐步累積,令後續檢查不只依賴原本的提示。

透過 Hugging Face Space 輸入基本遊戲概念或設計方向,查看 agents 如何自動遊玩及產生較高評分版本。GitHub 項目要求 Python >=3.11,並以每次提交執行的測試檢查憑證外洩和內部 import 解析;自行研究或部署時,仍要留意所需模型、遊戲引擎及執行環境未在提供資料中完整列明。

在 140 個 GameCraft-Bench 任務、兩個遊戲引擎及五個生成器的相同開發預算下,RSIGame 持續提升遊戲品質。經驗內化後,Qwen3.8-27B 在 Godot 取得 61.38、在 Phaser 取得 58.53,超過 GPT-5.5 一次生成的分數,同時把 Qwen 的生成 token 減少 11 倍;結果仍屬基準測試,不能直接等同於所有遊戲類型的穩定表現。

  • 由高層構想生成遊戲,再自行遊玩、診斷和修正
  • local loop 負責局部問題,global loop 負責品質與版本選擇
  • 支援 Godot 和 Phaser 等遊戲引擎評估
  • 透過訓練內化成功的開發經驗,減少後續生成成本

RSIGame 適合研究 agentic coding、遊戲生成及長流程自我改進的團隊,也適合作為檢驗 AI 是否能處理多輪程式修正的研究框架。它的代價是流程需要較多執行時間、模型及遊戲環境配合,評分提升亦受測試任務和開發預算影響。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型訓練, Qwen, 框架, Python, 編程

HybridCUA 讓 Agent 懂得何時用命令列

浙江大學、北京大學與清華大學團隊,讓 Computer-use agents 在 GUI 操作與 CLI 指令之間作出選擇,減少冗長點擊流程及連鎖錯誤。

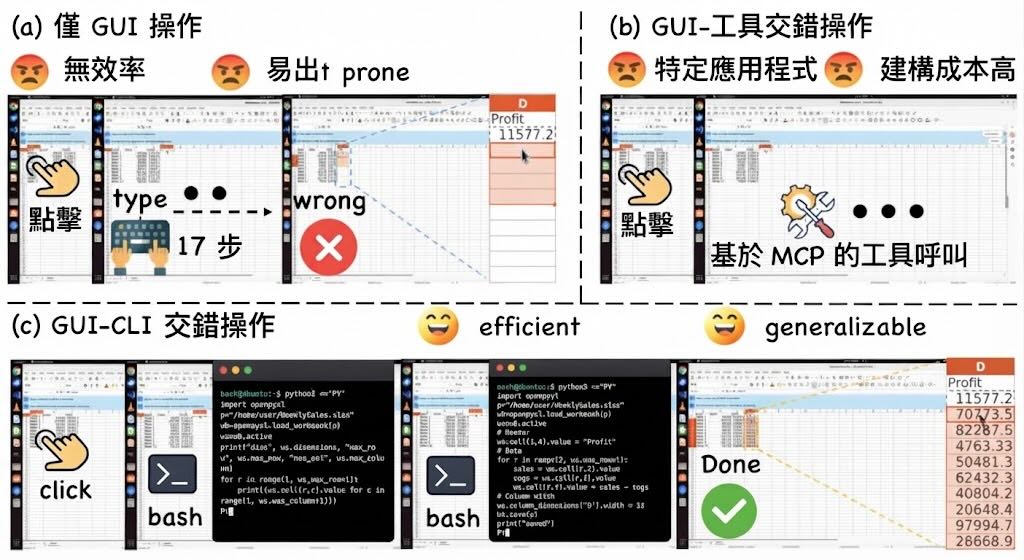
浙江大學、北京大學與清華大學的研究團隊,將 CUA (Computer-use agents) 從單靠滑鼠鍵盤操作,帶到 GUI 與 command line interface(CLI)協作的工作方式。HybridCUA 屬於訓練框架及模型項目,處理的是代理知道可以用 shell 之後,仍未能判斷何時使用、如何使用的問題。

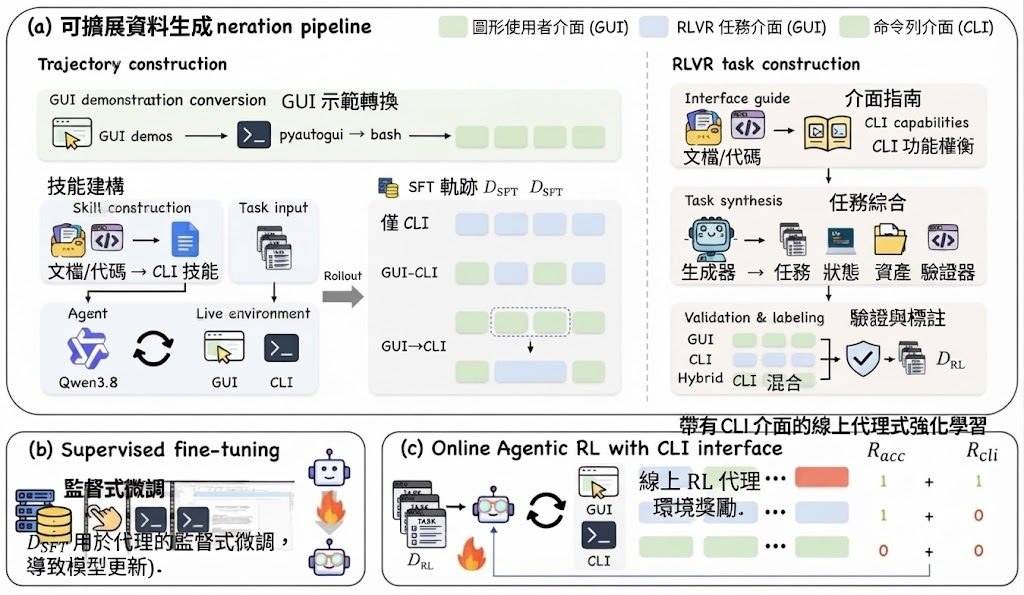
連串的 GUI 操作可以由一條命令取代,但 CLI 暴露給未受訓練的代理,反而令 OSWorld 準確率下降 2.5 至 11.5 個百分點。HybridCUA-8K 收集 GUI only、CLI only,以及交錯使用兩者的軌跡,再配合 supervised fine-tuning 和 CLI-aware rewards,訓練 HybridCUA-9B 選擇較合適的操作方式。

HybridCUA pipeline: (a) scalable generation of GUI-only, CLI-only and interleaved trajectories plus annotated RLVR tasks

• HybridCUA-9B 在 OSWorld 達到 53.6%,較基礎模型高 14.8 個百分點
• 平均每項任務使用 14.0 步,並可轉移至 OSWorld-MCP 及 Windows
• HybridCUA-8K 包含 5K 條混合軌跡及 3K 個已驗證 RLVR 任務
• CLI reward 分為 trajectory level 與 step level,分別鼓勵成功完成及減少失敗指令成本

儲存庫以 env_infra、online-rl 和 site 分開環境平台、GRPO 訓練流程及項目網站;前兩者透過 HTTP 的 /v1/sessions 協作,訓練器毋須自行啟動 VM 或容器。README 提供安裝腳本及 GPU、nvcc、Ray 等環境要求,但模型仍標示為 coming soon,因此目前較適合研究 Computer-use agents、GUI automation 或跨平台代理訓練的團隊閱讀資料集與訓練架構。

結果在 WindowsAgentArena 提升 4.0 個百分點,OSWorld-MCP 達 47.1%,Windows 達 36.0%,顯示 GUI 加 CLI 的方法具備一定跨平台能力;不過項目仍依賴複雜的分散式訓練環境,未提供即時可下載模型,距離一般使用者直接安裝仍有距離。

項目主頁 · GitHub · 模型

Categories: 開源, 北京大學, 清華大學, Agentic, MCP, 模型訓練, 庫, Dataset 數據集

Page 12 of 38
1 … 10 11 12 13 14 … 38