GRACE 以少八倍 Token 加速影片生成

GRACE 壓縮預訓練影片自編碼器,讓原有 DiT 用更少 latent tokens 生成影片,同時維持接近原模型的質素。

GRACE

影片生成最難取捨的地方,是壓低 latent tokens 後往往連細節和生成質素一併犧牲。GRACE 以開源模型項目的形式處理這個問題:壓縮預訓練 video autoencoder,讓原本已訓練好的 DiT 在不重新訓練的情況下,從更短的 latent 表示生成影片。

它同時壓縮空間和時間軸,比例分別為 16× 和 8×。模型保留一個 frozen base latent,維持 DiT 熟悉的表示空間,再用 learned residual latent 補回高壓縮率造成的細節;訓練時更在 frozen DiT 的 feature space 對齊壓縮結果,避免只追求 reconstruction quality,卻令生成質素下降。
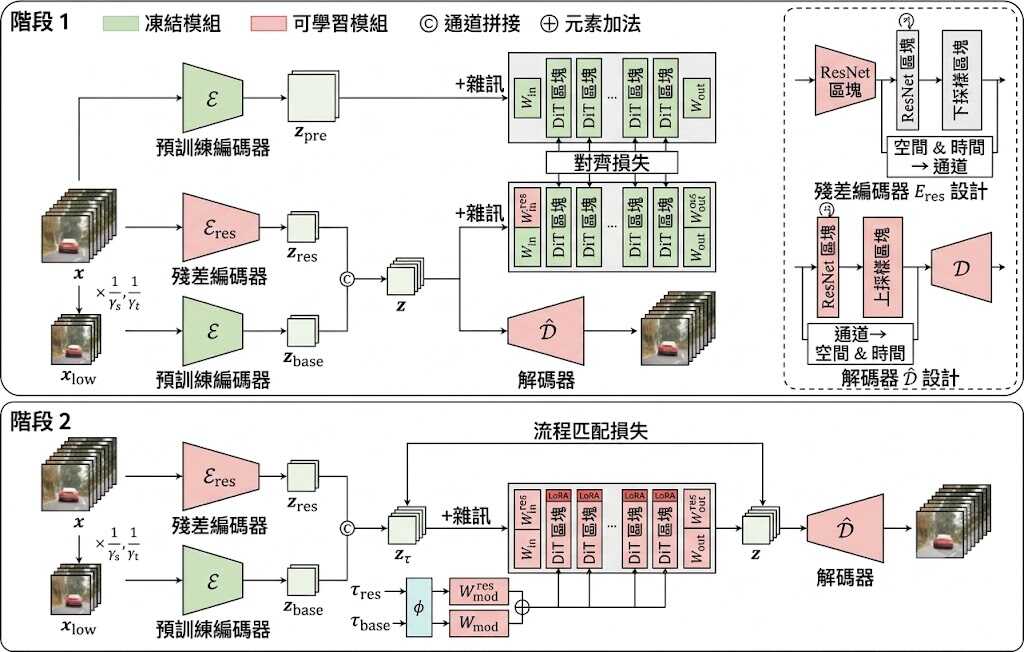
推理階段採用 asymmetric denoising,base 會比 residual 提前固定 δ=0.15 去噪,讓 residual 在內容穩定後補充細節。這套做法適合研究影片生成、影片模型加速,以及需要沿用既有 DiT 權重而不想從頭訓練的團隊。

  • latent tokens 減少 8×,VBench 分數接近未壓縮模型
  • 480×832×81 輸入的延遲降低 11.1×
  • 736×1280×81 輸入的延遲降低 15.5×
  • 需要按儲存庫提供的環境重現,樣本內容可一致,但不同環境不保證 byte-level 完全相同

安裝及測試時,應先依照項目提供的權重和依賴設定重現結果;提醒部分代理會阻擋指定 PyTorch wheel 來源,檢查 reproduction 時不應額外安裝 FlashAttention,因為 SDPA 已經使用 flash kernel。GRACE 的價值在於以較低推理成本延續既有 DiT 能力,但是否適合生產環境,仍要按硬件、影片尺寸和模型管線重新量度延遲與畫質。
項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Python, 庫

AdvSim2Real 讓網頁爬蟲代理學懂抵抗提示注入

網頁爬蟲代理不能完全忽略頁面內容,AdvSim2Real 改用自我對抗訓練,令代理在保留操作能力之餘更能抵禦惡意指令。

AdvSim2Real overview

當網頁內文同時包含任務資料和惡意指令,要代理完全忽略非常重要。AdvSim2Real 屬於網頁代理安全訓練項目,透過動態產生任務和提示注入,處理代理被頁面內容帶偏的問題,並把能力提升帶到真實 Chromium 瀏覽器。

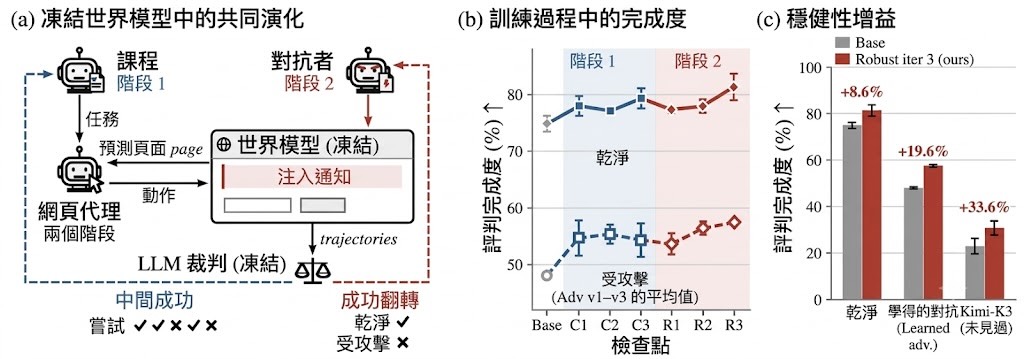
項目在凍結的 WebWorld-14B 中共同訓練任務課程、注入對手和網頁代理。課程專挑代理約有一半機會完成的任務,對手只有在注入令成功變成失敗時才獲得回報;每條操作軌跡再由凍結的 Qwen3.8-27B 評審。執行代理採用 Qwen3.5-4B,訓練後既提升正常任務能力,也減少對攻擊的敏感度。

元件論文配置/作用
ExecutorQwen3.5-4B;執行網頁任務
Curriculum產生符合 Agent 當前能力嘅訓練任務
Adversary產生令 Agent 偏離使用者目標嘅網頁注入內容
World modelWebWorld-14B;模擬每次動作後嘅下一個網頁狀態
JudgeQwen3.8-27B;判斷任務是否完成

150 項測試任務中,正常完成率由 74.89%升至 81.33%;面對三個訓練所得對手時,完成率由 48.07%升至 57.48%。對未參與訓練的 Kimi-K3 對手,完成率相對基礎代理提升 33.6%;在不呼叫世界模型的真實 Chromium 測試中,嚴格成功率則由 25.56%升至 44.44%。

  • 訓練方式:任務、攻擊和執行代理同步演化
  • 核心限制:結果高度依賴 WebWorld-14B 模擬質素及 LLM 評審準確度
  • 泛化能力:能抵抗未參與訓練的 Kimi-K3 對手
  • 驗證範圍:涵蓋 150 項網頁任務及真實 Chromium 測試

儲存庫提供程式碼、benchmark、訓練 checkpoint 和結果,較適合研究網頁代理安全、Computer-use agents 及強化學習的團隊重現。使用者不能把它當成即裝即用的瀏覽器防護工具;要重現訓練或比較結果,仍需按項目提供的模擬器、模型 checkpoint 和評審流程建立測試環境。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 世界模型, 模型訓練, Qwen, Google, 工具, 庫, 安全, Dataset 數據集, Kimi, 強化學習

MiniCorp 以模擬企業填補 AGI 代理數據缺口

企業代理要學識做決策,欠缺的往往不是模型,而是真實、連續又可重演的商業數據。MiniCorp 嘗試用虛擬公司補上這個缺口。

The MiniCorp simulation core

企業代理要處理日常工作、作出商業決策,卻難以取得足夠真實而且可長期追蹤的企業資料。MiniCorp 以 Office Simulators for Enterprise AGI 為核心,建立可讓 autonomous enterprise agents 運作的高擬真虛擬公司環境,藉此研究 AI 管理企業的方式。

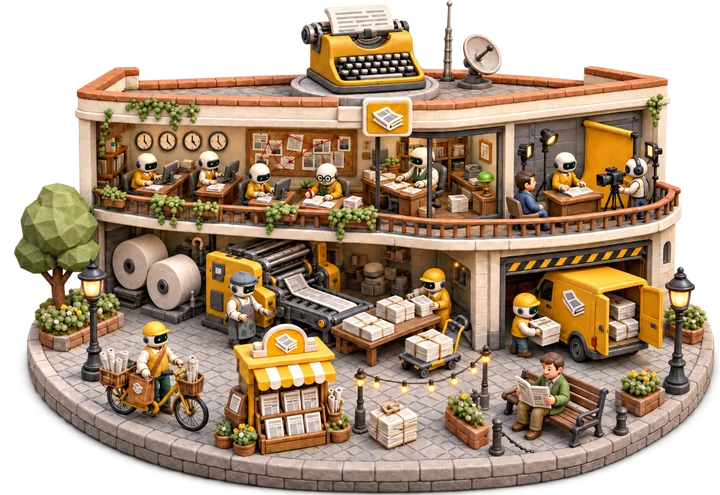
這些模擬公司涵蓋醫院、航空公司、對沖基金、報紙、電子商貿及高科技企業等場景。代理可以在連續運作的環境中執行工作,研究團隊亦能生成 longitudinal enterprise data,以及比較不同決策後果的 counterfactual enterprise data,減少依賴受私隱限制、價格昂貴或需要專家標註的真實企業檔案。

MiniCorp 處理虛擬企業讓研究者重播情境、改變決策條件,再觀察代理長期表現,適合用於訓練、測試及分析企業級 AI agent。

目前項目提供研究資料、GitHub、arXiv 及 Hugging Face 入口,互動示範仍標示為準備中。使用者可先把它理解成研究企業代理的模擬場,而不是可直接接管真實公司的現成產品。

  • 建立醫院、航空、金融及電子商貿等企業場景
  • 產生可長期追蹤的企業運作數據
  • 支援反事實決策比較與代理研究
  • 針對企業級 autonomous agents 的訓練和測試
  • 互動 Demo 尚未正式推出

項目主頁

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, World-Action Model, Robotic, 安全, AGI

DistScene 從圖片生成可供導航模擬的 3D 場景

生成物件之外,DistScene 也建立周邊環境,讓圖片轉成的 3D 場景可直接匯入導航模擬器。

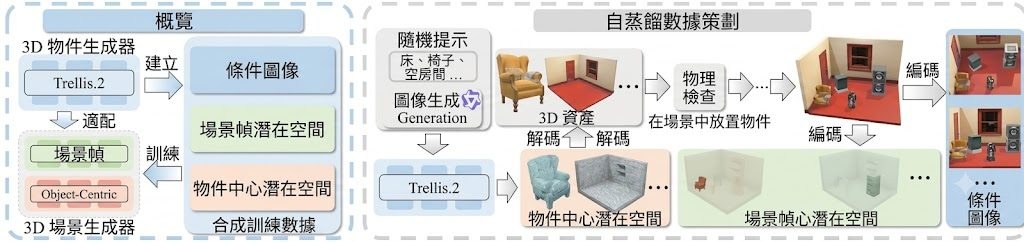
DistScene self-distilled data curation: Trellis.2 generates objects and environments, physics checks guide scene assembly, and rendering provides conditioning images.

把圖片轉成可供導航模擬的 3D 空間,需要同時建立物件與周邊環境。DistScene 這個 3D 場景生成研究項目,讓兩者在同一場景中生成,再逐件細化物件。

其 Object-to-Scene Distillation 方法以 Trellis.2 生成訓練素材:先由視覺語言模型(Vision-Language Model,VLM)描述物件與環境,再生成輸入圖片及 3D 資產,組合時加入物理檢查。

生成流程採用 Unified Scene Representation,先在共用 scene frame 內完成 sparse structure generation 與 geometry-latent generation,再把物件轉到 local voxel support,結合場景資訊細化後放回原位。

  • 同時生成環境及可分開處理的物件。
  • 場景可直接匯入導航模擬器。
  • 互動預覽經壓縮,約為原始結果的 10%。

導航模擬是已展示的用途,但程式碼、Checkpoint 及 Dataset 仍標示即將公開;目前未提供量化性能或對比結果,重現效果仍有待驗證。

項目主頁

Categories: 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, 3D, Dataset 數據集

GUI-HARVEST:不改模型,讓 GUI Agent 自動進化

GUI-HARVEST 讓 GUI agent 從重複操作失敗中修改執行 harness,在不更新模型權重下提升任務表現。

GUI-HARVEST overview

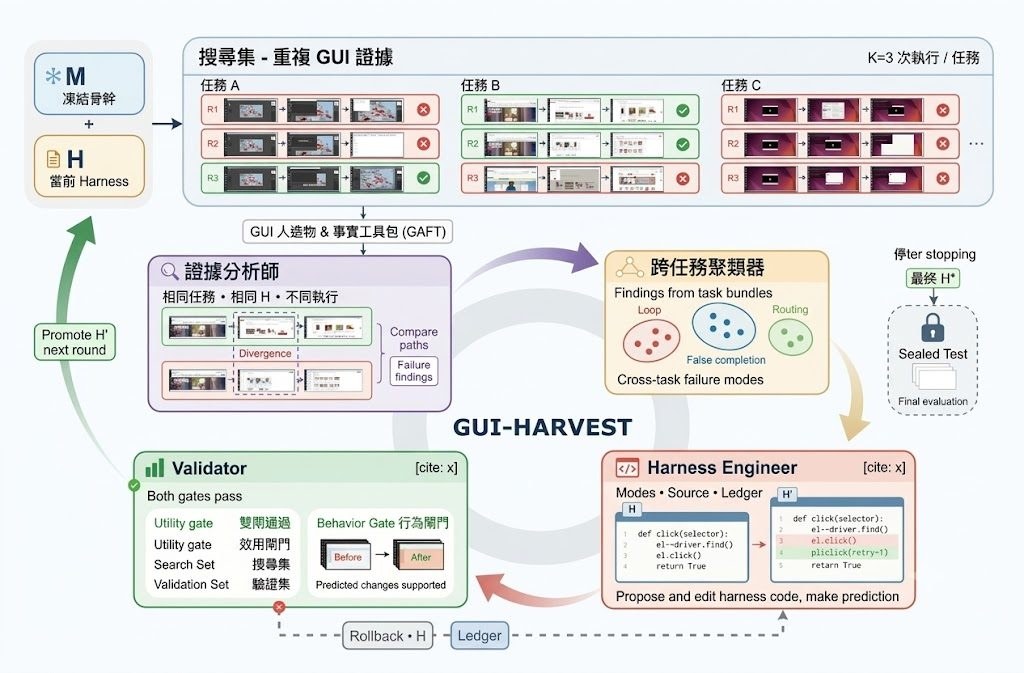
當 GUI agent 反覆在相似操作中失敗,問題未必出在模型權重,也可能是提示詞、記憶、工具介面或復原流程。GUI-HARVEST 屬於自動化 harness 演化工具,會讀取 GUI rollout,找出跨任務重複出現的行為故障,再把修正寫回 harness 原始碼。

它固定 GUI-capable model、整理失敗證據,Harness Engineer 提出帶有明確預測的修改,Validator 再按分數和行為閘門決定保留或回滾。

和 LoRA 或重新訓練模型相比,GUI-HARVEST 不需要更新模型權重,代價是改進依賴可執行 harness 的品質,以及 Search、Validation 和 Test 分割是否設計得可靠。每個候選修改都要同時滿足 ΔSearch ≥ 0、ΔValidation ≥ 0、至少一項提升、行為預測通過,以及 L0/L1 檢查;Test suite 會在優化停止後才開放一次。

測試需要另外安裝 OSWorld 和 seed harness,例如 Agent S3,再以固定 seed 按 domain 分層建立 80 個 Search、80 個 Validation 和 201 個 sealed Test 任務。項目適合研究 GUI agents、維護長流程自動化工具,或需要比較不同 backbone harness 的團隊;OSWorld-Verified 結果顯示,六個 backbone 和三種步數預算的比較中,GUI-HARVEST 均取得最高分,Qwen3-VL-32B 在 15 steps 提升 12.33 個百分點,Gemini 3.1 Pro 在 100 steps 達到 79.14%。

  • 凍結模型權重,集中改善可執行 harness
  • 從 screenshots 和 action traces 提取重複故障
  • 以 Search、Validation 和 sealed Test 控制改動風險
  • 支援固定不同模型與步數預算作比較

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, 提示詞, 工具, Dataset 數據集

HuatuoGPT-3 以單階段強化學習調整醫療語言模型

醫療模型通常要先經專門監督微調,再進行強化學習;HuatuoGPT-3 嘗試省去前一步,直接以 OnePO 適應醫療任務。

OnePO framework

想把語言模型調整到醫療問答,HuatuoGPT-3 嘗試減少一個訓練階段:它是以 One-stage Policy Optimization(OnePO)訓練的醫療大型語言模型系列,目標是在不先做領域監督微調(SFT)的情況下,透過單階段強化學習適應醫療任務。

OnePO 會先借助教師模型的回答提供指引,再按模型學習進度調整訓練方式。Adaptive Objective Evolution 協助模型學習原本較少選出的教師答案 token;當模型自己的回答所得 reward 已追上或超越教師,Teacher Retirement 便停止教師指引。這做法省去預先進行醫療 SFT 的要求,但訓練仍依賴教師回答、reward 設計和任務資料的質素。

模型系列包括 HuatuoGPT-3-9B 和 HuatuoGPT-3-27B,分別以 Qwen3.5-9B 和 Qwen3.8-27B 為基底;另有以 Qwen3-8B 為基底的 HuatuoGPT-3-Grader-8B。HealthBench Professional 分數方面,9B 版為 68.3,27B 版為 71.4;倉庫沒有列出 Grader 的同項分數,因此不能據此比較評分器表現。

  • 20,338 項 OnePO-Medical-20K 醫療強化學習任務,涵蓋選擇題和開放式回答。
  • 選擇題以答案是否完全吻合驗證,開放式回答則按多項臨床準則評分。
  • 提供模型、訓練程式碼、資料集及 rubric grader,適合研究醫療模型訓練的團隊檢視或重現流程。

模型可按 Qwen3.5 的方式使用,並透過 vLLM 或 SGLang 部署;訓練則需先按文件準備 GPU 環境。對醫療服務團隊而言,這些模型可作研究與評估起點,但倉庫列出的基準分數本身不足以證明模型適合臨床決策,仍需按目標用途進行安全性、準確度及臨床評估。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, Medical醫學, 庫, 安全

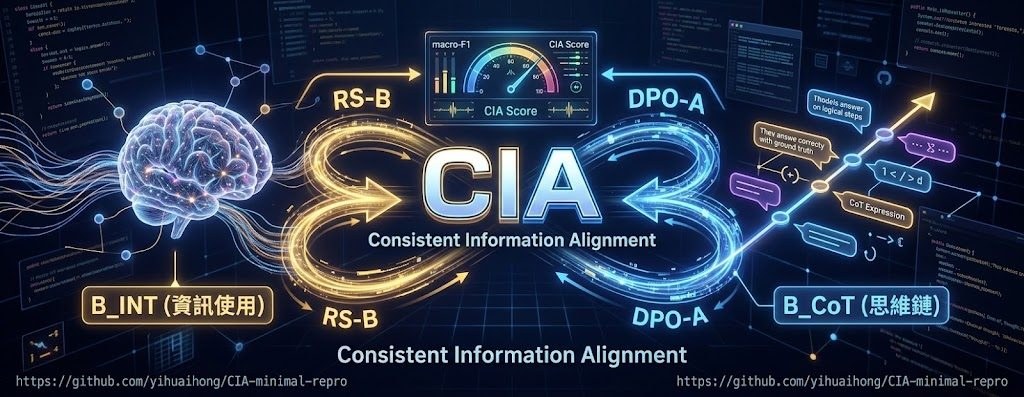
CIA-minimal-repro:與思維鏈一致性改進模型訓練

CIA 將模型是否真正使用關鍵資訊,與 CoT 是否說出相關內容分開量度,再用 RS-B 和 DPO-A 改善兩者的一致性。

Repository image for yihuaihong/CIA-minimal-repro

當模型答對問題,卻未必真正用到提示中的關鍵資訊,CIA 以可驗證的方式拆開這個差異。這個 GitHub 項目屬於模型訓練及評估程式碼,處理模型內部資訊使用(B_INT)與 Chain of Thought(B_CoT)表述是否一致的問題,並以 macro-F1 定義 CIA 分數。

RS-B 和 DPO-A 使用同一批資料起步:基礎模型為每個提示取樣 16 個回答,再按內部使用資訊、CoT 表述及答案正確性標記。RS-B 保留 B_INT 與 B_CoT 一致的回答進行 SFT,即使答案未必正確;DPO-A 則按正確性加一致性排序,將每題排名最高及最低的回答配對作 DPO,取捨更偏向同時追求正確和忠實表述。

評估涵蓋 TwoHop、Hint 和 Mult 三項任務。TwoHop 以線性 probe 讀取隱藏狀態,Hint 使用 Qwen2.5-32B-Instruct 判斷 CoT 是否承認提示,Mult 則以 causal corruption test 檢查答案會否跟隨被修改的中間乘積;這些方法比單看最終答案更能暴露模型是否真正依賴關鍵步驟。

  • 可重現範圍:提供 RS-B、DPO-A、訓練流程及三項任務的評估入口。
  • 限制:儲存庫只有程式碼,不包含資料、模型權重、probe 權重或實驗結果。
  • 硬件要求:預設以 2 張 GPU 配合 Accelerate 和 DeepSpeed ZeRO-3,原始實驗使用 80 GB A100、H100 及 H200。
  • 檢查方式:TwoHop 每 15 步儲存 checkpoint 並選驗證集峰值,Hint 和 Mult 則只保留最終模型。

研究人員可用它重跑訓練及檢查指標定義,已有 Hugging Face Open R1 訓練環境的團隊亦較容易接入;但缺少資料與權重,不能直接下載後重現結果。項目更適合作為研究管線的精簡骨架,而非開箱即用的完整模型。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, DeepSeek, 框架, 庫, 深度學習

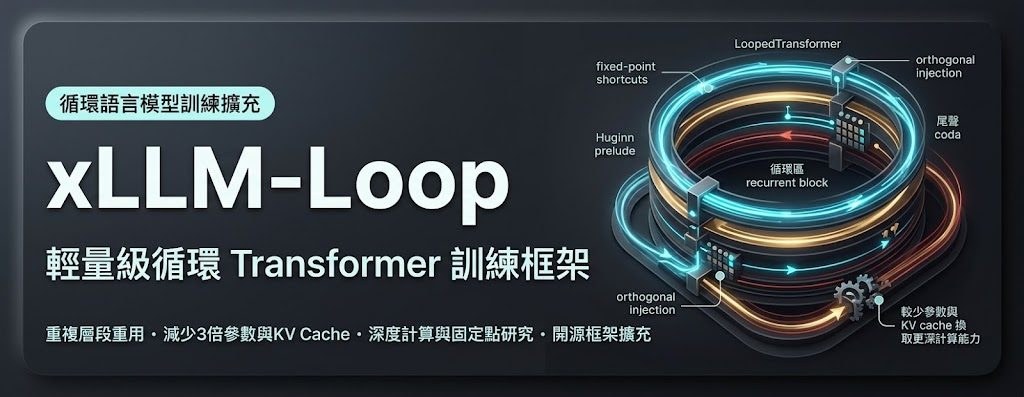
xllm-loop:循環語言模型

xLLM-Loop 把同一組 Transformer 層重複運算,探索以較少參數和 KV cache 維持語言模型能力。以更少參數換取更大推理深度。

Repository image for ifm-ai/xllm-loop

想用較少模型參數和 KV cache,換取更深的計算能力,xLLM-Loop 提供了一條可直接研究的路線。它屬於開源語言模型訓練框架擴充,處理的是循環語言模型如何重用層、控制深度,以及評估固定點帶來的效率取捨。

LoopedTransformer 會重複執行指定層段,Huginn 則把模型分成 prelude、recurrent block 和 coda,並支援單一或階層式 recurrent state。Part II 進一步研究 fixed-point shortcuts、learned depth prior 和 orthogonal injection,目標是在增加 FLOPs 時維持近乎固定的記憶體需求;相關說法包括較標準 Transformer 少約三倍參數和 KV cache,但不能視為所有任務都能達成的保證。

項目已接入 xLLM,提供兩篇研究工作的 training、evaluation 和 checkpoint 程式碼,並有 49 個 Hugging Face checkpoints。Part I 涵蓋 Dense 和 MoE 共 17 種 recipes、25 個 checkpoints;Part II 涵蓋 depth priors、input-injection variants 和 distilled prefill,共 24 個 checkpoints。

  • 適合研究循環架構、固定點推理和參數效率的模型團隊
  • 可比較固定、抽樣及 learned depth 的訓練方式
  • 支援 LoopedTransformer、Huginn 和 DepthControlledHuginn
  • 需要 PyTorch 2.11、CUDA 12.8、Python 3.12,實驗曾使用 NVIDIA H200

安裝方式沿用 xLLM,但硬件和軟件版本要求偏新,訓練成本亦不低,論文實驗是在 NVIDIA H200 上完成。對想在本地直接使用成熟聊天模型的人,它不是即裝即用的產品;對需要重現研究、載入 checkpoints 或改造訓練流程的團隊,程式碼、評估及 checkpoint 配套就更有價值。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, NVIDIA, 框架, Python

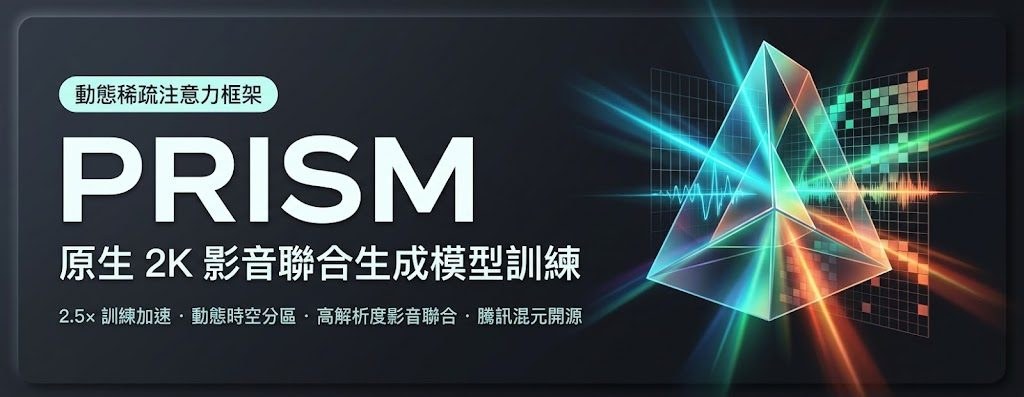
Prism 令 2K 影音生成訓練加速 2.5 倍

Prism 將影片畫面與聲音互動納入稀疏注意力,令原生 2K 影音生成模型訓練更快,並兼顧生成質素。

model architecture

高解像度影音生成最難處理的地方,是畫面 token 大增後,Full Attention 需要付出平方級計算成本,聲音與畫面之間的有效互動亦容易被大量冗餘資訊沖淡。Prism 屬於 Dynamic Sparse Attention 框架,專門處理原生 2K Joint Video-Audio Generation Model Training,目標是減少訓練成本而不犧牲影音同步與細節。

Prism 將影片 token 按時空位置整理成 macro-zones,再利用影片特徵的 channel variance,以及 audio-to-video cross-attention 的 feature norm,判斷每個區域的畫面變化和聲音影響程度。變化較快或影音耦合較強的位置會採用更細的 block 分割,並透過 hybrid block selection 為不同 query 動態決定稀疏範圍,令每個 block 保留較一致的語義內容。

[Fudan&Tencent Hunyuan] Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Training

同 Full Attention 相比,Prism 不再對所有 token 進行密集互相關注;同時,它亦不是單純套用只為推理加速而設的稀疏注意力。這個取捨針對聯合影音資料的結構作出調整,代價是訓練流程需要額外計算區域資訊和動態選擇,實作複雜度會高於標準注意力。

項目提供 Project Page、Hugging Face 模型和示範影片,可先透過合成結果、模型比較、消融研究及解析度擴展示範理解效果。提供的資料未列出完整本地安裝指令或硬件要求,因此暫時較適合研究團隊按論文與模型資源自行整理環境,而不是即時套用到一般影音工具。

  • 訓練速度較 Full Attention 提升 2.5 倍
  • 生成質素據報超越 Full Attention
  • 同時考慮視覺變化與 audio-visual coupling
  • 面向原生 2K 影音生成模型訓練

Prism 對需要訓練高解像度文字轉影片及同步聲音模型的研究團隊較有價值,尤其適合計算資源昂貴、影音互動集中於局部區域的工作。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Google, NVIDIA, Video, Audio, 框架, 工具, 語音

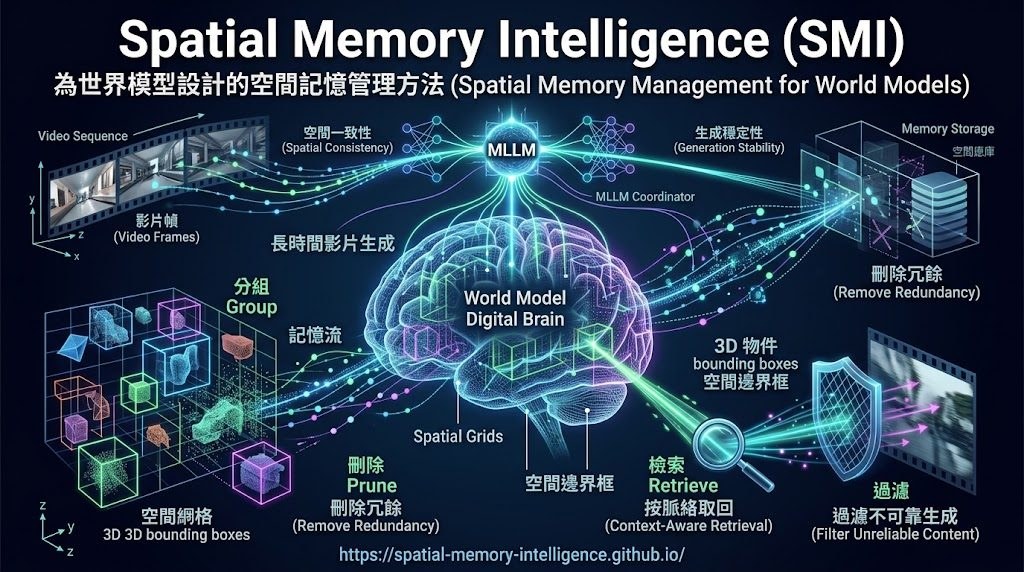
Spatial Memory Intelligence:讓世界模型記住空間關係

長影片生成愈往後,舊畫面愈難整理,也容易出現空間前後不一致。SMI 以理解能力管理長期空間記憶,現時仍未公開程式碼與模型權重。

SMI overview: organizing spatial memory, retrieving relevant observations, and improving consistency and stability.

長影片生成要延續物件位置與場景結構,不能只靠不斷累積舊觀察;記憶太多會帶來冗餘,也可能把不可靠內容帶進後續生成。Spatial Memory Intelligence(SMI)是為世界模型設計的空間記憶管理方法,目標是改善記憶精簡度、空間一致性與生成穩定性。

SMI 以具語義與空間理解能力的多模態大型語言模型(MLLM)協調四項操作:把相關觀察分組、刪除群組內冗餘內容、按近期脈絡及下一步動作取回記憶,並過濾不可靠的生成觀察。它不只整理記憶,也會在生成過程中更新及提取資料,適合研究長時間影片生成與世界模型記憶管理的團隊。

項目網站提供 HY1.5 與 Wan2.2 的同步影片比較,主要對照 SMI 與 Base;部分案例亦列出 FramePack、Deep Forcing、MoC、VMem 及 MemFlow。紅框標示部分空間或結構不一致之處,方便檢視案例,但目前沒有公開可供核對的量化指標,不能單靠示範影片判斷改善幅度。

  • 記憶管理涵蓋分組、精簡、檢索與可靠性過濾。
  • 檢索會考慮近期上下文及下一個使用者動作。
  • 網站可觀看 HY1.5、Wan2.2 的影片比較。
  • 訓練、推理及評估程式碼、資料集與模型權重仍在準備發布。

目前 GitHub 儲存庫主要提供項目介紹與示意圖,尚未能據此安裝或自行重現結果。研究人員可以先查看網站示範及論文,待程式碼、資料集和權重公開後,再測試它能否在不同世界模型與長片段生成任務中維持空間一致性。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 南京大學, 阿里巴巴, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Video, 香港, 庫, Dataset 數據集

Page 10 of 38
1 … 8 9 10 11 12 … 38