τ₀-VLA:為長程機械人任務補上分層推理

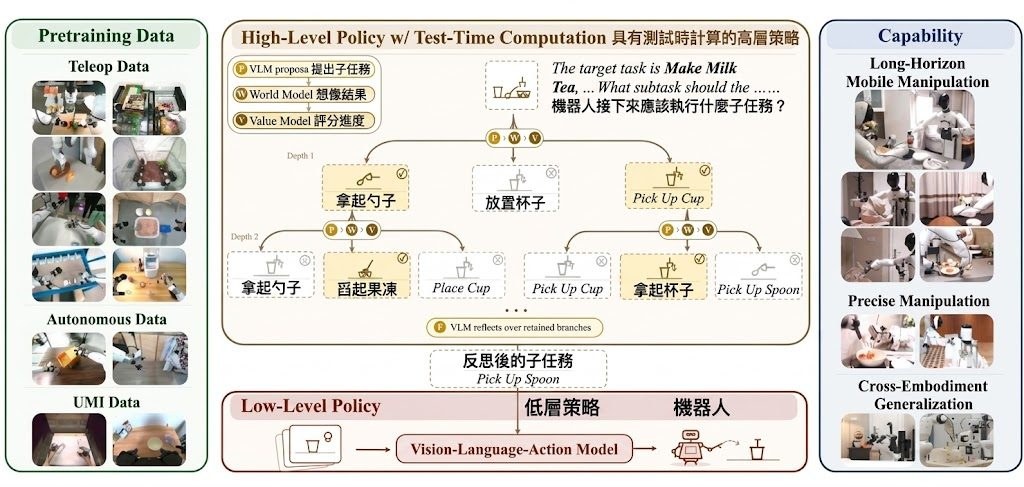
τ₀-VLA 把長程機械人操作拆成高層規劃與低層執行,先想下一步,再落到實際動作。它特別針對多步驟、要記住進度又要回復失誤的場景。

τ₀-VLA overview

τ₀-VLA 是一個機械人基礎模型,主打長程操作任務,例如清理房間、準備食材和沖奶茶這類要連續完成多個步驟的工作。它先用帶記憶的高層策略決定下一個子任務,必要時再用 world-model-guided test-time computation 比較不同做法,然後交由低層策略執行。

這種分層方式比單次前向推理更適合處理長流程,因為模型不只要做動作,還要跟進已完成進度、預測結果,再決定下一步。對需要機械人跨場景操作的團隊來說,比只處理單一步驟的控制模型更接近真實工作流程。

  • 高層負責規劃子任務,低層負責具體控制
  • 會在需要更多推理時做分支搜尋,不是即時拍板
  • 低層策略結合 Qwen3.5 vision-language backbone 與 Mixture-of-Transformers action expert
  • 訓練資料來自 40,115 小時真實機械人數據,涵蓋多模態協同訓練
  • 目前公開 v1 只支援 joint-control checkpoints,EEF serving 未提供

官方提供 Python 3.11、CUDA 12.8、PyTorch 2.7.1 的參考環境,也有 example_data 同配置的 post-training 例子,可用來接入自己的資料集或機械人設定。文中四個長程任務涵蓋 13 至 25 個步驟,重點不只是在動作準確,還包括進度保持、結果驗證和失誤後恢復。

對做機械人研究、具身智能系統,或要把語言理解和實體控制接起來的團隊,這個項目提供了一個較完整的分層基線;限制也很明確,公開版本先集中在 joint-control,較適合有相應訓練與部署條件的環境。
項目主頁 · GitHub · 模型

Categories: 開源, 多模態模型, 模型訓練, Qwen, NVIDIA, VLA, World-Action Model, Python

WithEveryone 多人合照不再撞臉

復旦大學、騰訊混元與香港大學研究團隊,嘗試一次保留五至十個人物身份的群組生成。

WithEveryone teaser

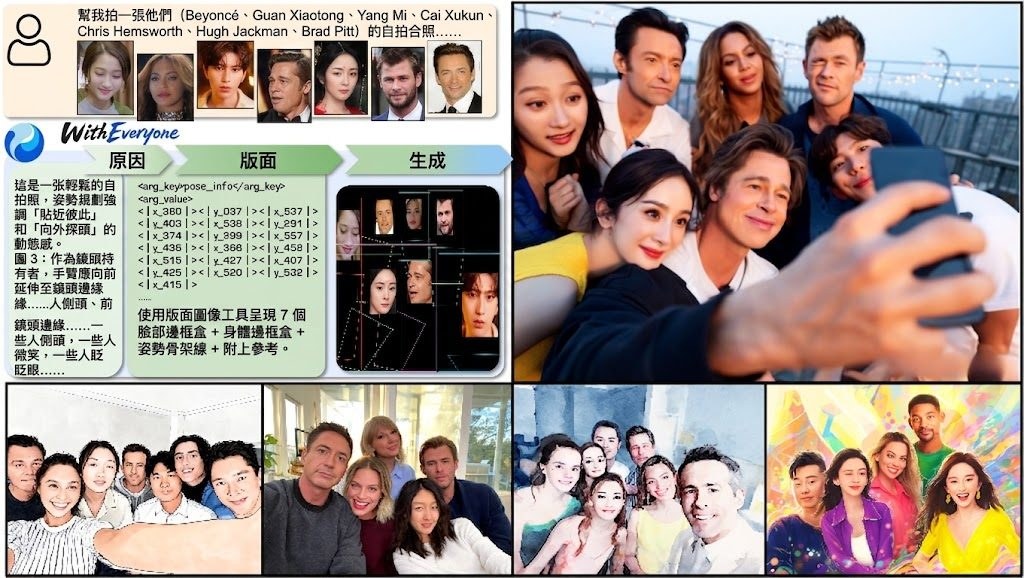
復旦大學、騰訊混元(Hunyuan)及香港大學的研究團隊共同開發 WithEveryone,針對 AI 生成多人合照時人物身份容易混淆的問題,讓五至十個參考身份可以同時出現在連貫場景中。它屬於群組影像生成研究項目,核心價值是維持每個人「誰是誰」的對應關係,而不只是增加畫面人物數量。

系統會把每個參考人物轉換成獨立的 identity token,再透過 Layout CoT 預先推理人物、臉部、身體區域與姿勢的位置,最後交由 renderer 生成視覺條件。Layout-Grounded ID Loss 會在指定臉部區域提供身份監督,ID Representation Forcing 則要求模型在合成前先為每個身份建立預測,減少多人場景中的錯配。

研究展示提供了 63 組生成結果,並在 identity-disjoint benchmark 上比較身份保真度與複製參考圖程度:WithEveryone 的 ArcFace similarity 為 0.614,高於 GPT-Image-2 的 0.566;Copy-paste score 為 0.055,低於 GPT-Image-2 的 0.169。這表示它一方面維持人物特徵,另一方面較少直接照搬參考圖,但目前資料未提供更完整的速度、硬件需求或不同人數下的細分結果。

目前 GitHub 儲存庫尚未提供可下載的研究版 checkpoint,亦沒有完整安裝及測試流程。原因是研究版本依賴的 foundation model 授權不容許公開 checkpoint;團隊正以支援開源發佈的 foundation model 訓練新版本,待程式碼及 checkpoint 準備好後才會分享。

  • 支援五至十個參考身份的群組影像生成
  • 以 identity token 綁定人物,配合身份感知的版面推理
  • 透過 Layout-Grounded ID Loss 監督指定臉部區域
  • 研究結果在 ArcFace similarity 及 Copy-paste score 上勝過 GPT-Image-2
  • 現階段只能閱讀研究展示,未能按儲存庫資料自行安裝重現

對需要製作多人宣傳照、角色群像或指定人物場景的影像研究團隊,這個方法提供了比單純堆疊參考圖更完整的身份與構圖處理思路。一般創作者暫時仍要等待開源版本,因為未公開 checkpoint 令項目現階段更接近研究展示,而不是可即時採用的生成工具。

項目主頁 · GitHub

Categories: 開源, 香港大學, 騰訊, 模型, 多模態模型, Image, 香港, Dataset 數據集

SemComp-Bench:影片生成評測由「似樣」走向真正完成任務

SemComp-Bench 不只看生成影片是否逼真,還檢查指定結果有否完成,以及關鍵語義是否仍然保留。

Repository image for Kelly372/SemComp-Bench

一段影片畫面流暢、物件外觀相近,不代表它真的完成了指令。SemComp-Bench(Benchmarking Semantic Task Completion in Video Generation)把評測焦點放在「結果有否做到」和「是否仍然保留與任務相關的語義」;GitHub 項目則是一套用來建立 SemComp-Data 的資料處理管線,處理影片篩選、狀態定位、指令整理和結果標註。

由原始影片到可評測資料,流程分成 9 個階段:先按標題過濾及分類任務,再定位 reference frame 與 outcome state,檢查畫面質素和狀態順序,產生中英雙語的簡短及詳細指令,最後抽取 outcome-centric clips、標註 semantic alignment types,並描述結果狀態。這種做法把評測所需的參考畫面、指令和完成結果放在同一段真實影片脈絡中,較適合檢查模型是否真的做到指定改變,而不只是產生看似合理的畫面。

項目屬於影片生成評測的資料集建構工具,實際解決的是把零散影片整理成可驗證、可重複評分的任務樣本。SemComp-Bench 目前提供 1,273 個結構化樣本、6 個真實世界領域、60 個 SemComp-Core cases,平均 outcome-centric clip 約 4.03 秒,並配有兩種指令、四類 reference alignment types,以及 27 個評測取樣畫面。

使用者需要 Python 3.10 或更新版本、ffmpeg、ffprobe,以及供第 2 至第 5 和第 7 至第 9 階段使用的 multimodal model service;第 6 階段的 ImageBind inference 建議使用支援 CUDA 的環境。原始影片、模型權重、服務憑證和執行輸出均不隨儲存庫提供,因此較適合研究團隊按自己的影片及模型服務重建資料,而不是下載後即時取得完整數據集。

  • 以 outcome achievement 配合 semantic grounding,避免只用畫質或 prompt alignment 判斷成功
  • 透過 reference frame、outcome state 和短片建立完整評測三元組
  • 1 至 7 階段通常會輸出 snapshot、excluded set,技術失敗另有 error.parquet
  • 可用 tests/ 的離線回歸測試檢查處理流程
  • splitting/ 含改編自 Panda-70M 和 ImageBind 的元件,非商業授權限制需要先審閱

對研究生成影片、製作評測數據,或需要分析任務完成率的團隊而言,這套管線提供了清楚的重建入口;但它依賴外部多模態模型服務和本地媒體資源,資料建立成本與授權審查仍是採用前必須計算的部分。

項目主頁 · GitHub · 數據集

Categories: 開源, 視覺模型, 多模態模型, NVIDIA, Video, Python, Dataset 數據集

moe_vie 視覺編碼器:CLIP 規模 MoE 化,最細版本也貼近 SOTA

Meta 團隊把 Mixture-of-Experts 帶進 CLIP 風格視覺編碼器,用細粒度專家路由配合自訂 Triton kernel,在零樣本分類與檢索上貼近體型大 1.7 倍的 SOTA 編碼器。

Repository image for facebookresearch/moe_vie

視覺編碼器愈變愈大,準確度換來的是推論成本與延遲同時膨脹,特別是高解析度圖片與長影片情境。MoE-ViE 想打破這個取捨:把 Mixture-of-Experts(MoE)機制引入 CLIP 風格的對比預訓練流程,讓模型總容量擴大,但每張圖、每段片只啟用一部分專家,把容量與實際計算脫勾。

與一般 MoE 不同,MoE-ViE 採用細粒度專家拓樸(fine-grained MoE topology),並提出一個無輔助損失(auxiliary-loss-free)的變體來平衡專家負載,避免傳統 MoE 常見的負載不均問題。同時,作者針對 MoE 額外開銷撰寫了專門的 Triton kernel,把推論延遲拉回接近密集模型的水準。

項目以 Vision Transformer 骨幹搭配上述 MoE 設計,配合穩健的對比預訓練流程(contrastive pretraining recipe),一口氣釋出 B / L / H 三個尺寸的模型,覆蓋 224 / 384 / 448px 解析度。在 ImageNet-1k、ObjectNet、COCO 文字檢索圖片、Kinetics-400、MSR-VTT 文字檢索影片等基準上,零樣本表現與各項強 CLIP baseline 相當甚至更佳,其中 H/14 版本在保持約 76% 延遲的情況下,貼近體型大 1.7 倍的 SOTA 編碼器。當對接 LLM 組成視覺語言模型時,MoE-ViE 在圖像與影片基準上亦勝過多個啟用參數多達 5 倍的編碼器。

另一個針對影片能力的處理方式是 frame-level distillation 加上一個新設計的凍結機制,目的是在引入影片理解的同時保留原本學到的圖像知識。這個步驟令同一組視覺編碼器可以同時服務圖像與影片任務,而不必訓練兩套模型。

重點摘要:

  • MoE 化的 CLIP 風格視覺編碼器:以 Mixture-of-Experts Vision Transformer 配合對比預訓練,支援 B / L / H 三種規模。
  • 細粒度專家拓樸 + 無輔助損失平衡:避免傳統 MoE 的專家負載不均,並以自訂 Triton kernel 控制推論延遲。
  • 圖像與影片兼顧:frame-level distillation 配合新凍結機制,讓單一編碼器同時處理圖像與影片理解。
  • 對接 LLM 後仍具競爭力:在多項圖像與影片基準上,表現勝過啟用參數多達 5 倍的既有編碼器。
  • 官方釋出代碼與零樣本評測套件:提供模型定義、配置檔與可重現的零樣本評估流程,惟授權為 CC BY-NC 4.0,需留意非商用限制。

本項目由 Meta 團隊發佈。需要留意的是授權為 CC BY-NC 4.0,僅限非商用場景使用;訓練細節、資料組成與對齊 LLM 的實作屬研究配置,重現成本不低,較適合作研究基準而非即取即用的產品元件。

GitHub · 模型

Categories: 開源, 多模態模型, 模型訓練, Meta

MOSS-VL 多模態模型系列,致力於實時視覺理解。

MOSS-VL 針對直播式影片理解而來,讓模型邊看邊答,不再只靠看完才回應。它同時提供即時、離線與基礎三個版本,適合不同工作流。

MOSS-VL

MOSS-VL 是一組 video-language model,核心解法是把長影片理解從「先看完再回答」改成連續影片流上的即時對話。MOSS-VL-Realtime 會在收到新畫面時同步做感知與文字生成,遇到資訊不足時還會先保持沉默,等場景有變化再回應,這比一般離線影片模型更貼近直播、監控和互動式分析的需要。

項目的三個版本分工清楚:MOSS-VL-Realtime 主打串流互動,MOSS-VL-Instruct 偏向離線長影片理解與深入對話,MOSS-VL-Base 則提供可再訓練的基礎表示。三者都屬於 11B 參數的 open-weight 模型系列,架構上採用 unified cross-attention,重點不是單純堆大,而是把影片、問題和回答放進同一條流裡處理。

  • 支援任意時間點提問,適合直播解析、即時巡檢與互動式看片
  • 會主動等待關鍵事件,再決定是否開口,減少過早下結論
  • 新畫面一到就可修正先前回答,較適合連續變化的場景
  • MOSS-VL-Instruct 適合長影片分析,MOSS-VL-Base 適合延伸訓練
  • 官方資訊有 Hugging Face、ModelScope、Web demo 與論文連結,但原始資料未提供完整本地安裝流程

同類做法多數仍是離線式理解,先把影片看完才輸出答案;MOSS-VL-Realtime 則把回應插進觀看過程,連延遲和中途修正都納入設計。這種取捨對需要即時判讀的團隊更實用,尤其是做影音監察、現場助理、互動式多模態應用,或要在長影片上做持續問答的情境。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, Video

NaviDC-OCR:1.2B 參數文檔 VLM,統一處理相機與數碼文件

NaviDC-OCR 把文件理解收斂到一個輕量 Vision-Language Model(VLM)流程,對掃描件和手機拍攝文件都能一起處理。它的重點不只在識別文字,還在版面、表格與公式之間的結構還原。

icon

NaviDC-OCR 是一個輕量級 Vision-Language Model(VLM),專門處理 document understanding,也就是把文件內容、版面和結構一併讀出來。它最實際的價值,在於同時應付 digital documents 和 camera-captured documents,尤其適合文件拍攝角度不正、透視變形或版面較複雜的情境。

這個項目已釋出模型權重與 technical report,使用方式偏向直接載入 Hugging Face 上的模型做推理或再訓練,而不是一套獨立應用程式。它的訓練流程結合 Multi-node Consensus Voting(MCV)、Image-to-Image Self-Verification,以及 progressive four-stage training,顯示作者把大量標註成本轉移到自動化資料整理與驗證。

  • 1.2B 參數,定位是輕量部署而非堆大模型。
  • 同時面向掃描文件與相機拍攝文件,覆蓋範圍比只做單一路徑的做法更廣。
  • Geometry-aware Document Modeling 與 Curvature-Guided Douglas-Peucker Sampling(CGDP)主要針對彎曲、傾斜和變形頁面。
  • Content-Structure Decoupled Learning 令表格與公式的內容和結構分開學,較適合複雜文件。
  • 作者聲稱在多個 benchmark 上有強表現,但具體部署成本仍要視推理框架與硬件而定。

和不少只偏重 OCR 文字抽取的做法相比,NaviDC-OCR 更像是把「看懂文件」放在第一位:它不只要讀字,還要保留版面關係與幾何資訊。這會令它在企業文件處理、票據整理、表格抽取、學術文件解析,或者手機拍照掃描的工作流裡更有用,但它仍然是研究型模型,落地時要留意速度、記憶體與實際文件分佈是否接近訓練資料。

GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 模型訓練, Qwen, Image, Dataset 數據集

HRM-Text 把基礎模型預訓練門檻壓到千美元級

想自己預訓練文字模型,通常先被算力同數據成本勸退。HRM-Text嘗試把呢道門檻大幅壓低,連完整訓練流程都一併開放。

banner

最值得留意的地方,不是又多一個 1B 級文字模型,而是有人把「由零開始預訓練 foundation model」整理成一個可落地的開源項目。HRM-Text 屬於模型加訓練框架類型,處理的是中小團隊想自建文字生成模型時,算力、數據量同工程門檻都過高的問題。

它採用 Hierarchical Recurrent Model(HRM)架構,並加入 task completion 同 latent space reasoning,重點不是單純追更大參數,而是用 hierarchical recurrent architecture、PrefixLM sequence packing、FlashAttention 3 同 PyTorch FSDP2,把預訓練成本壓到傳統做法的 130 至 600 倍更低算力需求,以及 150 至 900 倍更低數據需求。呢個取捨很鮮明:換來的不是萬能部署環境,而是一條偏向研究與訓練端、對 Hopper-class GPU 仍有明確要求的路線。

部署同測試方式亦算完整。儲存庫已包含 training、checkpointing、evaluation,同 checkpoint 轉成 Hugging Face Transformers 格式的工具,配合 companion 的 data_io 管線準備 tokenized data 後,就可以按單節點或多節點方式開跑;不過 native Transformers 支援要等下一個 release,native vLLM 支援亦仍在進行中,所以現時較適合想重現訓練流程、驗證成本結構,或者研究 HRM 架構本身的團隊。

參考跑分不算保守:0.6B 版本用 8 張 H100、約 50 小時,GSM8k 有 77.6%,MATH 51.2%;1B 版本用 16 張 H100、約 46 小時,GSM8k 提升到 84.7%,MMLU 60.7%,ARC-C 81.9%。呢啲數字未必代表它已經適合所有產品化場景,但足以證明這條路不是紙上談兵,尤其對大學實驗室、國家語言模型計劃,或者想為小語種、自有語料建立 base model 的團隊,有相當現實的吸引力。

  • 把 foundation model 預訓練成本壓到約千美元級,重點在完整流程而不只是一個模型權重
  • 同時提供訓練、評估、checkpoint 轉換工具,方便重現與延伸研究
  • 目前較依賴 H100 等 Hopper-class GPU,部署彈性未算完全成熟
  • 適合研究機構、語言科技團隊,同要自建基礎模型能力的項目
  • 原生 Transformers 與 vLLM 支援仍在補齊,短期內較偏訓練端使用

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 模型訓練, Python, Dataset 數據集

MMDiff 以特徵差分操控多模態模型行為

MMDiff 把文字模型同多模態版本之間嘅差異拆開,找出受視覺訓練改寫嘅特徵,再用嚟削弱或引導模型行為。對做多模態安全、空間推理同 OCR 嘅團隊,佢提供咗一條可解釋又可干預嘅路。

MMDiff

MMDiff(Multimodal Model Diffing)係一套研究型方法,處理嘅問題唔係再訓練模型,而係先睇清楚多模態大型語言模型(Multimodal Large Language Models, MLLMs)入面邊啲特徵因為視覺訓練而改變,再將呢啲特徵移除或引導。對要做審核、除錯、對齊行為嘅團隊,呢種做法比單靠黑盒輸出更實用。

佢嘅核心做法係將基礎語言模型嘅 sparse autoencoder(SAE)同多模態 SAE 對齊比較,再用 contrastive per-token firing 去揀出任務相關特徵。之後可以做 causal removal,或者用 MMDiff-CAA 喺相關層面 steering,直接改變模型喺空間推理、OCR 同安全場景嘅輸出傾向。

項目提供咗對應嘅 SAE checkpoints,亦有針對 LLaVA-MORE、PaliGemma 2 同 InternVL3.5 嘅結果。作者做咗視覺空間理解、多模態安全同 OCR 評測,指出移除單一特徵可令目標能力下降,同時一般 VQA 受影響好細,顯示呢套方法唔係純觀察,而係真係可以做定向控制。

  • 可用嚟定位多模態訓練改寫咗邊啲特徵
  • 可以將特定行為削弱,而唔一定要重訓整個模型
  • 對做 OCR、空間推理、模型安全審查嘅團隊特別有用
  • 測試結果顯示,目標能力下降明顯,一般 VQA 干擾相對細
  • 方法可跨幾個 MLLM 家族轉用,唔只限單一模型

項目主頁 · GitHub · 模型

Categories: 開源, 多模態模型, 微軟

MobileMem 把手機長期記憶放入真實場景測試

手機助手要記住一年的生活,難點不只是搜尋資料,更要理解跨應用、跨模態的長期脈絡。

logo

手機助手若要回答「女兒七歲生日有哪些照片」或核對過敏藥物,單靠短對話記憶很快會失準。MobileMem 屬於端側長期記憶(on-device long-term memory)的評測框架與資料集,將一年手機經歷整理成可重現的測試環境,檢驗記憶系統能否跨應用保留、連結及找回重要資訊。

它涵蓋 365 天、12 個應用程式,以及每位使用者平均 1.72M tokens 的資料規模,來源包括對話、日曆、筆記、瀏覽紀錄和相片等異質內容。與只測單輪問答或獨立文件檢索的做法相比,MobileMem 更接近長期使用情境,但同時令資料整理、隱私處理和推理成本變得更複雜。

資料分為兩條 benchmark track:text 供文字記憶系統處理長期對話與結構化 mobile-app events;omni 則加入 screenshots 和 photos,測試多模態記憶。它本身不是模型,而是用來比較不同 memory systems、分析失敗原因及建立 leaderboard 的測試基礎。

  • 支援文字與多模態兩類測試
  • 涵蓋跨應用、長期且知識密集的 mobile agent trajectories
  • 可從 HuggingFace 下載資料集
  • Dataset Explorer branch 提供互動式資料瀏覽
  • 現有資訊未列出具體模型分數,需查看 leaderboard 或自行重跑測試

研究人員可先下載 HuggingFace 資料集,按 text 或 omni 軌道接入自己的記憶模型,再利用網站和 Dataset Explorer 檢查案例。適合開發 mobile agents、personalized assistant、長期 RAG 或 multimodal memory 的團隊;涉及健康紀錄、家庭相片等私人內容時,仍要自行確認資料授權、匿名化和端側部署要求。

項目主頁 · GitHub

Categories: 開源, Agentic, RAG, 多模態模型, Medical醫學, 中國, Dataset 數據集

RA-Bench 直指危機假影片檢測盲點

危機事件影片最麻煩之處,不是合成得花巧,而是看起來太像真。RA-Bench把檢測器拉回真實傳播場景,專門測試這個落差。

RA-Bench: Can we defend against generated crisis videos?

當一段災難、戰事或公共事故影片本身已有真實事件做錨點,檢測器往往無法只靠內容違和感分辨真偽。RA-Bench屬於影片檢測基準資料集,針對的正是 AI 生成危機影片貼近真實新聞片段後,現有偵測方法還能否守得住。

它的做法有一個關鍵判斷:不再拿脫離情境的合成片去測,而是把真實危機影片與對應生成版本配對,並且涵蓋四個開源與五個閉源生成器。資料規模有 17,886 段影片,當中包括 1,830 段 real anchors、16,056 段生成片,另設 RA-Bench-HumanProof 與 RA-Bench-LastMile,前者收錄連人工審查者都一致誤判為真的 633 段影片,後者再測試影片經過連續傳播處理後,檢測器會否失準。

這個項目把「像真」、「會誤導人」、「經社交傳播後失真」三件事放在同一套測試裡。相對於只看配對樣本的資料集,它多了一層來源泛化與傳播鏈穩健性的要求;代價是資料權限較複雜,完整版本有部分 real anchors 只提供原始 URL,未必人人都能直接重跑 full 軌道。

  • public-media 只評估可重新分發的真實錨點配對,較適合公開重現與初步比較
  • full 依照完整論文清單評估,也要求處理只提供 URL 的真實來源
  • Hugging Face 釋出公開媒體約 93.8 GB,生成影片完整提供,真實素材則經權利審核後部分保留來源連結
  • 評估採用 source-matched evaluation,會把每個生成來源放回其對應真實錨點脈絡判斷

對做影片鑑識、內容審核、新聞驗證與多模態安全研究的團隊,RA-Bench的價值很直接:它不是教模型辨認「很像假片的假片」,而是逼它面對會在人類審查與傳播流程中混過去的片段。限制也同樣清楚,這仍是 benchmark,不是現成檢測器;要得出可比較結果,仍要先準備預測輸出、下載資料,並處理部分真實來源無法重分發的存取條件。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 多模態模型, OpenAI, Video, Dataset 數據集

Page 5 of 23
1 3 4 5 6 7 23