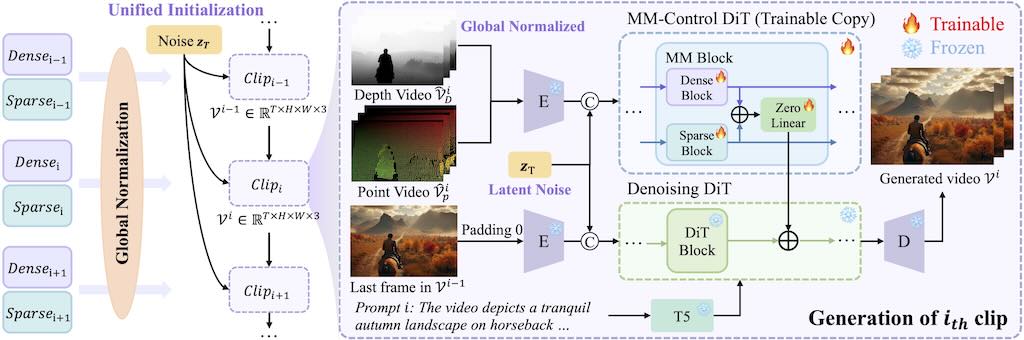
可控的超長影片生成是一項基礎但具有挑戰性的任務,因為現有的方法雖然對短片段有效,但由於時間不一致和視覺品質下降等問題而難以擴展。
LongVie 2 的核心設計可確保時間一致性:
1)統一雜訊初始化策略,在各個片段之間保持一致的生成;
2)全域控制訊號歸一化,可在整個視訊的控制空間中強制對齊。為了減輕視覺品質下降,LongVie 2 採用密集(例如深度圖)和稀疏(例如關鍵點)控制訊號,並輔以一種退化感知訓練策略,可以自適應地平衡模態貢獻以保持視覺品質。

可控的超長影片生成是一項基礎但具有挑戰性的任務,因為現有的方法雖然對短片段有效,但由於時間不一致和視覺品質下降等問題而難以擴展。 LongVie 2 的核心設計可確保時間一致性:1)統一雜訊初始化策略,在各個片段之間保持一致的生成;2)全域控制訊號歸一化,可在整個視訊的控制空間中強制對齊。為了減輕視覺品質下降,LongVie 2 採用密集(例如深度圖)和稀疏(例如關鍵點)控制訊號,並輔以一種退化感知訓練策略,可以自適應地平衡模態貢獻以保持視覺品質。
「Qwen3-VL-Embedding-2B」是 Qwen 家族中最新的多模態信息檢索和交叉模態理解模型。可在同一向量空間做相似度計算,方便做「跨模態檢索」與「圖文混合檢索」。 Embedding 維度可控:預設最高 2048 維,但支援使用者自訂輸出維度 64–2048,可依儲存成本與下游模型需求調整(例如 256/512 維用於向量 DB)。 模型規模與 context length:2B 參數,context 長度 32k,適合放在邊緣或低資源伺服器上,同時能處理長文檔、多 frame 影片描述等輸入。
「Qwen3-VL-Embedding-2B」是 Qwen 家族中最新的多模態信息檢索和交叉模態理解模型。可在同一向量空間做相似度計算,方便做「跨模態檢索」與「圖文混合檢索」。
Embedding 維度可控:預設最高 2048 維,但支援使用者自訂輸出維度 64–2048,可依儲存成本與下游模型需求調整(例如 256/512 維用於向量 DB)。
模型規模與 context length:2B 參數,context 長度 32k,適合放在邊緣或低資源伺服器上,同時能處理長文檔、多 frame 影片描述等輸入。
| 模型 | Gemini Multimodal Embeddings | Qwen3-VL-Embedding (2B/8B) |
|---|---|---|
| 模態支援 | 文字、圖片、video(含 audio 軌道,1 FPS + 音頻特徵) | 文字、圖片、截圖、video(多 frame),混合任意組合 |
| 語言 | 多語(英文主導) | 30+ 語言,強中文/多語對齊 |
| 維度 | 固定 1408 | 可自訂 64–4096(預設 2048) |
| Context | Video 上限 1-3 小時 | 32K tokens(長影片多 frame) |
| 開源 | 否(API) | 是(HF/GitHub,Apache 2.0) |
| 成本 | $0.0001/1000 chars(text),更高 video/image | 免費本地,GPU 硬體成本 |
| 整合 | Vertex AI / Gemini API,易 scale | Transformers/vLLM,量化友好 |
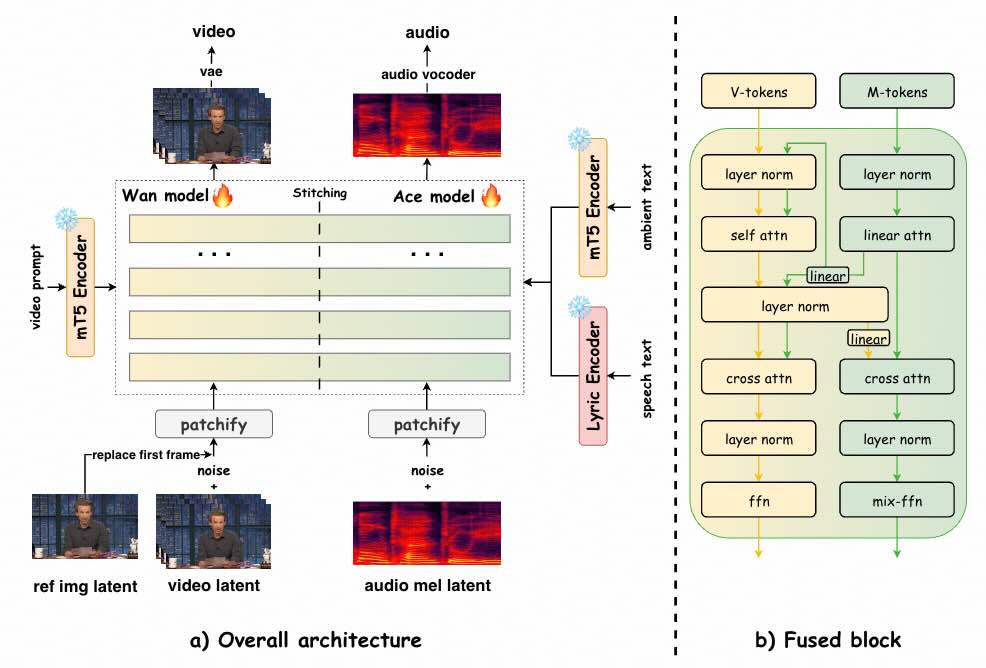
UniVerse-1 是個類似 Veo-3 的模型,可根據參考圖像和文字提示同時產生同步音訊和視訊。

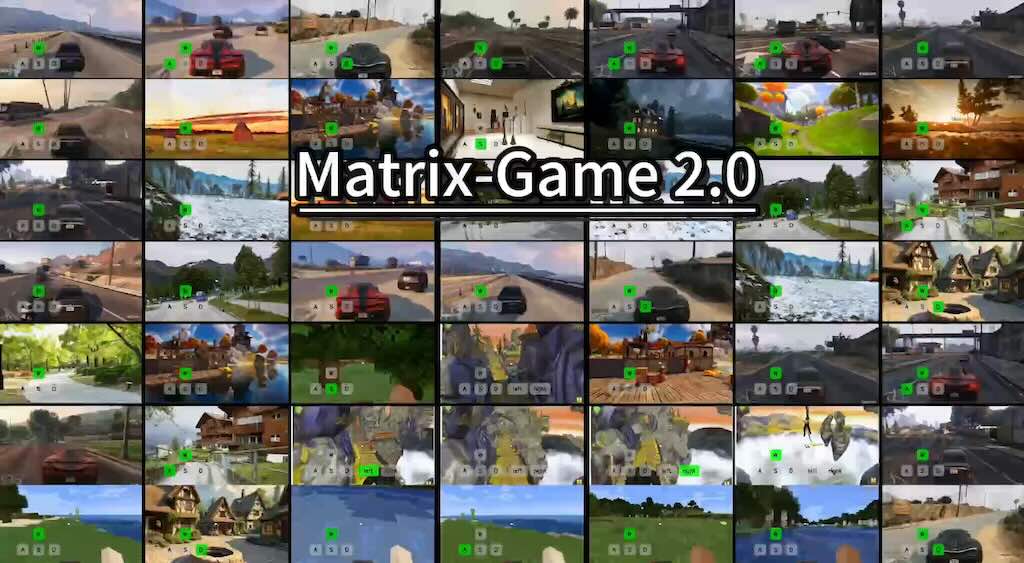
Matrix-Game 2.0 是一套高效、強大的互動世界生成系統,專注於視覺與行動融合,能夠在多種遊戲場景下生成高質量、流暢並可交互的視頻內容,領先於現有主流方案,適合用於前沿AI遊戲和虛擬世界研究。主要由Skywork AI團隊開發。

影片主要介紹如何使用 Ostris AI 開發的 AI Toolkit,在僅有 24 GB VRAM 的 RTX 4090 或 3090 GPU 上,訓練一個基於 Qwen-Image 模型的 LoRA(Low-Rank Adaptation)風格模型。Qwen-Image 是一個 20 億參數的巨型模型,通常需要更高規格的硬體(如 32 GB VRAM 的 RTX 5090),但作者透過創新技術(如量化與 Accuracy Recovery Adapter)實現了在消費級 GPU 上的訓練。影片強調這是對先前影片的延續,先前影片曾在 5090 上使用 6-bit 量化訓練角色 LoRA,而本次聚焦於更常見的 24 GB VRAM 硬體。
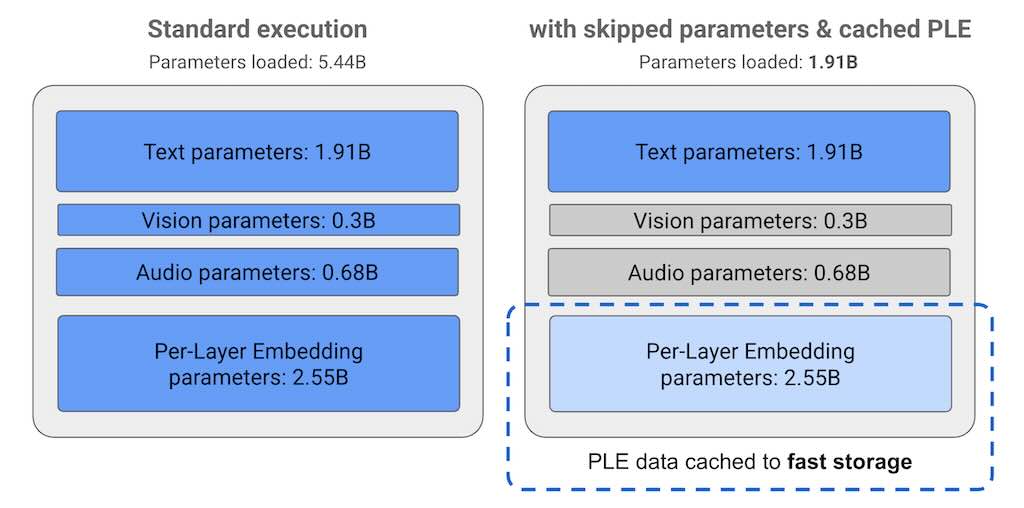
Gemma 3n 是一款開源生成式 AI 模型,針對手機、筆記型電腦和平板電腦等日常設備進行了最佳化。包括逐層嵌入 (PLE) 參數快取和 MatFormer 模型架構,可靈活降低運算和記憶體需求。模型同時具備音訊輸入處理、文字和視覺資料處理等功能。 Gemma 3n 模型的參數在 E2B 模型的標準執行過程中,執行模型時會載入超過 50 億個參數。然而,使用參數跳過和 PLE 快取技術,該模型可以在有效記憶體負載略低於 20 億(19.1 億)個參數的情況下運行。Huggingface 下載
Gemma 3n 是一款開源生成式 AI 模型,針對手機、筆記型電腦和平板電腦等日常設備進行了最佳化。包括逐層嵌入 (PLE) 參數快取和 MatFormer 模型架構,可靈活降低運算和記憶體需求。模型同時具備音訊輸入處理、文字和視覺資料處理等功能。

Gemma 3n 模型的參數在 E2B 模型的標準執行過程中,執行模型時會載入超過 50 億個參數。然而,使用參數跳過和 PLE 快取技術,該模型可以在有效記憶體負載略低於 20 億(19.1 億)個參數的情況下運行。Huggingface 下載
LTX-Video 是第一個基於 DiT 的視訊生成模型,可以即時產生高品質的視訊。它可以以 1216×704 的分辨率生成 30 FPS 的視頻,比觀看這些視頻的速度還快。該模型在多樣化影片的大規模資料集上進行訓練,可以產生具有逼真和多樣化內容的高解析度影片。模型支援文字轉圖像、圖像轉影片、基於關鍵影格的動畫、影片擴充(正向和反向)、影片轉影片以及這些功能的任意組合。


Skywork 是一個創新的研究團隊,致力於推動 LLM 和多模式理解。它們的使命是透過視覺和語言開發並實現無縫互動的尖端模型和資料集來突破人工智慧的界限。模型支援文字到視訊(T2V) 和圖像到視訊(I2V) 任務,並且可以在同步和非同步模式下進行推理。 影片長度限制的突破:雖然像 LTXV 和 HuanYun 等模型在速度或品質方面表現出色,但它們通常限制生成約 5 到 10 秒的短片。Frame pack 可以生成高達 60 秒的高品質影片,但 60 秒是其最大長度。Skyreels V2 透過其稱為「擴散強制 (diffusion forcing)」的技術,可以讓您生成長達 60 秒甚至可能更長的影片。技術上,擴散強制模型可以透過不斷訓練一個擴散強制取樣器並在最後組合每個結果來無限延長影片長度。

Skywork 是一個創新的研究團隊,致力於推動 LLM 和多模式理解。它們的使命是透過視覺和語言開發並實現無縫互動的尖端模型和資料集來突破人工智慧的界限。模型支援文字到視訊(T2V) 和圖像到視訊(I2V) 任務,並且可以在同步和非同步模式下進行推理。
影片長度限制的突破:雖然像 LTXV 和 HuanYun 等模型在速度或品質方面表現出色,但它們通常限制生成約 5 到 10 秒的短片。Frame pack 可以生成高達 60 秒的高品質影片,但 60 秒是其最大長度。Skyreels V2 透過其稱為「擴散強制 (diffusion forcing)」的技術,可以讓您生成長達 60 秒甚至可能更長的影片。技術上,擴散強制模型可以透過不斷訓練一個擴散強制取樣器並在最後組合每個結果來無限延長影片長度。
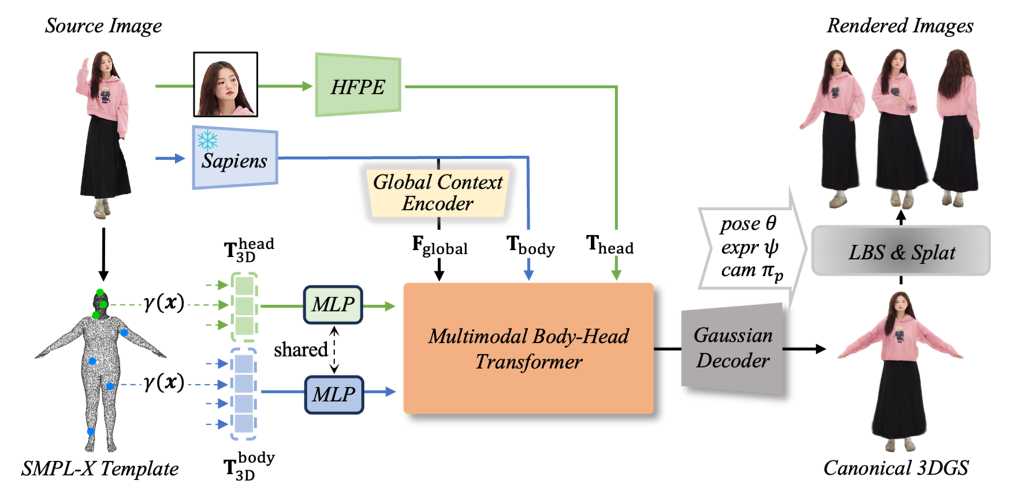
LHM (Large Animatable Human Reconstruction Model) 是一個高效及高質量的 3D 人體重建方案模型,能夠在幾秒鐘內生成影片。模型利用了多模態的 Transformer 架構,以注意力機制,對人體特徵和影像特徵進行編碼,能夠詳細保存服裝的幾何形狀和紋理。為了進一步增強細節,LHM 提出了一種針對頭部特徵的金字塔型編碼方案,能夠生成頭部區域的多種特徵。(阿里巴巴)

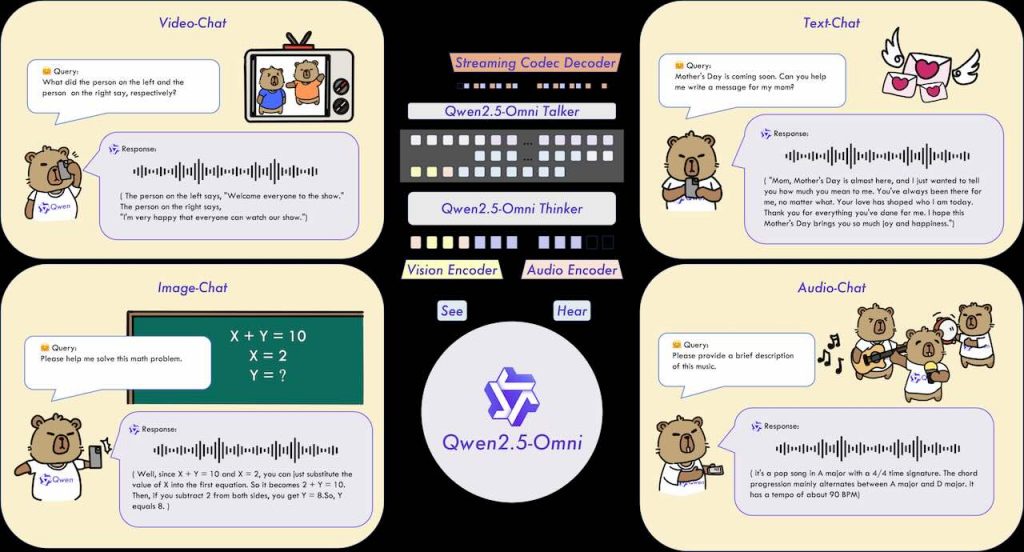
Qwen 2.5-Omni,是一個由阿里巴巴團隊開發的端對端多模態模型。它的主要目的是統一處理輸入的文字、圖像、音訊和影片,能同時生成文字和自然語音作為回應。模型在多模態輸入的感知、文字與語音的同步生成以及串流處理的優化等方面都採用了創新技術同埋架構,例如 TMRoPE 時間對齊編碼和 Thinker-Talker 架構。下面的影片詳細示範了 Qwen 在不同的應用場景下的優秀表現。