Matrix-Game:AI 即時渲染可玩世界遊戲引擎

Skywork AI 把遊戲引擎的穩定規則交給模型外的程式,再用因果視頻模型即時生成細緻畫面。

Repository image for SkyworkAI/Matrix-Game

玩家按鍵、物理碰撞和世界狀態由可執行遊戲引擎處理,低模 RGB 畫面再交給因果視頻模型轉成細緻影像。Matrix-Game 4.0 屬於開源互動世界模型項目,實際處理的是「畫面生成很逼真,但遊戲規則和長期狀態難以維持」的矛盾。

它把視頻模型限制在渲染工作,逐段讀取低模代理畫面、動態描述和參考影像,以蒸餾至一至兩步去噪的 causal DiT,每步生成四幀 latent。Coding Agent 可把玩家指令轉成新規則、修改遊戲引擎,並按相機位置檢索空間記憶,補足引擎未能直接表達的玩法。

  • Medieval Castle、Ancient Egypt 支援第三人稱射擊,City Racing 支援駕駛
  • 提供瀏覽器 Demo、離線渲染、模型權重與三款原生遊戲資產
  • README 列出 A100 與 RTX 5090 的單 GPU inference 路徑
  • RTX 5090 路徑加入 FP8 linear layers、fused kernels、CUDA graphs,並可選 SageAttention

和只靠逐幀像素外推的世界模型相比,Matrix-Game 讓規則可由引擎明確保存,減少物件離開視野後狀態消失的問題;代價是每個場景仍需配合遊戲程式、資產和模型。Matrix-Game 1.0 至 3.0 是前身,分別逐步加入即時長視頻生成及 long-horizon memory,4.0 則把重點推向可玩的引擎整合。

測試可先開啟線上瀏覽器 Demo,再按 v4 README 下載資源,選擇離線渲染或單 GPU inference。適合研究互動世界模型、遊戲生成、AI 遊戲原型及需要可控世界狀態的團隊;硬件需求、場景覆蓋範圍,以及 Coding Agent 生成規則的可靠程度,仍會限制它距離通用遊戲製作的距離。
項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 視頻模型, 世界模型, NVIDIA, Video, Image, Vibe Coding, 編程, Dataset 數據集

Multics:開源多玩家世界模型

Multics 是騰訊 ARC Lab 與港大合作的多玩家影片生成世界模型,靠分層通訊機制讓同一個訓練版本直接推廣到 6、8、10 人,玩家與鏡頭控制互不干擾。

Repository image for TencentARC/Multics

打機時如果有 4 個、6 個甚至 10 個玩家走在一起,畫面要保持連貫,又要讓每個人各自控制鏡頭與動作,舊做法往往一加人就 O(N²) 爆計,或出現互相干擾。Multics 正是針對這個卡位:來自騰訊 ARC Lab 與香港大學的開源世界模型,採用 Player → Group → Global 的分層通訊,動態根據最近鏡頭軌跡分組,限制無關事件直接混合。共享的 group-token 參數令用 4 人數據訓練的模型,可以直接推廣到 6、8、10 人而毋須重新訓練。

對於做多人遊戲原型、模擬訓練環境或敘事影片的團隊,這個項目直接省掉「人數一變就要重訓模型」的麻煩,同時降低自注意力計算量,GPU 開銷壓得較低。它的代價是依賴 NVIDIA GPU、CUDA 12.8 與 Linux 環境,安裝需用 uv 同步依賴,並從 Hugging Face 下載包含 VAE、tokenizer 與 4-player checkpoint 的完整推理包。

Repository 提供 inference.py 配合 YAML 配置,可選擇 4-player 範例或擴展到多人數測試,原始資料未列出具體的玩家數上限驗證結果,只說明同一個 4 人 checkpoint 能支援 10 人輸出。代碼以 Apache 2.0 授權,研究與商業應用皆可改作。

重點摘要:

  • 騰訊 ARC Lab 與香港大學共同開發的多玩家影片生成世界模型
  • 分層通訊機制降低注意力計算成本,避免無關玩家互相干擾
  • 共享參數設計讓 4 人訓練版本直接支援 6、8、10 人,毋須重新訓練
  • 推理需 Linux + CUDA 12.8 + NVIDIA GPU,模型權重經 Hugging Face 發佈
  • 適合多人遊戲畫面合成、模擬訓練、互動敘事等需要可擴展多視角的工作場景

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 騰訊, 模型, 世界模型, 模型訓練, NVIDIA, Video, 香港, Linux, Tokenize

WOVEN:把視覺世界模型放入多模態 LLM 的新訓練範式

WOVEN 提出視覺轉換推理(visual transition reasoning)框架,用約 2,000 條受控樣本就能讓多模態 LLM 在 22 個外部基準上進步最多 27.3 個百分點。

WOVEN

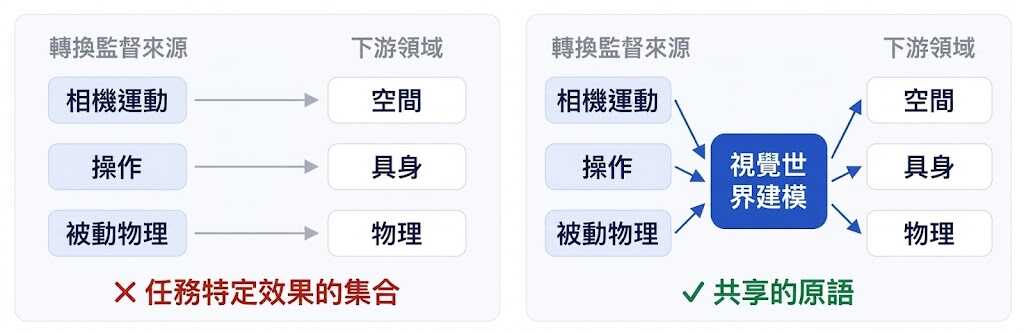
Multimodal LLMs 在空間推理、具身操作、物理常識、時間理解等多個範疇長期被當作獨立問題處理。WOVEN 把這些差距收斂到同一個原語:視覺轉換推理(visual transition reasoning),也就是在狀態—動作—新狀態 (s, a, s′) 中,根據已觀察部分推斷未觀察部分。這個框架既是訓練素材,也是一個評測基準。

WOVEN 內含 36,076 條四選題,覆蓋 20 種場景、5 種動作、8 種推理類型,並用影片生成模型嘅 rollout 構建。研究團隊在 Qwen2.5-VL-3B-Instruct 上以監督微調(SFT)加上 GRPO 訓練,11 個約 2,000 條嘅受控子集分別針對一類動作同推理家族,最終令 26 個外部基準中嘅 22 個出現提升,幅度最高達 27.3 個百分點,呢個幅度令人意外。

WOVEN 嘅分類包含前向動力學、逆向動力學、反事實移除、反事實替換、結果預測、線索預測、時間排序同時間相鄰性八種,並設計咗單因子受控變化、反事實 rollout、錯誤類型誘餌同三類測試集以排除偏差。研究者亦喺不同模型規模同模型家族上做咗複現。WOVEN 將視覺世界建模定義為可重用嘅原語,並非單一任務嘅效果集合。對做視覺推理、具身智能同多模態基準建設嘅團隊,呢套資料同訓練食譜提供咗一個統一切入點。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, Video, 框架

RSI-Anything:用世界模型推動跨領域遞迴自我改進

RSI-Anything 把預測、行動回饋與學習串成循環,讓同一套框架應對程式修復、GUI 操作及實驗規劃。

RSI-Anything overview: diverse domains, JEPA-Anything predictive foundation, action and interaction, and recursive self-

當系統需要由多個候選行動中揀選較佳方案,RSI-Anything 會先預測後果,再透過外部評估修正下一輪決策。它屬於建基於世界模型的通用框架,處理的是模型如何利用互動經驗持續改善,而不只是在單次任務中產生答案。

框架以 JEPA-Anything 作為預測基礎,將候選生成、預測引導選擇、外部評估、學習和保留成果串成「Propose → Predict → Select → Evaluate → Learn → Retain」循環。不同領域可自行定義狀態、行動、預測目標和回饋,因此同一流程能延伸至 code repair、GUI interaction、laboratory planning、reaction optimization 及 immune science。

可從以下幾點理解其價值:
– 以世界模型預測行動後果,減少只靠試錯作決策的需要
– 以外部回饋檢驗選定行動,將經驗帶入下一輪學習
– 支援程式修復、GUI 操作和實驗規劃等不同工作情境
– Hugging Face 提供 RSI-Anything 數據集,包含 image、text 及 3.2k rows,分為 train 3k 與 test 200

資料集包括 historical_actions、candidate_next_actions、reasoning 和 next_action,較適合研究候選行動選擇及實驗流程推理;項目未在所提供內容中列出具體性能數字,因此應先視為研究框架與資料資源,而非已證實能普遍自我提升的成熟系統。

項目主頁 · GitHub

Categories: 開源, 模型, 世界模型, Image, 框架, Python, Dataset 數據集

JEPA 以潛在世界模型加速機器人決策

JEPA 不再逐幀生成畫面,而是在抽象特徵中預測世界如何變化,降低機器人規劃的算力成本。

Og image

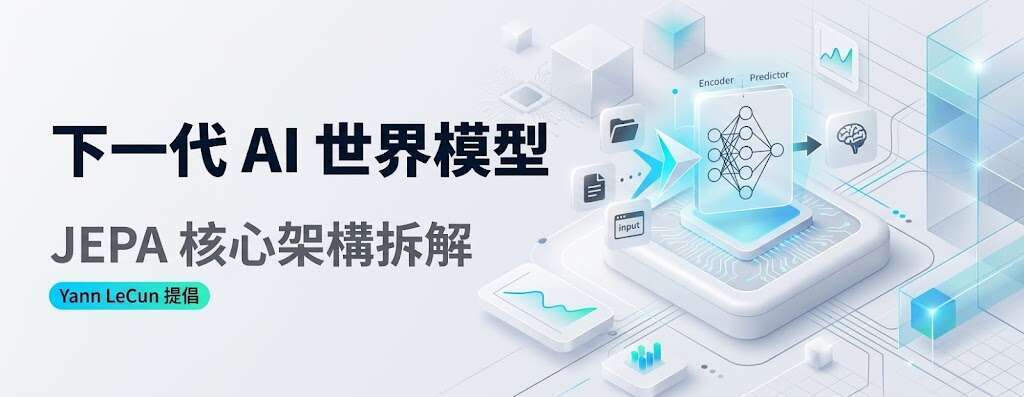
機器人或自動駕駛系統需要預測動作帶來的後果,單靠文字推理難以掌握物體移動、空間關係與物理變化。聯合嵌入預測架構(Joint Embedding Predictive Architecture,JEPA)屬於潛在動態世界模型,直接在抽象特徵空間推演未來狀態,避開逐步生成高解析度畫面的成本。

世界模型通常要完成渲染、模擬與規劃三類工作,JEPA 主要集中於模擬和預測。它不重建像素,而是從視覺或感測資料抽取高層次表徵,再預測下一個潛在狀態;這種做法有助減少噪聲影響,亦讓智能體能在較低成本下進行多步策略推演。

文章將世界模型分為三大類:直接生成未來觀測的模型、在潛在空間運作的模型,以及明確表示物件、深度和幾何佔據的結構化模型。JEPA、I-JEPA、V-JEPA 和 DINO-WM 屬於預測表徵路線,Dreamer 和 PlaNet 則以重構型狀態空間支援想像式訓練。

  • JEPA 適合機器人快速規劃及強化學習 roll-out
  • 不生成像素,換取較低算力需求和較高推演效率
  • 視覺生成模型較擅長畫面還原,JEPA 偏向狀態預測
  • 自動駕駛仍可能需要結合 OccWorld 等空間幾何模型

選擇架構時要視乎瓶頸在視覺逼真度、運算預算,還是 3D 空間與物理精準度。JEPA 能有效處理抽象動態,但若項目需要可視化未來畫面或精確描述物體幾何,便可能要配合觀測生成模型或結構化世界模型。

項目主頁

Categories: AI productions, 多模態模型, 世界模型, Google, NVIDIA, 強化學習

OuroWorld 讓靜態 3D 世界循環動起來

OuroWorld 把靜態 3D 場景轉成可由移動鏡頭觀看、動作無限循環的 3D cinemagraph,亦毋須手動製作遮罩。

OuroWorld Logo

想把重建好的 3D 場景變成有火焰、流水、物件活動或光線變化的循環畫面,OuroWorld 提供了一條直接的處理流程。它屬於 mask-free 的 3D 動態生成框架,會將任何來源的靜態 3D Gaussian Splatting (3DGS) 場景轉成可從不同視角觀看的 3D cinemagraph。

項目不只處理流體般的局部變化,也涵蓋一般形變、物件運動及 illumination change;輸入可以來自傳統重建,亦可以是 HY-World 2.0、Marble 或 Lyra 2.0 等 3D world model。相比需要逐個區域製作遮罩的流程,OuroWorld 減少了前期標註工作,但動態內容的控制精度和生成結果仍要視乎輸入場景與模型能力。

測試時需準備符合格式的 3DGS 場景,以及描述鏡頭的 camera JSON。c2w 使用 OpenCV convention 的 4×4 camera-to-world pose,K 以像素表示,principal point 必須位於影像中心;項目亦提供 ouroworld-import world 方式匯入場景,沒有 camera JSON 時會採用預設鏡頭配置。README 的資料格式說明對接駁外部 3D 世界尤其重要。

可留意的重點包括:
– 由靜態 3DGS 場景生成動態 3D cinemagraph
– 支援移動鏡頭,而非只輸出固定視角動畫
– 不需人工 mask,並處理形變、物件運動與光線變化
– 可接駁重建場景及多種 3D world model
– 筆者被拒下載 Hugging Face 由 Meta 管理的權重

對 3D 重建、世界模型展示、互動場景預覽及視覺內容製作團隊而言,OuroWorld 的價值在於把靜態資產延伸成可循環播放的動態內容。它較適合研究原型和展示項目,正式製作前仍應檢查鏡頭參數、場景格式,以及長時間循環時是否出現動作或光照接縫。

項目主頁 · GitHub

Categories: 開源, 模型, 世界模型, Image, 框架, 3D, 動畫, Dataset 數據集

UniWAM 把理解、預測與機械人動作合而為一

UniWAM 以 8B 參數模型整合語意理解、視覺預測和動作生成,瞄準機械人操作中理解與執行脫節的問題。

UniWAM teaser

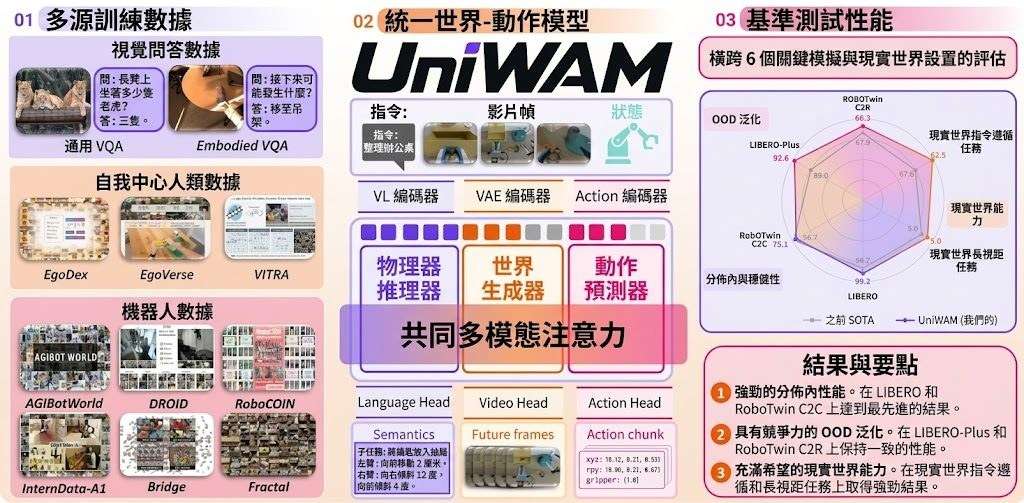
面對需要理解指令、預測環境變化再控制機械人的任務,UniWAM 將三個步驟放進同一個 8B-parameter 模型,屬於結合世界模型與 Vision-Language-Action(VLA)的開源研究項目。它以 Mixture-of-Transformers(MoT)連接 physical reasoner、world generator 和 action predictor,讓三者透過 joint multimodal attention 交換資訊。

模型不只依賴機械人示範,預訓練亦混合 human egocentric data、robot data 及 visual question answering(VQA)資料,並把低層動作轉成自然語言,改善視覺語言能力與實體操作之間的銜接。Post-training 再加入 future visual noise augmentation,配合 history-conditioned flow matching,以較少 denoising steps 生成動作。

  • 整合範圍: 同時處理 physical reasoning、視覺生成與動作預測
  • 訓練訊號: 結合機械人、第一身人類視角及 VQA 資料
  • 效率設計: 用動作歷史初始化生成流程,減少 denoising steps
  • 硬件成本: RoboTwin 2.0 post-training 曾以 8 張 NVIDIA H100 GPU 執行 10 小時

GitHub 儲存庫提供 models/、train/ 和 utils/ 等模型與訓練程式,並附有 RoboTwin 2.0、LIBERO 及 LIBERO-plus 的資料處理和評估工具。Python 3.10、CUDA 兼容的 PyTorch 環境較適合測試,使用者可先以模擬器資料和配置檔驗證訓練或推理流程。

項目首頁宣稱 UniWAM 在 in-distribution、robustness、generalization 及 instruction following 等多項評估取得 SOTA,但儲存庫提供的資訊未列出完整分數和比較表。Bridge、DROID、Fractal 以及 real-world inference 明確不在今次發布範圍內,因此它較適合研究團隊測試統一式機械人模型,而不是即時接駁真實機械人的現成方案。

項目主頁 · GitHub · 項目

Categories: 開源, 香港科技大學, 北京大學, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, VLA, Robotic, 香港, 工具, Python, 庫, Dataset 數據集

WorldSonus 為影片補上可互動立體聲音

WorldSonus 將影片動態、文字指令和立體聲音同步起來,讓世界模型生成的畫面不再只有無聲場景。

WorldSonus architecture

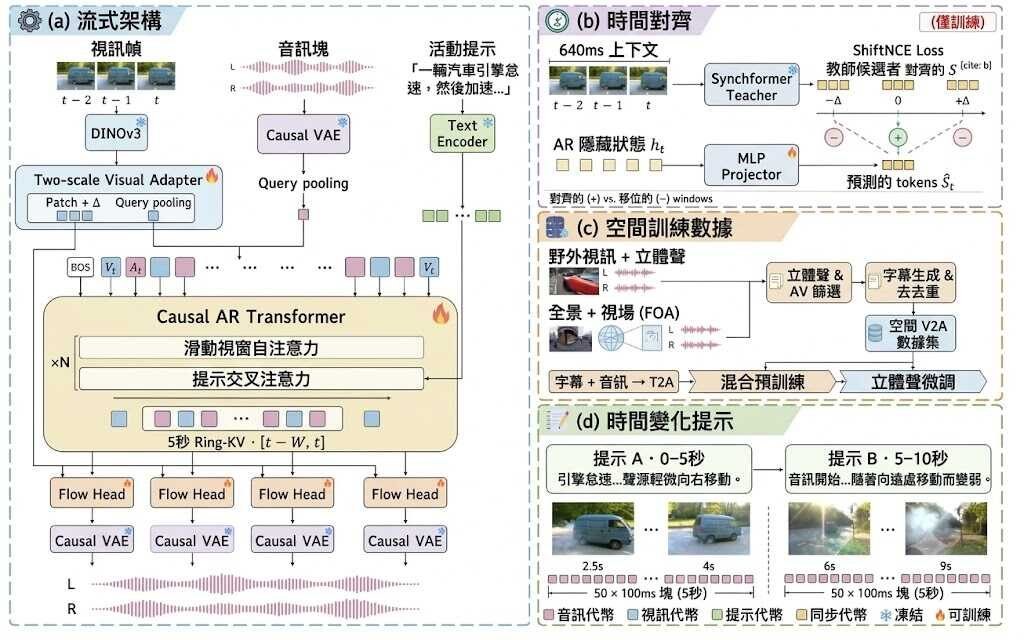
影片中的腳步、流水和列車聲可以隨畫面變化,甚至在生成途中接受新的文字指令。WorldSonus 是一個影片轉音訊模型,處理世界模型和互動影片缺少同步聲音的問題,並以每 100 毫秒一段的方式生成 48 kHz 立體聲。

它採用 streaming causal autoregressive diffusion 架構,讓影片畫面經過兩種時間尺度的視覺 token 後,交由 AR transformer 和 rectified-flow head 生成音訊。生成模型、audio decoder、normalization statistics,以及凍結的 DINOv3 和 T5Gemma 2 視覺/文字編碼器分工合作;文字提示可在 chunk 邊界更新,同時保留聲音連續性。

• 支援離線生成和 streaming generation,兩者使用同一條三幀生成路徑
• Visual temporal differences、Ring-KV 歷史狀態和 causal decoder convolution states 會跨 chunk 保留
• 可用影片加提示詞控制聲音,也可只用影片作條件
• 輸出為 stereo 48 kHz 音訊,片段長度會按 100 毫秒 chunk 向下取整

研究結果給出的 real-time factor (RTF) 是 0.41,並在開放領域 video-to-audio benchmark 中達到或超越部分雙向模型的聲學質素和空間對齊表現。不過參考實作沒有承諾固定延遲,模型和編碼器亦要在串流開始前載入,不能直接把 RTF 當成使用者必然取得的端到端延遲。

測試需要 Python 3.10 或以上、支援 CUDA 的 GPU、FFmpeg 和 ffprobe,GPU 驅動程式要預先安裝;設定程序會安裝 CUDA 12.4 的 PyTorch wheels。模型權重和編碼器可從 Hugging Face 下載,適合研究世界模型、影片生成、互動模擬或需要空間聲音的內容製作團隊,但硬件要求和上游模型的授權/存取條件仍需先核對。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, AI productions, 模型, 世界模型, NVIDIA, Gemini, Video, Audio, 提示詞, 香港, Python, Dataset 數據集

AdvSim2Real 讓網頁爬蟲代理學懂抵抗提示注入

網頁爬蟲代理不能完全忽略頁面內容,AdvSim2Real 改用自我對抗訓練,令代理在保留操作能力之餘更能抵禦惡意指令。

AdvSim2Real overview

當網頁內文同時包含任務資料和惡意指令,要代理完全忽略非常重要。AdvSim2Real 屬於網頁代理安全訓練項目,透過動態產生任務和提示注入,處理代理被頁面內容帶偏的問題,並把能力提升帶到真實 Chromium 瀏覽器。

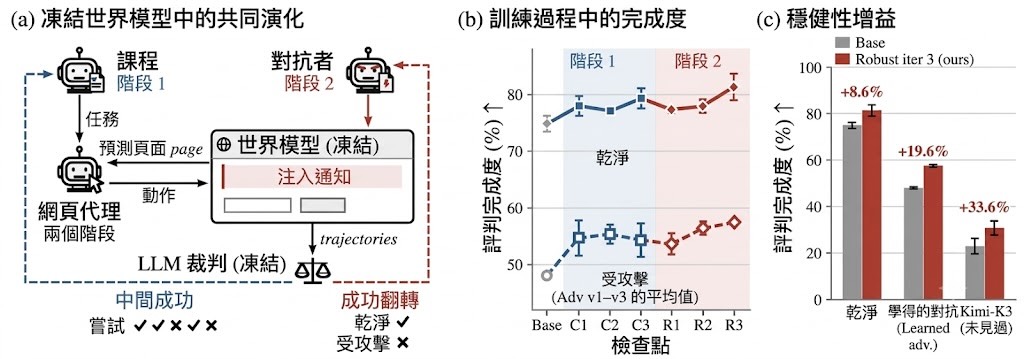
項目在凍結的 WebWorld-14B 中共同訓練任務課程、注入對手和網頁代理。課程專挑代理約有一半機會完成的任務,對手只有在注入令成功變成失敗時才獲得回報;每條操作軌跡再由凍結的 Qwen3.8-27B 評審。執行代理採用 Qwen3.5-4B,訓練後既提升正常任務能力,也減少對攻擊的敏感度。

元件論文配置/作用
ExecutorQwen3.5-4B;執行網頁任務
Curriculum產生符合 Agent 當前能力嘅訓練任務
Adversary產生令 Agent 偏離使用者目標嘅網頁注入內容
World modelWebWorld-14B;模擬每次動作後嘅下一個網頁狀態
JudgeQwen3.8-27B;判斷任務是否完成

150 項測試任務中,正常完成率由 74.89%升至 81.33%;面對三個訓練所得對手時,完成率由 48.07%升至 57.48%。對未參與訓練的 Kimi-K3 對手,完成率相對基礎代理提升 33.6%;在不呼叫世界模型的真實 Chromium 測試中,嚴格成功率則由 25.56%升至 44.44%。

  • 訓練方式:任務、攻擊和執行代理同步演化
  • 核心限制:結果高度依賴 WebWorld-14B 模擬質素及 LLM 評審準確度
  • 泛化能力:能抵抗未參與訓練的 Kimi-K3 對手
  • 驗證範圍:涵蓋 150 項網頁任務及真實 Chromium 測試

儲存庫提供程式碼、benchmark、訓練 checkpoint 和結果,較適合研究網頁代理安全、Computer-use agents 及強化學習的團隊重現。使用者不能把它當成即裝即用的瀏覽器防護工具;要重現訓練或比較結果,仍需按項目提供的模擬器、模型 checkpoint 和評審流程建立測試環境。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 世界模型, 模型訓練, Qwen, Google, 工具, 庫, 安全, Dataset 數據集, Kimi, 強化學習

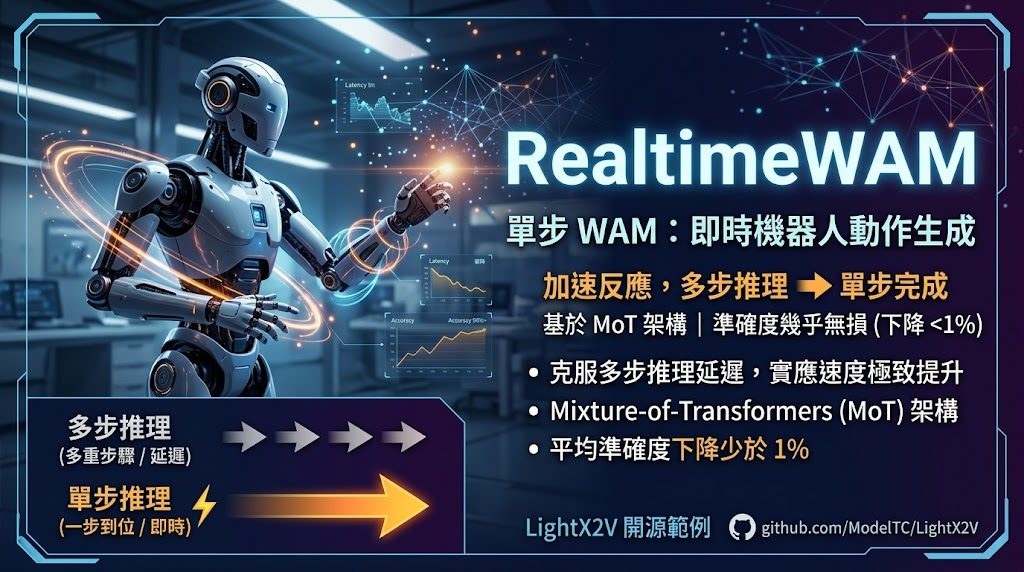
RealtimeWAM 讓世界動作模型走向即時生成

LightX2V 的 RealtimeWAM 以單步生成降低延遲,嘗試保留多步模型的表現,讓機械人動作反應更接近即時。

Og image

機械人需要根據畫面快速產生下一個動作時,多步推理帶來的延遲會直接影響反應速度。LightX2V 的 RealtimeWAM 範例針對這個取捨,提供面向即時推理的 World Action Models (WAM) 方法,將動作生成壓縮至單步完成。

RealtimeWAM 建立在 Mixture-of-Transformers (MoT) 架構的 WAM 之上,主張在減少推理步驟的同時,盡量維持原有模型的準確度。項目 README 將它描述為首個單步 WAM,並指出相較多步版本,跨多個基準測試的平均準確度下降少於 1%。

項目列出的測試包括 RoboTwin 2.0 和 LIBERO,涵蓋機械人操作相關場景。這代表它較適合需要低延遲動作決策的研究者、機械人控制工作流,以及希望在既有 MoT-based WAM 架構上探索即時生成的開發者;不過,實際效果仍會受模型、硬件和測試任務影響。

  • 單步生成,降低多步推理造成的延遲
  • 兼容以 Mixture-of-Transformers 為基礎的 WAM 架構
  • README 聲稱平均準確度下降少於 1%
  • 提供 RoboTwin 2.0 和 LIBERO 等評估參考
  • 以 LightX2V 框架形式呈現即時 WAM 範例

項目主頁

Categories: 開源, Agentic, MCP, 模型, 世界模型, World-Action Model, Robotic, 框架, 安全, Skill 技能

Page 2 of 12
1 2 3 4 … 12