WorldLine 讓機械人先看見動作後果

WorldLine 把機械人動作轉成影像及空間訊號,預測場景如何變化,再協助評估策略及規劃操作。

Repository image for Zhengsh123/WorldLine

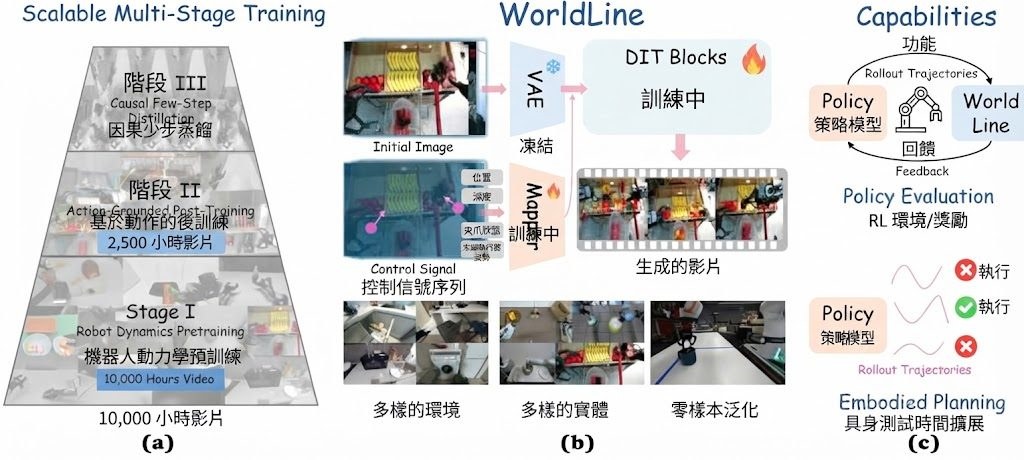
機械人要搬動物件前,WorldLine 可以先在視覺模擬中預測動作會如何改變場景,減少每次都依賴實體試錯。它屬於面向機械人操作的世界模型及視覺模擬器,處理的是「控制指令如何造成可觀察結果」這個核心問題,而不是按照任務文字生成畫面。

WorldLine 先用超過10,000小時的無動作標註機械人影片學習機械人與物件的互動,再把末端執行器的位置、深度、方向及夾爪狀態投影到經校準的相機視角。這些 image-space actions 成為不同機械人之間的共同介面;另外超過2,000小時、涵蓋10多種 embodiments 的動作軌跡,負責把通用 dynamics 對應到個別控制方式。

WorldLine 把 action grounding 分開處理,較有利於跨機械人及跨鏡頭遷移,代價是需要校準相機、動作軌跡及失敗案例。模型以 block-autoregressive 方式因果 rollout,每個區塊用四步 denoising 生成,兼顧互動速度與預測細節,但不代表能取代真實環境驗證。

  • 用於 policy evaluation、embodied planning 及實體操作前的預測
  • 以 image-space action 統一不同機械人的視覺控制介面
  • 透過 multi-view、failure-enriched training 及 relational regularization 強化互動敏感度
  • 以 few-step distillation 減少 rollout 所需計算

研究團隊包括香港科技大學、Joy Future Academy、北京大學及香港中文大學。較適合研究機械人學習、視覺規劃及模擬器的團隊先按程式碼建立推理環境,再以不同 camera view、embodiment 和失敗動作測試預測穩定性;需要即時控制的人員則應同時量度延遲、動作偏差及真實機械人的遷移落差。
項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港科技大學, 北京大學, AI productions, 模型, 視覺模型, 世界模型, 模型訓練, Video, Image, 香港, Dataset 數據集

Maestro:本地一鍵 AI 創作工作室,把導演、剪接、生成模型打包

Maestro 把 LTX-2.5、MiniMax H3 等本地模型整合成一個創作介面,配合 LLM 編寫分鏡並自動生成音樂影片與短片,適合想在自己機器上完成後期的人。

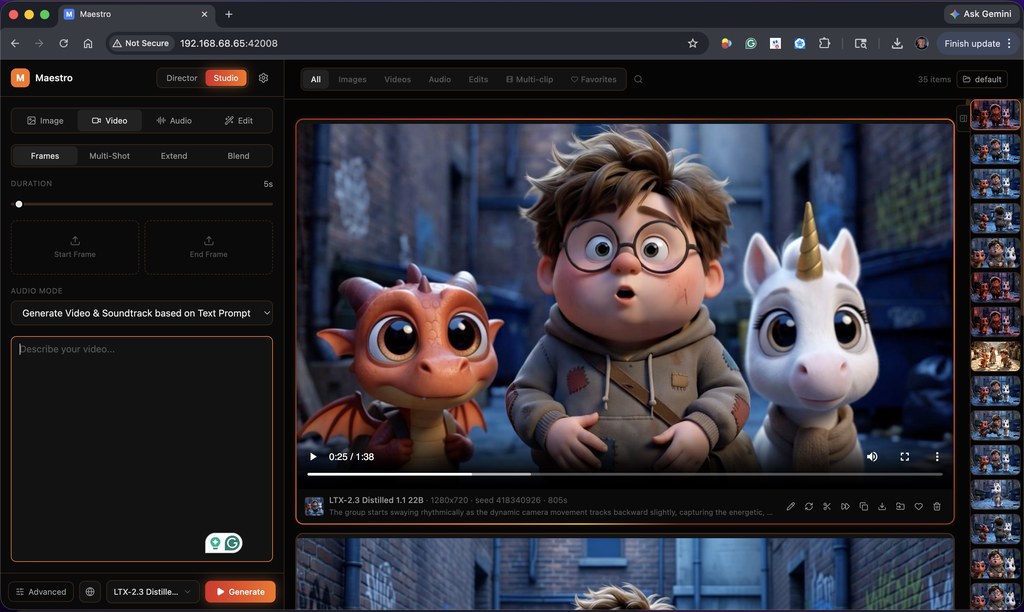
Maestro UI

用 LTX-2.5 或 Hunyuan 這類本地模型做創作時,最麻煩的往往不是模型本身,而是要自己串接腳本、分鏡、剪輯和多軌音訊。Maestro 直接把這條工作流收進一個桌面介面:LLM 先讀懂你的音訊或劇本,再交由圖像、影片、音訊模型接力生成。Director Mode 同時支援 Music Video(節拍感知分鏡)同 Short Film(劇本連戲)兩種套路,前者會分析 BPM 與段落(主歌、副歌、橋接),再把鏡頭對齊落拍;後者靠 pacing-bias slider 控制剪接密度,並維持角色與對白的一致性。Auto Mode 可以一鍵跑完整條 analyze → plan → generate → combine 流程,Manual Mode 則保留每一步檢查點。

Director v2 架構把編劇、結構化分鏡、模型格式化分成三層,H3 路徑直接走自家編譯器,其他模型則用 per-model polish。Studio 那邊亦提供適應性寫作與連戲指引,並對源動作、對白歌詞做一致性檢查。對比逐個 CLI 工具拼接的傳統做法,Maestro 的差異在於把 director 邏輯、prompt 優化同非破壞性多軌剪輯綁定在一處,省下不少膠水程式。

硬件門檻方面,Performance Auto-Tune 會在首次啟動時偵測 GPU、VRAM、RAM,並自動選取量化、VAE tiling 與 VRAM 安全係數;OOM 時還會彈出建議橫幅,一鍵降 headroom。Qwen Image 2.1 7B 支援最多十張參考圖、透明 PNG 輸出與專屬 prompt 增強,但屬研究/評估授權,商用要另外處理 Qwen 的授權。

重點摘要

  • 整合 LTX-2.5、MiniMax H3、Wan、Hunyuan、SCAIL-2 等本地模型作影片生成、延伸、混合、重拍、上色與 upscale
  • Director Mode 用本地 LLM 自動規劃音樂影片分鏡或短片劇本,並維持角色與對白連戲
  • Auto Mode 全自動、Manual Mode 每步可審;Performance Auto-Tune 依硬件自動選 profile
  • Qwen Image 2.1 7B 支援十張參考圖、透明 PNG,但僅研究/評估授權
  • 原始資料未提供具體安裝步驟或下載連結,需自行到倉庫頁查閱

內容生成後想拿來做音樂 MV、自媒體短片或概念分鏡的獨立創作者、小型工作室,會較容易受惠;商業團隊則要留意 Qwen 等模型的授權細節。Maestro 在 JavisBench、V ABench 等基準上對 LTX-2.3 的對比屬同捆支援模型本身的表現,工具層並未自稱有獨立 benchmark。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, 騰訊, AI productions, 模型, Qwen, NVIDIA, Video, Image, Audio, 香港, 工具, Content Creator, LTX, 音樂, MiniMax

AV-GRPO 把音訊影片聯合模型訓練門檻壓到 8 張 A800

這個項目把 GRPO 強化學習帶進多模態模型,並透過「模態錨定解耦」大幅降低跨模態訊號干擾,連 LoRA 微調都能在 8 張 A800 上完成 22B 模型訓練。

Repository image for zhiyuxu03/AV-GRPO

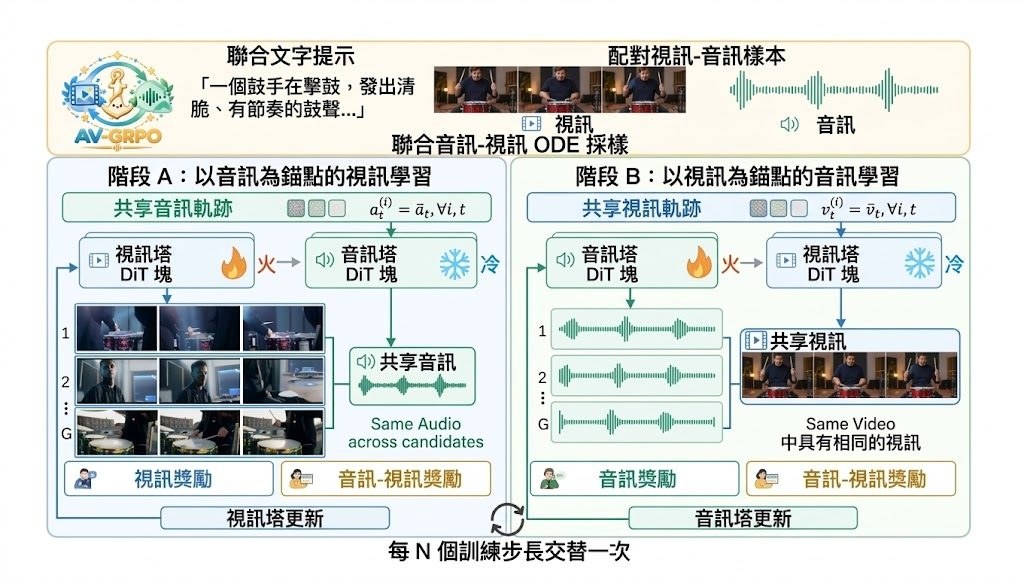
聯合音訊與影片生成一直有個麻煩:模型做出來的影像與聲音品質、文字對齊度、長度同步性常常此消彼長。AV-GRPO 直接把 GRPO 強化學習框架搬進 LTX-2.3 這類 22B 級的雙流模型,並用「模態錨定解耦」的方式,把音訊與影片兩路的學習訊號分開計算,避免強化學習的獎勵把兩個模態的功勞混在一起算不清。配套的 5DAV 數據集同樣沿五個維度拆解,方便精準控制訓練難度。

作者最在意的是算力門檻,這套框架支援全參數微調與 LoRA 微調兩種模式,只要 8 張 A800 就能跑得起來,並整合了模態錨定 rollout、凍結其中一路做軌跡鎖定優化、依模態特性調整擾動強度三個機制,把原本耦合的多模態偏好學習拆成條件式單模態子問題,使獎勵歸因與同步優化都更精準。

在 JavisBench 與 VABench 評測中,AV-GRPO 不論 LoRA 或全參數設定,於生成品質、語意對齊、跨模態同步三項都穩定超越 LTX-2.3 基準。對需要「一次到位」產出高同步影音的團隊、短片創作工具開發者、以及想在有限 GPU 資源下微調大型影音模型的實驗室,吸引力都很高。

重點摘要:

  • 首個針對音訊影片聯合生成設計的 GRPO 框架,解決強化學習獎勵訊號在異質模態間糾纏的問題。
  • 模態錨定解耦讓影片與音訊各自計算 rollout 與獎勵,顯著改善獎勵歸因。
  • 22B 模型在 8 張 A800 上支援 LoRA 或全參數微調,大幅降低硬體門檻。
  • 5DAV 數據集沿五個維度解耦,方便調節難度與做消融實驗。
  • JavisBench 與 VABench 結果顯示生成品質、文字對齊與跨模態同步全面優於 LTX-2.3。

官方尚未提供一鍵安裝或開箱即用的 inference 腳本,整合進 LTX-2 推論流程時仍需自行處理權重合併與路徑替換;對於想直接做線上服務的團隊,整合成本仍是主要取捨。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Audio, 框架, 香港, 工具, LTX, Dataset 數據集, LoRA

Segment-Snap:讓 AI 看懂3D 場景怎樣開門

由室內3D掃描推斷可動部件、運動方式和把手位置,Segment–Snap把幾何線索與語義判斷接在同一條流程內。

Paper on arXiv

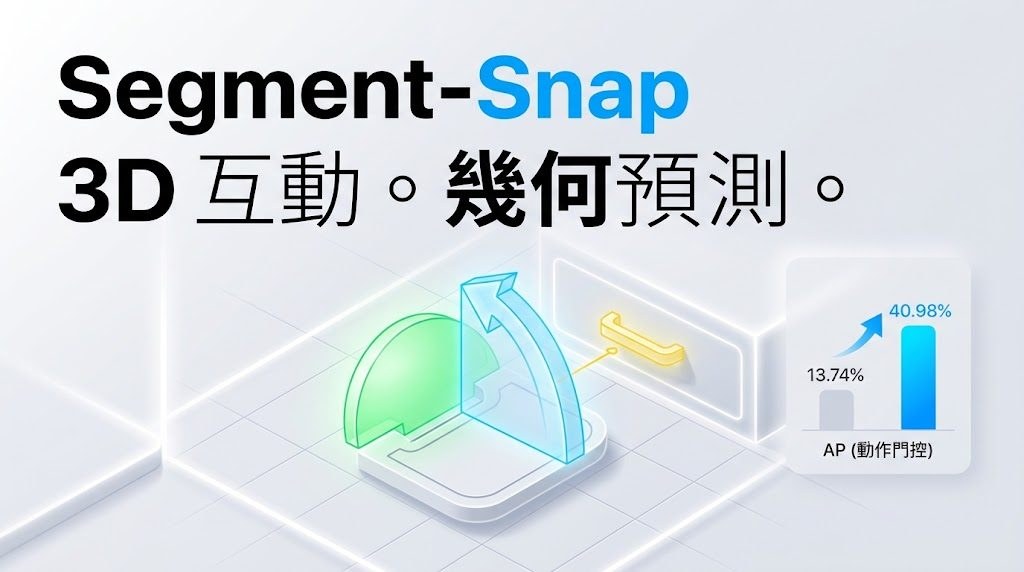
一張室內3D掃描不應只告訴你有門櫃,還要指出哪個部件會動、沿甚麼方向移動,以及人應在哪裏操作。Segment–Snap 屬於3D場景互動理解模型,處理的正是可動部件、運動類別、鉸鏈位置和把手之間的關係。

項目採用三個獨立訓練的 predictor 讀取同一個 RGB point cloud:Movable-part predictor 負責部件分割及旋轉、平移類別;Dense handle predictor 尋找細小把手;Joint part-handle predictor 再提出與部件相關的把手候選。把手位置會協助判斷旋轉部件的鉸鏈線,部件的幾何和類別則反過來改善把手標籤,兩個方向各行一次,沒有迭代式 feedback。

固定的 training-free decoder 會為可靠部件支援擬合方盒,利用垂直軸先驗推斷旋轉,並以表面法線處理平移;這令模型毋須另行訓練 motion regression。Joint predictor 的 parent parts 只作內部脈絡,最終輸出仍以獨立 Movable-part predictor 的部件結果為準,取捨相當清楚。

• Handles → part motion +27.25 個百分點,主要改善 hinge placement
• Parts → extra handles +5.01 個百分點,補充把手 proposals
• Part classes → handle labels +0.98 個百分點,修正部分 motion-class 判斷
• 三項結果來自 Articulate3D validation,指標為 motion AP 或 handle AP,增幅不可直接相加

測試時可按資料準備文件處理場景,再使用 Hugging Face 提供的 pretrained checkpoints 和 repository 內的 training configurations,重現公開 Articulate3D validation 實驗。項目較適合研究3D視覺、機械人感知、具身互動或需要分析門櫃等室內物件操作方式的團隊;它提供的是研究參考實作,並非可直接接駁家居控制系統的完整產品。

項目主頁 · GitHub · 模型

Categories: 開源, 香港理工大學, 模型, 模型訓練, 香港, 3D

RULER 讓 SVG 生成更貼近人類判斷的評分

生成SVG時,圖像看似相似,未必代表指令已經做到。RULER用逐項評分改善模型訓練,毋須配對的標準圖像或人工偏好標籤。

RULER-generated eye icon with eyelashes and a blue iris

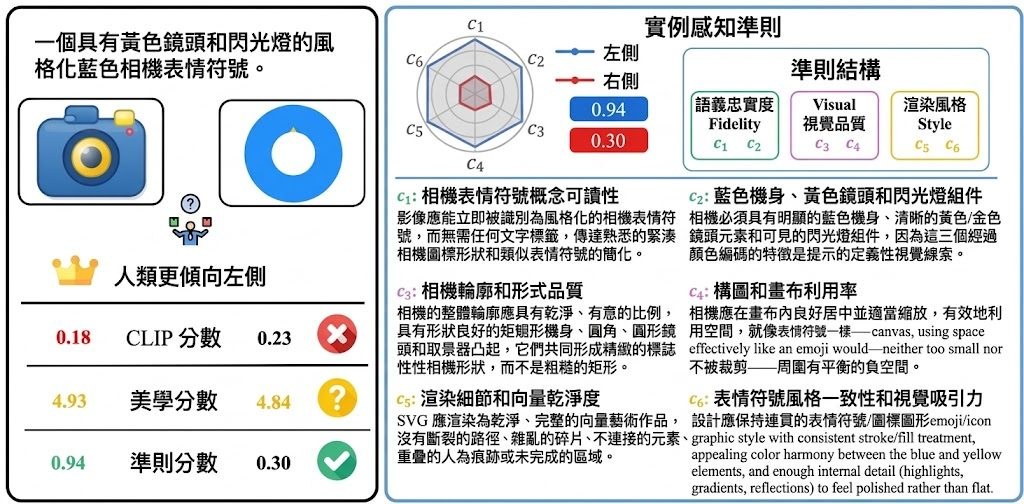
想把「畫一個指向東北的指南針」轉成SVG,模型要同時掌握主體、方向和風格;但這類開放式生成通常沒有唯一正確圖像,傳統分數未必能指出作品究竟錯在哪裏。RULER是一套用於SVG生成評估及強化學習訓練的方法,嘗試把籠統分數拆成可逐項檢查的要求。

它會只根據文字指令,為每個生成任務建立六項評分準則,涵蓋語意、視覺和風格,再由視覺語言模型評分渲染後的作品。各項得分按權重合成較細緻的獎勵,供 Group Relative Policy Optimization(GRPO)優化模型;整個流程不需要配對SVG標準答案或人工偏好標籤。

這種做法針對的是CLIP、Aesthetic等單一分數難以判斷SVG細節,也可能令強化學習模型迎合分數、產生 reward hacking 的問題。研究團隊表示,多軸評分比單一指標更貼近人類判斷;在MMSVG-Illustration和MMSVG-Icon上,rubric分數分別由0.432升至0.693,以及由0.395升至0.683,並超越專門SVG模型,表現可媲美規模大得多的DeepSeek-V3。

  • 每條指令會生成專屬評分準則,而非所有作品共用一把分數尺。
  • 評分同時檢查語意、視覺和風格,獎勵可用於GRPO訓練。
  • 不需要標準SVG圖像或人工偏好標籤,適合缺少標註資料的生成項目。
  • 評測結果顯示評分準則的設計是提升開放式SVG生成的重要因素。

項目主頁

Categories: 香港科技大學, Image, 提示詞, 香港

Mira-Scene 單張圖片重建可編輯 3D 場景,讓畫面變成可拆解空間

Mira-Scene 將單張圖片拆成物件、深度與環境,再組合成可編輯 3D 場景,降低由 2D 畫面建立空間內容的門檻。

Mira-Scene teaser

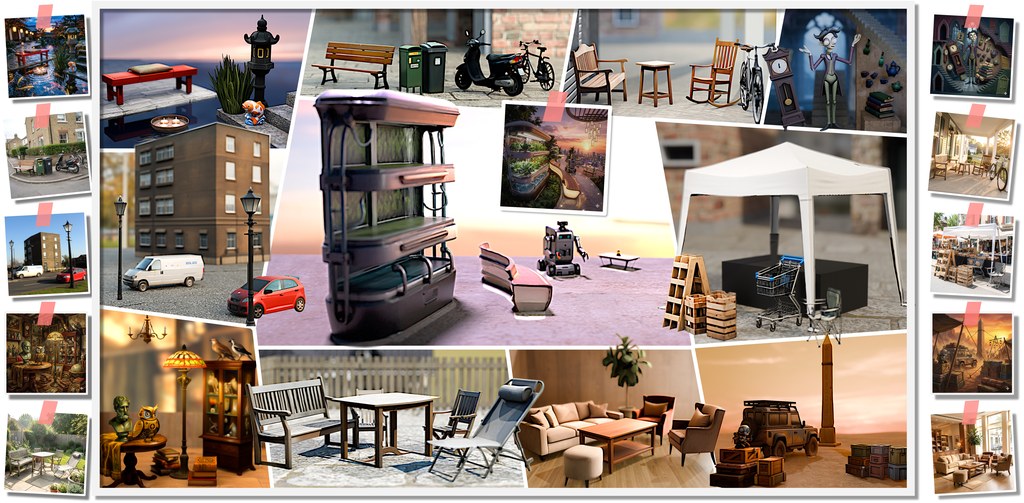
由一張圖片開始,Mira-Scene 能分辨場景內的物件、估算深度,再為各物件建立網格並組合成可編輯 3D 場景。它屬於單圖 3D 場景重建模型與推理項目,處理的是影像缺乏空間結構、物件難以獨立編輯的問題,適合概念設計、虛擬場景和後續模擬工作。

完整流程包括互動式 instance segmentation、monocular depth estimation、canonical coordinate map(CCM)、voxel prediction、逐物件 mesh generation、支援物件接觸關係的 scene assembly,以及 environment-map generation。Hugging Face 提供的 CCM diffusion checkpoint 只負責其中一個階段,並不是可直接輸出 GLB 的獨立 image-to-3D 模型;分割遮罩、mesh backend 和場景組裝階段仍要配合使用。

Mira-Scene 採用分階段推理,支援中斷後繼續執行、多個深度及網格後端,亦可按個案分配多張 GPU。使用者可依照中文 inference、visualization 和 evaluation 指南準備輸入圖片及遮罩,再檢視各階段產物;訓練程式碼和示例訓練數據仍列在待辦事項,研究用途以外需要自行處理環境和模型資源。

• 單張圖片重建可拆解的 3D 場景
• 以 CCM 和稀疏 voxel 表示物件空間結構
• 對比 SAM3D,3D-IoU 為 0.727,較 0.520 高
• 部分指標領先,但 EMD 略遜於 SAM3D
• 開源推理流程完整,訓練部分尚未公開

評測表中,Mira-Scene 使用 80k 規模、全自動流程的數據,CD、FS@0.1、3D-IoU、ICP-Rot、2D-IoU 和 ADD-S 均優於 SAM3D;EMD 則為 0.169,稍高於對方的 0.163。這反映它在整體形狀、投影對齊和姿態誤差上具競爭力,但不能把單一圖片重建視為完整真實世界掃描,遮擋、不可見背面和網格後端仍會影響結果。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 影像處理, 3D, 蘋果

VideoGen-Agent 讓影片生成懂得規劃、驗證與修正

影片生成不再只靠一次輸出,VideoGen-Agent會分步使用工具,檢查結果後再修正畫面與內容。

VideoGen-Agent logo

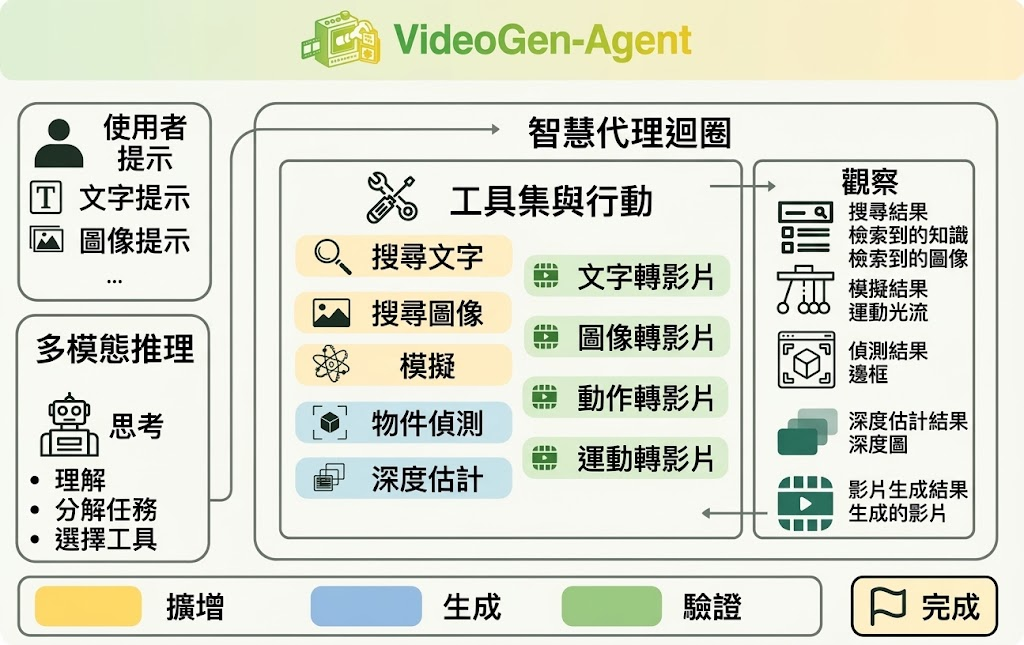
面對需要維持人物身份、物理關係、場景構圖或事件次序的提示詞,一次生成往往難以兼顧所有要求。VideoGen-Agent以多模態代理配合強化學習,讓影片生成流程加入規劃、工具操作和視覺驗證,逐步處理這些容易出錯的部分。

代理會在多輪互動中協調 augmentation、generation 和 verification 工具,根據提示詞及中途觀察結果決定下一步行動。訓練先以教師生成的工具使用軌跡建立基本行為,再透過 multitask agentic reinforcement learning 改善工具選擇和生成品質,並以混合獎勵同時評估工具呼叫有效性、任務配合程度及影片效果。

VABench 包含600個提示詞,涵蓋程序知識、單一及多個實體的身份保持、物理一致性、場景構圖和多鏡頭時間結構。以 Seedance 1.0 T2V 作為基礎生成器時,VideoGen-Agent分數由56.5提升至75.6;推理時換用 Toolset 2,即使不重新訓練代理,分數仍升至86.1,人類評審在雙選比較中有84.3%偏好升級後的配置。

• 以多步驟代理流程取代單次影片生成
• 結合 augmentation、generation 和 verification 工具
• 針對身份、物理一致性及事件順序等難題作出驗證
• VABench涵蓋600個多類型提示詞
• 程式碼及資料集當時仍標示為即將推出

這種做法較適合需要精準遵循複雜提示詞的影片創作、研究評測及工具驅動工作流。它仍依賴可用的生成與驗證工具,代理表現亦會受基礎模型、工具能力和評估方式影響,不能把分數提升直接視為所有影片場景都能獲得相同效果。

項目主頁

Categories: 香港中文大學, Agentic, AI productions, Video, 提示詞

OmniVChat:測試 AI 能否同時聽懂及看懂

直接把聲音和影像交給AI,回覆是否仍有根據?OmniVChat 提供評分工具,但測試與訓練分數不能混用。

OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue

讓AI直接接收用戶的聲音和影像,再以文字回答,OmniVChat(Omni Video Chat)提供了檢驗這類對話的評估與訓練獎勵工具。問題藏在影音之中,不另附文字提問、外部影像描述或自動語音辨識(Automatic Speech Recognition,ASR)轉錄,適合測試多模態模型能否連結所見所聞。

OmniVChat-Bench包含2,800段合成對話,按分層準則評分,涵蓋五類能力:

  • Dialogue-State & Link Perception(DSLP):理解對話狀態與連結。
  • Multimodal Entity Alignment(MEA):把說話對應至正確的可見實體。
  • Model Self-Awareness(MSA):交代自身身分與物理限制。
  • Anti-Hallucination(AH):回答以影音證據為依據。
  • Emotion Recognition(ER):結合面部與聲線辨識情緒。

評估分數r(y)介乎0至1,以Subcategory Mean匯報;OmniVChat-RL共用評分核心,另加格式、效率與風格獎勵,範圍為0至1.5,兩者不能直接比較。

研究團隊可先查看儲存庫的評分程式與範例,再到Hugging Face取得完整標註及媒體。這個項目只提供程式碼、範例與文件;合成對話的結果亦不足以單獨判斷模型在真人影音互動中的可靠程度。

GitHub

Categories: 開源, 香港中文大學, 阿里巴巴, 多模態模型, Video, Audio, 工具, 庫, 語音

小米公開 CodeMidas 強化學習訓練進度

小米以即時指標公開 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練狀態,並連結至程式編碼代理研究。

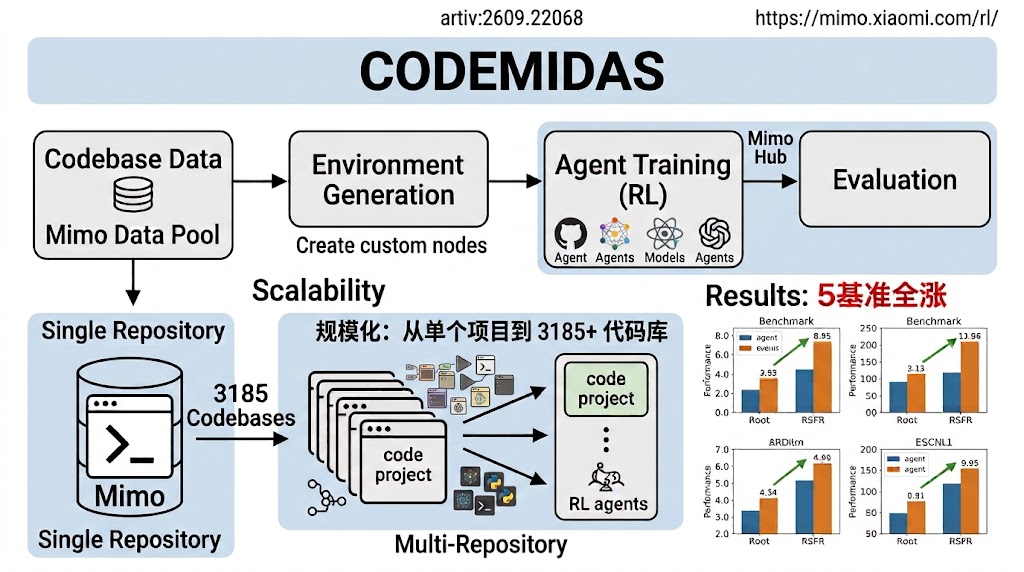
CodeMidas 把模型訓練過程帶到公開視野,展示 mimo-v2.6-pro 與 mimo-v2.6-flash 兩組 reinforcement-learning runs 的即時指標。對需要追蹤模型能力如何形成的研究者和開發者而言,這類介面可用來觀察訓練是否持續、何時中斷,以及不同模型版本的進度差異。

小米以 trainer 直接提供的 metrics 為主,未有完整列出指標定義、數值解讀或最終評測結果。因此,讀者可以把它視為訓練監察入口,而不是已完成模型的性能報告;畫面亦提示可能出現重新連線狀態,資料連續性仍需留意。

根據 CodeMidas 研究,mimo 從程式碼本身擴展 agentic coding reinforcement learning environments。這個方向處理的問題,是如何建立足夠多、又能反映真實編程任務的訓練環境,讓 coding agents 在程式修改、執行與驗證等流程中學習,而不只依賴靜態範例。

資訊:
– 同時追蹤 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練
– 指標由 trainer 即時更新,適合觀察訓練進程
– CodeMidas 聚焦由程式碼擴展 agentic coding RL environments

對模型研究、AI agent 和編程工具開發者來說,頁面提供了一個觀察訓練公開化的窗口;一般使用者則應等待正式模型說明和獨立評測,才適合判斷其編碼能力及穩定性。

項目主頁 · 模型

Categories: 開源, 香港大學, 北京大學, Agentic, 模型訓練, 工具, Discord, 編程, 小米-Xiaomi

OST:可撤回串流推理的「過早下結論」

香港大學與香港科大(廣州)團隊開源 Omni-Streaming Thinking(OST)針對解決串流影音推理中視覺先到、聲音後到的錯位問題。

Repository image for EnjunDu/OST

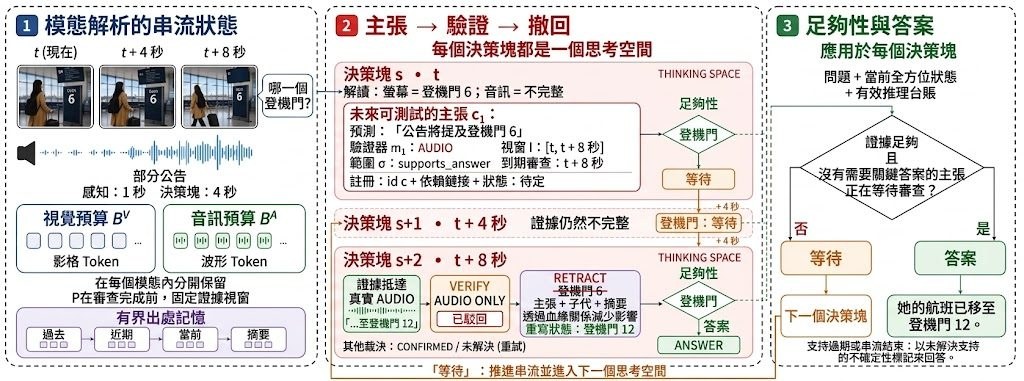
看串流影片做即時推理,最常見的卡位是視覺線索先到位、聲音事件卻還在展開——模型若把視覺猜測當成事實寫進記憶,後續聲音即使推翻它,舊結論仍可能一路延續下去。OST 正是針對這個「提早跨模態承諾」的失敗模式設計:每一個未解的詮釋都被記成一條 claim,附帶預期事件、指定驗證模態、證據到期時段,以及依賴它的狀態;期限一到就用對應模態的證據覆核,被推翻時連帶下修相關狀態,再由引導式解碼產出修正後的回應。

OST 以凍結的骨幹模型為基礎,所有新增的部分都是 adapter、soft prompt 或輕量 head,骨幹參數完全不會被改動。聲音與視覺各自有獨立的保留緩衝區與配額,避免高密度的視覺 token 把聲音擠出記憶;舊狀態以四向折疊收進金字塔結構,讓推理上下文維持在有界範圍內。回答閘門則會延遲輸出,直到所有影響答案的 claim 都完成覆核。

適合研究串流多模態推理、想重播或審視 claim–verify–retract 循環的團隊,會比較容易從中受益。程式碼只涵蓋推論與執行記錄,不包含訓練、評測 harness 或診斷 benchmark。

重點摘要:

  • 類型:串流影音推理的推論實作,骨幹凍結,僅加掛 adapter 與 head。
  • 核心機制:claim–verify–retract,未確認詮釋附帶驗證模態與到期時段。
  • 記憶設計:聲音與視覺分開配額,舊狀態四向折疊維持上下文有界。
  • 輸出控制:answer gate 會等到關鍵 claim 覆核完成才放行。
  • 範圍限制:僅推論,不含訓練、評測 harness 與 OST-DiagBench 資料集。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港大學, 香港科技大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio, 香港, Dataset 數據集

Page 3 of 18
1 2 3 4 5 … 18