τ₀-VLA:為長程機械人任務補上分層推理

τ₀-VLA 把長程機械人操作拆成高層規劃與低層執行,先想下一步,再落到實際動作。它特別針對多步驟、要記住進度又要回復失誤的場景。

τ₀-VLA overview

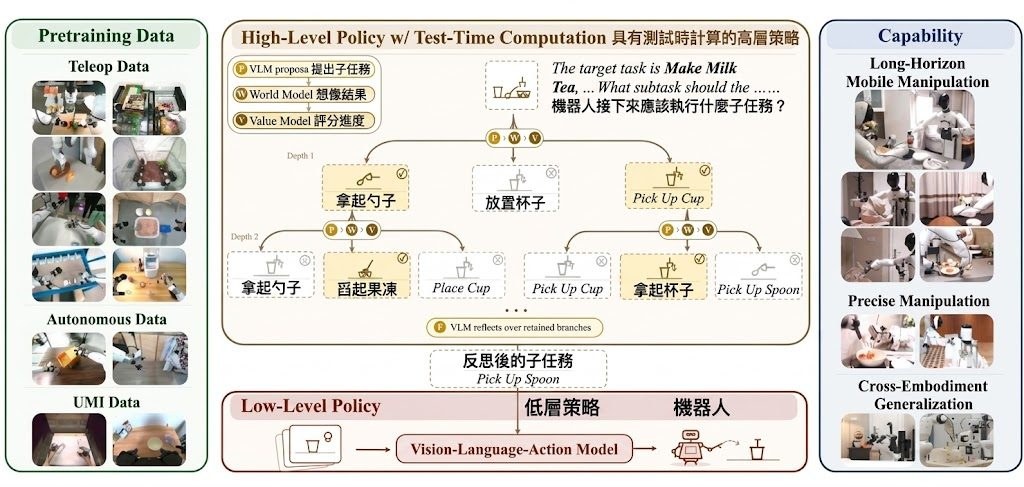
τ₀-VLA 是一個機械人基礎模型,主打長程操作任務,例如清理房間、準備食材和沖奶茶這類要連續完成多個步驟的工作。它先用帶記憶的高層策略決定下一個子任務,必要時再用 world-model-guided test-time computation 比較不同做法,然後交由低層策略執行。

這種分層方式比單次前向推理更適合處理長流程,因為模型不只要做動作,還要跟進已完成進度、預測結果,再決定下一步。對需要機械人跨場景操作的團隊來說,比只處理單一步驟的控制模型更接近真實工作流程。

  • 高層負責規劃子任務,低層負責具體控制
  • 會在需要更多推理時做分支搜尋,不是即時拍板
  • 低層策略結合 Qwen3.5 vision-language backbone 與 Mixture-of-Transformers action expert
  • 訓練資料來自 40,115 小時真實機械人數據,涵蓋多模態協同訓練
  • 目前公開 v1 只支援 joint-control checkpoints,EEF serving 未提供

官方提供 Python 3.11、CUDA 12.8、PyTorch 2.7.1 的參考環境,也有 example_data 同配置的 post-training 例子,可用來接入自己的資料集或機械人設定。文中四個長程任務涵蓋 13 至 25 個步驟,重點不只是在動作準確,還包括進度保持、結果驗證和失誤後恢復。

對做機械人研究、具身智能系統,或要把語言理解和實體控制接起來的團隊,這個項目提供了一個較完整的分層基線;限制也很明確,公開版本先集中在 joint-control,較適合有相應訓練與部署條件的環境。
項目主頁 · GitHub · 模型

Categories: 開源, 多模態模型, 模型訓練, Qwen, NVIDIA, VLA, World-Action Model, Python

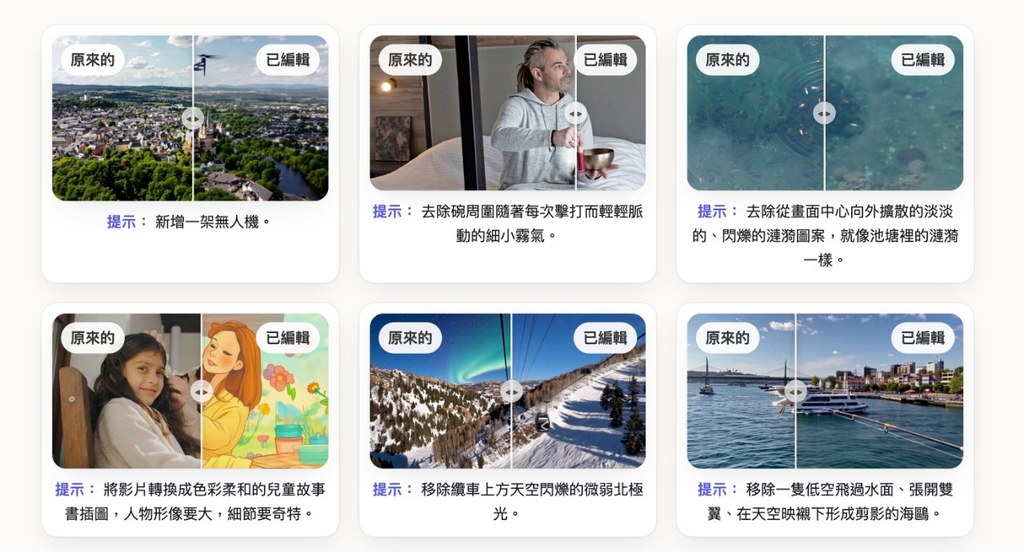
Qwen-Video-Edit:開源影片編輯模型

它把文字指令式影片編輯做得更直接,透過現成的 image editing model 去改寫影片 latent。對需要長片段、分段修改同一條影片的工作流,會比重起一套 video transformer 更省力。

input contact sheet

Qwen-Video-Edit 是一個 instruction-based video editing 項目,核心做法是把 Qwen-Image-Edit 直接搬去處理影片 latent,再用兩個可訓練 projection 接上 Wan 2.1 的 video-VAE。這樣做的價值很清楚:不用再依賴 video-pretrained transformer,也能按文字指令改影片內容。

安裝和測試路線已經整理得相當明確。train.py 走單機多 GPU 訓練,infer.py 負責長影片逐段編輯與 Wan 2.2 denoising-enhancement,dataset.py 則讀取 Ditto 格式的 source、edited、instruction 配對。

和一般影片編輯方法相比,差異在於它不是從頭學影片理解,而是借用影像編輯模型的先驗,再用 warm-started projections 與 grid positional encoding 去補上時間維度。這代表訓練成本和架構複雜度較低,但限制也在於效果仍仰賴 Wan 2.1 latent 空間、Ditto-1M 資料,以及後段 enhancement。

  • 支援 LoRA 或 full fine-tuning,取捨在訓練成本與自由度之間
  • 長影片可以分段套用不同指令,適合剪接、局部修改、旁白對齊內容
  • 輸出 checkpoint 以 trainable-weights-only .safetensors 形式提供,載入流程較直接
  • 另有 zero-training demo,可先看 image-grid 與 latent-grid 編輯行為
  • 模型權重已公開,方便直接做復現或二次改造

項目主頁 · GitHub · 模型

Categories: 開源, 視頻模型, 模型訓練, Qwen, Video, Image, 影像模型, Dataset 數據集

EditBridge 更穩定的4K 影像編輯

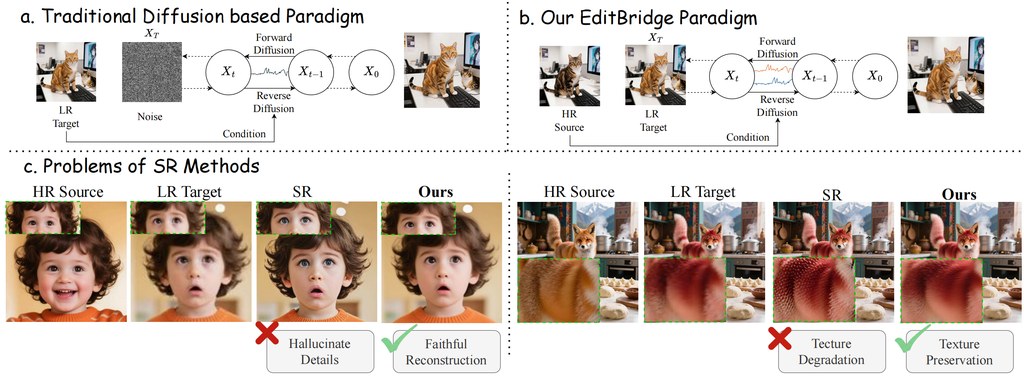
EditBridge 把低解析度編輯和高解析度修復接起來,避免放大時細節走樣。它適合要保留原圖紋理、文字和結構的影像編輯流程。

Overview of the EditBridge paradigm

EditBridge 是一個影像編輯框架,目標很直接:在 1K 到 4K 的高解析度輸出下,仍然保住原圖細節,而不是放大後再補出一堆不一致的紋理。它把粗編輯結果先交給 diffusion bridge 再修復,讓高解析度原圖繼續參與推理,不用把整張圖重生成一次。

和常見做法相比,它的取捨在於把「補細節」改成「沿著已對齊的內容做橋接」。核心做法是 PG-BSA(prior-guided block-wise sparse attention),用先前編輯階段的對應關係去挑選需要看的區塊,減少密集全局注意力帶來的成本,同時降低高頻細節失真。

倉庫已經交代了基本使用路線:先建立 Python 環境,再安裝項目,下載 Qwen-Image-Edit-2509 checkpoint,之後用 CSV 準備 source_image、target_image、condition_image 和 prompt。訓練時還要先抽取 target-to-source correspondences,1K、2K 與 4K 的流程分開處理,4K 版本則透過降低記憶體消耗來跑。

這套方法較適合做高解析度修圖、產品圖改寫、海報文字修正,或者任何不能接受放大後失真、塗抹感太重的工作流。它的評估重點也很清晰:在 1K 到 4K 的 reconstruction 和 perceptual metrics 都維持領先,推理時間比直接高解析度生成和傳統 diffusion 超解析度方案更實用。

  • 保留原始高解析度 source 作為條件,減少細節漂移
  • 用 coarse edit 接 diffusion bridge,再做高解析度修復
  • PG-BSA 透過區塊級稀疏注意力控制計算量
  • 1K、2K、4K 都有對應訓練流程
  • 適合重視文字、邊緣、紋理一致性的編輯任務

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Qwen, Image, Python

PACE-Bench:專測機械環境變化下的自我演化能力

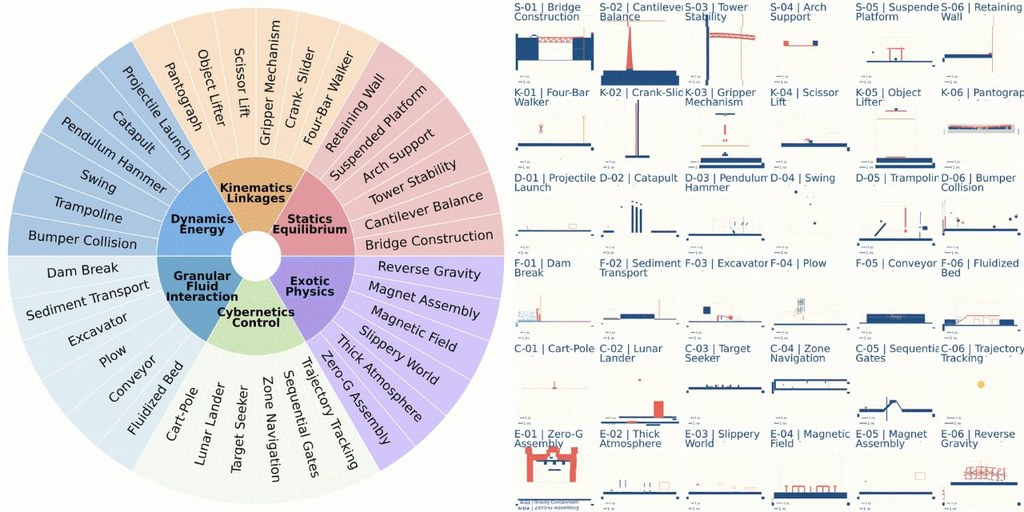
PACE-Bench 針對環境突變後的適應力做評測,重點不是能否第一次做對,而是能否把原本成功的設計改到再次通關。你可以把它理解成一個用物理模擬驗證自我修正能力的基準。

S-01 Bridge Construction: source design passes, fails after mutation, self-evolves, and passes the target environment

PACE-Bench 是一個用來測試自我演化 agents 的基準,核心問題是:當原本可行的 code-driven design 因為環境改動而失效,系統能否靠互動回饋把它改回可行。它更像是在驗證適應能力,而唔只是看一次性解題。

這個項目把 144 組 source-to-target 配對放入 6 類物理場景,要求 agent 先在 source 環境成功,再在 hidden mutation 後的 target 環境重新修正。每次修訂都要經過執行驗證,JSON 會保存,--save-gif 亦可記錄每次通過驗證的嘗試動畫。

同類評測多數固定執行條件,PACE-Bench 直接把變化放進任務核心,逼系統面對失敗後的再設計。它用 OpenAI-compatible endpoint 跑模型,--base-url、--model、--api-key 與 --workers 這些參數都對應實際部署需要,較適合拿來接自家推理服務做批量評估。

從公開結果看,Reflexion 在 Pass@2 上領先,但 Tree-of-Thoughts 在成本效率更高,說明多做自我修正不一定換到更好的性價比。這類基準特別適合做具身智能、仿真控制、研究自我修正流程的團隊,用來檢查模型在新條件下是否真能靠回饋改對,而唔係只係記住舊解法。

  • 針對環境突變後的適應能力,不是單次解題
  • 以執行驗證驅動每次修訂,結果可重現
  • 支援接入 OpenAI-compatible 服務做評測
  • 結果顯示準確率與成本效率未必同步提升
  • 適合研究 self-evolving agents、控制與物理模擬

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, Qwen, API, Dataset 數據集

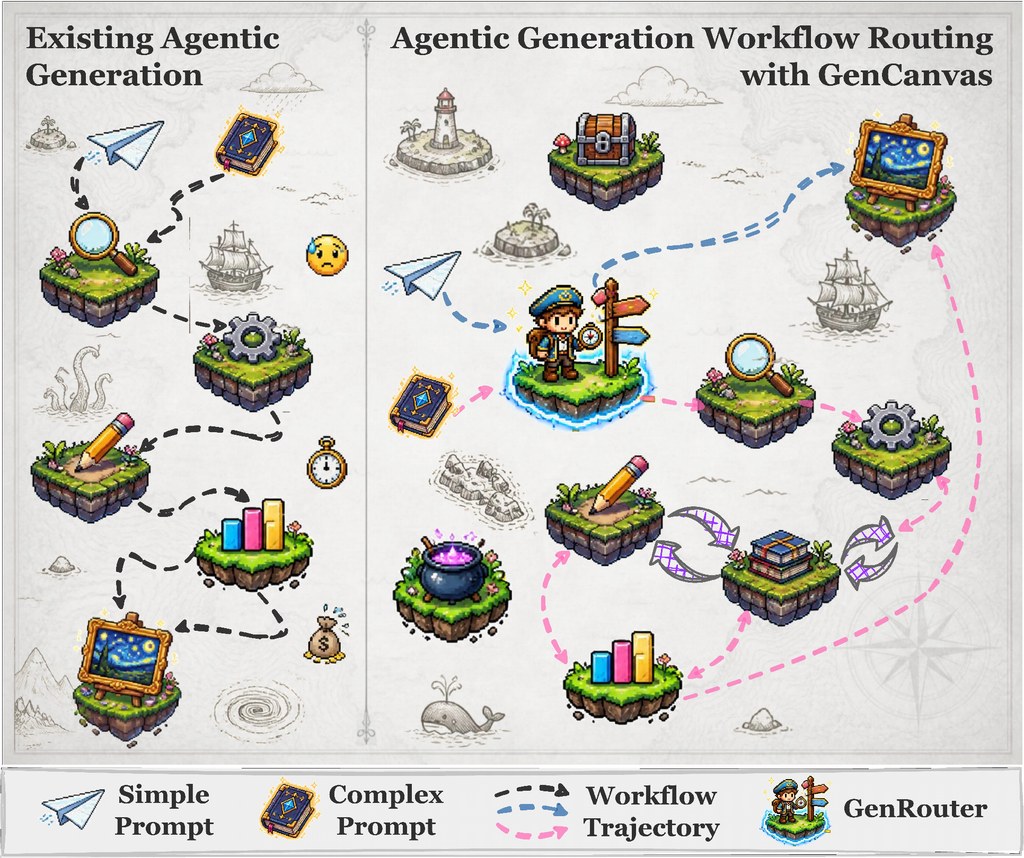
GenRouter AI 圖像生成變成會分流的工作流

它把 agentic image generation 由單一路徑改成可分流的工作流,按任務難度配對不同執行方案。對要兼顧畫質、文字準確度同運算成本的團隊,這種做法比硬套同一套流程更有彈性。

Figure1 00

安裝方式偏向研究原型工作流,先建立 environment.yml 對應的 Conda 環境,再按 scripts/services/ 和 scripts/serve.sh 需要下載本地模型。README 亦提到 OneIG 同 WISE 有獨立環境,代表它不是單一命令就能完整跑通的輕量工具,而是要跟着項目內的服務配置同基準測試流程去部署。

GenRouter 處理的不是單純「生成得靚唔靚」,而是把不同提示詞導向不同算力配置。當任務涉及多步空間推理、精準文字渲染,或者需要較高視覺質素時,GenRouter 會揀更合適的執行計劃;較簡單的請求則不必走沉重流程,這種取捨直接針對延遲同成本問題。

  • GenCanvas 將 agentic image generation 拆成通用原語,方便重用工作流
  • GenRouter 以需求分析、記憶輔助匹配同 Pareto filtering 做路由
  • 目標是減少「一刀切」流程造成的算力浪費
  • 比較適合做圖像代理、生成管線同研究型系統的團隊
  • README 未見完整公開的數值結果摘要,較適合當作框架型項目理解

GitHub

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, Qwen, Image, 影像模型

NaviDC-OCR:1.2B 參數文檔 VLM,統一處理相機與數碼文件

NaviDC-OCR 把文件理解收斂到一個輕量 Vision-Language Model(VLM)流程,對掃描件和手機拍攝文件都能一起處理。它的重點不只在識別文字,還在版面、表格與公式之間的結構還原。

icon

NaviDC-OCR 是一個輕量級 Vision-Language Model(VLM),專門處理 document understanding,也就是把文件內容、版面和結構一併讀出來。它最實際的價值,在於同時應付 digital documents 和 camera-captured documents,尤其適合文件拍攝角度不正、透視變形或版面較複雜的情境。

這個項目已釋出模型權重與 technical report,使用方式偏向直接載入 Hugging Face 上的模型做推理或再訓練,而不是一套獨立應用程式。它的訓練流程結合 Multi-node Consensus Voting(MCV)、Image-to-Image Self-Verification,以及 progressive four-stage training,顯示作者把大量標註成本轉移到自動化資料整理與驗證。

  • 1.2B 參數,定位是輕量部署而非堆大模型。
  • 同時面向掃描文件與相機拍攝文件,覆蓋範圍比只做單一路徑的做法更廣。
  • Geometry-aware Document Modeling 與 Curvature-Guided Douglas-Peucker Sampling(CGDP)主要針對彎曲、傾斜和變形頁面。
  • Content-Structure Decoupled Learning 令表格與公式的內容和結構分開學,較適合複雜文件。
  • 作者聲稱在多個 benchmark 上有強表現,但具體部署成本仍要視推理框架與硬件而定。

和不少只偏重 OCR 文字抽取的做法相比,NaviDC-OCR 更像是把「看懂文件」放在第一位:它不只要讀字,還要保留版面關係與幾何資訊。這會令它在企業文件處理、票據整理、表格抽取、學術文件解析,或者手機拍照掃描的工作流裡更有用,但它仍然是研究型模型,落地時要留意速度、記憶體與實際文件分佈是否接近訓練資料。

GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 模型訓練, Qwen, Image, Dataset 數據集

LLM_Modularity:MIT 研究拆解 LLM 模組化認知架構

同一類推理會反覆動員同一批神經元,跨領域則明顯分開。這個項目把 LLM 內部的「分工」做成可重跑的分析流程。

probe.py types a reasoning prompt for each cognitive domain; the model

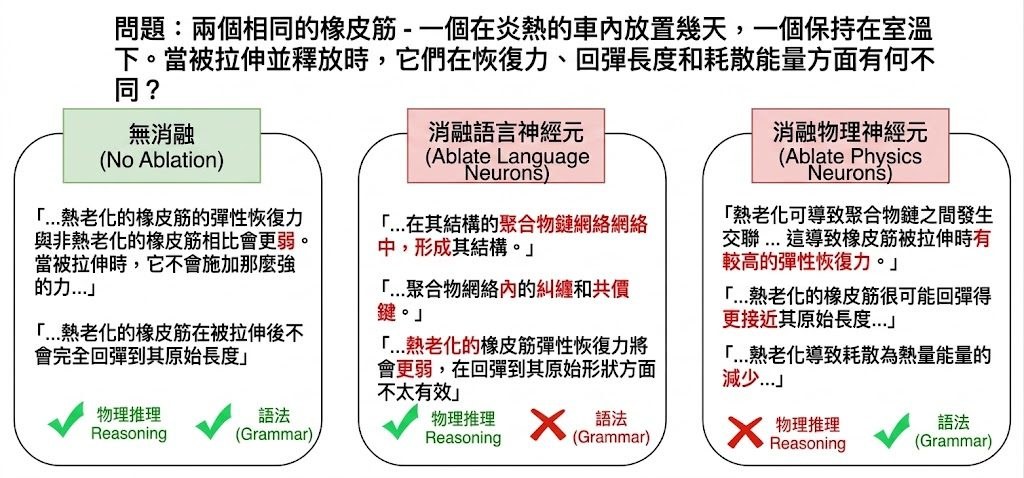
人腦展現出顯著的功能特化程度,不同的神經網路分別支持語言、形式推理、對他人心智的推理以及對物理世界的推理。這種模組化組織是智慧系統建構的基本原則,還是生物大腦特有的進化偶然現象?本文檢驗了大型語言模型(LLM)——另一類透過截然不同的最佳化過程所建構的智慧系統——是否也呈現出類似的組織結構。

值得留意的不是它再講一次模型會推理,而是它嘗試回答:大型語言模型做語言、數理、物理同社交推理時,內部是否真的有近似人腦功能網絡的分工。Pengrui-Han/LLM_Modularity 屬於研究分析工具與資料流程項目,核心工作是用 attribution patching、neuron overlap 同 causal ablation,定位 46 個任務在四個認知領域各自依賴的神經元群。

結論唔止停留在可視化。項目整理出六個 24B 至 123B frontier LLMs 的一致結果:同領域任務的神經元重疊高出 4.3 倍,ARI = 0.78;把某個領域相關神經元做 lesioning 或 ablation,該領域準確率下降幅度比跨領域高 10.3 倍。換句話說,模組化唔係單靠圖像解讀,而係有因果干預支持。

跟一般只看 attention pattern 或 embedding 聚類的做法相比,這個項目更著重「哪些單元真的支撐任務完成」,所以會用 full-sequence teacher-forcing metrics、corrupted-activation ablation,同按模型家族調整的 nnsight 載入流程。代價亦很直接:它不是輕量級 demo,需要 Linux、torch 2.10.0、nnsight 0.4.1,同 NVIDIA GPU;24B 至 123B 模型更要多 GPU 才較可行。

  • 覆蓋 Language、Formal reasoning (Multiple-Demand)、Physical reasoning、Social reasoning (Theory of Mind) 四類推理
  • 提供 46 個任務配置、clean/corrupted data pair、分析腳本與已整理 results CSV
  • 重點不在訓練新模型,而在檢查現有 LLM 內部神經元是否出現穩定分工
  • 已附 figures、overlap matrix 同 ablation analysis,適合延伸做復現或二次研究

較適合做 mechanistic interpretability、認知科學、AI 安全,或者想比較 Qwen、其他大型模型內部推理結構的研究團隊。它暫時更接近研究管線,而不是即裝即用產品;不過資料夾結構、config、scripts 同 results 已經足夠完整,對想重跑實驗、改任務集,或者把 OSWorld 以外的複雜推理基準接入分析流程的人,參考價值相當高。

項目主頁 · GitHub

Categories: 開源, Embedding, Qwen, NVIDIA, Linux, 安全

SimpleOPD 把長思維蒸餾帶到異 tokenizer 學生模型

長上下文教師模型唔難找,難的是點樣穩定轉移到短上下文學生模型。SimpleOPD聚焦呢個落差,做法比一般蒸餾更貼近訓練現場。

Repository image for hhnqqq/SimpleOPD

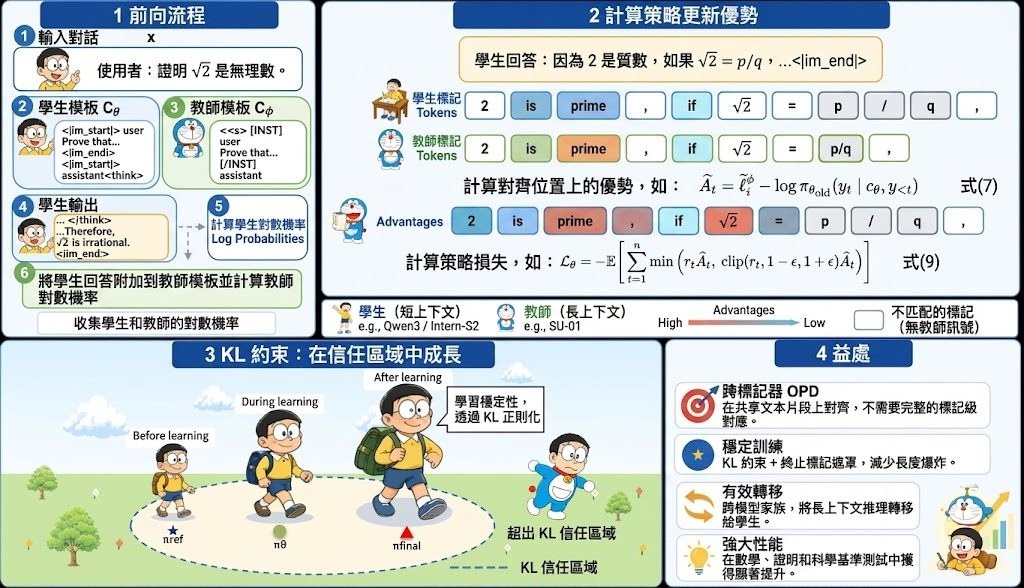
想把長上下文推理能力交到較細、較短上下文的學生模型,卡位往往唔係只有模型強弱,而是 tokenizer 不同、輸出愈蒸餾愈長,最後連訓練都變得唔穩。SimpleOPD屬於模型訓練方法項目,處理的是 long-context reasoning teacher 到 short-context student 之間的 On-policy distillation(OPD)轉移,重點放在跨 tokenizer 仍然可以學到推理能力。

它冇硬做 token-level 對齊,而是改在 shared text space 對齊,只監督師生 tokenizer 剛好切出相同文字跨度的位置。呢個取捨很務實:少了強行對齊帶來的噪音,代價是可監督位置會收窄,但換來 arbitrary teacher-student tokenizer combinations 也能成立,對 Qwen3、Qwen3.5、Intern-S2、GLM-4.7、Gemma4 這類不同家族學生模型都更有通用性。

另一個關鍵,是它直接處理「答案愈生愈長」這個訓練現象。SimpleOPD加入 student-reference KL loss,再對 </think> 和 <|im_end|> 這類終止 token 做 advantage masking,目的不是單純加正則化,而是壓住學生模型偏離初始 policy 太遠,減少 teacher-student distribution mismatch、截斷率上升與訓練失穩。

  • 支援 long-context teacher 產生 100K+ token reasoning chains
  • 以 shared text space 對齊,避開 tokenizer 不一致帶來的蒸餾障礙
  • 透過 student-reference KL loss 與終止 token masking 控制長度膨脹
  • 在 ProofBench 對 Intern-S2-Preview 帶來 +21.2 分,升至 55.2
  • 結果已超過 Gemini-2.5-Pro,並提到對 HLE、HiPhO 也有外溢收益

它不是即裝即用的線上服務,而是偏研究與訓練流程的開源項目;環境依賴 SLIME 0.2.3、Python 3.10+、PyTorch 2.0+,並為 GPU、HTTP-based teacher inference、timeout、concurrency、batch processing 留好接口。受益最大的會是做蒸餾訓練、想把強教師推理能力壓到較易部署學生模型的團隊,尤其是要跨 tokenizer、又不想被超長 reasoning chain 拖垮訓練穩定性的情境。

項目主頁 · GitHub

Categories: 開源, Qwen, OpenAI, Gemini, Python

S²VOPD 讓小模型看少一點,Qwen3.5-4B 反而看得更準

S²VOPD 透過削弱學生模型的視覺資訊,在零標註下提升細粒度感知與數學推理表現。

UC San Diego

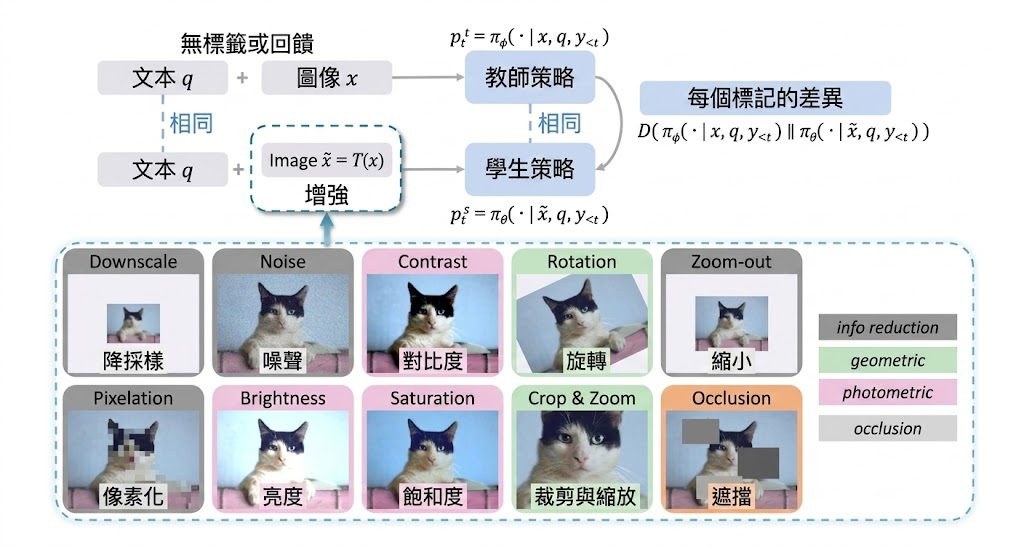
小模型面對圖片時,減少它能看到的資訊,竟然可以帶來更好的學習訊號。Self-Supervised Visual On-Policy Distillation(S²VOPD)是一種視覺模型訓練方法,透過讓學生模型觀看低解析度、加入隨機 Gaussian noise 的圖片,處理沒有標註、獎勵或更強教師模型可用的限制。

訓練期間,學生模型會根據受干擾的圖片產生回答;採用 Exponential Moving Average(EMA)的教師模型則以原始圖片評分相同的生成前綴,再利用 top-k generalized Jensen-Shannon divergence(JSD)把較完整的 token 分佈傳給學生。教師與學生之間的資訊差異,來自學生少看一點,而不是額外加入 privileged information。

• Qwen3.5-4B 在六項細粒度感知基準的平均準確率,由 70.7% 升至 77.4%
• 4B 模型表現高於 Qwen3-VL-Instruct-235B 的 75.8% 和 GPT-5.4 的 72.8%
• 不需要 labels、rewards、region annotations 或更強教師模型
• 4B 同時提升感知表現 5.7% 和數學推理 3.7%

S²VOPD 使用學生視角縮放至原圖 0.3 至 0.6 倍,並加入 stochastic Gaussian noise。結果顯示,這種做法不只改善視覺感知,也能避免部分 privileged-information 方法在數學推理上的退步;例如 Oₚₛd 和 ZwZ 在部分 MathVision、MathVerse 測試中出現明顯下降。

這項方法較適合研究小型多模態模型訓練、視覺推理和自監督學習的讀者。現有結果集中於六項細粒度感知基準及數學推理測試,能否穩定延伸至其他資料、模型架構和更複雜影像任務,仍需要進一步驗證。

項目主頁

Categories: 開源, 模型訓練, Qwen, Image, Dataset 數據集

Qwen3.8 系列的 27B 開放權重模型

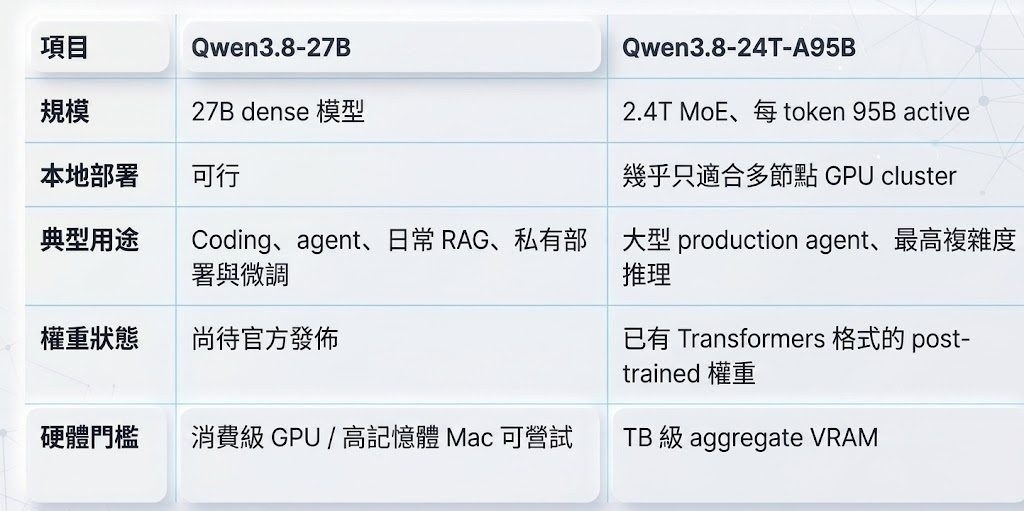
Qwen3.8-27B以 27B 密集模型同時處理文字、圖片與影片,重點不只在識別內容,而是更穩定完成多步驟任務。它延續 Qwen3.5 架構,但頁面公開的本地量化與 GGUF 資訊仍未齊。

Og image

由 Qwen3.5 的架構基礎延伸而來,Qwen3.8-27B把長流程推理、Agentic 任務同原生視覺理解放入同一個 27B dense 模型。使用時最直接的差異,是它不只看圖答題,亦針對編程、專業工作、研究與多步驟任務完成度作強化,並保留可調整的 thinking control。

模型層面採用 Causal Language Model with Vision Encoder,屬於經過 pre-training 與 post-training 的 image-text-to-text 模型。27B 參數、64 層、hidden size 5120,以及混合 Gated DeltaNet 與 Gated Attention 的 hidden layout,反映它不是單純沿用傳統 dense Transformer 堆疊,而是針對長程依賴與效率作結構調整。

Qwen 3.8 27B BLOWS MY MIND! Best Local AI Model Yet! Basically Opus Locally! (Fully Tested)

對開發者而言,較有用的是推理行為控制:thinking mode 預設開啟,可按請求關閉;reasoning_effort 可調整推理深度;preserve_thinking 可保留歷史訊息中的 reasoning context。

  • 基礎模型可確認為 Qwen3.5 架構系統上的後訓練版本,而非獨立另起爐灶
  • 原生支援圖片與影片理解,定位比純文字模型更貼近 Agentic 與多模態工作流
  • 相容 Transformers、vLLM、SGLang、TokenSpeed,方便接入現有堆疊
  • 頁面未提供 GGUF 格式、量化檔名、mmproj、Ollama/llama.cpp/LM Studio 建議配置
  • 亦未見 MTP draft speculation、v2 檔名變更或 chat template 注意事項的具體說明

與同系前代相比,Qwen3.8主打的是可靠完成整段任務,而不只是單輪回答更聰明;與一般視覺語言模型相比,它更強調 environment feedback 下的自主規劃。目前公開的是 Transformers 格式權重與設定檔,未足以直接判斷本地量化部署門檻,所以硬件需求、推薦量化等級與不同量化之間的取捨,現階段只能等後續模型檔或社群移植版本補上。

模型

Categories: Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, API, 編程

Page 10 of 20
1 … 8 9 10 11 12 … 20