OmniAssistBench:以多輪互動評測即時影片助手的表現

OmniAssistBench 以 LLM-as-a-Judge 固定互動路徑測試 Omni-LLMs 的多輪影片助手能力,涵蓋685組開放式問答、7類任務,影片含自然語音、打字或手寫提示。評分顯示 Gemini-3-Pro 以66.4分領先。

OmniAssistBench proposes an annotation pipeline which allows annotators to build test samples from existing Internet vid

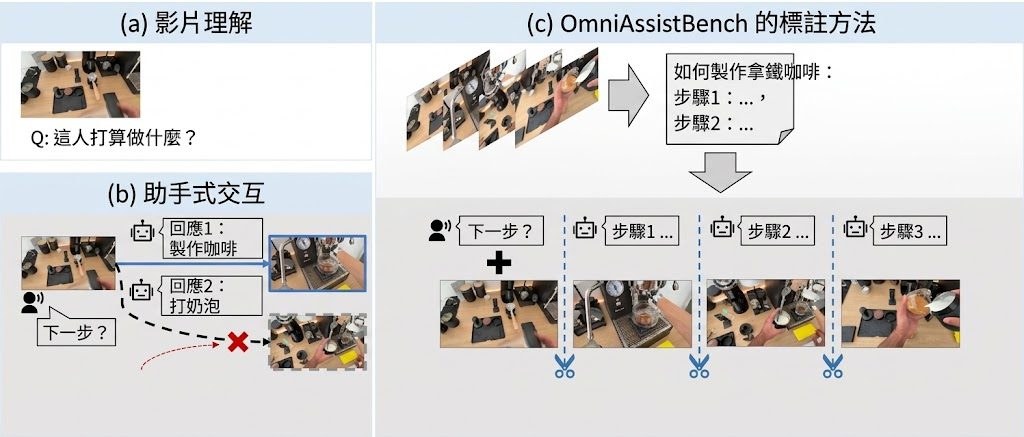
當影片助手的回答會改變使用者下一步行動,傳統只對固定影片問答的測試便難以反映真實體驗。OmniAssistBench 屬於 Omni-LLMs 的影片助手評測基準及數據集,透過固定互動路徑,處理多輪對話中影片內容會隨模型回應變化的問題。

項目涵蓋 685 組開放式問答,分成 Basic Tier 與 Advanced Tier,涉及社交理解、時間感知、手勢提示、程序指導及主動回應等 7 類主要任務和 16 類細分任務。影片取材自運動、煮食、講課、DIY 及談話節目,另有 3 個自行拍攝案例,每個平均超過 15 輪互動;問題會以自然語音、打字或手寫方式嵌入影片,而不是只放文字提示。

  • 以影片連同對應音訊輸入模型,再按互動回合回答問題
  • 由專家先整理影片步驟,再剪輯片段及加入字幕,固定測試路徑
  • 評分採用 LLM-as-a-Judge,原始 0 至 5 分再換算為 0 至 100
  • 建立數據集耗用超過 1,000 小時專家工時

這種做法比靜態影片問答更貼近助手場景,但固定路徑亦代表其他合理回應未必能在同一測試中獲得充分反映。Project homepage 的排行榜顯示,Gemini-3-Pro 整體得分為 66.4,Gemini-2.5-Pro 為 64.6,商用及開源 Omni-LLMs 都只達部分正確,反映可靠的即時影片助手仍有明顯改進空間。

研究團隊來自南京大學、南開大學及 University of Waterloo。測試者需要按照項目提供的評測流程處理影片和音訊,相關 Dataset、Project Page 及評估程式碼可供查閱;正式採用前應先確認版本、存取權限及評分流程是否已更新。
項目主頁 · GitHub

Categories: 開源, 南京大學, 字節跳動, Qwen, Gemini, Dataset 數據集

[技術文章] RecVerse 讓購物代理更像真人行為

RecVerse以分層記憶和整段軌跡訓練,模擬更貼近真人的網上購物流程。

Hero image preview

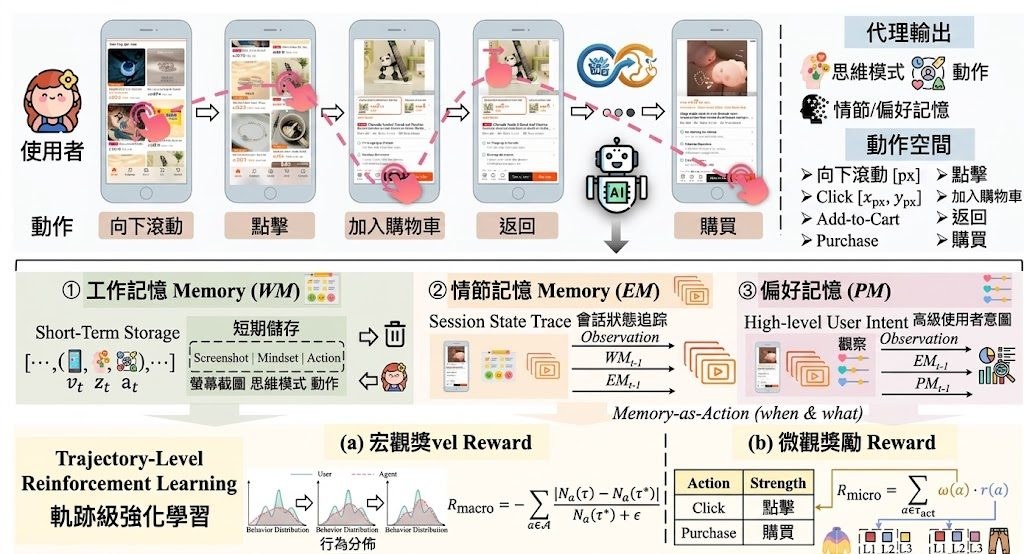
網上購物模擬器要重現真人由瀏覽、比較到購買的連續決定,才能支援推薦系統的離線測試和 Reinforcement Learning(RL)訓練。RecVerse 是一個以 GUI 為基礎的模擬代理,透過螢幕截圖理解頁面,生成多輪購物軌跡,處理長時間瀏覽中用戶狀態不斷變化的問題。

現有做法各有缺口:Rule-based simulators 依賴向量化商品特徵和預設行動空間,難以涵蓋複雜的電商介面;Large Language Models(LLMs)和 Vision-Language Models(VLMs)代理雖然加入推理及 persona 建模,長會話仍可能丟失早期觀察,或者把所有歷史硬塞進 context window。逐步模仿每個已記錄行動,亦可能令整段流程出現過度探索或過分被動等不自然模式。

RecVerse以認知啟發的分層記憶處理長期資訊,包括短期焦點用的 Working Memory、保存本次會話軌跡的 Episodic Memory,以及記錄高層次意圖的 Preference Memory。記憶更新本身被視為行動,代理可以按情況學習何時及應該保存哪些資訊。

訓練時,系統改用 trajectory-level RL,直接為完整購物會話評分,同時對齊真人的宏觀行動類型分佈和微觀購物意圖。研究團隊亦發布 USB(UserSimulationBenchmark)互動式電商 GUI 軌跡數據集;實驗結果指 RecVerse 在行為忠實度和意圖一致性上均優於現有基線。

  • 以螢幕截圖理解電商 GUI,生成多輪購物行為
  • 透過三層記憶保留短期焦點、會話經歷和用戶偏好
  • 用完整軌跡目標修正逐步模仿帶來的不自然行為
  • USB 提供互動式電商 GUI 軌跡數據集
  • 可用於推薦策略的離線及反事實測試

Paper

Categories: 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, 中國

AgentMercury 生成可驗證商業世界

把企業情境轉成可執行環境,讓AI代理在多服務流程中訓練,再轉移到未見過的評測項目。

Og image

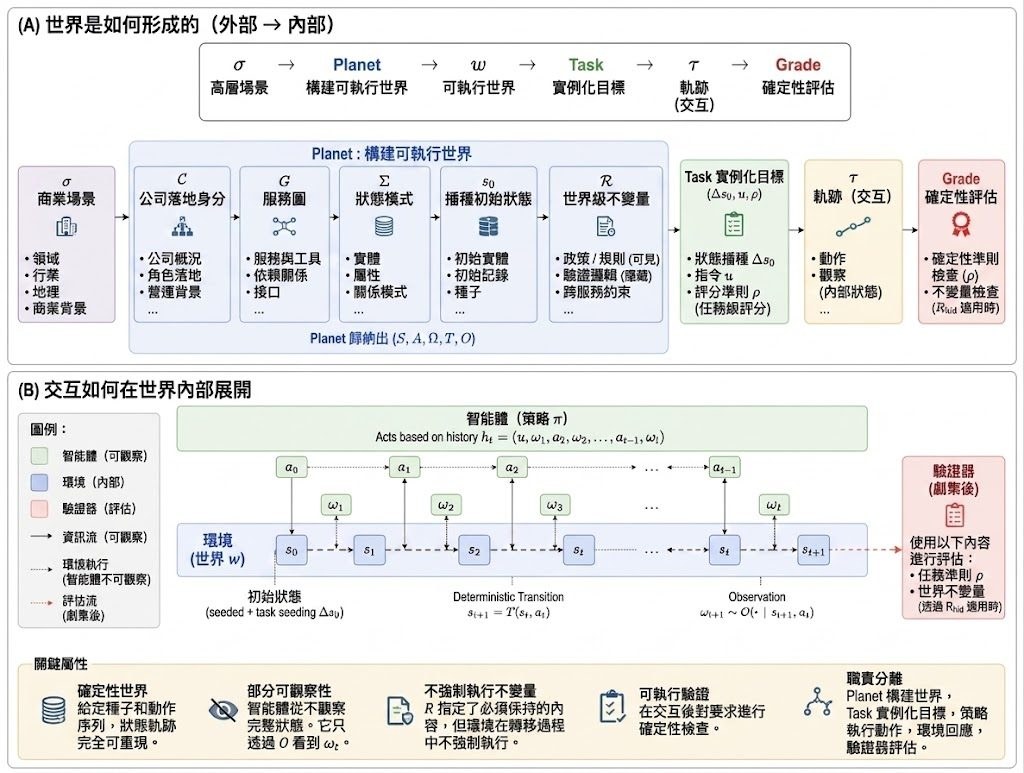
當AI代理要處理跨部門企業流程,難點往往不只在於選擇工具,還要在多個服務之間維持一致狀態,最後交出可以核實的結果。AgentMercury是一個用於訓練 Computer-use agents(CUAs)的環境生成項目,讓高層次商業情境直接變成可執行、可重播和可驗證的虛擬世界,代理可以在其中進行多輪操作,而系統會按完成後的狀態計算獎勵。

常見做法會先為指定任務或 benchmark 手工建立環境,環境自然只覆蓋測試者預先想到的流程。AgentMercury則把環境建構本身交給 Planet:它由公司身份、服務圖、資料表結構、初始狀態和跨服務不變條件組成一個完整世界,再由 Task 在共享世界上加入不同目標和評分規則。一個世界可以承載多個任務,減少每個新流程都要重新造環境的成本。

驗證條件主要以環境資料庫上的 SQL 形式執行。代理完成一輪操作後,系統會根據任務 rubric 和隱藏的不變條件,對整條 trajectory 進行確定性評分;環境不會在每一步替代理判斷對錯,代理必須自行處理跨服務要求,完成後才接受檢查。這種安排讓結果可以重播,也令 Reinforcement Learning(RL)訓練得到較穩定的回饋。

目前項目整理出4,783個 executable worlds,涵蓋14個產業和50個國家,包含13.98M seeded state rows、842種工具和43,300個可驗證 RL 任務。典型世界約有13項服務、65種工具、31張狀態表,以及約15個以 SQL 編寫的 deterministic verifiers;訓練資料涉及4,326個公司環境,但 Qwen3.5-4B 的報告只使用其中3,200個任務取得梯度,仍覆蓋53.5%的環境、62.9%的產業和75.8%的工具。

項目以 Qwen3.5-4B 和 Qwen3.5-35B-A3B 進行 RL 訓練,代理透過 Model Context Protocol(MCP)操作即時形式的商業軟件,並以 GRPO(Group Relative Policy Optimization)為主要優化方法,SAO 則作為另一種選項。Qwen3.5-4B 的平均獎勵約由0.25升至0.53,截斷回應比例由78%降至3%;在未參與訓練的 EnterpriseOps-Gym 八個企業領域,平均分數由12.3升至15.7,增幅為27.6%。35B-A3B 使用 GRPO 和 SAO 後,平均分數分別由24.8升至28.1及28.3,但結果仍屬項目所報告的訓練和評測範圍,未代表代理已能可靠處理所有企業工作。

  • 將高層次商業情境編譯成可執行世界,而不是只為單一任務造環境
  • 以共享資料庫、SQL 驗證條件和可重播評分檢查跨服務結果
  • 提供4,783個環境、842種工具和43,300個可驗證 RL 任務
  • Qwen3.5 系列在多輪 MCP 工具操作訓練後,獎勵和未見領域表現均有改善
  • 仍需留意合成環境與真實企業軟件之間的差距,以及評測範圍有限的問題

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, Qwen, Dataset 數據集

InfinityEdit:支援多輪連續編輯嘅開源影片框架

InfinityEdit 將影片編輯變成連續接力,每個指令都在上一段結果上再延伸。它適合要處理長片段、持續畫面同多輪改動嘅場景。

Pianist source video thumbnail

InfinityEdit 係一個影片編輯框架,核心問題唔係單次改一段短片,而係面對持續流入嘅影片,連續套用多個指令,令後一段自然接住前一段,仲要保住畫面連貫。對做長片生成、直播式視覺改寫,或者需要一路加指令一路修正畫面嘅工作流程,佢處理嘅正正就係「編輯唔可以只限喺固定片段內」呢個限制。

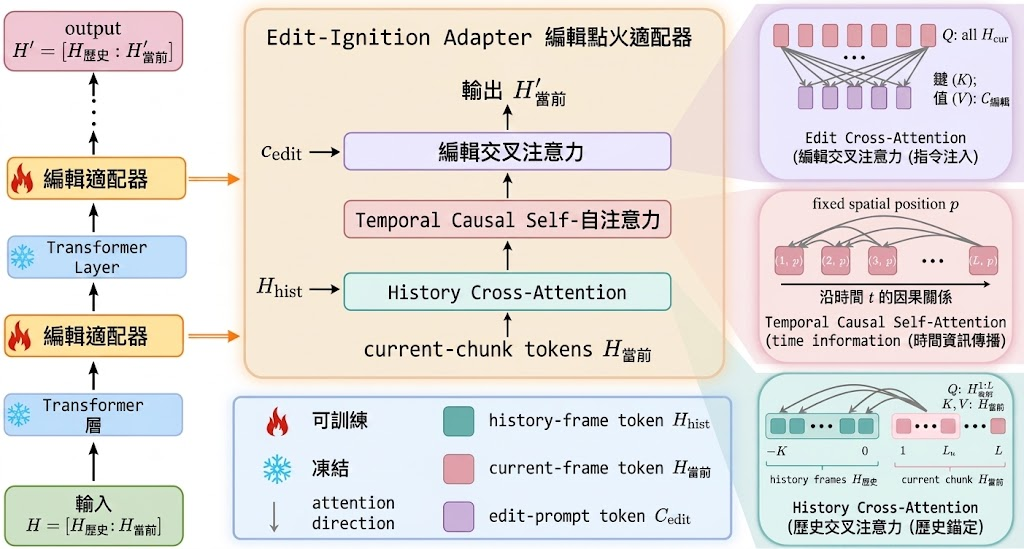
佢嘅做法係喺凍結嘅 video diffusion backbone 上面加一個輕量嘅 Edit-Ignition Adapter,令原本負責串流生成嘅模型多咗三層訊息路徑:歷史畫面引導、時間因果注意力,同埋編輯指令注入。生成時只會喺有新編輯指令到達嘅那一段啟動 adapter,之後嘅片段就交回原模型接力,記憶體負擔唔會一路膨脹。

項目提供訓練程式同多輪推理流程,安裝方法都幾直接,先建 Python 3.11 環境,再裝 requirements.txt,之後下載基座模型 Helios-Distilled。訓練分兩階段,第一階段學基本編輯能力,第二階段再針對低噪聲細節同時間權重做修正;推理則會輸出一串 source.mp4edit_1edit_2 之類嘅連續結果,方便睇到每次指令點樣疊落去。

同一般固定源片逐格改寫嘅方法相比,InfinityEdit 睇重嘅係「延續」而唔係「覆寫」。呢個取捨令佢更貼近長影片、持續鏡頭、反覆編修呢類工作,但亦意味住訓練資料要先做 VAE latent 同文字 embedding 預處理,流程比即插即用工具重少少。官方展示同評估都集中喺長片生成同多輪 sequential editing,顯示佢嘗試解決嘅唔係單次風格轉換,而係編輯累積後仍然保持穩定。

  • 支援多輪順序編輯,每次指令都建立喺上一段已編輯內容之上
  • 以凍結 backbone 配合輕量 adapter,改動集中,唔需要重寫整個生成模型
  • 適合長片生成、持續鏡頭改寫、分段式影片修正呢類場景
  • 訓練同推理都已經拆好流程,但前期資料預處理同模型下載仍然係必要步驟
  • 評估重點放喺長序列穩定性同編輯連貫性,而唔係單一片段嘅局部改動

對做影片生成、研究串流式編輯,或者想將文字指令一路疊加到同一條影片流嘅團隊,呢個項目提供咗一個較完整嘅技術路線。佢唔係追求一次過改到最盡,而係用較細嘅介入,令編輯可以一路接力落去,仲保持住原本生成器嘅長片能力。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Embedding, Video, 框架, Python

[技術文章]LLM 媲美 Embedding,成本卻高逾 1431 倍

LLM已能追上頂尖Embedding模型,但搜尋系統未必值得因此承受高昂成本。

Hugging Face

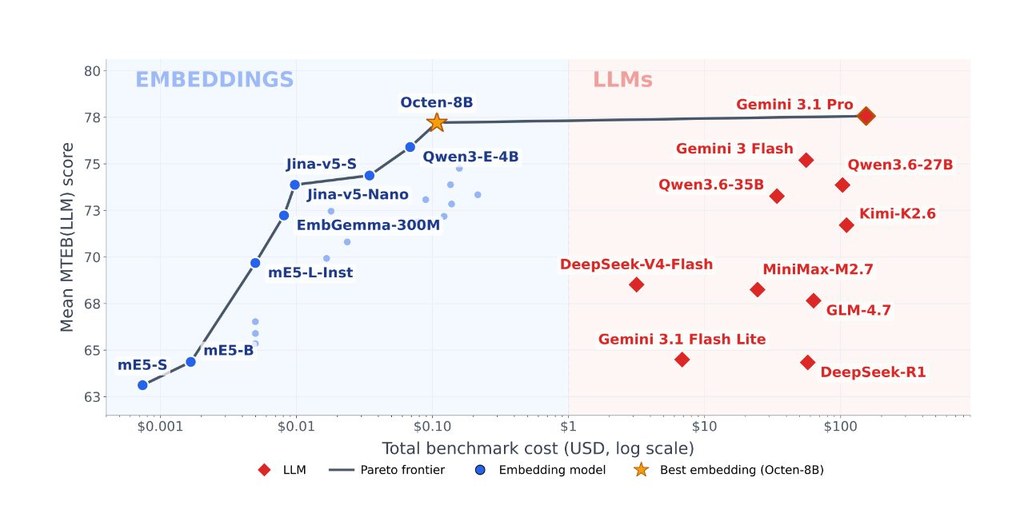
做語意搜尋、分類或文件聚類時,LLM已能在多項測試追上專門的文字嵌入模型;但每次評測成本最高相差1,431倍,令「是否應取代Embedding pipeline」成為成本與能力之間的取捨。本頁屬研究論文內容,並非可直接下載的單一模型頁面;未有提供可確認的 base model 或 fine-tuned from 資訊,因此無法判定某個模型的原始基礎模型。

研究比較10個、來自6個家族的 large language models (LLMs),以及26個參數量由118M至14B的 embedding models,測試涵蓋37項 MTEB(LLM) 任務,包括分類、semantic textual similarity (STS)、聚類、pair classification 和 retrieval。最佳 LLM Gemini 3.1 Pro 得分77.6,最佳 embedding model 得分77.2,差距只有0.4分。

  • Embedding models 在分類、相似度和聚類表現較合適
  • LLM 在需要推理的 retrieval 任務較有優勢
  • LLM 每次 benchmark pass 成本約154美元,embedding model 約0.11美元
  • 開源 LLM 在同一 GPU 上慢約2.5至736倍
  • reasoning tokens 佔 LLM inference 成本28%至81%

研究亦指出,降低 reasoning budget 對多數模型的 retrieval 品質沒有明顯傷害,反映混合式流程更合理:以 embedding model 負責大部分相似度搜尋,再把需要理解語境或多步推理的查詢交給 LLM。

Paper

Categories: Embedding, Qwen, Gemini, LLaMa, Ollama, Dataset 數據集, Kimi

VoxEMW:把 Mac 變成 1.3 秒回應的私人語音助手

VoxEMW 將語音處理放在 Apple Silicon Mac,手機只需透過瀏覽器或 iOS 客戶端對話,回應速度與音色克隆是最大賣點。

Repository image for emwstudio/VoxEMW

對住手機講完一句話,約 1.3 秒後便聽到固定角色用克隆聲線回答,VoxEMW 屬於開源語音助手項目,處理判停、轉寫、對話調度及語音合成,解決語音對話延遲高、角色聲線難以保持的問題。Mac 負責主要語音管線,只有 LLM 大腦經 DeepSeek API 上雲,日常成本相對可控。

整套流程由 Silero 加 SmartTurn 負責判斷何時真正講完,Qwen3-ASR-0.6B-hf 在 MPS 上轉寫,再由 DeepSeek v4-flash 產生回覆,Qwen3-TTS-1.7B-Base 以 MLX 6bit 執行零樣本音色克隆。參考聲音配合逐字台詞便可註冊角色,首段聲音約 0.5 秒生成;中途打斷時,已播放及已聽內容會寫回上下文,對話較不容易斷層。

一块 4090 跑通 AI 视频通话全栈:Qwen3.8-27B 本地部署,对话时延 2 秒

項目需要 Apple Silicon Mac 作本地伺服器,實測以 M5、16GB 記憶體可以流暢運行,模型及環境約需下載 4GB。瀏覽器可直接連接本機介面;iPhone 或 iPad 則要透過局域網 HTTPS/WSS 連線,並自行處理 TLS 證書、Xcode 簽署及免費帳戶七日側載限制。

• 回應最快 1.26 秒,中位數約 1.6 秒,實際速度仍受網絡及 API 影響
• VAD、STT、TTS 留在本機,DeepSeek API 按 token 收費
• 支援流式字幕、空回覆重試及語音中斷後續接
• 全屏星空會隨說話及聲波變化,增加角色互動感

相比全程雲端方案,VoxEMW 減少語音資料離開家中 Mac,但需要一部 Apple Silicon Mac 長期運行;相比完全離線方案,DeepSeek API 帶來額外費用及資料傳輸考慮。適合想建立固定聲線角色、研究低延遲語音管線,或有 Mac 作家庭伺服器的開發者,普通使用者則要先接受證書、模型環境及 API 金鑰設定等門檻。

GitHub

Categories: 開源, 文字轉語音, Qwen, DeepSeek, API, 框架, Mac, 語音, 蘋果

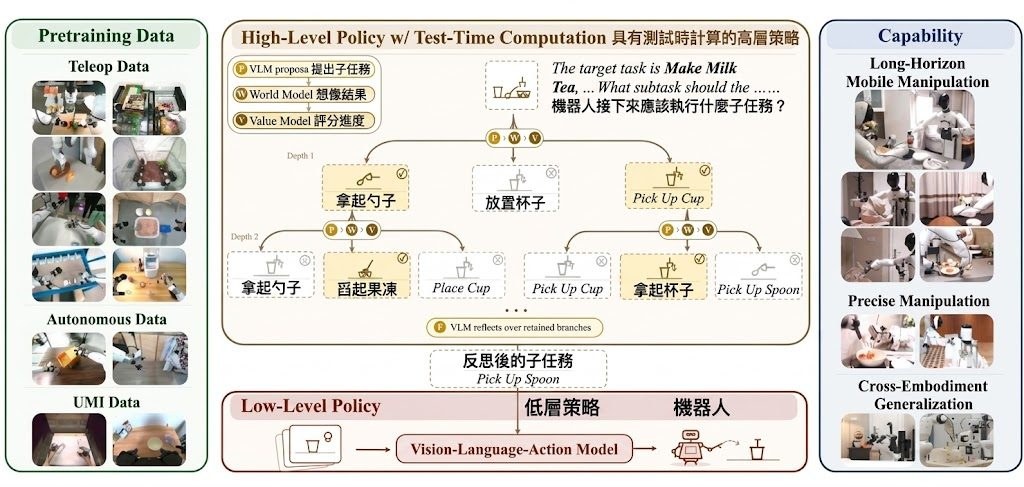
τ₀-VLA:為長程機械人任務補上分層推理

τ₀-VLA 把長程機械人操作拆成高層規劃與低層執行,先想下一步,再落到實際動作。它特別針對多步驟、要記住進度又要回復失誤的場景。

τ₀-VLA overview

τ₀-VLA 是一個機械人基礎模型,主打長程操作任務,例如清理房間、準備食材和沖奶茶這類要連續完成多個步驟的工作。它先用帶記憶的高層策略決定下一個子任務,必要時再用 world-model-guided test-time computation 比較不同做法,然後交由低層策略執行。

這種分層方式比單次前向推理更適合處理長流程,因為模型不只要做動作,還要跟進已完成進度、預測結果,再決定下一步。對需要機械人跨場景操作的團隊來說,比只處理單一步驟的控制模型更接近真實工作流程。

  • 高層負責規劃子任務,低層負責具體控制
  • 會在需要更多推理時做分支搜尋,不是即時拍板
  • 低層策略結合 Qwen3.5 vision-language backbone 與 Mixture-of-Transformers action expert
  • 訓練資料來自 40,115 小時真實機械人數據,涵蓋多模態協同訓練
  • 目前公開 v1 只支援 joint-control checkpoints,EEF serving 未提供

官方提供 Python 3.11、CUDA 12.8、PyTorch 2.7.1 的參考環境,也有 example_data 同配置的 post-training 例子,可用來接入自己的資料集或機械人設定。文中四個長程任務涵蓋 13 至 25 個步驟,重點不只是在動作準確,還包括進度保持、結果驗證和失誤後恢復。

對做機械人研究、具身智能系統,或要把語言理解和實體控制接起來的團隊,這個項目提供了一個較完整的分層基線;限制也很明確,公開版本先集中在 joint-control,較適合有相應訓練與部署條件的環境。

項目主頁 · GitHub · 模型

Categories: 開源, 多模態模型, 模型訓練, Qwen, NVIDIA, VLA, World-Action Model, Python

Qwen-Video-Edit:開源影片編輯模型

它把文字指令式影片編輯做得更直接,透過現成的 image editing model 去改寫影片 latent。對需要長片段、分段修改同一條影片的工作流,會比重起一套 video transformer 更省力。

input contact sheet

Qwen-Video-Edit 是一個 instruction-based video editing 項目,核心做法是把 Qwen-Image-Edit 直接搬去處理影片 latent,再用兩個可訓練 projection 接上 Wan 2.1 的 video-VAE。這樣做的價值很清楚:不用再依賴 video-pretrained transformer,也能按文字指令改影片內容。

安裝和測試路線已經整理得相當明確。train.py 走單機多 GPU 訓練,infer.py 負責長影片逐段編輯與 Wan 2.2 denoising-enhancement,dataset.py 則讀取 Ditto 格式的 source、edited、instruction 配對。

和一般影片編輯方法相比,差異在於它不是從頭學影片理解,而是借用影像編輯模型的先驗,再用 warm-started projections 與 grid positional encoding 去補上時間維度。這代表訓練成本和架構複雜度較低,但限制也在於效果仍仰賴 Wan 2.1 latent 空間、Ditto-1M 資料,以及後段 enhancement。

  • 支援 LoRA 或 full fine-tuning,取捨在訓練成本與自由度之間
  • 長影片可以分段套用不同指令,適合剪接、局部修改、旁白對齊內容
  • 輸出 checkpoint 以 trainable-weights-only .safetensors 形式提供,載入流程較直接
  • 另有 zero-training demo,可先看 image-grid 與 latent-grid 編輯行為
  • 模型權重已公開,方便直接做復現或二次改造

項目主頁 · GitHub · 模型

Categories: 開源, 視頻模型, 模型訓練, Qwen, Video, Image, 影像模型, Dataset 數據集

EditBridge 更穩定的4K 影像編輯

EditBridge 把低解析度編輯和高解析度修復接起來,避免放大時細節走樣。它適合要保留原圖紋理、文字和結構的影像編輯流程。

Overview of the EditBridge paradigm

EditBridge 是一個影像編輯框架,目標很直接:在 1K 到 4K 的高解析度輸出下,仍然保住原圖細節,而不是放大後再補出一堆不一致的紋理。它把粗編輯結果先交給 diffusion bridge 再修復,讓高解析度原圖繼續參與推理,不用把整張圖重生成一次。

和常見做法相比,它的取捨在於把「補細節」改成「沿著已對齊的內容做橋接」。核心做法是 PG-BSA(prior-guided block-wise sparse attention),用先前編輯階段的對應關係去挑選需要看的區塊,減少密集全局注意力帶來的成本,同時降低高頻細節失真。

倉庫已經交代了基本使用路線:先建立 Python 環境,再安裝項目,下載 Qwen-Image-Edit-2509 checkpoint,之後用 CSV 準備 source_image、target_image、condition_image 和 prompt。訓練時還要先抽取 target-to-source correspondences,1K、2K 與 4K 的流程分開處理,4K 版本則透過降低記憶體消耗來跑。

這套方法較適合做高解析度修圖、產品圖改寫、海報文字修正,或者任何不能接受放大後失真、塗抹感太重的工作流。它的評估重點也很清晰:在 1K 到 4K 的 reconstruction 和 perceptual metrics 都維持領先,推理時間比直接高解析度生成和傳統 diffusion 超解析度方案更實用。

  • 保留原始高解析度 source 作為條件,減少細節漂移
  • 用 coarse edit 接 diffusion bridge,再做高解析度修復
  • PG-BSA 透過區塊級稀疏注意力控制計算量
  • 1K、2K、4K 都有對應訓練流程
  • 適合重視文字、邊緣、紋理一致性的編輯任務

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Qwen, Image, Python

PACE-Bench:專測機械環境變化下的自我演化能力

PACE-Bench 針對環境突變後的適應力做評測,重點不是能否第一次做對,而是能否把原本成功的設計改到再次通關。你可以把它理解成一個用物理模擬驗證自我修正能力的基準。

S-01 Bridge Construction: source design passes, fails after mutation, self-evolves, and passes the target environment

PACE-Bench 是一個用來測試自我演化 agents 的基準,核心問題是:當原本可行的 code-driven design 因為環境改動而失效,系統能否靠互動回饋把它改回可行。它更像是在驗證適應能力,而唔只是看一次性解題。

這個項目把 144 組 source-to-target 配對放入 6 類物理場景,要求 agent 先在 source 環境成功,再在 hidden mutation 後的 target 環境重新修正。每次修訂都要經過執行驗證,JSON 會保存,--save-gif 亦可記錄每次通過驗證的嘗試動畫。

同類評測多數固定執行條件,PACE-Bench 直接把變化放進任務核心,逼系統面對失敗後的再設計。它用 OpenAI-compatible endpoint 跑模型,--base-url--model--api-key--workers 這些參數都對應實際部署需要,較適合拿來接自家推理服務做批量評估。

從公開結果看,Reflexion 在 Pass@2 上領先,但 Tree-of-Thoughts 在成本效率更高,說明多做自我修正不一定換到更好的性價比。這類基準特別適合做具身智能、仿真控制、研究自我修正流程的團隊,用來檢查模型在新條件下是否真能靠回饋改對,而唔係只係記住舊解法。

  • 針對環境突變後的適應能力,不是單次解題
  • 以執行驗證驅動每次修訂,結果可重現
  • 支援接入 OpenAI-compatible 服務做評測
  • 結果顯示準確率與成本效率未必同步提升
  • 適合研究 self-evolving agents、控制與物理模擬

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, Qwen, API, Dataset 數據集

Page 4 of 18
1 2 3 4 5 6 18