RynnValue 用秒估計機械人完成時間

它不只判斷機械人有冇做對,仲會估計距離完成仲差幾多秒。呢種時間式價值訊號,令強化學習獎勵設計變得直接得多。

RynnValue overview

機械人操作最難的不只是識別動作成敗,而是要持續知道距離完成指令仲有幾遠。RynnValue 就是針對呢個空缺而來的模型項目:它把機械人影片連同文字指令一齊讀入,逐格預測剩餘完成時間,並輸出自然語言分析,讓進度估計、失敗偵測與 VLA(vision-language-action)policy 的獎勵建構可以共用同一套訊號。

它和常見進度分數或偏好標註做法的分野很清楚。RynnValue 不靠人工標出「較好」軌跡,也不把進度硬壓成 0 到 1,而是直接學習 goal-conditioned cost-to-go 的物理時間;標籤來自時間戳,配合子任務切分與 cutoff relabeling,於是能擴展到 7,000 多小時、約 300 萬段 instruction-conditioned clips 的異質機械人資料。這個取捨帶來的好處是可擴展,代價則是模型必須更好地處理長尾任務時長與不同視角、不同 embodiment 的差異。

RynnValue 連同完整工具鏈一併提供。你可以把它理解成一套由 HuggingFace 相容模型、影片推理示範,到 reward-model benchmark 與強化學習介面都包起來的研究型工具組;當中 RynnValue 建基於 RynnBrain,實作在 Qwen3-VL architecture 之上,除了預測 absolute 與 relative temporal value,亦會生成影片描述,並判斷 instruction–video 是否匹配、任務是否成功。

  • 核心能力是把「距離完成尚餘幾多秒」變成稠密 value signal
  • 訓練毋須 preference 或 progress annotations,較易放大量異質資料
  • 8B 版本在 RBM-EVAL-OOD 的平均 Kendall’s τₐ 達 0.675,高於文中對照的 fully preference-supervised 方法 0.655
  • 可直接接到 reward shaping,用作 policy ranking、evaluation 與 reinforcement learning critic

為免模型偷看序列位置去猜進度,作者加入 temporal-order shuffling、random temporal sampling,以及 value-isolation attention;消融結果亦顯示這些設計不是裝飾,拿走後指標會明顯下跌。再進一步,它把輸出的 value 轉成 potential-based shaping reward,在雙臂 Franka 的真實機械人學習中,無論 online 定 offline 都比最強 reward-model baseline 有更高成功率。

最受惠的會是做機械人操作、VLA 訓練、reward modeling 與 embodied AI 評測的團隊,尤其想減少人手標註成本、又需要跨資料來源泛化能力的人。限制同樣存在:這類時間距離訊號雖然比二元成敗更細緻,但對任務切分、影片品質與觀測覆蓋仍然敏感,而且它目前聚焦於 robot manipulation,不代表可直接外推到所有 agent 場景。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, Qwen, Video, VLA, Robotic, Dataset 數據集

StreamArena 多模態長片代理的記憶與互動分析

來自香港科大、港大與中大及小紅書的團隊,把長達近 90 分鐘的影片理解拆成可持續觀察、回想、找工具與主動回應四種能力。

StreamArena overview

由 HKUST(香港科技大學)、The University of Hong Kong(香港大學) 與 The Chinese University of Hong Kong(香港中文大學) 及小紅書組成的開發團隊,將焦點放到一個很多多模態代理都未真正處理好的難題:影片唔再係幾秒剪輯,而係接近一個半鐘頭、仲要持續互動。StreamArena 屬於資料集與評測工具包,處理的是 continuous streaming video understanding,目標係用統一方法檢驗代理在長時間影音流之中,能否即時理解、隔一段時間後仍然記得內容,並在合適時機用工具或主動回應。

呢個項目最值得注意的地方,在於它唔用短片加選擇題去掩蓋模型弱點,而係用 243 段 full-length videos、平均 88.8 分鐘、合共 3,646 個 open-ended tasks,分成 Real-Time Perception (RTP)、Historical Retrospection (HR)、External Tool Use (Tool) 同 Proactive Interaction (Pro)。HR 與 Pro 仲按時間跨度分層,HR 最遠拉到 30 分鐘,直接把長期記憶與延遲控制的取捨攤開來測。

StreamArena Evaluation Toolkit:streamarena/ 放資料載入、媒體處理、tool-call protocol、OpenAIBackend、GeminiBackend 同 LLM-as-Judge scorer;method/ 則整理多種被測方法,包括 offline 的 Qwen、MiMo、Kimi、Qwen-Omni、Gemini,以及 MiniCPM-o-4.5、VST、StreamForest、ThinkStream。所有方法都寫入同一套 records JSONL schema,所以 judge/ 可以用同一把尺評分。安裝與執行細節在目前資訊裡未完全展開,但可確認它不是單一模型倉庫,而是用來重跑、對齊與比較不同方法的評測框架。

  • 覆蓋四類能力:RTP、HR、Tool、Pro,唔只問答,仲測持續監看與主動互動
  • 243 段長影片、平均 88.8 分鐘,資料規模明顯偏向長時序理解
  • 同一份 JSONL 輸出格式配合通用 judge,方便橫向比較不同方法
  • StreamMind 在同一 Qwen3.5-397B-A17B backbone 上,把 pooled query-to-answer latency 降低 66.2%

一個重要限制:StreamMind 在這次釋出裡只有 evaluation protocol docs,未附完整可直接重現的實作;AURA 亦只提供 client,server 仍要依賴官方 vLLM。換句話說,StreamArena 現階段更像研究團隊、代理系統開發者同多模態評測工作流會用到的基礎設施。想比較不同 streaming method、檢查長影片代理究竟卡在記憶、反應,還是工具調用,呢個項目比一般短片 benchmark 更接近部署前要面對的現實。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港大學, 香港科技大學, Agentic, 多模態模型, Qwen, Gemini, Video, 香港, Kimi

Wan-Animate-2 把角色動畫推向即時互動

同一張角色圖,已經可以跟住驅動影片做出更穩定動作,連鏡頭角度都可另外控制。Wan-Animate-2想解決的,不只是畫面靚唔靚,仲包括直播同數字人能否即時用。

Og image

一張角色圖片配合一段驅動影片,便可以生成動作自然、表情細緻的角色動畫,這正是 Wan-Animate-2 想處理的核心場景。它屬於角色動畫生成框架,重點不只放在畫質,還試圖解決身份容易走樣、動作細節流失,以及難以支援即時互動這幾個長期卡位。

跟不少依賴中間動作表示的方法不同,Wan-Animate-2 直接把 driving video 餵入重新設計的 Diffusion Transformer,避開 motion extractor 帶來的誤差與 identity drift。這種端到端做法的好處,是角色外觀保持得更穩,細微表情、複雜肢體動作,甚至角色與場景之間較合理的互動,都更容易保留下來。

它另一個值得留意的能力,是加入 text-driven viewpoint control,令輸出鏡頭角度可以跟驅動影片分開控制。對數字人、直播主持、虛擬角色演出這類互動工作流來說,這代表同一段驅動內容不一定要綁死原本視角,使用時更容易配合不同畫面需求。

  • 直接使用 driving video,而不是先抽取中間動作表示
  • 主打更穩定的 identity preservation 與 motion fidelity
  • 支援 text-driven viewpoint control,可分離鏡頭視角與驅動動作
  • 推出 Wan-Animate-2-Lite,目標是把推理延遲壓到即時門檻
  • 預告公開 Wan-Animate-2-Base 權重,方便社群延伸研究

為了走向即時應用,團隊亦提出 Wan-Animate-2-Lite,並用三階段訓練流程去降低 inference latency,包括 teacher forcing pretraining、error buffer mechanism,以及 Self-Forcing distillation 配合 chunk-wise backpropagation。現有結果與使用者研究顯示,它在多種角色和動作模式下都有不錯的高保真表現;不過目前公開資訊仍以研究展示為主,部署成本、硬件需求與長時間串流穩定性,仍要等更多公開細節驗證。

項目主頁

Categories: 阿里巴巴, 視覺模型, Video, Image, 動畫

Ego2Robot 把人類影片轉成機械人訓練數據

Ego2Robot將第一身人類操作影片轉化成大規模機械人訓練數據,改善 VLA 模型面對陌生環境時的泛化能力。

Ego2Robot pipeline overview

機械人要應付陌生場景,往往需要大量而且多樣化的示範數據;Ego2Robot選擇從第一身人類操作影片取材,將人手動作轉換成不同機械人形態可以使用的訓練資料。這個數據合成項目面向 Vision-Language-Action(VLA)模型預訓練,處理人類影片與機械人動作、視覺外觀不一致的問題。

流程分為動作對齊、視覺對齊和品質篩選三部分。系統會把拇指、食指、中指指尖及手腕等關鍵點重新映射到夾爪的 TCP、開合幅度和方向,再以 Savitzky–Golay 及 SLERP 平滑動作;視覺處理則結合 SAM 3、ProPainter、機械人底座姿態搜尋和 IK solving,把機械人手臂合成到已修補的人類場景中。

項目支援已有手部姿態標註的數據集,也可以從原始影片估算姿態,後者使用 WiLoR 逐幀重建和 DynHaMR 時序最佳化。統一流程可以平行產生 15 種 robot morphologies,累積 18,561 小時訓練數據,涵蓋較多任務、場景和機械人配置。

重點包括:
– 同時支援 curated datasets 和 in-the-wild videos
– 以多層 quality curation 篩走動作及視覺合成中的低質資料
– RoboTwin 2.0 加入視覺外觀、場景佈局、機械人形態和任務語義等干擾軸
– 與機械人數據聯合預訓練後,多種 out-of-distribution 情況下的泛化能力提升
– 改善效果亦在真實機械人部署中獲得驗證

對需要建立通用機械人操作模型的研究團隊,Ego2Robot提供了一條減少真人示範收集成本的路線。不過,合成數據的品質仍取決於手部姿態估算、動作重定向、逆運動學和場景合成是否準確,因此它較適合作為真實機械人數據的補充,而不是完全取代實體部署資料。

項目主頁

Categories: 阿里巴巴, 視覺模型, 多模態模型, 模型訓練, Qwen, Video, VLA, Robotic, 中國, Dataset 數據集

Vision-DeepResearch:由靜態圖片走向連續影片的 DeepResearch Agent

Video-DeepResearch 將視覺搜尋延伸至連續影片,要求模型先理解跨畫面的證據,再進行網絡探索。

icon

面對需要翻查影片內容、再結合網絡資料回答的問題,單靠文字搜尋往往會漏掉關鍵畫面。Video-DeepResearch 是一個多模態研究型 Agent 項目,透過 Video-DeepResearch(Video-DR)處理連續影片中的時空資訊,並把視覺理解與網絡探索分開安排。

它修正了兩個常見卡位:模型偏向使用文字工具,較少主動檢視影片;模型亦可能直接依賴內部記憶,未有真正完成工具輔助搜尋。Pipeline 先逐階段解鎖視覺工具,要求模型完成跨畫面 grounding,再進入網絡檢索,取捨是流程較嚴謹,但推理成本和執行時間亦可能增加。

訓練流程先以 Supervised Fine-Tuning(SFT)建立基本能力,再使用 Group Relative Policy Optimization(GRPO)強化自主探索。項目同時提供 30 K 個 video-grounded QA pairs、7 K 條整理後的 trajectories,以及程式碼、資料集和模型權重,研究團隊可按需要測試基準、重現訓練或直接載入模型。

  • Video-DR-35B-A3B 在 Video-DR 達到 68.0% accuracy
  • 比 Claude-4.5-Sonnet 的 63.0% 高 5.0 個百分點
  • GPT-5 和 Gemini 2.5 Pro 分別為 57.0% 和 62.0%
  • Vision-DeepResearch-30B-A3B 延續同一研究方向,另有 SFT-only 的 8B 版本

現有結果反映它在影片證據與網絡資料需要互相驗證的工作較有價值,例如研究、媒體核查和長片段問答;但 68.0% 仍代表部分問題會出錯,較適合作為研究平台和可檢驗的 Agent 架構,而不是無需監督的影片分析服務。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港理工大學, Agentic, 多模態模型, 模型訓練, Qwen, OpenAI, Gemini, Video, 香港, Anthropic, Dataset 數據集

CADENA 把 3D 網格逐步還原成 CAD 程式

想由3D mesh 反推可編輯 CAD 流程,CADENA 提供了一條幾務實的路。它唔係一次過寫完整程式,而係每步都先執行、再比較幾何差異。

Repository image for zhemdi/cadena

做 3D reverse engineering,最大痛點唔係生成一段似樣代碼,而係生成之後能否真的建出可用、可編輯、而且封閉的幾何。CADENA 屬於模型加推理流程的參考實作,目標是把 3D mesh 重建成 parametric CAD program;它採用 stepwise inference,每次只發出一個 operation,先執行目前前綴,再用目標幾何與已建幾何的差距決定下一步。

這種做法的價值,在於把「一次過輸出整段程式」改成可檢查、可回退的逐步生成。倉庫內的 inference/ 會做 vLLM 服務、per-operation expansion 同 prefix selection,rl/ 則負責 sandboxed prefix rendering 與排序分數;系統只保留能令 IoU 改善的步驟,所以多走幾步不會令結果更差。代價同樣清楚:部署要 Python 3.10+、CUDA GPU、vLLM,同時依賴 OpenCASCADE via CadQuery,環境比一般 Vision-Language 模型推理更重。

模型本身用的是 Qwen2-VL-2B policy,Hugging Face 釋出 sftrl 兩個階段,當中 rl 對應 CADENA-RL。輸入不是單張截圖,而是八個視角拼成一張圖,六個軸向視圖加兩個等角視圖;目標物放在綠色通道,當前已建立幾何放在紅色通道,模型讀到的其實是尚未補齊的殘差。這種設計直接把「下一刀應該補邊度」轉成視覺訊號。

幾個值得留意的重點:
– 倉庫提供完整推理、資料集建立、評分與可視化流程,但不包含用來合成訓練語料的 rule-based program generator。
cadgen/ 只有 DSL runtime 的執行半部,較適合做還原、測試與基準比較,唔係完整資料生產管線。
– 預設流程會由 mesh 目錄建立 inference dataset,再輸出每一步的程式、輸入圖同 built STL,方便檢查中途錯誤。
– 無效預測會被剔除:建不出來,或者結果不是 watertight,都不算有效答案。
– 評分包含 GMS、IoU、CD,而且結果會按 family 及整體一併報告,避免單一類型零件拉高平均值。

適合研究 CAD reverse engineering、幾何生成、製造前處理,或者想把 mesh 轉回可參數化編輯流程的團隊。現階段最實際的理解方式,是把 CADENA 看成一套偏研究導向、但已經有明確 benchmark、checkpoint 同 rollout 腳本的開源項目;可重現性做得不錯,不過完整訓練資料生成鏈未公開,想延伸到自家資料或重訓流程,仍要補上不少工程工夫。

GitHub · 模型

Categories: 開源, 多模態模型, Qwen, Google, NVIDIA, 框架, 3D, Python, Dataset 數據集

LongHorizon-Harness 解決代理在長任務時的錯誤

代理能否跑足幾十小時,關鍵唔只在模型能力,仲在狀態有冇走樣。LongHorizon-Harness把驗證、執行同任務延續拆開處理。

Install and run LongHorizon-Harness from the command line

當代理要橫跨桌面程式同 command line 連續做事,最易出問題唔係單步操作,而係中途記錯狀態、判斷錯進度,結果愈做愈偏。LongHorizon-Harness 針對屬於長時程代理執行與驗證工具,目標係令複雜任務可以被保存、核實,再一路推進到完成。

它唔係新模型,它主要協助 Claude Code、Codex、OpenClaw 之類 agent backend 上面處理 execution、state management 同 result verification。核心做法是 Manage-Execute-Audit (MEA) loop,把規劃、執行、審核拆成不同路徑,並把可信狀態獨立保存,減少單一長對話愈滾愈亂的問題。

  • 支援 Claude Code、Codex、OpenClaw,亦可配 Gemini CLI 與 mini-SWE-agent
  • 以獨立 audited state 推動下一步,而唔係只靠 session 內記憶
  • 可用單一指令啟動,每次執行會獨立保留 audit trail
  • 針對 WeaveBench、OSWorld 2.0、Terminal-Bench 2.1 這類長任務基準有公開成績

它在 WeaveBench 取得 80.7% PassRate、OSWorld 2.0 有 35.2% partial score,Terminal-Bench 2.1 success rate 為 77.2%。官方亦強調在相同 backbone 下,只換 harness,三個 benchmark 都向上走,反映改進點主要來自流程控制同驗證機制,而唔係模型突然變強。

呢種設計較適合需要長時間自動化處理、多步驟交接、又要追蹤結果可信度的團隊,例如研究、軟件測試、系統操作同複雜 office workflow。代價是流程比單純聊天式代理更重,審核與狀態管理會增加結構與成本,但換來的是更穩定的延續能力,同較容易追查每一步點樣做出來。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, 框架, OpenClaw, Anthropic, Dataset 數據集, MiniMax, Skill 技能

Poplar 把人像數據集生成變成可追溯流水線

想建立可重現的人像圖文數據集,難處往往唔係生成,而係點樣保留規格、來源同質檢。Poplar正正將呢三步串成可審核流程。

Poplar teaser

生成人像圖文數據集最易失控的地方,不在於出圖本身,而在於之後很難追查提示詞有冇被改動、畫面為何被淘汰、覆蓋範圍是否足夠。Poplar把呢件事做成一條開源流水線兼框架,專注處理 human-centric image-text dataset synthesis,將 Specify、Render、Inspect 三段分開,又用 append-only JSONL 記錄每一步。

它的做法幾務實:先抽樣人物、服裝、活動、場景、取景與光線等結構化屬性,再由 Qwen3.5-27B-FP8 把規格寫成攝影導向提示詞;之後用 Krea 2 Turbo 配合 Krea2-realism-V2 生成,每個規格只出一張圖,最後再由同一個 Qwen3.5-27B-FP8 檢查圖文是否一致、是否有明顯缺陷。重點不只是「生成到」,而是連 prompt hash、seed、重試紀錄、缺陷標記同審核時間都留底。

  • 適合研究團隊、數據工程、訓練視覺模型前的數據建設工作
  • 差異在於把語意覆蓋、渲染來源與質檢決策全部做成可追溯紀錄
  • 部署門檻不算低,已發佈排程要四張 NVIDIA GPU,並需相容 CUDA 12.6 的 PyTorch 環境
  • 質量控制包含保守式 deterministic prefilter,會重試近灰階、嚴重模糊、低細節或損壞輸出

跟只看單張生成效果的做法相比,Poplar更重視整批數據集能否重現與審核,取捨是硬件需求較高,流程亦偏向資料生產而非互動創作。現有資料未見完整基準分數,但它把審核 rubric、prompt mismatch severity、evidence 與 confidence 都納入 review records,對要建立可交付數據資產的團隊,價值相當直接。

項目主頁 · GitHub

Categories: 開源, Qwen, NVIDIA, Image, Python, Dataset 數據集

UEmbed:單一模型同時做稠密與稀疏檢索

UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,令稠密向量與稀疏詞彙向量可以一併輸出。對要做多模態搜尋或檢索增強生成的團隊,這種設計可減少來回切換模型。

Repository image for Alibaba-NLP/UEmbed

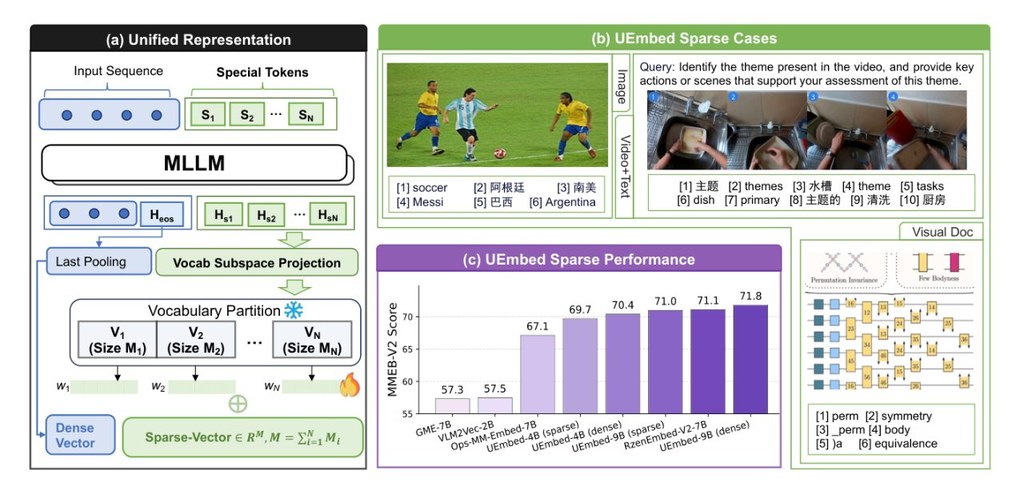
UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,它走的是多模態 embedding 模型路線,重點是把 dense 向量和 SPLADE-style sparse lexical 向量放在同一個 causal forward pass 內處理,方便直接做檢索、多模態搜尋和 visual-document retrieval。它不是只做文字匹配,而是把文字、圖片、影片與混合輸入統一到同一套表示空間。

直接取用 Hugging Face 上的 2B、4B、9B 權重,再按輸入格式送入不同媒體內容,檢查 dense 與 sparse 輸出是否符合預期。若要部署到搜尋系統,dense 部分可接向量檢索,sparse 部分可接倒排索引,兩條路可以同時保留。

它和傳統 learned sparse retriever 最大分別,在於保留 decoder-only multimodal backbone,並用 16 個 learnable special tokens 分攤稀疏詞彙空間,避開單一 token 的表達瓶頸。訓練時同時優化 dense InfoNCE、sparse InfoNCE 和 FLOPS regularization,取捨是結構較巧,但推理時可以用同一個模型兼顧語義召回與詞彙可解釋性。

效能方面,UEmbed-9B 在 MMEB-v2 取得 71.8(dense)與 71.0(sparse),並在公開數據訓練條件下做出很強的稀疏檢索表現;在 BEIR 上亦保持競爭力。對做搜尋、RAG、跨媒體內容索引,或者要把文字與圖像一齊納入檢索的團隊,這套做法會較有吸引力。

  • 同一個模型同時輸出 dense 與 sparse 表示
  • 支援文字、圖片、影片與混合輸入
  • 稀疏輸出可直接對接倒排索引,較易解釋
  • 以 Qwen3.5 multimodal backbone 為基礎,並用公開資料訓練
  • 2B、4B、9B 三個規模可選

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, RAG, Embedding, 模型, 多模態模型, Qwen, Image

Context Scaling 把文生圖提示詞帶到結構化階段

寫得更長未必更準,關鍵反而是提示詞有幾多可對應畫面的結構資訊。Context Scaling 把這件事量化,連帶改寫文生圖訓練與編輯流程。

Text prompt scaling law overview

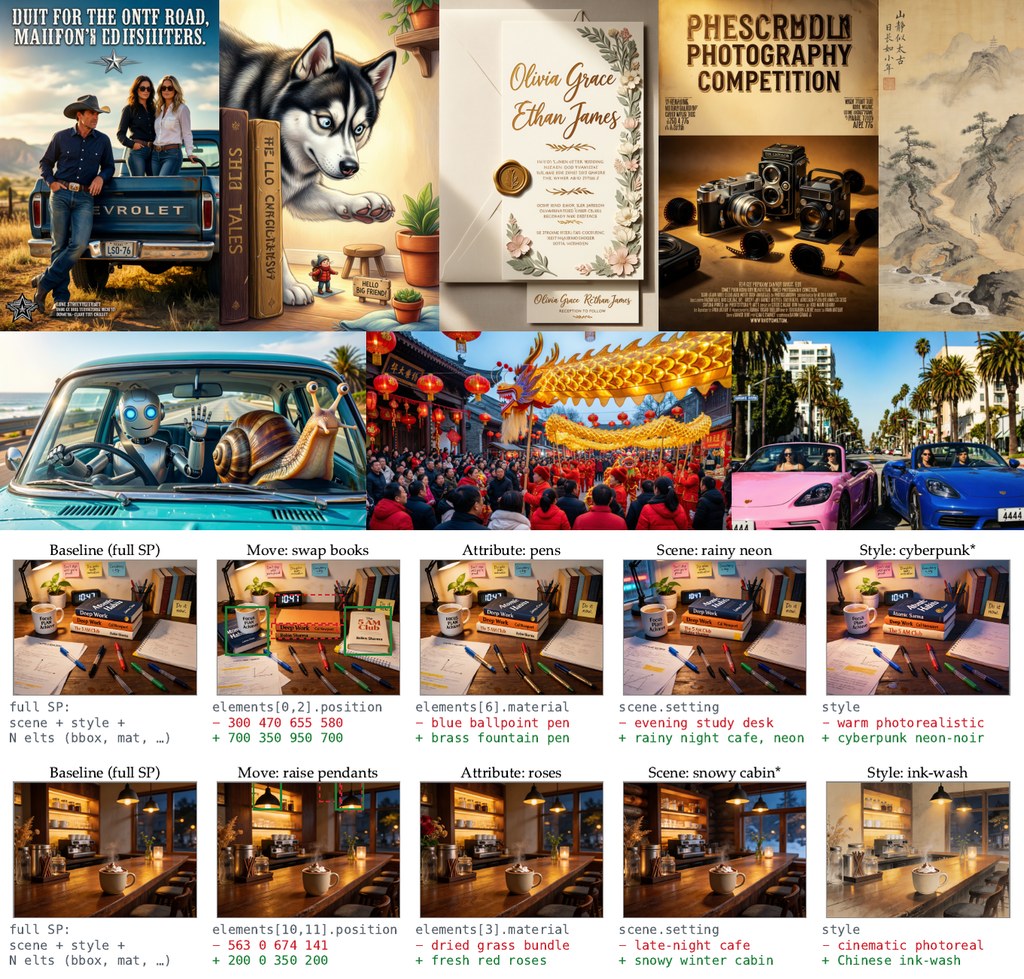
文生圖卡住的位置,很多時不是模型不夠大,而是提示詞交代得唔夠可計算。Context Scaling 聚焦影像生成中的文字條件 scaling law,屬於一個結合研究、模型與工作流程設計的項目,處理的是提示詞怎樣更有效描述構圖、屬性同空間關係,令 diffusion model 更容易學到、亦更容易按要求生成。

它最值得留意的判斷,是 caption 長度本身跟效果關係唔算緊密,反而 structured language 的資訊量更重要。團隊用兩個指標去量度這件事:white-box likelihood metric 的 GPG,同 black-box attribute metric 的 ED;受控訓練結果顯示,converged diffusion loss 會隨 GPG 近線性下降,亦會跟 ED 呈 power law 關係。

Context Scaling: Scaling Properties of Text Conditioning in Visual Generation

這個方向不只停留在分析。項目把 Structured prompts(SP)做成帶 semantic 與 geometric fields 的 JSON schema,再配合 trainable LLM prompter + captioner,將用戶要求或者輸入圖片轉成更有結構的描述;zero-shot structured editing 亦因此變得可行,因為每個可編輯因素都被拆成命名欄位,改其中一部分時,其他構圖元素較容易保留。

  • 重點不在提示詞有幾長,而在畫面資訊有幾可對齊
  • GPG 與 ED 為提示詞資訊量提供兩種量化方法
  • Structured prompts(SP)直接補強 compositional、reasoning、world-knowledge 類生成
  • prompter 經 supervised fine-tuning、cold-start、verifier-gated on-policy distillation 訓練
  • 已公開 Code、Models 與 Demo,理解路線可先看 project page,再到 Hugging Face collection

跟同類做法相比,它的取捨相當清楚:不是單靠更大模型或更長自然語言描述去碰運氣,而是先提升 captions 對影像的可監督性,再訓練 prompter 去穩定產生這類結構。官方說法指出,系統在多個 compositional、reasoning 與 world-knowledge benchmark 上超越全部已評測 open-weight models,並在多數評測追平或超過最強 closed-weight models;不過公開資訊仍以研究結果為主,部署細節與完整安裝流程未算多,現階段較適合做方法研究、提示詞工程、影像編輯流程設計,以及評估下一代文生圖介面的團隊參考。

項目主頁 · GitHub · 模型

Categories: 開源, 字節跳動, 模型, 模型訓練, Qwen, 影像模型, txt2img, Dataset 數據集

Page 6 of 18
1 4 5 6 7 8 18