[技術文章] 淘寶直播 AI 主播團隊提出 HAT 訓練法 解決小模型難以跟上快速更新的張力

淘寶直播 AIGC 團隊針對直播帶貨 AI 主播的實時互動需求,提出 Harness-Aware Training(HAT)框架,令小模型能在頻繁更新的策略環境中保持低延遲與高適應力。

Hero image preview

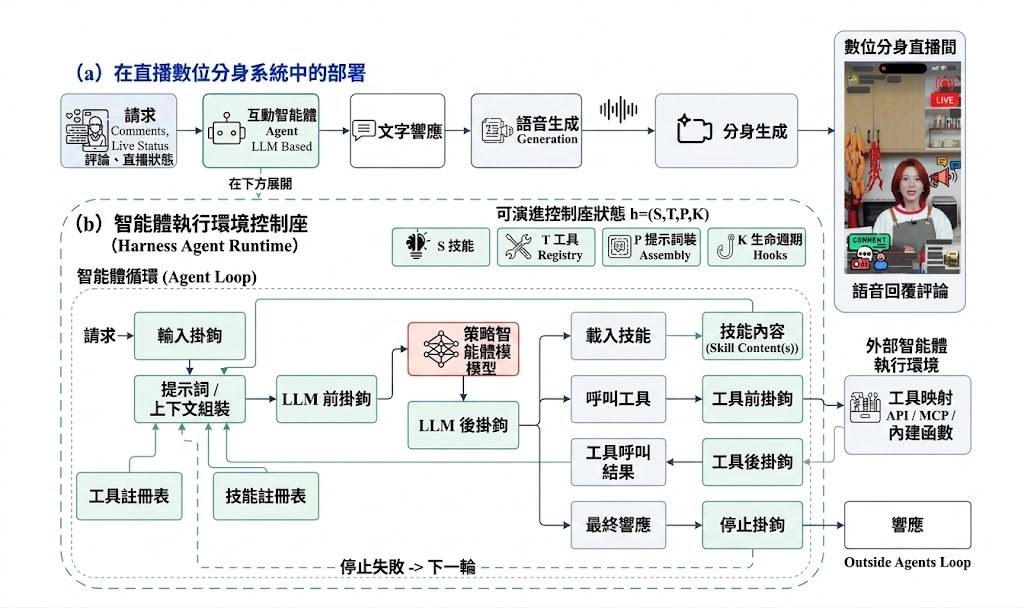
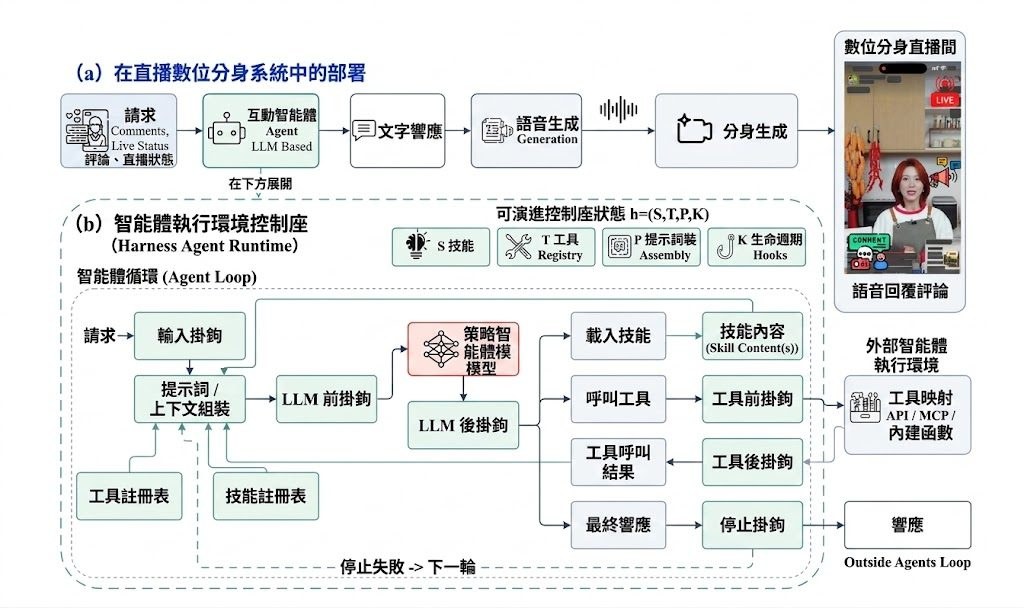
淘寶直播旗下的 TaoLive AIGC LLM 團隊發表技術報告,提出一套名為 Harness-Aware Training(HAT)的訓練方法,專門用於訓練能在直播帶貨場景中即時回答商品問題、與觀眾互動並執行營銷策略的數字人主播。團隊指出,直播帶貨對延遲極為敏感,同時行銷規則與商戶偏好又會持續變動,因此業界普遍採用「可演化 Harness」設計,把 Skills、Hooks、prompts 和 tools 與模型參數解耦,策略改動時不必重新訓練模型。然而這種做法帶來明顯取捨:大模型雖然泛化能力強,能夠零樣本適應 Harness 變動,但延遲太高;小模型延遲符合實時要求,卻容易過拟合到固定的 Harness 設定,一旦配置更新就需要重新訓練。

HAT 的核心思路是在訓練階段就讓模型接觸大量不同的 Harness 配置,使它學會「讀懂當前的 Harness」,而非記住某一個固定版本。具體做法引入 Harness-State Augmentation(HSA),對 Skill 識別碼、Skill 內容、工具 schema、prompt 結構及 Hook 函數施加保留任務語義的轉換。訓練分為三個階段:HSA-SFT 讓小模型從強模型生成、在多樣化環境中收集的高質量軌跡學習,直接提升推理與工具調用能力;General OPD 透過 On-Policy Distillation 在通用從基礎模型學習,恢復 SFT 過程中受損的泛化能力;HSA-RL 則在經 HSA 增廣的多樣化環境中做強化學習,進一步強化模型對變動 Harness 的理解與工具調用穩定性。

HAT 訓練的模型在 Live-Stream QA 上平均得分 94.8,明顯高於基礎模型的 80.3 和最強通用 LLM 的 93.0;在 Harness-Variant QA 上亦達到 94.6,遠超基礎模型的 75.4。傳統 Fixed-Harness SFT 會令 IFEval 分數較基礎模型下跌 7.7 分,而 HAT 不單避免這種下跌,更取得 83.5 分。在部署層面,模型可在單張 NVIDIA H20 GPU(啟用優化)上運行,P50 延遲 3.4 秒、P95 8.1 秒,已滿足實時互動門檻。系統已落地至淘寶直播的生產環境,線上 A/B 測試顯示相對 ReAct 對照組,Harness 實驗組在確認收貨 GMV 上帶來 4.33% 的 UV 標準化提升、商品頁瀏覽量提升 0.91%。

對需要快速疊代策略、又受制於延遲與算力的實時對話代理團隊而言,這份報告展示了一條可落地的工程路徑。

重點摘要
– 淘寶直播 AIGC 團隊針對直播帶貨 AI 主播提出 HAT 訓練框架
– 解決小模型過拟合固定 Harness、無法跟上策略更新的核心矛盾
– 透過 HSA 增廣與三階段訓練兼顧延遲、泛化與工具調用穩定性
– IFEval 分數避免傳統 SFT 出現的 7.7 分下跌,反升至 83.5
– 已在淘寶直播生產環境上線,A/B 測試帶來 GMV 與瀏覽量提升
Paper

Categories: 阿里巴巴, Agentic, 模型訓練, 框架, Skill 技能

[技術文章] 淘寶直播 AI 主播團隊提出 HAT 訓練法 解決小模型難以跟上快速更新的張力

淘寶直播 AIGC 團隊針對直播帶貨 AI 主播的實時互動需求,提出 Harness-Aware Training(HAT)框架,令小模型能在頻繁更新的策略環境中保持低延遲與高適應力。

Hero image preview

淘寶直播旗下的 TaoLive AIGC LLM 團隊發表技術報告,提出一套名為 Harness-Aware Training(HAT)的訓練方法,專門用於訓練能在直播帶貨場景中即時回答商品問題、與觀眾互動並執行營銷策略的數字人主播。團隊指出,直播帶貨對延遲極為敏感,同時行銷規則與商戶偏好又會持續變動,因此業界普遍採用「可演化 Harness」設計,把 Skills、Hooks、prompts 和 tools 與模型參數解耦,策略改動時不必重新訓練模型。然而這種做法帶來明顯取捨:大模型雖然泛化能力強,能夠零樣本適應 Harness 變動,但延遲太高;小模型延遲符合實時要求,卻容易過拟合到固定的 Harness 設定,一旦配置更新就需要重新訓練。

HAT 的核心思路是在訓練階段就讓模型接觸大量不同的 Harness 配置,使它學會「讀懂當前的 Harness」,而非記住某一個固定版本。具體做法引入 Harness-State Augmentation(HSA),對 Skill 識別碼、Skill 內容、工具 schema、prompt 結構及 Hook 函數施加保留任務語義的轉換。訓練分為三個階段:HSA-SFT 讓小模型從強模型生成、在多樣化環境中收集的高質量軌跡學習,直接提升推理與工具調用能力;General OPD 透過 On-Policy Distillation 在通用從基礎模型學習,恢復 SFT 過程中受損的泛化能力;HSA-RL 則在經 HSA 增廣的多樣化環境中做強化學習,進一步強化模型對變動 Harness 的理解與工具調用穩定性。

HAT 訓練的模型在 Live-Stream QA 上平均得分 94.8,明顯高於基礎模型的 80.3 和最強通用 LLM 的 93.0;在 Harness-Variant QA 上亦達到 94.6,遠超基礎模型的 75.4。傳統 Fixed-Harness SFT 會令 IFEval 分數較基礎模型下跌 7.7 分,而 HAT 不單避免這種下跌,更取得 83.5 分。在部署層面,模型可在單張 NVIDIA H20 GPU(啟用優化)上運行,P50 延遲 3.4 秒、P95 8.1 秒,已滿足實時互動門檻。系統已落地至淘寶直播的生產環境,線上 A/B 測試顯示相對 ReAct 對照組,Harness 實驗組在確認收貨 GMV 上帶來 4.33% 的 UV 標準化提升、商品頁瀏覽量提升 0.91%。

對需要快速疊代策略、又受制於延遲與算力的實時對話代理團隊而言,這份報告展示了一條可落地的工程路徑。

重點摘要
– 淘寶直播 AIGC 團隊針對直播帶貨 AI 主播提出 HAT 訓練框架
– 解決小模型過拟合固定 Harness、無法跟上策略更新的核心矛盾
– 透過 HSA 增廣與三階段訓練兼顧延遲、泛化與工具調用穩定性
– IFEval 分數避免傳統 SFT 出現的 7.7 分下跌,反升至 83.5
– 已在淘寶直播生產環境上線,A/B 測試帶來 GMV 與瀏覽量提升
Paper

Categories: 阿里巴巴, Agentic, 模型訓練, 框架, Skill 技能

VoiceMem 讓語音 AI 記住你的情緒與偏好

VoiceMem 以流式雙腦架構處理事實記憶、情緒與人格,讓語音智能體在對話中更懂使用者,同時控制延遲與成本。

VoiceMem Logo

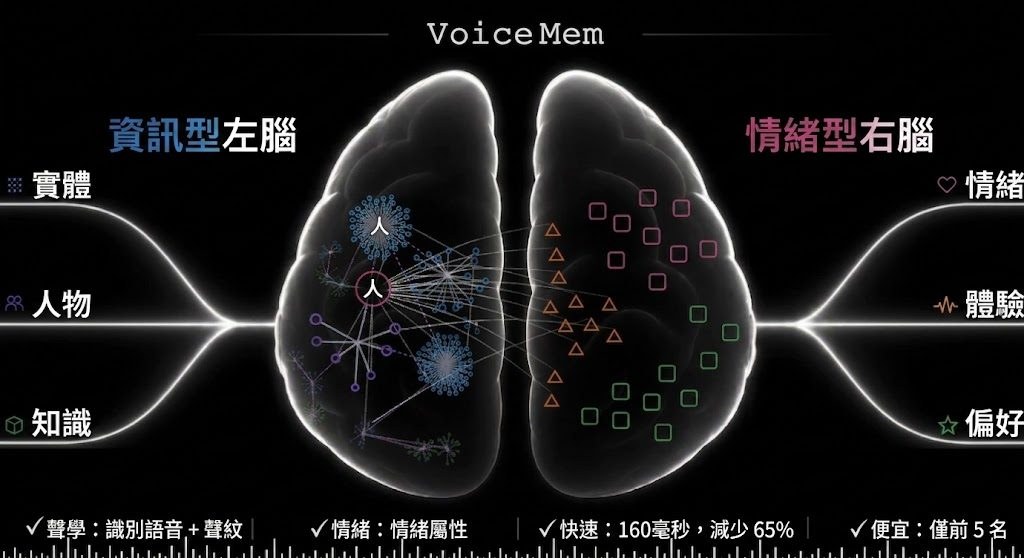
語音智能體要記住「我是素食者、對堅果過敏」,並不只是保存轉錄文字,還要分辨人物、情緒、偏好與性格。VoiceMem 屬於語音 AI 記憶引擎及可整合的庫,處理音訊輸入、記憶抽取、檢索和回應前的上下文注入,讓長期個人化對話不必每次重新建立背景。

它採用 VoiceMem Dual-Brain Streaming Architecture(流式雙腦架構):左腦以 schema 與 entity 組織事實記憶,右腦獨立管理情緒、偏好和人格,亦維護跨 entity 的關聯。音訊仍在輸入期間,系統已經分段、轉錄、抽取資料並寫入記憶圖;查詢時先路由及排序,只把 Top-K 記憶放入上下文,減少語音回應需要處理的內容。

  • 左腦在 Top-3 限制下維持 Mem0 的滿載性能
  • 右腦加入長短期情緒歸因及交叉節點
  • 透過壓縮資訊、分層儲存和流式查詢降低等待時間
  • 單輪查詢約需 300 token,架構及底層記憶引擎可替換

VoiceMem 內置 ASR(Automatic Speech Recognition)、聲紋、場景、情緒感知及本地 embedding 元件,亦提供離線記憶引擎和 streaming interface。倉庫資訊包含 Python 庫、互動式網頁 demo、VoiceMem_Default_Models_Env 模型環境,以及可選的 Qwen 回應模型;但完整硬件要求、服務依賴和模型授權仍需按連結內容逐項確認,不能單靠 README 推斷。

ChatMem-400K 以記憶世界構建、SLM 驗證的 online on-policy distillation 和人工修訂三階段製作,配合 VoiceMem Model Families 的 Qwen3 6 35B A3B Qlora 模型系列。這令項目較適合需要長期語音陪伴、個人助理、客服或具情緒連續性的 voice agent 團隊;對只需短對話轉錄的工作流,雙腦記憶層會增加整合和維護成本。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 清華大學, Agentic, Embedding, 多模態模型, Qwen, Python, , 語音

Super-Star:讓數字人邊聽邊做

Super Star 將串流語音、對話和身體動作連成一條即時管線,令 3D 數字人毋須等待完整語音才開始配合手勢。

logo

數字人要一邊回應、一邊自然做出配合語氣的動作,關鍵不只是生成語音,而是不能偷看未來內容。Super Star 屬於面向 3D 數字人的即時互動框架,處理多模態輸入、串流回應語音,以及與語音同步的身體姿態生成。

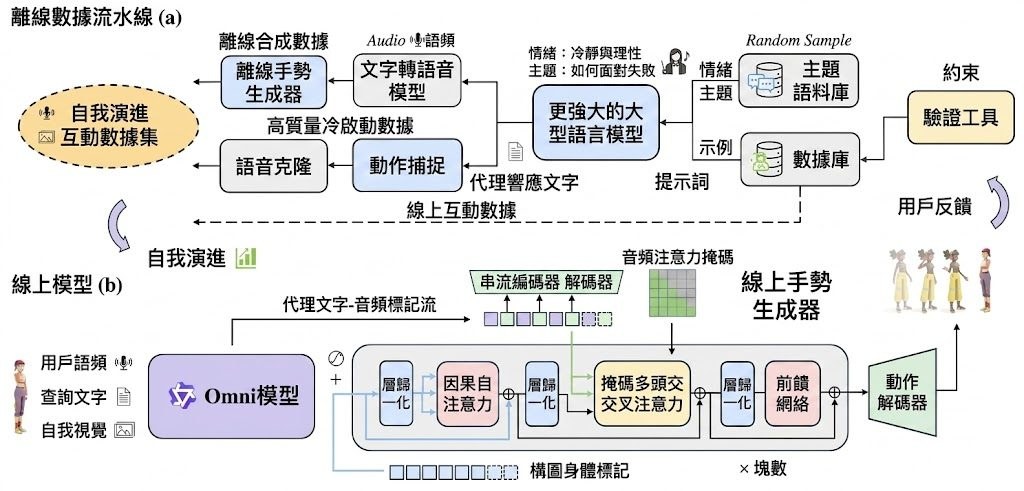
Super-Star 把 Streaming Speech Response 與 Online Gesture Generator 兩個模組接合。前者採用 Qwen3-omni 產生串流回應語音,後者是因果多模態自回歸模型,根據目前收到的語音和 motion history 預測下一段動作,因此可在低延遲下生成手勢,不需等整段對話完成。

離線資料流程會按主題和情緒建立人機對話,再為回應語句生成 co-speech gestures;線上互動收集到的使用者偏好,會回流到 closed-loop self-evolving data pipeline,支援持續調整。相比先取得完整語音再生成動作的做法,Super Star 以較少未來資訊換取即時性,但動作預測亦更依賴目前語音片段和歷史狀態。

  • 串流語音與動作同步,適合虛擬陪伴、直播角色及互動式數字人
  • Qwen3-omni 負責回應語音,Online Gesture Generator 負責身體動作
  • 研究結果主張改善 latency-quality trade-off、語音動作同步及使用者偏好
  • 訓練 Motion Tokenizer 和 Online Gesture Generator 時需要 WAV 音訊
  • CUDA driver 需為 12.4 或以上,完整執行細節仍要配合 Qwen3-omni 及 vLLM-Omni 文件

提供的資料包含 training、inference 和 evaluation code。訓練部分使用 RQVAE 的第一層 codebook 解碼,對應論文線上模型採用的 VQVAE,測試者需要準備 WAV 檔案並填寫音訊路徑和輸出目錄。對研究團隊及需要低延遲數字人互動的開發者而言,項目較適合作為研究原型或客製化系統的起點,而非即裝即用的成品。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, 多模態模型, 模型訓練, Qwen, NVIDIA, Audio, 3D, 語音, Dataset 數據集

阿里巴巴 PAI 以 PDD 加速 MiniMax-H3 影片生成

阿里巴巴 PAI 團隊把 MiniMax-H3 變成少步數就能出片的版本。你可以把它理解成針對影片生成速度做加速的 LoRA。

Og image

阿里巴巴 PAI 團隊針對 MiniMax-H3 做了 Parallel Decoding Distillation(PDD),目標是用更少推理步數完成影片生成。這份項目同時保留 MiniMax-H3 的兩條路線,分別對應 FL2VA 和 Ref2VA,方便按不同基礎版本套用加速 LoRA。

兩個官方 8-step Acc LoRA,檔名分別是 MiniMax-H3-FL2VA-Acc-8Step.safetensorsMiniMax-H3-Ref2VA-Acc-8Step.safetensors,兩者都標示 rank=64network_alpha=64,並以 BF16 形式提供。這表示它們不是完整底模,而是掛在對應 base model 上的加速適配器。

8-step Acc LoRA 可配合 768p 生成流程,並對比 baseline、Turbo 4-step 版本和 8-step Acc LoRA。

實務上,8-step Acc LoRA 代表在速度和畫面穩定度之間做取捨,重點是把影片生成的推理成本壓低,而不是追求最長流程。相較原始 MiniMax-H3,這類 LoRA 的用途更偏向快速出樣和迭代,適合需要較短等待時間的影片生成工作流。

  • 開發團隊是 Alibaba-PAI,並以 MiniMax-H3 做 PDD 加速
  • 提供兩個 8-step 官方 Acc LoRA,分別對應 FL2VA 和 Ref2VA
  • 檔案以 BF16、rank=64network_alpha=64 方式發布
  • 頁面有 768p Demo,但未交代 GGUF、mmproj 或硬體需求

項目主頁 · 模型

Categories: 開源, 阿里巴巴, AI productions, 多模態模型, 視頻模型, Video, MiniMax

TLive-Omni:專攻直播電商的多模態理解模型

TLive-Omni 將影像、影片、語音和文字統一成文字輸出,特別適合要即時理解直播內容的場景。它同時處理商品畫面、聲音與對話脈絡,目標是減少直播電商裡資訊斷裂的問題。

logo

TLive-Omni 是一個多模態理解模型,針對直播電商場景,把影像、影片、語音和文字整合到同一個文字輸出介面。對做直播監控、商品理解、內容標註或客服輔助的人來說,它處理的是同一場直播裡多種訊號難以對齊的問題。

這個項目建基於 Qwen3.5 backbone,再接入 AuT audio encoder 和輕量 MLP 對齊層,並用 timestamped Per-vGrid 把聲音片段和對應畫面放在一起。它支援最長 256K tokens context,適合長時間直播流的連續理解,而不是只看單段截圖或單句語音。

訓練流程分三階段 SFT,先做語音與語言對齊,再擴展到完整多模態指令跟隨,之後加入 Faithful-RFT,強調回答要貼近直播場景的即時需要。README 亦列出聲音辨識、講者分析、商品視覺定位、文字辨識、時序定位、影片密集描述和 omni-modal QA 等能力,顯示它不是單一功能模型,而是面向直播任務的綜合型系統。

  • 4B 和 9B 版本都已公開,方便按算力和部署成本選擇。
  • 在直播電商的音訊、影像和影片任務上有不錯表現。
  • 對一般基準也有泛化能力,不只局限於單一場景。
  • 更適合需要長上下文、多訊號同步分析的團隊。
  • 取捨在於它很聚焦直播電商,未必是通用多模態助手的最佳替代。

整體來看,TLive-Omni 把直播場景最麻煩的訊號對齊、長上下文理解和即時回答放在同一條路徑處理,對做電商直播分析、內容審核和銷售輔助的團隊會更實用。它的價值不在於把功能堆滿,而在於把多模態理解收斂到直播工作流裡真正會撞到的問題。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 多模態模型, Qwen, Video, Audio, 語音

VA-Judger 生成更貼近人類偏好的影片與聲音

VA-Judger 以人類偏好比較影片和聲音生成結果,改善單靠獨立指標造成的失真與獎勵錯配。

VA-Judger training pipeline

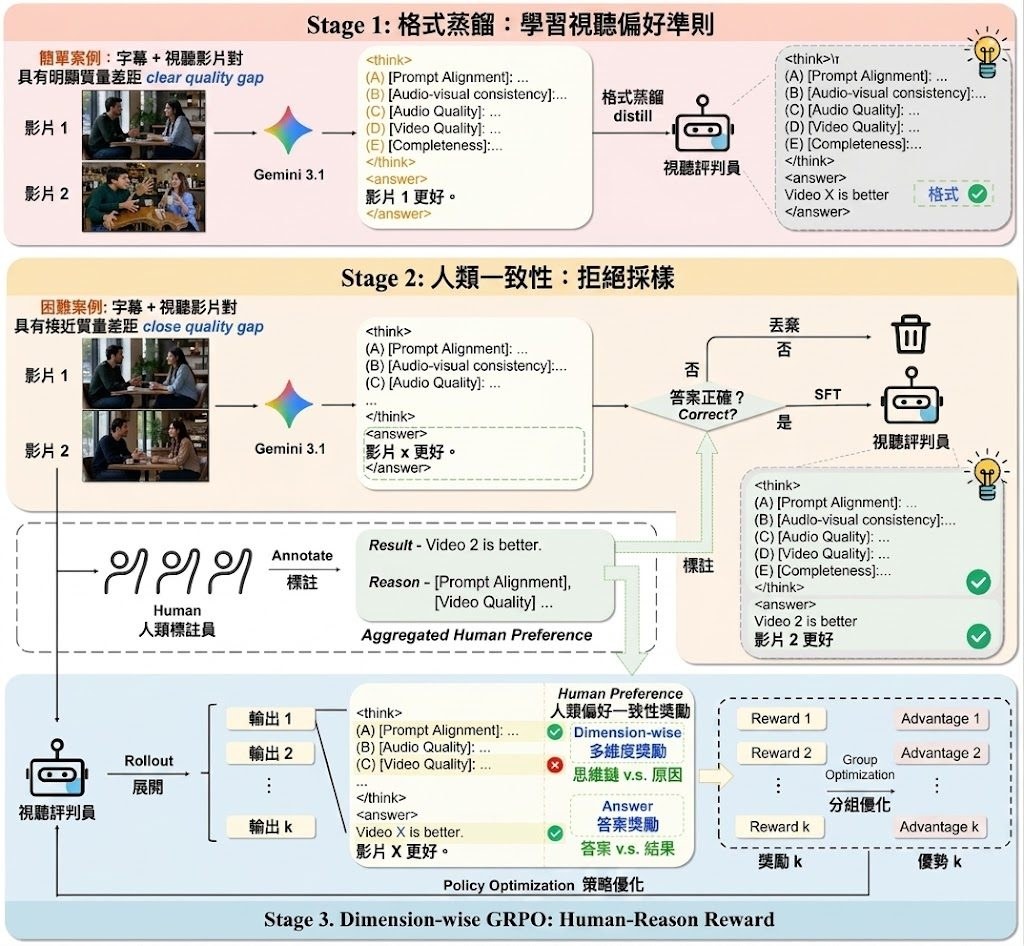
同一個提示詞產生兩段影音內容時,VA-Judger會比較哪一段更符合人類偏好,並拆解提示詞對齊、影音一致性、音質、畫質及內容完整度。它屬於聯合影片與音訊生成的 Reward Model,處理傳統指標難以捕捉整體連貫性的問題。

模型以 Qwen3-Omni 為基礎,先從品質差距明顯的配對學習比較準則,再透過拒絕採樣處理接近的結果,最後以 dimension-wise Group Relative Policy Optimization(GRPO)把人類回饋分配到不同品質維度。這比把音質、畫質及同步指標簡單相加更貼近觀看者的整體判斷,也減少生成模型鑽指標漏洞的機會。

VA-Judger-Bench包含同領域及跨領域模型比較,用來測試 Reward Model 是否能對齊人類選擇;研究結果指向它優於多項指標基線。VAPref-10K則包含9K提示詞及10.3K組細緻的影音配對比較,但資料集及部分訓練程式仍未發布。

項目提供 Reward Model 推理、Video Model 推理、模型 SFT,以及以 VA-Judger 分數優化 LTX-2 的流程;README亦列出合併已發布 RL LoRA 的 LTX-2 checkpoint。提供的資料沒有列出完整安裝步驟,使用者需要按項目頁面、checkpoint及程式碼狀態自行確認環境。

  • 適合場景:研究影音生成、偏好對齊及 RL post-training 的團隊
  • 可評估內容:提示詞對齊、影音一致性、音質、畫質及內容完整度
  • 主要取捨:比較人類偏好的方法較全面,但需要配對資料及額外訓練流程
  • 目前限制:dimension-wise GRPO 程式碼及 VAPref-10K 仍列為待發布項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 視頻模型, 模型訓練, Qwen, Video, LTX, Dataset 數據集

Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

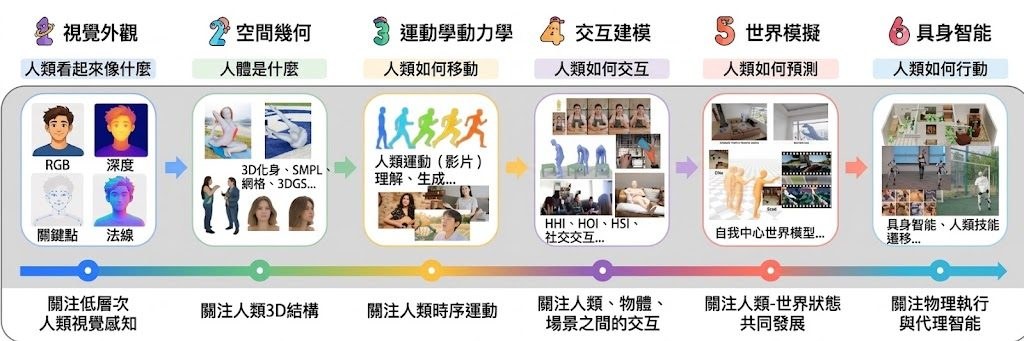
做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

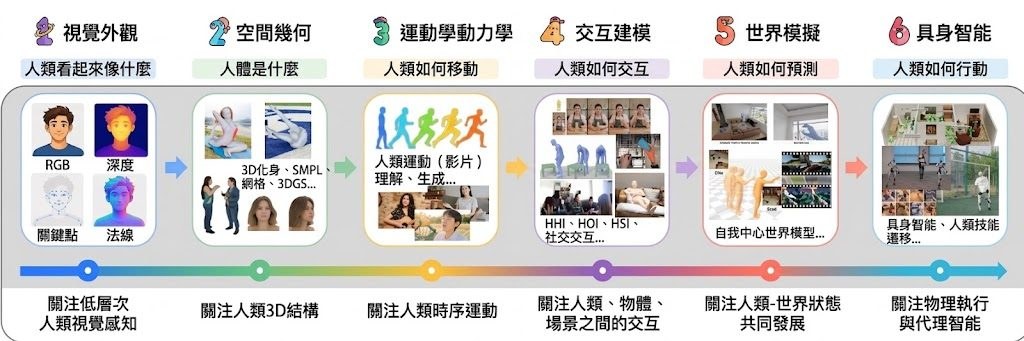
伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

資源庫並非可直接下載執行的模型或軟件,使用方式是瀏覽 GitHub 內容及項目首頁,按 Academic Knowledge、Research Infrastructure 和 Community Learning Hubs 等部分尋找材料。研究者亦可透過社群渠道提交或維護資源,因此內容會隨社群整理持續更新,但完整度和一致性仍取決於後續貢獻。

伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者,GitHub 資源庫和 survey 應該一併閱讀;只想立即執行模型或測試 API 的使用者,則需要另找具體實作項目。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

UniSpace:把理解、生成與編輯放進同一視覺空間

UniSpace 嘗試用同一套視覺表示處理影像理解、生成與編輯,但首個程式版本仍未包含訓練流程。

UniSpace logo

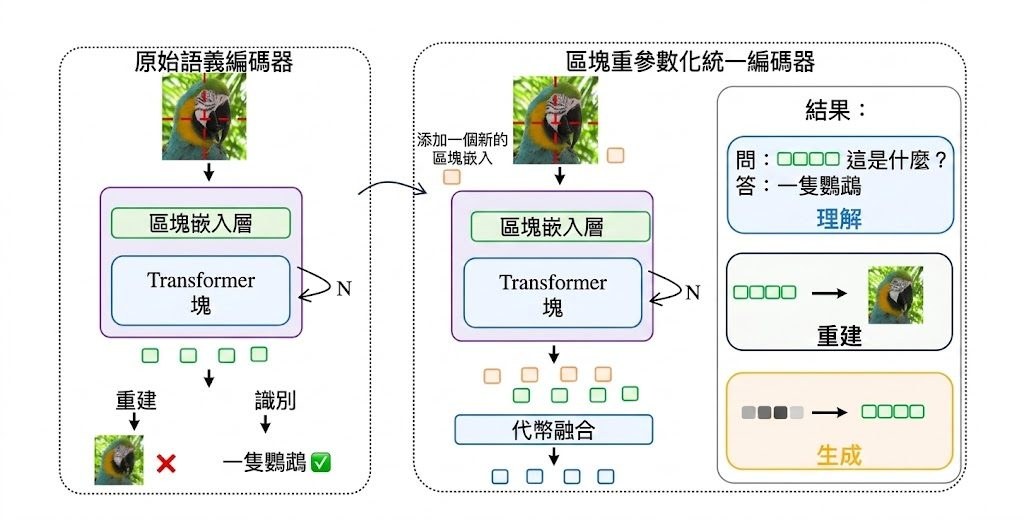
影像模型往往要在語意理解與畫面細節之間取捨,UniSpace 以統一視覺表示同時處理理解、生成和指令式編輯,定位是多模態模型及推理評估項目。它由 patch-reparameterized vision encoders 和 Qwen3-8B Mixture-of-Transformers 組成,前者保留預訓練模型的語意能力,再補足重建與生成所需的細節。

三款 encoder 分別是 PR-SigLIP2、PR-DINOv2 和 PR-Qwen-ViT;UniSpace 則使用配備 Qwen-based patch-reparameterized tokenizer 的視覺空間。這種分工讓同一套表示可以連接理解、文字生成影像及影像編輯,但也代表模型效果取決於 encoder、tokenizer 和多模態 backbone 能否協調工作。

ImageNet-1K 256 × 256 重建測試使用 50,000 張驗證影像,PR-DINOv2 取得最高 PSNR 30.84、SSIM 0.90 和最低 rFID 0.14。生成測試同樣使用 50,000 個樣本;PR-DINOv2 配合 Classifier-Free Guidance (CFG) 後,gFID 為 1.877、IS 為 274.16,但 Recall 由 0.637 降至 0.605,反映畫面品質與覆蓋範圍之間仍有取捨。

目前最需要留意的是可重現性,而不是安裝難度。儲存庫屬於 paper-time landing release,首個程式版本只會提供 inference 和 evaluation,訓練程式及內部數據管線不公開;在預期檔案和 checkpoints 尚未完整發布前,fresh clone 不能直接執行命令。研究團隊、模型評測人員和需要比較視覺 encoder 的開發者可先參考固定 seed、採樣步數及評測規則,待穩定版本發布後再驗證結果。

  • 能力範圍: 統一支援影像理解、生成與 instruction-based editing。
  • 模型關係: PR-SigLIP2、PR-DINOv2、PR-Qwen-ViT 提供視覺表示,Qwen3-8B Mixture-of-Transformers 負責多模態處理。
  • 評測結果: PR-DINOv2 重建 rFID 0.14,UniSpace GenEval 整體分數 0.84,DPG-Bench 為 86.49。
  • 限制: 目前欠缺可由 fresh clone 直接執行的完整程式、訓練流程及內部數據管線。

項目主頁 · GitHub

Categories: 開源, 多模態模型, Qwen, Clone, Dataset 數據集

Page 3 of 18
1 2 3 4 5 18