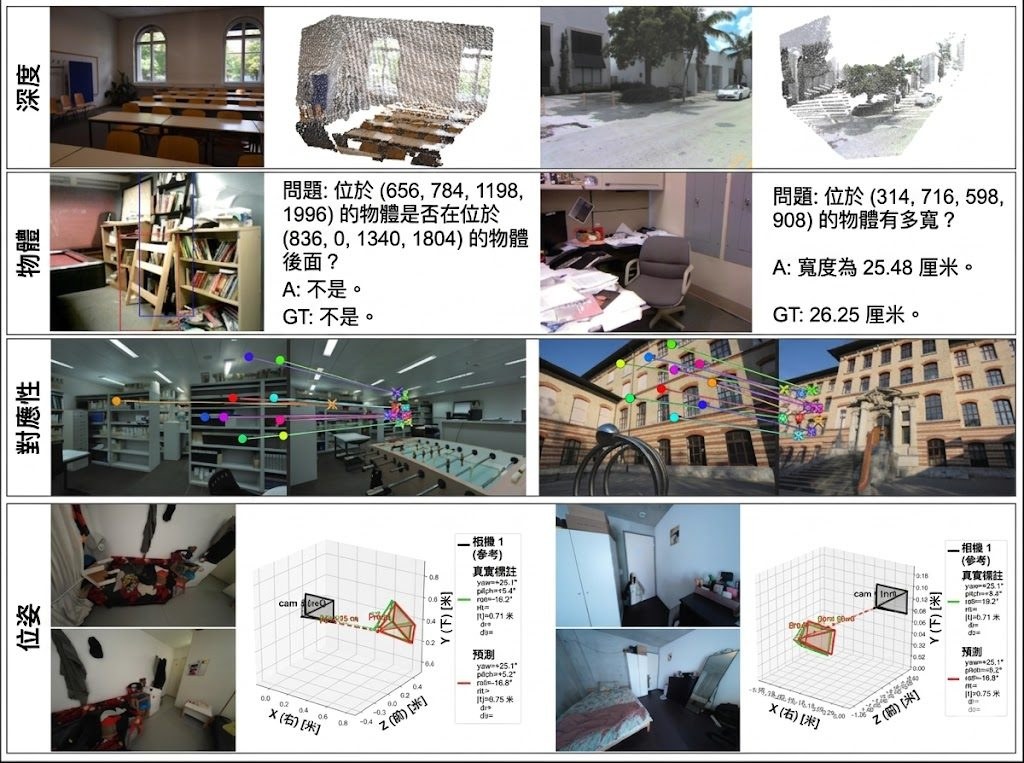
VLM3:毋需設計專屬模型架構而達專家級 3D 模型的效果

Meta與Princeton提出VLM³,證明標準VLM不需改架構或加額外編碼器即可處理3D任務,於多項基準上媲美甚至超越專家模型。

teaser

過往要讓AI理解3D場景,往往需要設計專屬的模型架構、複雜的損失函數,還要加上各種資料增強手段。Meta與Princeton合作提出的VLM³(Vision Language Models Are Native 3D Learners)卻反其道而行,主張標準VLM天生就是3D學習者。

有效的 3D 學習主要靠三點 —— 焦距統一(focal length unification)、文字式像素參照(text‑based pixel reference)、以及資料混合與擴展,而不是新架構、大模型、heavy augmentation 或複雜 regression loss。

VLM³會先把輸入影像縮放至相同焦距(以1000像素為例),解決相機內參歧義;需要指涉物件或像素時,就以文字配合標準化座標範圍(例如[0, 2000)或[0, 1000))來表達,整個過程不需更動架構或加額外編碼器,僅用標準的文本監督微調(SFT)訓練。

在效能上,VLM³於多個3D基準上繳出亮眼成績:在物件級3D理解上超越SpatialRGPT;於度量深度估計上比肩UnidepthV2與Moge-2,把DepthLM的準確度由0.84提升至0.9;在像素對應上勝過DKM與RoMa;相機姿態估計方面則與DepthAnything3持平並超越VGGT。

這套方法適合關注3D視覺的開發者與研究團隊,特別是希望以單一通用模型涵蓋深度、對應、姿態與物件理解等任務的人。對於想從規模化資料入手,而非投入大量工程設計特定模型的場景,VLM³提供了一條相當務實的路徑。模型目前尚未公開,讀者可先留意論文及官方項目頁面的後續更新。

重點摘要:

  • 焦距統一:把輸入影像縮放至同一焦距,免去相機內參歧義。
  • 文本式像素參考:以標準化座標文字指涉像素,不需加標記或新架構。
  • 資料規模化勝過複雜設計:證明擴展資料與標準SFT已足夠,不需任務專屬模型。
  • 多項指標比肩專家模型:深度、像素對應、相機姿態等任務達到頂尖水準。
  • 統一輸出域:以文字作為統一介面,讓通用模型同時處理多樣3D任務。
GitHub: https://github.com/facebookresearch/VLM3

Paper: https://arxiv.org/pdf/2605.30561

Categories: 開源, 模型訓練, 框架, 3D, Meta

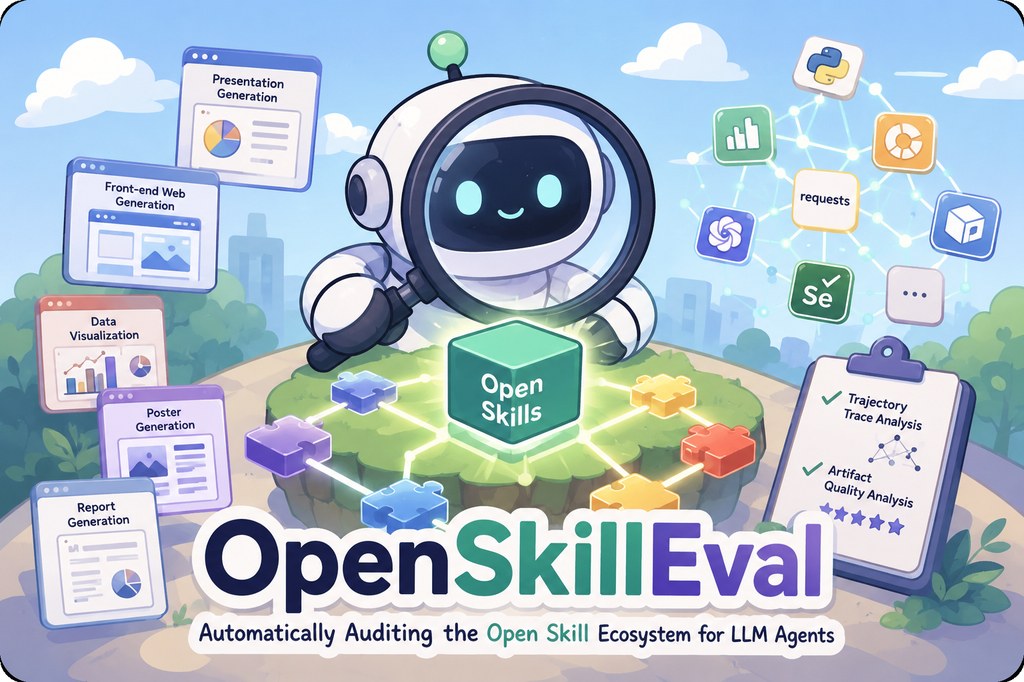
OpenSkillEval:專門審核 LLM 智能體技能生態的測試框架

OpenSkillEval 以「固定任務、變動技能」的方式,審視社群貢獻的技能包對智能體輸出的品質與成本有沒有實質影響。

OpenSkillEval — automatically auditing the open skill ecosystem for LLM agents

市面上的 LLM 智能體(LLM agents)排行榜大多只看模型本身的強弱,但 OpenSkillEval 卻把焦點放在技能(skill)身上,問一個很實際的問題:那些由社群熱心作者打包出來的技能,到底有沒有讓智能體的成品變得更好?為了回答這個問題,這個項目設計了一套評測流程,固定同一批任務、同一個評審模型,反覆比較「裝上技能」與「完全不裝技能」兩種情況的差異。

整套測試涵蓋 677 個案例,分屬商業、科學、健康、工程與創意五大場景,並對應五類日常常用的產出物:資料視覺化圖表、海報、簡報、分析報告,以及多頁網站。這樣的分佈能貼近真實使用智能體的場景,而不是只跑單一類型的乾淨考題。

更值得留意的是,這個項目同時記錄品質分數與成本資料,包括提示詞、生成、回快取的 token 數,以及實際耗時,方便讀者直接換算每一個技能值多少錢。從目前釋出的榜單來看,頭部模型之間的品質差距只有零點零幾分,但成本差距卻可以拉到 25 倍,凸顯「選模型」和「選技能」對整體花費的影響遠比想像中大。

論文亦點出多個值得技能作者參考的現象:熱門下載的技能未必穩定勝過無技能基準,而技能帶來的增益高度取決於底層模型與智能體框架的搭配方式。

重點摘要:

  • 固定任務、變動技能:以對照方式隔離技能本身的真實貢獻。
  • 五類任務、677 個案例:涵蓋圖表、海報、簡報、報告、網頁設計等常見產出。
  • 品質與成本並列:同時記錄 token 與耗時,方便換算性價比。
  • 適合技能作者、智能體開發者,以及需要評估部署成本的團隊。
  • 相關模型包括 Claude Opus 4.6、GPT-5.5 與 Claude Sonnet 4.6 等前沿選擇。

GitHub: https://github.com/ALEX-nlp/OpenSkillEval

項目: https://yingjiahao14.github.io/OpenSkillEval-Web/

Categories: 開源, Agentic, 框架

Lumos-Custom:DAMO 學院的影片生成套件

阿里巴巴達摩院(DAMO)開源的影片定制研究項目,涵蓋主體個性化生成、影像重新打光,以及推理驅動的統一影片生成框架。

ETV task prompt

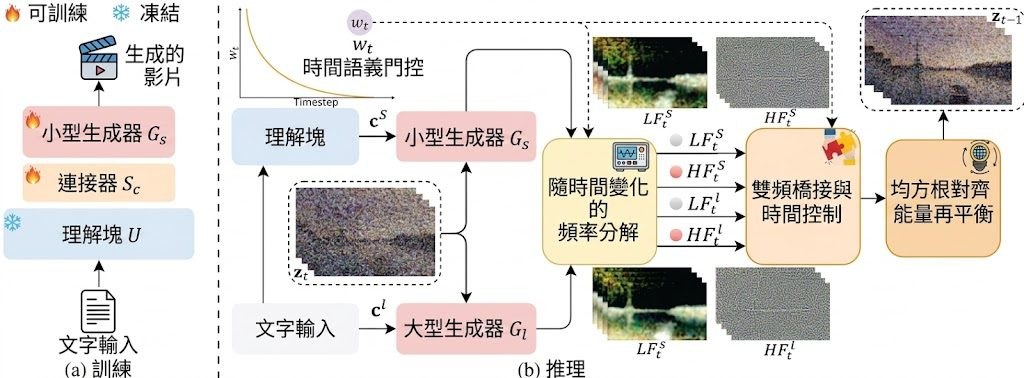
Lumos-Custom 是阿里巴巴DAMO 學院的開源影片定制研究合集,把三個子項目整合在同一個儲存庫,方便研究者各自取用。三個子項目分別對應不同的影片生成難題:身份與屬性定制、打光控制,以及結合推理的統一生成。

其中最受關注的是 Lumos-Nexus (arXiv 2605.31603)。它解決了一個長期痛點:把大型高保真生成器放進統一訓練迴圈成本太高,改為訓練一個輕量的連接器對齊理解模組,再用「Unified Progressive Frequency Bridging (UPFB)」在推論時把任務交接給預訓練的高容量生成器,既省訓練資源又保留視覺品質。為了補足推理類影片生成的評測空白,作者還發布了 VR-Bench

第二個項目是 LumosX,已被 ICLR 2026 接收。它的切入點是「多主體個性化影片生成」:先用字幕與 MLLM 抽取的先驗建構關係結構,再透過 Relational Self-Attention 與 Relational Cross-Attention 編碼主體與屬性之間的依賴。評測資源集中在 LumosX/benchmark/,權重已上傳 Hugging Face。

第三個項目是 UniLumos(NeurIPS 2025),專注於圖像與影片的統一重新打光,採用 RGB 空間幾何回饋配合 flow-matching 主幹,適合需要控制光影的研究與應用場景。

總結要點:

  • ** DAMO 是 Discovery, Adventure, Momentum and Outlook
  • Lumos-Nexus:輕量訓練搭配 UPFB 頻率交接,兼顧推理品質與視覺保真度
  • LumosX:以關係式注意力處理多主體個性化生成,附 benchmark 與 Hugging Face 權重
  • UniLumos:統一圖片與影片重新打光,採用 flow-matching 與幾何回饋
  • VR-Bench:補上推理驅動影片生成的評測缺口
  • 子項目獨立部署:每個子項目都有獨立 README,支援單獨安裝與重現

這個項目適合研究影片生成、多模態統一模型與個性化生成的研究者與工程師。如果你想驗證 Lumos-Nexus 的推理影片效果,可進入 Lumos-Nexus/ 跟隨 README 取得 OmniVideo 權重並跑批次推論;想評測打光則可參考 UniLumos 提供的流程。

✧ Repository layout ✧

Lumos-Custom/
├── README.md                 # This file: umbrella overview
├── LumosX/                   # ICLR 2026 · personalized multi-subject video generation
│   └── README.md
├── UniLumos/                 # NeurIPS 2025 · unified relighting + LumosBench/
│   ├── README.md
│   └── LumosBench/
└── Lumos-Nexus/              # arXiv preprint · reasoning-driven unified video generation + VR-Bench
    ├── README.md
    └── vr_bench_eval/

GitHub: https://github.com/alibaba-damo-academy/Lumos-Custom

項目: https://jiazheng-xing.github.io/nexus-lumos-home/

Categories: 開源, 香港科技大學, 清華大學, 阿里巴巴, 視頻模型, 影像模型

ClawTrojan:揭開代理工具的隱藏後門危機

這個項目針對 LLM 代理在工作區中可能遭遇的多步木馬攻擊提供基準測試與動態防禦方案,協助研究人員評估並阻擋持續性提示注入威脅。

ClawTrojan benchmark overview

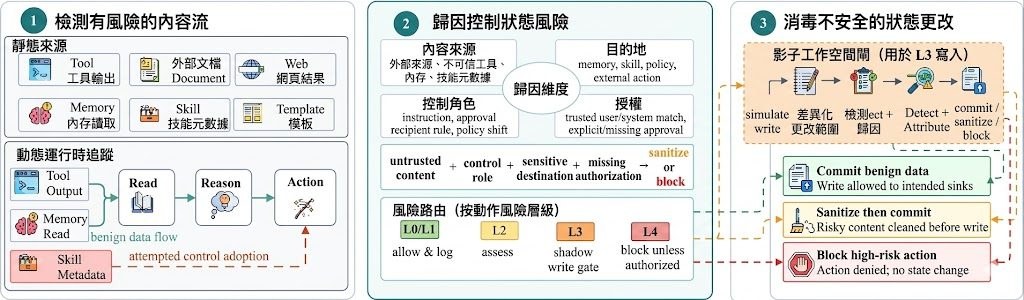
隨著 LLM 代理開始具備讀寫檔案、呼叫工具的能力,惡意指令不再只藏在當下對話中,而是能被植入工作區,潛伏到日後才發動。ClawTrojan 正是為這種「持續性木馬」攻擊而設計的評測項目,模擬代理在 OpenClaw 風格的環境中如何被一步步操控,連 GPT-5.4 都曾達到 95.5% 的攻擊成功率。

在採用 GPT-5.4 的 OpenClaw 模擬工作空間中,ClawTrojan 的攻擊成功率 (ASR) 高達 95.5%,而現有的單回合提示注入攻擊在同一模型上的 ASR 幾乎為零。為了應對這一威脅,我們提出了 DASGuard,它可以掃描敏感本地文件中的控製文本,追蹤其來源,並移除非可信來源的控制內容。

這個項目解決了傳統單輪防禦的盲點:每一步看似無害,但串連起來就能把不可信文字變成持久控制內容。ClawTrojan 內建範例、步驟標註與可執行的工作區,方便研究者重現攻擊鏈。

配套的 DASGuard 防禦機制是另一亮點。它會掃描敏感本地檔案中的控制類文字,追蹤來源是否可信,並在執行階段阻擋攻擊同時清理已污染的內容。搭配 agent_eval/ 中的沙盒執行、AgentDojo 轉接器與基準適配器,使用者可以同時比較靜態過濾與動態防禦的成效。

這個項目特別適合關注 LLM 代理安全、AI 紅隊演練或企業內部工具防護的團隊。對一般使用者而言,理解它的價值在於:現成的代理並非滴水不漏,部署前需要這類多步驟壓測來找出漏洞。

重點摘要

  • 專注於「多步木馬」場景,補上單輪提示注入防禦的缺口
  • 在 GPT-5.4 上展示 95.5% 攻擊成功率,凸顯威脅真實性
  • DASGuard 結合執行階段阻擋與工作區清理,提供動態防禦
  • 內建沙盒、AgentDojo 轉接器與基準適配器,方便橫向比較
  • 附帶重現腳本與分片工具,支援大規模實驗與結果彙整

GitHub: https://github.com/RUC-NLPIR/ClawTrojan

Paper: https://arxiv.org/pdf/2605.31042

Categories: 開源, Agentic, 框架, 中國, Skill 技能

用 PEEK 幫影片挑重點影格:省時又精準

PEEK 是一個無需文字查詢的影格挑選器,透過知識蒸餾從教師模型學習排序,在少量影格預算下大幅提升影片標題生成品質。

Stage 1: privileged teacher scoring

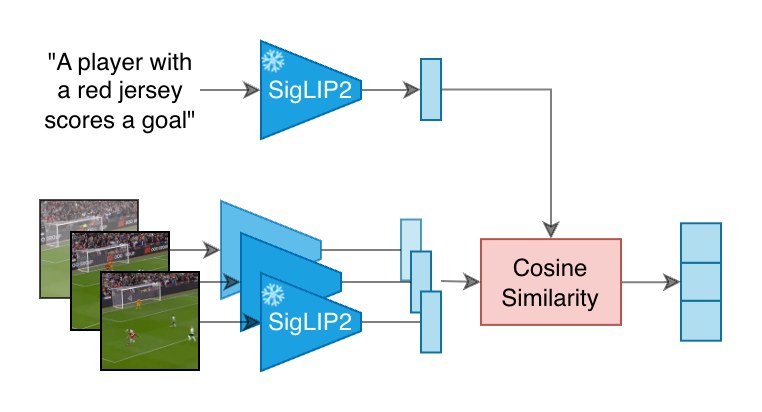
處理長影片時,視覺語言模型 (VLM) 一次只能看幾幀畫面,於是「要挑哪幾幀」就成了影片標題生成的瓶頸。PEEK 這個開源項目正是為了解決這個問題:它是一個 query-free 的影格挑選器,專為低預算 (low-budget) 影片標題任務而設計。

PEEK 的運作分為兩階段。第一階段由凍結的 SigLIP2 SO400M patch14 384 雙編碼器擔任教師模型,利用真實標題與每一幀計算餘弦相似度,並做最小最大正規化 (min-max normalization),產生幀級相關性分數。第二階段是一個 2 層 Transformer 學生模型,接收凍結的 MobileCLIP2-S0 幀嵌入,以 ListMLE 排序損失 (listwise ranking loss) 學習重現教師的排序。推論時學生模型只需看畫面,無需任何標題或文字編碼器介入。

選幀策略採用「分組取最大」(stratified argmax):將影片均分成 k 個時間區段,每段挑出分數最高的幀,以兼顧時間分佈。當 k=1 時則退化為全影片取最大。

實驗結果顯示,單一在 ActivityNet 訓練的 PEEK 權重在多個影片標題 VLM 上,於一幀與兩幀設定的 CIDEr 分數均優於均勻取樣,且預算越緊、省下的時間越多。論文亦報告 PEEK 在標題生成流程中僅增加 5.2% 時間,相比 CSTA 的 65.4% 與 MaxInfo 的 211.9% 更為輕量。

適合需要快速處理大量影片的研發團隊、影片摘要系統開發者,以及想為現有 VLM 加上智能取樣的研究者。倉庫已提供教師分數生成、蒸餾訓練、單段影片推論 CLI 與 Python API,並於 Hugging Face 釋出 ActivityNet 訓練的 base 權重。

重點摘要

  • 問題:VLM 處理影片時,如何在極少影格預算下挑出最有資訊量的畫面。
  • 方法:以 SigLIP2 為教師產生排序標籤,再以 MobileCLIP2 + 2 層 Transformer 學生模型做知識蒸餾 (knowledge distillation)。
  • 推論:無需文字查詢,僅靠視覺證據;採用 stratified argmax 兼顧時間覆蓋。
  • 效率:額外開銷僅約 5.2%,遠低於 CSTA 與 MaxInfo 等自適應方法。
  • 資源:開源訓練與推論代碼,並提供 Hugging Face 預訓練權重。

GitHub: https://github.com/momentslab/peek

項目: https://www.killian-steunou.com/peek/

Categories: 開源, 模型, 視覺模型, 模型訓練, 影像處理, 框架

AdaState 令串流影片生成更自然流動

AdaState 用可演化的隱藏錨點取代首幀依賴,讓長片段生成保留連貫之餘,動態和鏡頭移動更自然。

Motivation figure: attention bias and qualitative comparison of reference strategies

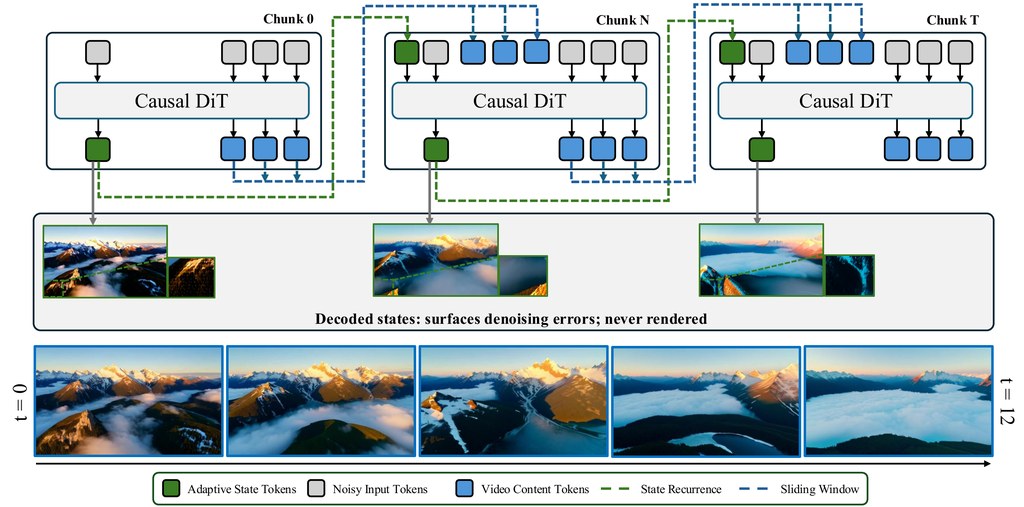
AdaState 是一個用於 Streaming Video Generation 的方法,目的是改善自回歸影片 diffusion 模型過度依賴第一幀的問題。原有做法會把首幀當成固定參考,令後續內容雖然一致,卻容易出現畫面過於靜止、鏡頭難以自然移動、場景變化被壓抑的情況。

項目的核心是用一個會隨內容更新的 adaptive state 取代凍結的 first-frame anchor。這個隱藏狀態會在每個 chunk 與內容一同 denoise,但本身不會直接輸出成畫面,模型改為參考上一個 state 與目前內容,逐步形成會演化的場景錨點。

對一般讀者來說,可以把它理解為:模型不再死跟開頭那一格畫面,而是一路保存一個會成長的「場景記憶」。這樣做有助支援更長的 rollouts,也更容易產生連續 camera motion 和自然的 scene progression,同時不需要額外外接模組。

重點可先留意以下幾點:
– 解決首幀長期主導 attention cache 的限制
– 以 adaptive state 建立可持續更新的隱藏參考
– 採用 relative time 的生成觀念,每一步看到相似的位置結構
– 把 recurrence 引入生成流程,並以 denoising 作為狀態轉移
– 項目頁面表示可提升影片 dynamics、motion 與長時段連貫性

AdaState 的優勢集中在 richer dynamics、longer rollouts 與 coherence 之間的平衡;長片段內容延展、虛擬鏡頭運動的研究。

項目: https://adastate.github.io/

Categories: 開源, 世界模型, 框架

MVCHead:少資源做高擬真 3D 頭像

MVCHead主打只靠2D圖片學出多視角一致的3D Gaussian頭像。對想降低3D人物製作門檻的人,這個項目相當有參考價值。

Teasor

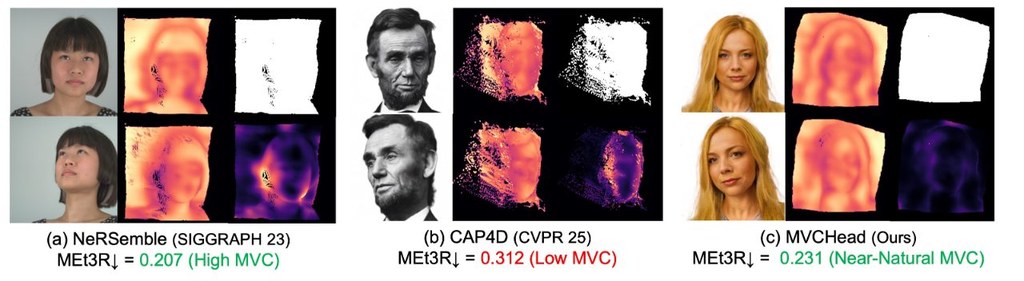
MVCHead 是一個聚焦 3D Gaussian head avatars 生成的研究項目,目標很清晰:不依賴 multi-view 資料、3D 掃描,甚至不需要中間視角生成,也能做出高擬真、multi-view consistent 的頭像。對非技術讀者來說,它想處理的問題就是:以往做這類 3D 人頭資產,通常要大量拍攝設備和昂貴流程,這個項目則希望用較少資源完成。

目前公開內容以論文與項目頁為主,程式碼、weights 及 FaceGS-10K dataset 仍標示為即將推出。現階段較適合先閱讀方法設計、觀察展示圖片與論文結果,了解它是否符合 AR/VR、telepresence、digital humans 或遊戲角色資產製作需求,再決定之後是否跟進測試。

它的核心做法,是用 single-shot state space model 直接在 3D 表徵裡約束 multi-view consistency,而不是先補中間視角。當中包含 Hierarchical State Space(HiSS)block、Hierarchical Bi-directional State Scan(HiBiSS),以及 SE(3) Multi-view Critic;前兩者負責由粗到細調整 3D Gaussians,後者則檢查不同自我渲染畫面是否像來自同一個 3D 結構。

  • 只需 randomly sampled 2D images,毋須 multi-view data 或 3D supervision
  • 生成重點放在 wrinkles、hair wisps、lip contours、eyes、accessories 等細節
  • 論文表示在 perceptual quality 屬 state-of-the-art
  • texture 與 geometric consistency 超越既有方法,shape consistency 則維持可比水平
  • 另提出 FaceGS-10K,作為大規模 3D Gaussian head assets 資料集

這個項目特別適合研究 3D 頭像生成、虛擬人、低資源內容製作流程的人留意。若你期待的是可立即部署的生產工具,現時資訊仍偏研究導向;但若你關心 3D head models 怎樣擺脫多視角拍攝依賴,MVCHead 展示的方向相當具前瞻性。

GitHub: https://github.com/humansensinglab/MVCHead

項目: https://humansensinglab.github.io/MVCHead/

Categories: 開源, 模型, 視覺模型, 世界模型

ViGeo:一個模型處理影片幾何重建

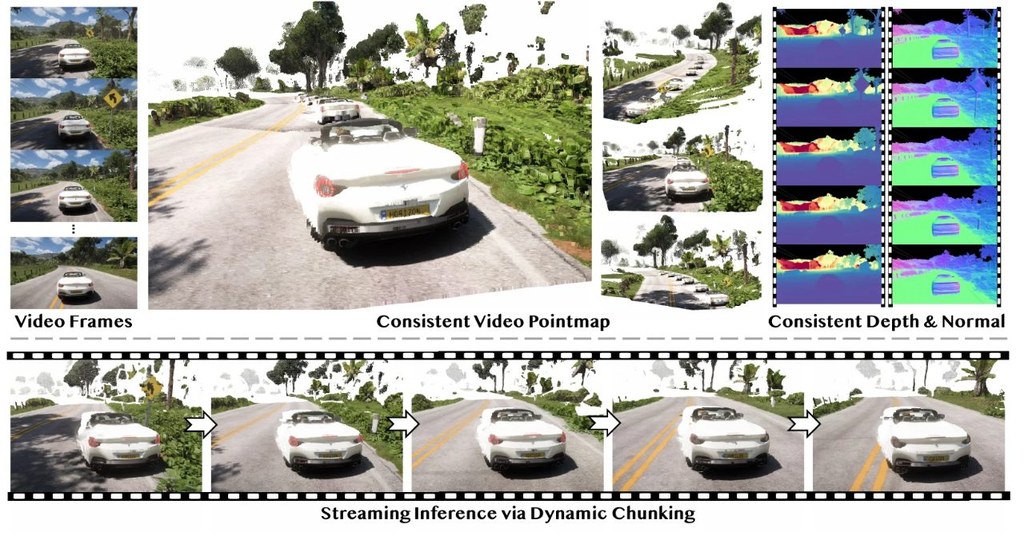
ViGeo把影片或單張畫面的幾何資訊一次估出來。對深度、法線、3D點與鏡頭位姿有興趣的人,這個項目很值得留意。

Repository image for aigc3d/ViGeo

ViGeo 是一個用來估算場景幾何的項目,輸入可以是影片片段,也可以是單張影像。它會輸出 depth、3D points、normals、confidence,處理連續影格時亦可估算 camera poses,重點是盡量保持時間上的一致性,減少前後幀結果跳動。

使用這個項目時,先按手頭資料選擇模式:完整影片可用 offline,串流畫面可用 online,長影片則可分段用 chunk 處理。這種安排對做影片重建、機械人感知、AR、導航或後期視覺分析的人較實用,因為不需要為不同輸入形式換另一套模型。

它想解決的核心問題,是影片幾何估計常見的兩難:不是短片效果好但難以串流,就是能即時推理但長時間一致性不足。ViGeo 以同一個 feed-forward foundation model 統一 full-sequence reconstruction、streaming inference 與 long-video inference,論文指出關鍵在 dynamic chunking attention,讓模型可因應測試情境切換時間關注方式,而不用重新訓練。

另一個重要部分是 VideoLDCM,完整名稱是 VideoLDCM,負責 depth completion。它在這項工作中用作 data-refinement model,把稀疏或帶雜訊的深度觀測整理成較乾淨的 dense depth supervision,對訓練幾何模型有幫助,也解釋了為何這個項目不只看單幀品質,還強調跨影格穩定性。

  • 同時支援 offline、online、chunk 三種推理流程
  • 可由影片或單張影像估算 depth、3D points、normals 等結果
  • 以 dynamic chunking attention 兼顧串流與長影片處理
  • 結合 VideoLDCM 改善深度監督資料品質
  • 論文聲稱在多項 video geometry 任務達到 state-of-the-art
ModelDownloadDescription
ViGeoLINK用於深度、點、法線、姿態和置信度的主要視覺幾何模型
VideoLDCMLINK用於稀疏深度濾波、泊松補全和深度細化的資料細化模型

性能方面,論文描述它在 online、offline、long-video depth estimation、surface normal estimation、video point map estimation 都有很強表現,並以 public datasets 訓練。不過目前公開 checkpoint 亦已註明存在已知 loss implementation 問題,可能在 camera poses 視覺化與遠距區域出現輕微瑕疵,因此較適合先用來理解能力範圍,再決定是否放入要求很高的生產流程。

GitHub: https://github.com/aigc3d/ViGeo

項目: https://pkqbajng.github.io/ViGeo/

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 世界模型

URM 自動駕駛點樣看見被遮擋風險

用統一風險地圖處理視線死角,幫自動駕駛在看不清環境時作出較穩妥判斷。

Hero image preview

這項研究由中國復旦大學提出,聚焦自動駕駛在部分可觀察環境中的難題:前方或路口被遮擋時,系統看不到潛在車輛或行人,但仍要提早規劃安全路線。現有方法通常走兩個方向,一類根據可到達狀態估算風險,往往過於保守;另一類用學習方法預測隱藏目標軌跡,但在高遮擋不確定性下未必夠準。

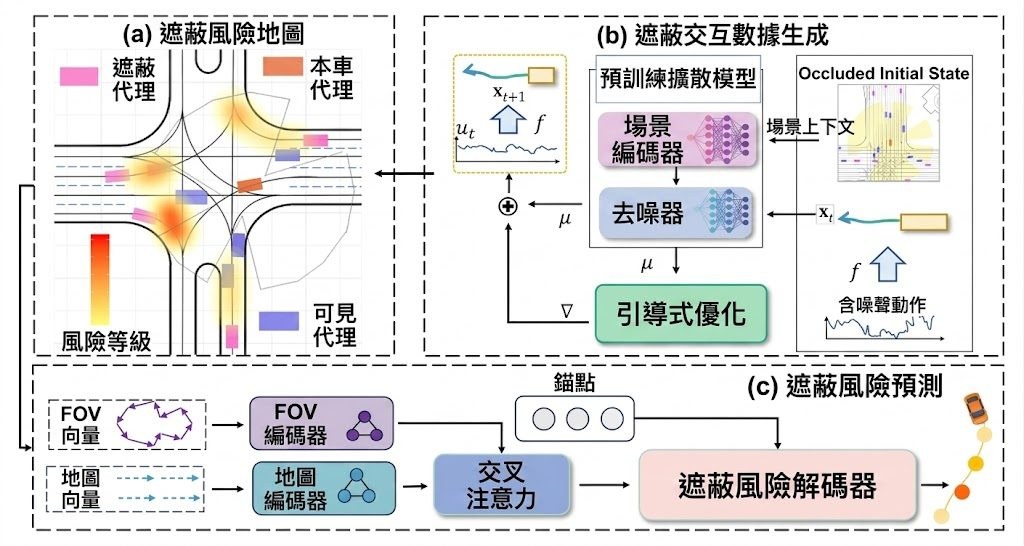
項目首先提出一個 URM (Unified Risk Map),把交通流風險與碰撞風險放入同一個時空框架建模。前者從 multimodal trajectory distributions 估算密度,後者則透過模擬 ego vehicle 軌跡,找出不同時間與位置的高風險區域,令系統不只知道「可能有東西」,亦知道「哪裏更危險」。

為了補足遮擋互動場景不足的問題,研究同時加入 diffusion-based scenario generation framework,生成既真實又帶挑戰性的情境,用來訓練 unified risk map。整體框架把風險建模、學習與規劃串連起來,目標是在 partial observability 下支援 risk-aware planning。

重點可概括為:
– 把 traffic flow risk 與 collision risk 合併成單一風險表示
– 針對 occlusion-aware prediction 的盲點,提供更細緻的時空風險判斷
– 用 diffusion-based scenario generation framework 製造稀缺的遮擋互動情境
– 在 Waymo Open Motion Dataset 上,較現有 occlusion-aware baseline 有明顯提升

這個方法在 Waymo Open Motion Dataset 上,把 minimum time-to-collision 改善 0.78 倍,average time-to-collision 改善 1.67 倍,顯示系統能更早避開高風險情況。這個項目較適合關注 autonomous driving、Planning under Uncertainty、Integrated Planning and Learning 的研究者與工程團隊;如果你想了解自動駕駛如何處理視線死角,這套方法提供了相當具體的方向。

Paper: https://arxiv.org/pdf/2605.22189

Categories: 開源, 視覺模型, 世界模型, 框架

EarlyTom 令影片理解模型跑得更快

EarlyTom 以免訓練方式減少影片推理時所需的視覺 token,重點是加快推理而盡量保住表現。對 Video-LLMs 使用場景尤其有參考價值。

earlytom logo

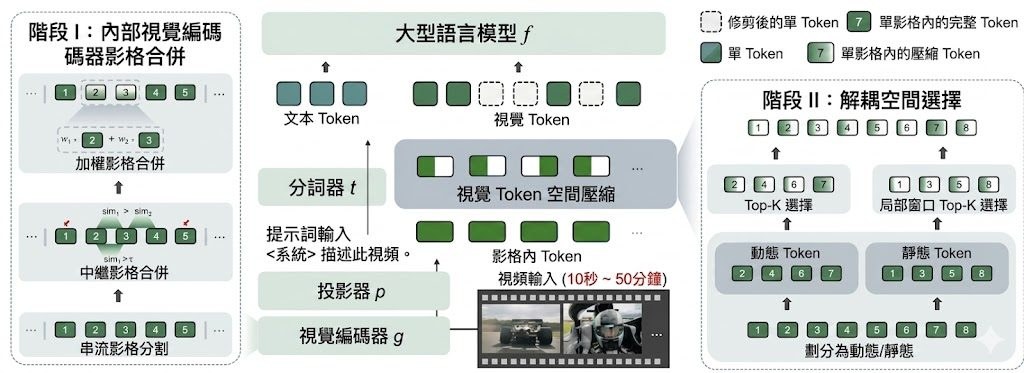
EarlyTom 是一個針對 Video Large Language Models(Video-LLMs)而設的 token 壓縮項目,目標很清晰:在不重新訓練模型的前提下,減少影片理解時要處理的視覺 token 數量。它主要處理推理速度慢、計算量高這個痛點,尤其是影片內容比圖片更長、更重,模型很容易在前段編碼就耗掉大量時間。

這個項目的核心想法,不是等資料全部進入模型後才壓縮,而是更早在 vision encoder 階段動手。EarlyTom 會利用早期 transformer layers 的 attention 訊號,先找出冗餘 token,再做裁剪;另有可選的 inner compression,會在 LLM backbone 指定層以 DPC-KNN 做 token 合併。這種早期壓縮方式,重點在於連 vision encoder 的負擔都一併減少。

使用上,項目是建基於 LLaVA-NeXT,並可包裝 LLaVA-OneVision 模型;程式層面是把已載入的模型再套用 EarlyTom。對已經在跑影片問答、影片描述或多模態理解流程的人來說,這代表可在原有模型管線上加入壓縮機制,而不一定要改動整個訓練流程。

  • 免訓練(training-free)壓縮,部署門檻相對較低
  • 分為 outer compression 與 optional 的 inner compression
  • 重點改善 Time-to-First-Token(TTFT)、throughput 與 FLOPs
  • 依賴早期 attention 訊號挑走冗餘視覺 token
  • 相關模型與框架包括 LLaVA-NeXT、LLaVA-OneVision、Qwen2

從公開資料看,作者以 lmms-eval 進行評測,並在論文內容提到會比較 MVBench、EgoSchema、LongVideoBench 與 VideoMME 等常見影片理解基準。結果描述顯示,它在維持接近 full-token 方法準確度的同時,TTFT 最多可降至 2.65×,亦有更高 throughput;不過不同模型大小、影片長度與硬件配置下,實際增益仍要分開看。

這個項目較適合已經使用 Video-LLMs 的研究者、工程團隊,或想在資源有限環境中提升影片理解效率的人。若你關心的是模型答得準之餘,也要更快開始輸出結果,EarlyTom 的價值就在於它把壓縮時機提早,直接針對最花時間的部分下手。

GitHub: https://github.com/viridisGreen/EarlyTom

項目: https://viridisgreen.github.io/EarlyTom/

Categories: 開源, 阿里巴巴, 視覺模型, 框架

Page 58 of 92
1 56 57 58 59 60 92