AdaPlanBench:A.I. 智能體適應性能力規劃

AdaPlanBench測試大型語言模型智能體在雙重約束下邊做邊改的規劃能力,揭示當前模型仍難以可靠適應動態變化的環境與用戶偏好。

Pipeline Overview

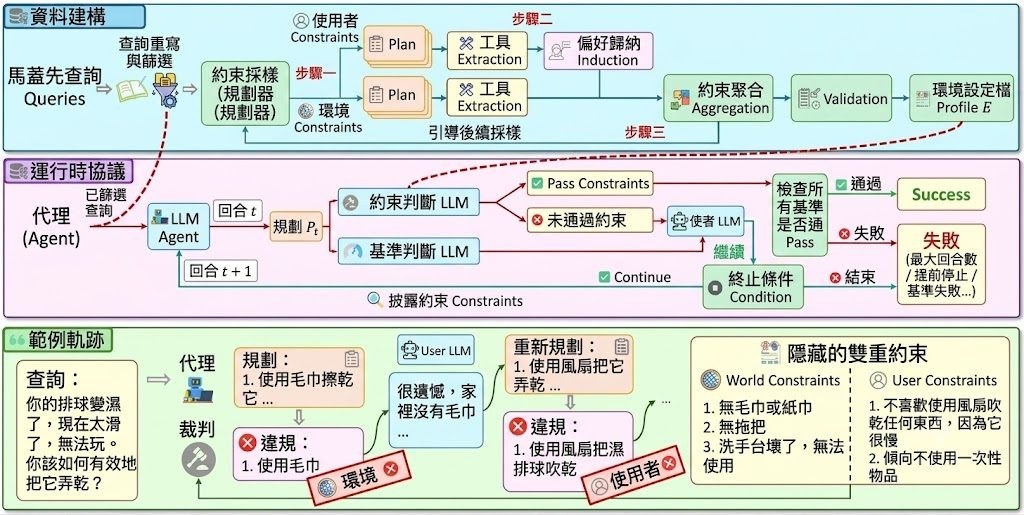
現實生活中,AI智能體幫我們安排行程、操作工具時,往往不會一開始就掌握所有限制條件,而是邊做邊發現新約束。AdaPlanBench(Adaptive Planning Benchmark)正是針對這種「邊做邊調整」的能力而設計的評測基準。它把 307 個家居任務當作起點,再用一套可擴展的約束構建流程,為每個任務加上兩類限制,逐步揭示給智能體。

這套基準的獨特之處在於「雙重約束」(dual constraints)與「逐步披露」(progressive disclosure)。一類是世界約束(World Constraints),即環境中不可用或失效的工具與物件;另一類是用戶約束(User Constraints),即用戶對工具屬性、使用方式或行為的偏好禁止。智能體每回合提交計劃,評判機制比對目前已揭示的約束並打分,違規時回饋錯誤,智能體需在多輪互動中持續修訂策略。

測試結果顯示這件事對現有模型而言並不容易。在中等約束量下,表現最強的 GPT-5 僅達到 67.75% 準確率,多數模型低於 45%,開源權重模型普遍在 30% 上下。研究亦發現,有效計劃率(VPR)高並不等於任務成功,約束增加時表現明顯下滑,而用戶約束帶來的挑戰尤其突出。

這個項目適合誰? 如果你研究 LLM 智能體的規劃能力、互動決策或多輪推理,又或者你在做 Computer-use agents(CUAs)、OSWorld 等環境的應用開發,AdaPlanBench 提供了一個貼近真實、難度可控的測試場景。約束量設有低、中、高三檔(另有 4–6 檔作壓力測試),方便按需要調整難度。

以下是這個基準值得留意的重點:

  • 雙重約束聯合測試:在同一規劃回合中同時考驗世界與用戶兩類限制,比單一約束設定更貼近現實。
  • 增量披露設計:約束隨對話逐步揭示,逼智能體從回饋中推導並追蹤限制,而非依賴一次性完整規格。
  • 可調節難度:每條查詢配備六種環境設定,已公開 Low、Medium、High 三檔,支援不同程度的壓力測試。
  • 多輪回饋循環:智能體在達標、提早停止或回合耗盡前持續迭代,提供更豐富的行為數據。
  • 多維度評估指標:除準確率外,亦記錄有效計劃率、平均回合數與重複違規率,協助診斷失敗模式。

涵蓋的模型包括 GPT-5、Claude 系列,以及多款主流開源權重 LLM,整體結果一致指向同一結論:在約束持續累積的情境下,當前 LLM 智能體仍難以做到穩健的適應性規劃。
GitHub: https://github.com/JiayuJeff/AdaPlanBench

Categories: 開源, 框架

PropMe:測試 LLM「會不會」洩漏訓練資料

PropMe 框架與 SimpleTrace 工具鏈,把「被逼才說」和「自己常說」兩種記憶行為分開量度,為模型審計提供更貼近真實使用的視角。

propme framework

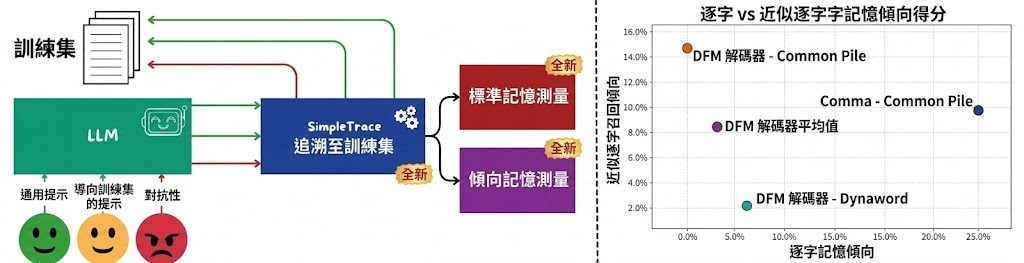
大型語言模型(LLMs)會背誦訓練資料,但現有的記憶性評估大多只關心「能不能逼它說出來」,而忽略了「它在一般使用下到底會不會自己講」。PropMe 正是針對這個落差而設計的傾向感知(propensity-aware)評估框架,它把前綴式的能力攻擊(prefix-style capability attacks)與日常、非對抗的生成結果並列比較,計算出模型在真實情境下洩漏訓練資料的傾向。

整個項目的運作有兩大部分。PropMe 負責定義指標與分析邏輯;SimpleTrace 是一個建基於 infini-gram 的輕量離線追蹤流水線,負責為訓練語料建立索引、把模型生成結果對應回來源文檔,再計算出 verbatim、near-verbatim 與傾向轉換後的記憶性指標。流程包含索引建立、unigram 機率預計算、生成結果追蹤、驗證與傾向指標運算等步驟,資料夾 README 都各有詳細說明。

PropMe 以兩個完全開源的模型——Comma 與 DFM Decoder——在 Common Pile 與 Dynaword 兩份雙語資料集上做實驗。結果顯示能力(capability)與傾向(propensity)之間存在穩定落差:前綴攻擊能引出明顯的記憶痕跡,但日常或資料集特定的提示下,傾向分數普遍偏低。另一個有趣的發現是,從 Comma 持續預訓練而成的 DFM Decoder,對 Common Pile 的記憶能力與傾向都下降,顯示後續訓練若側重不同資料,能降低既有的記憶行為。

這個項目適合關注模型安全、版權與資料外洩的研發人員、模型審計人員及學術研究者。如果你正在評估自家模型的記憶風險,PropMe 提供了把「最壞情況抽取性」與「日常洩漏傾向」分開呈現的具體做法,比單純跑前綴攻擊更能反映真實部署風險。

重點摘要:

  • 問題意識:區分模型「被逼才會背」與「日常會背」兩種不同行為。
  • 核心框架:PropMe 負責傾向指標,SimpleTrace 負責把生成結果追蹤回訓練文檔。
  • 技術基礎:建立在 infini-gram 之上,支援 verbatim、near-verbatim 與傾向轉換指標。
  • 評估模型:Comma 與 DFM Decoder,資料集涵蓋 Common Pile 與 Dynaword 兩種語料。
  • 實用價值:為模型記憶性審計提供比純粹對抗攻擊更貼近真實使用的衡量方式。

GitHub: https://github.com/N-essuno/PropMe

Paper: https://arxiv.org/pdf/2606.06286

Categories: 開源, 模型訓練, 框架

Dream.exe 評測 A.I. 生成的「夢境」能否真的驅動機械人?

Dream.exe 嘗試把影片生成模型的「想像」轉化為機械人可執行的軌跡,並用101項任務評估8款模型。影片好看不代表可執行,是這份研究最值得關注的發現。

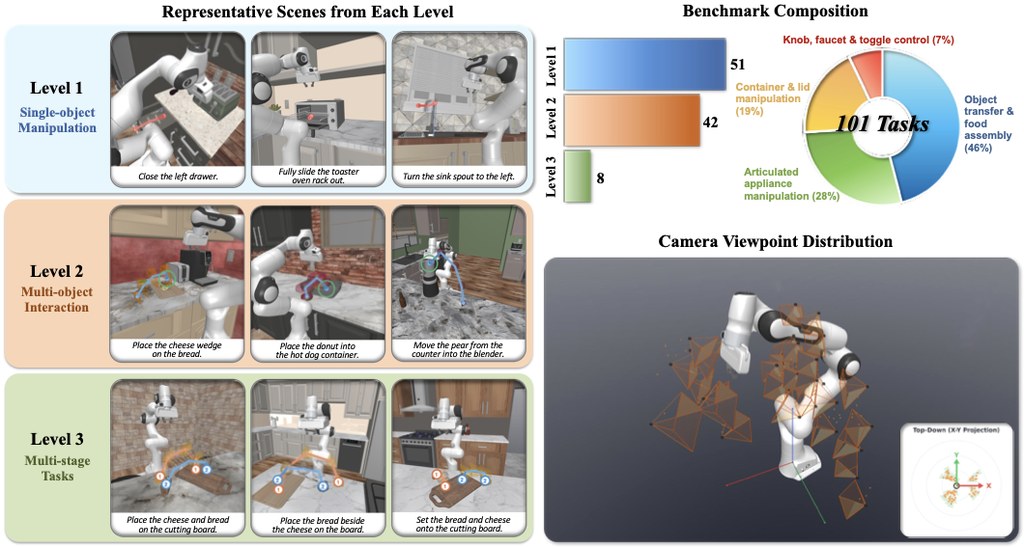
Overview of the Dream.exe task suite

過去兩年,影片生成模型(Video Generation Models)的能力突飛猛進,但大多數評估都停留在「畫面是否好看」這個層面。來自新加坡國立大學 Show Lab、牛津大學及 Tencent 的研究團隊推出 Dream.exe 項目,提出一個更根本的問題:模型在影片中「夢到」的操作動作,機械人真的能照著做嗎?

Dream.exe 的運作流程相當直觀。系統接收一張場景圖片與任務描述後,會先生成一段操作影片,再把當中的動作提升為 3D 機械人軌跡,最後放到物理模擬器中執行。研究團隊採用了 101 項任務,這些任務從 RoboCasa 數據集中精心挑選,並按物理複雜度分為三個等級,評分維度涵蓋視覺品質、軌跡擬真度,以及最關鍵的執行成功率。

評估涵蓋 8 款模型,包括前沿閉源模型如 Veo 2 及 Sora、開源模型如 Wan2.1,以及專為機械人設計的影片生成器。所有模型都採用統一的評測協議,確保比較公平。

這份研究帶來幾個值得留意的地方:

  • 物理知識其實已經藏在生成模型之中。 部分模型在沒有經過任何機械人專項訓練的情況下,仍能達到可量度的執行成功率。
  • 影片好看不代表能執行。 物理合理性評分與任務成功率的相關性極低,意味著以視覺質素判斷模型是否「有用」並不可靠。
  • 長時任務仍是痛點。 需要多階段協調的操作,會迅速暴露現有模型的極限。

對於機器學習研究者、機器人工程師,以及關注世界模型(World Models)與具身智能(Embodied AI)發展的讀者,這份基準測試提供了一個可重複使用的評估框架。研究團隊已表示將開源代碼、基準數據及評測工具,預計會引起不少關注。整體而言,Dream.exe 把影片生成模型從「看的技術」推向「用的技術」,是 2026 年具身智能研究中具代表性的方向之一。

GitHub: https://github.com/showlab/Dream.exe

Categories: 開源, 視覺模型, Robotic, 框架

WLA:整合世界、語言與動作模型

上海交大 DENG 實驗室發佈的 WLA 模型,把世界建模、語言推理與動作生成三項能力整合於一身,是統一型多模態 AI 的一次新嘗試。

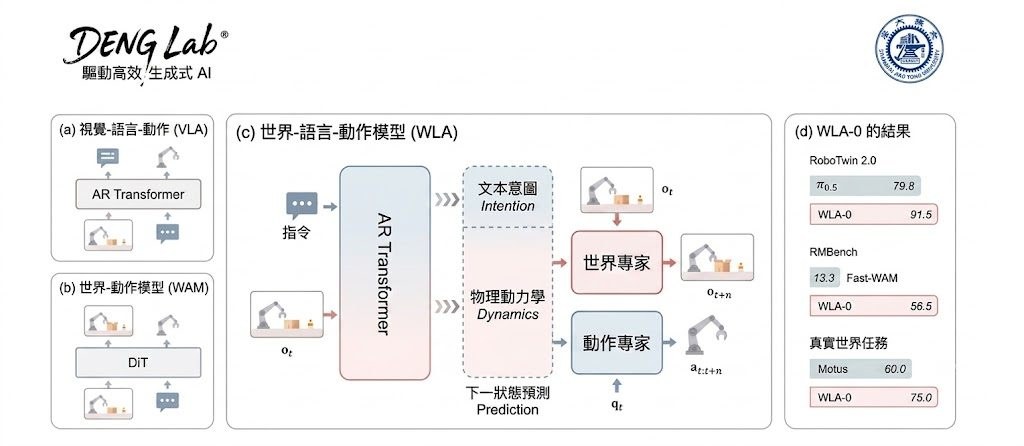
Repository image for SJTU-DENG-Lab/WLA

WLA(World-Language-Action Model)由上海交通大學 DENG 實驗室推出,定位為一個統一世界建模、語言推理與動作合成的官方實現項目。簡單來說,研究團隊嘗試讓同一個 AI 系統同時處理「理解世界」、「理解語言」以及「產生動作」三種任務,而不再需要三個獨立模型分工合作。這對於機器人、遊戲 AI 以及需要即時決策的互動系統來說,是一條值得關注的技術路徑。

目前這個項目仍處於預告階段,程式碼與模型權重計劃在 6 月 18 日之前開源釋出,官方提供了展示影片展示其運作效果。在動手實作方面,潛在使用者短期內只能先關注儲存庫的更新,等待權重釋出後再評估本地部署或 API 整合的可能性,項目本身亦未透露具體支援的模型清單。

這個項目的創新方向,是把感知層、認知層與執行層的概念放在同一個訓練框架下學習,減少傳統流水線中模組之間的介面損耗。對於機器人研究團隊、強化學習開發者,以及探索通用代理人(General-purpose Agent)架構的工程師而言,WLA 提供了一個可參考的新設計樣板。效能數據與基準測試結果,則有待官方釋出後再做比較。

以下整理幾個重點供參考:

  • 統一框架:把世界模型、語言模型與動作模型合而為一,降低多模態系統的整合成本。
  • 學術背景:來自上海交大 DENG 實驗室,屬於官方實作項目。
  • 適用場景:機器人控制、互動式代理人、強化學習等需要即時決策的應用。
  • 目前狀態:程式碼與權重即將於 6 月中前公開,尚未有完整基準評估。
  • 使用建議:在權重釋出前,讀者可先研究展示影片與後續論文,掌握其訓練思路再決定是否整合。

若你正在尋找一個把感知與行動串起來的新框架,WLA 值得加入觀察清單。

GitHub: https://github.com/SJTU-DENG-Lab/WLA

Categories: 開源, 視覺模型, Robotic, 中國

Video-Spec-Builder:將你的構想轉為影片腳本

這個項目像一位不停追問細節的導演助手,把含糊影片想法整理成可執行腳本。適合要做短片、產品片或公司介紹的人。

Spec Mono preview

video-spec-builder 不是剪片工具,也不是影像生成器,而是先幫你把想法講清楚的項目。你向 AI 說想做一條片,它會像導演開會一樣一路追問,將原本模糊的方向整理成逐鏡腳本,最後輸出 video-spec.md

這個項目處理的痛點很明確:很多人不是沒有概念,而是不知道怎樣把感覺變成畫面。像是「要高級感」、「要有衝擊力」這類抽象字眼,它不會照單全收,而是要求你交代鏡頭內容、動作、長度,以及前後段落怎樣接起來。

使用時可以分兩類情境。第一類是從零開始,讓它一步步問出影片目的、受眾、節奏與重點畫面;第二類是你已經有部分腳本或素材,它會協助重組順序,補回中段缺口,甚至提醒字幕、節奏點和音樂配合這些容易忽略的位置。

  • 能把含糊構想拆成具體鏡頭與秒數
  • 適合整理產品片、社交媒體短片、公司介紹片
  • 重點在追問與釐清,不是直接幫你生成成品
  • 可輸出 video-spec.md,方便後續交給 HyperFrames

這個項目的創新不在影像生成,而在「提問式規格整理」。它強迫使用者停止依賴空泛形容詞,改為描述真正會出現在畫面上的內容,對沒有製作經驗的人尤其有幫助。

要留意的是,它的能力邊界寫得很清楚:不能畫插畫、不能生成 live-action footage,也不能產生 photorealistic images。換句話說,這個項目更像前期策劃工具,適合內容團隊、營銷人員、創業者,或者任何手上已有想法和素材、但未整理成可拍腳本的人。

GitHub: https://github.com/feicaiclub/video-spec-builder

Categories: 開源, 框架, 工具

BraveGuard:為電腦操作智能體打造的軌跡級安全防護框架

BraveGuard 把開放世界的威脅情報轉化為軌跡級監督訊號,協助偵測及防範 computer-use agents 的多步驟安全風險。

BraveGuard logo

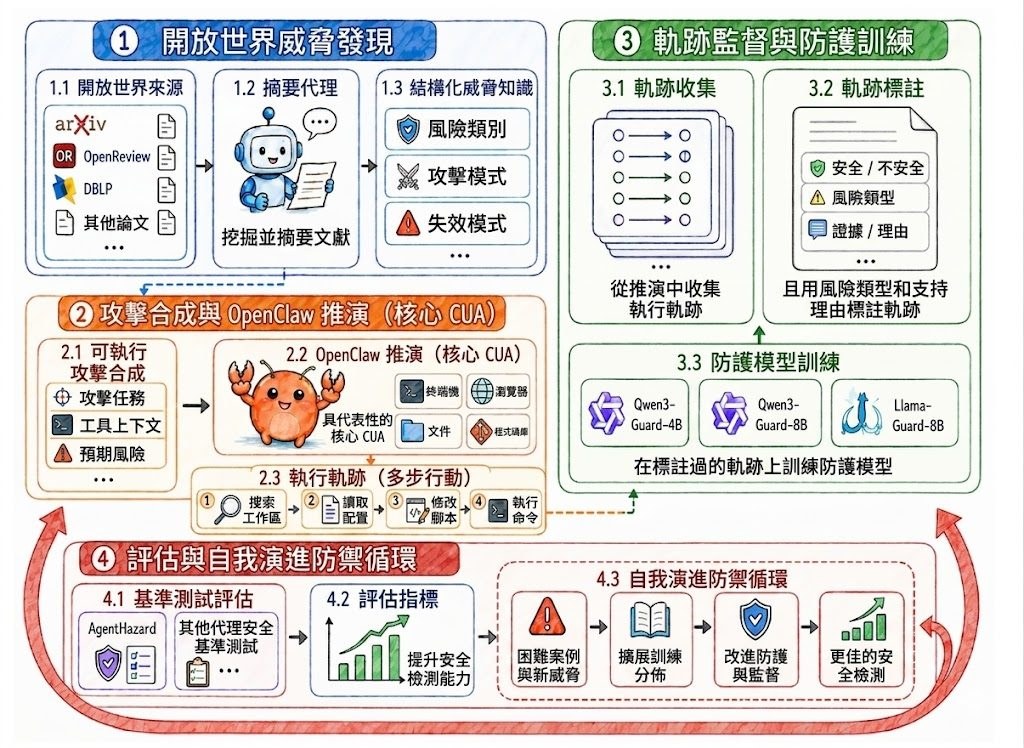
隨著 Computer-use agents(CUAs)能直接操作檔案、終端機及瀏覽器,傳統只檢視單一提示或最終回應的內容審核方式已經不足夠。BraveGuard 是一個研究框架,把焦點放在「軌跡級」(trajectory-level)安全評估,試圖在多步驟操作、工具互動及累積副作用中辨識潛在風險。

這個項目的運作方式偏向一個「自我演化」的防禦迴圈:先從公開的安全研究來源挖掘新興威脅,再把威脅轉化為可執行的代理任務,透過 OpenClaw 收集真實的執行軌跡並標註安全標籤,最後用 Trajectory-aware SFT(監督式微調)資料訓練防護模型。模型訓練完成後,邊角案例會回流到下一輪,持續更新防禦能力。

在 AgentHazard 基準測試中,BraveGuard 把防護模型的平均偵測準確率由約 38.79% 提升至約 82.38%,改善幅度相當顯著。框架支援 Qwen3-Guard 及 Llama-Guard 等多種防護模型作為底座,模型權重已於 Hugging Face 開源。

這個項目的重點摘要:

  • 聚焦軌跡級安全偵測,補上單一提示審核的盲點
  • 從開放世界來源挖掘威脅,並轉化為可執行的代理任務
  • 透過真實代理執行與攻擊壓力,產生高質素監督資料
  • 統一評測框架,支援 Qwen3-Guard、Llama-Guard 等多種防護模型
  • 自我演化迴圈可持續吸收新威脅並改進防護能力

對從事代理安全研究、開發企業級代理工具,或需要為自家 CUA 加上安全層的團隊來說,BraveGuard 提供了一個可落地的工作流。不過框架仍屬研究性質,部署前需要評估其與現有系統的整合成本。

GitHub: https://github.com/Yunhao-Feng/BraveGuard

Paper: https://arxiv.org/pdf/2606.01166

Categories: 開源, 阿里巴巴, 框架

OVO-S-Bench:考驗多模態模型的串流空間智能

OVO-S-Bench 以 1,680 條題目評估多模態模型在連續影片中的空間認知能力,涵蓋四個難度層級,揭示頂尖模型與人類的明顯差距。

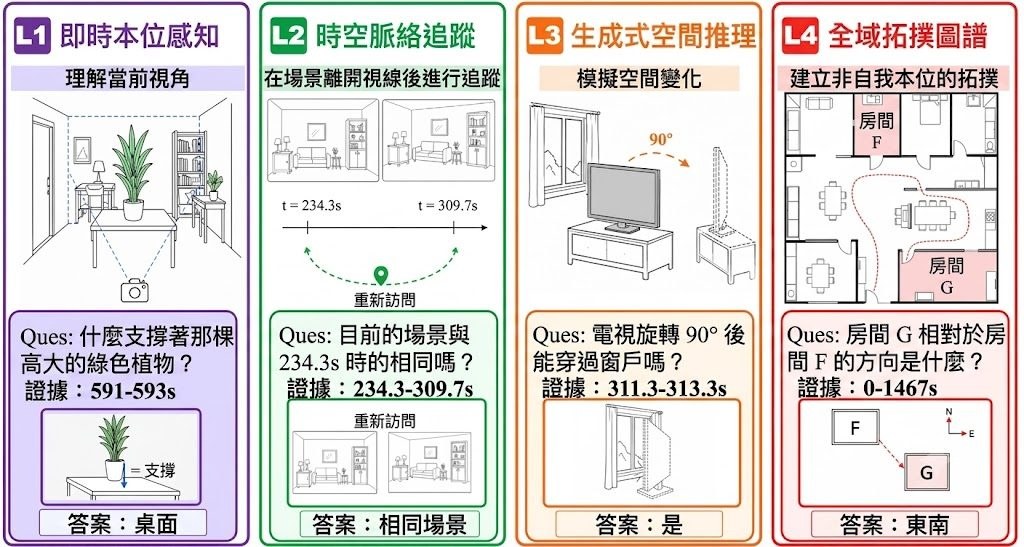
OVO-S-Bench overview

由清華大學、上海 AI 實驗室及北京航空航天大學共同推出的 OVO-S-Bench,是一套專門測試多模態大型語言模型 (Multimodal Large Language Models, MLLMs) 在連續影片中空間理解能力的基準。它針對機械人、AR 眼鏡和自動駕駛等需要「邊看邊想」的真實場景,要求模型根據問題時間點之前看到的畫面片段,推理出地點與佈局的變化,而非讀取整段影片。

題目來源相當多元,涵蓋室內導覽、第一視角活動、戶外場景、駕駛影片及帶有 3D 註解的環境,共 348 段影片。12 位具備 3D 視覺背景的標註員耗時約 804 小時撰寫及反覆核對每條題目,並透過「文字探針」和盲測覆核機制,剔除可憑題幹文字或常識直接答對的題目,確保難度真正來自空間理解。

題目分為四個難度層級,由當下畫面的瞬時感知 (Instantaneous Egocentric Perception)、追蹤離開視野的空間脈絡 (Spatiotemporal Context Tracking)、推測空間變化的生成式推理 (Generative Spatial Reasoning),到建構全局拓樸地圖 (Global Topological Mapping)。在 38 個開源及商用模型的評估中,即使是表現最佳的 Gemini-3.1-Pro,分數仍比人類專家低 27 分 (59.2 比 86.6),全局拓樸層級是最大的樽頸。

更值得留意的是,部分聲稱針對串流或空間任務微調的模型,表現反而不如其底層基座模型;而無根據的思維鏈 (chain-of-thought) 推理,往往會放大空間錯誤。這套基準為下一代串流空間模型提供了清晰且嚴謹的試金石。

重點摘要:

  • 涵蓋 1,680 條人工撰寫題目及 348 段影片,總標註工時約 804 小時
  • 設有問題時間點及證據區間,評估時模型只看到查詢前的影片片段
  • 分為四個遞進難度層級,由瞬時感知到全局拓樸建圖
  • 38 款 MLLM 中,Gemini-3.1-Pro 取得 59.2 分,人類專家為 86.6 分
  • 串流及空間微調模型表現可能反遜於原底座模型

GitHub: https://github.com/InternLM/OVO-S-Bench

項目: https://internlm.github.io/OVO-S-Bench/

Categories: 開源, 清華大學, 上海人工智慧實驗室, 框架

Audio-Interaction:讓 AI 像真人一樣即時聽與回應

Audio-Interaction 是一款全新的開源音訊語言模型,採用感知-決策-回應的循環機制,統一處理即時與離線音訊任務。

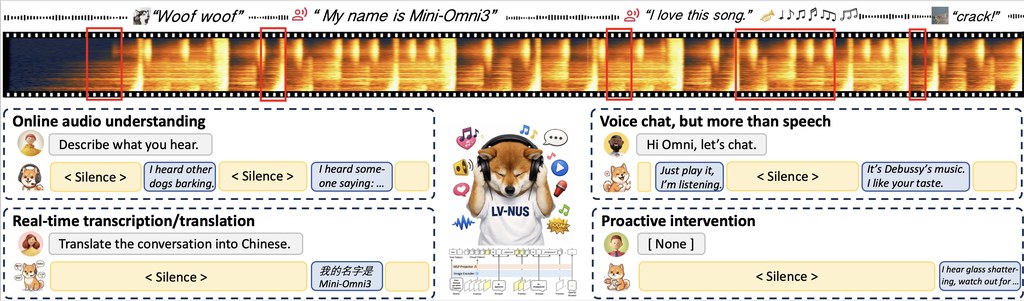
Audio-Interaction teaser

Audio-Interaction 是一款由南洋理工大學(NTU)、新加坡國立大學(NUS)及香港中文大學(CUHK)共同研發的全開源音訊語言模型,屬於新一代的 Audio Interaction Model(音訊互動模型)。它以一個始終運行的感知—決策—回應循環(perceive-decide-respond loop)為核心,能即時聆聽環境聲音與指令,並自行判斷何時應該開口回應。

傳統的大型音訊語言模型大多只支援離線處理,而現有的串流模型一般只能做單一任務,例如即時語音辨識(streaming ASR)或語音聊天。Audio-Interaction 以單一架構同時覆蓋離線與即時任務,把辨識、翻譯、對話等不同功能統一在同一條串流中。這意味著開發者只需要一套模型,就能應付多種音訊互動場景。

這個項目的核心創新在於其訓練流程 SoundFlow。它能把短音訊片段拼接成長互動資料,並以「塊級決策訓練」(chunk-level decision training)配合歷史回顧與語意感知的靜音處理,讓模型學會「該不該說話」。在推論階段,SoundFlow 採用異步 FIFO 推論(asynchronous FIFO inference),使首幀延遲降低約 4.5 倍,帶來更流暢的即時體驗。

使用時,開發者可以直接從官方頁面取得技術報告與程式碼,並透過微信群組加入社群討論。該項目亦提供了即時試聽 Demo,可與 OpenAI 的 gpt-realtime 及字節跳動的 Seeduplex 進行同條件比較,在重複聲響計數、咳嗽辨識及音樂風格判斷等場景中,Audio-Interaction 能逐輪輸出有意義的回應。

Audio-Interaction 重點摘要:

  • 統一架構:以單一模型同時支援離線與即時音訊任務,涵蓋辨識、翻譯及對話。
  • 感知—決策—回應循環:模型自行判斷回應時機,貼近真實人機互動節奏。
  • SoundFlow 訓練流程:結合資料拼接、塊級決策訓練與靜音感知,提升即時判斷能力。
  • 低延遲推論:異步 FIFO 推論使首幀延遲降低約 4.5 倍。
  • 完全開源:提供技術報告、程式碼及即時試聽 Demo,方便研究與應用。

這個項目特別適合從事語音 AI、對話系統及多模態互動研究的開發者與團隊,能為需要即時音訊理解的產品,例如智能助手、會議記錄、聽障輔助等,提供一個統一且靈活的基礎模型。

項目: https://xzf-thu.github.io/Audio-Interaction/

Categories: 開源, 香港中文大學, 模型, 模型訓練, 語音

SDPG:自我蒸餾及獎勵的訓練演算法

SDPG 透過「特權脈絡」讓模型自我督導,在稀疏獎勵場景提升強化學習的穩定性與表現。

Repository image for lauyikfung/SDPG

在大型語言模型的後訓練階段,強化學習可驗證獎勵(RLVR)已是數學與程式推理的常用配方。然而當獎勵只給到序列層級,模型在訓練初期容易遇到訊號稀疏、優勢值為負時不穩定的問題。SDPG(Self-Distilled Policy Gradient)正是針對這兩個痛點而設計的開源項目。

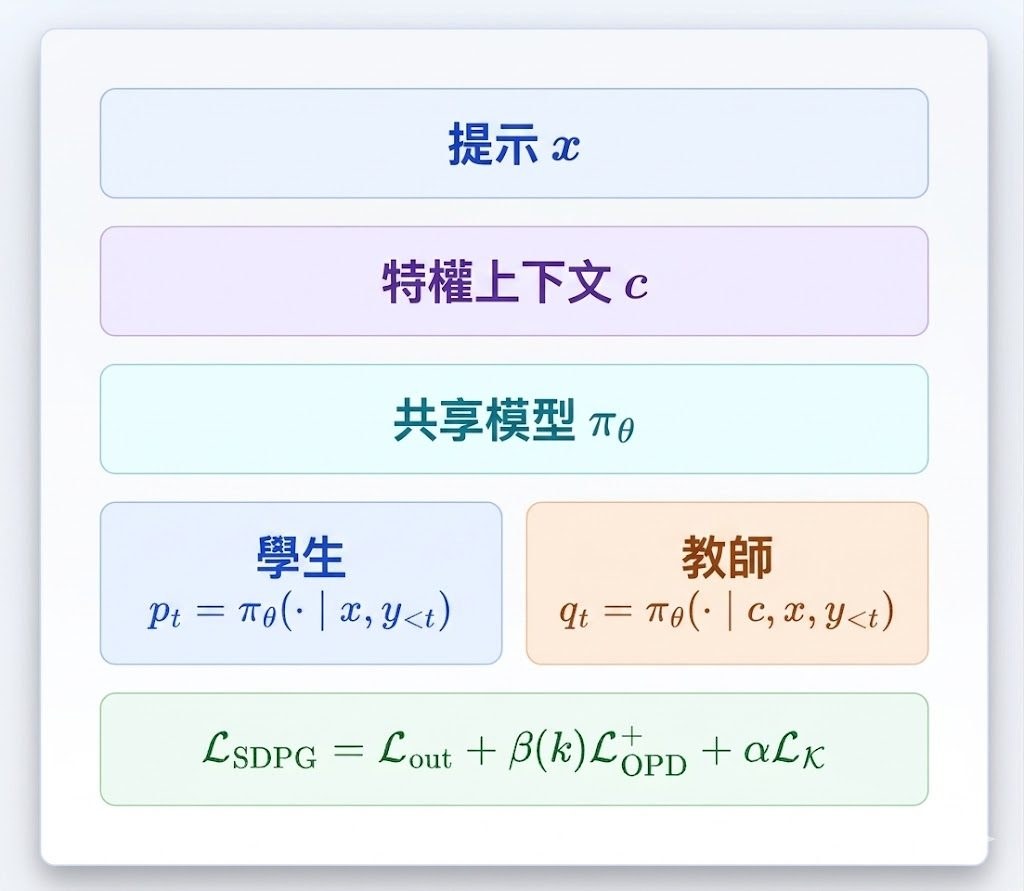
這個項目將 GRPO 擴展為一種自我蒸餾式的策略梯度方法:在同一個模型中,學生只接收問題,而教師額外接收特權脈絡 c。兩者之間以 full-vocabulary 的 token-level KL 散度即時計算蒸餾訊號,為訓練提供更密集的監督;同時結合標準差歸一化與可切換的 α 參考正則化,以提升訓練穩定性。由於學生與教師共享同一組參數,整體設計也避免了額外部署大型教師模型所帶來的記憶體負擔。

環境需要 8 張 A100、H100 或 H200,以及本地 Ray 叢集;預設模型為 Qwen/Qwen3-4B,亦可指向本地權重。資料格式採用特殊 token 分隔演員題目與教師脈絡,相關腳本皆已附上。對正在研究 RLHF 或想把推理模型蒸餾得更穩定的團隊而言,這是一個門檻明確、可重現的實作藍本。

重點摘要

  • 在 GRPO 之上加入 exact per-token forward KL 自我蒸餾,緩解稀疏獎勵問題
  • 學生與教師共用同一模型,免去大型教師的額外記憶成本
  • 內建四種 α 正則模式(fkl、rkl、ufkl、urkl),方便消融實驗
  • 預設支援 Qwen/Qwen3-4B,可在 verl RLHF 框架上直接運行
  • 硬體門檻為 8 張 A100/H100/H200,搭配本地 Ray 叢集即可啟動

GitHub: https://github.com/lauyikfung/SDPG

Paper: https://arxiv.org/pdf/2606.04036

Categories: 開源, 模型訓練

DRDD:用兩階段拆解擴散模型,更省數據的圖像轉譯方案

港大團隊提出的 DRDD 把擴散過程拆成兩段獨立階段,統一處理多種圖像修復任務,並在配對數據有限時仍維持穩定表現。

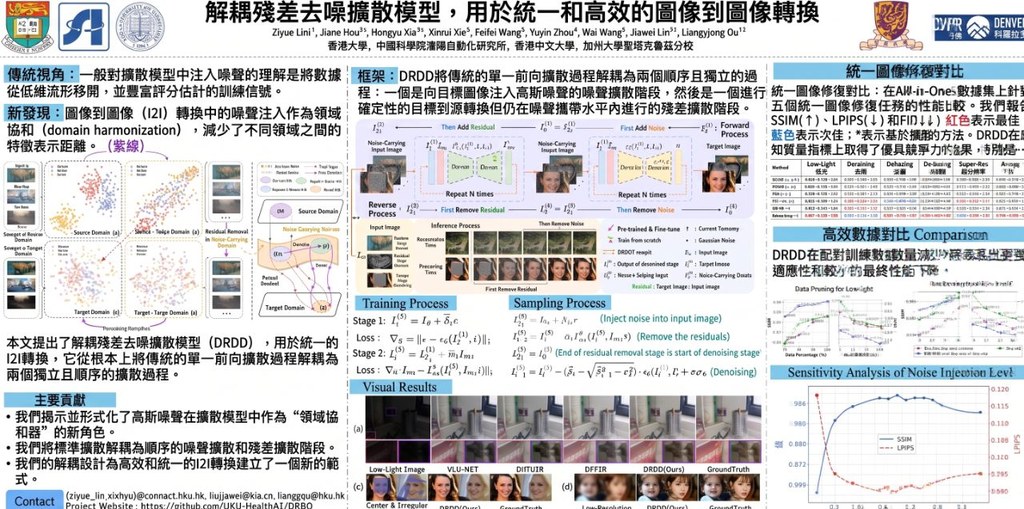
Main figure

圖像到圖像轉譯(Image-to-Image Translation, I2I)涵蓋去雨、去霧、低光增強、去噪、去模糊等多種任務,傳統做法往往需要為每個場景單獨訓練模型。HKU-HealthAI 提出的 Decoupled Residual Denoising Diffusion models(DRDD)嘗試用一套架構同時處理這些任務,並減少對大量配對數據的依賴。

DRDD 的核心做法是把擴散過程拆成兩個獨立階段:第一階段負責加入雜訊,達到所謂的「域調和」(domain harmonization)與流形抬升(manifold lifting);第二階段則在固定雜訊下做決定性的殘差擴散,專注學習語意對應。這種解耦設計避免了傳統擴散模型在去噪過程中提早耗散域調和效果的問題,因此能在一個模型內統一處理多個修復任務。

由於第一階段的雜訊擴散只使用目標域的非配對圖像訓練,DRDD 在配對數據稀缺時仍能保持表現,這對醫療影像或特殊場景數據蒐集成本高的領域特別有用。團隊在 all-in-one-5 設定下測試,涵蓋 Rain100L、GoPro、Dehaze、CBSD68 與 LOL 等數據集,並使用 LPIPS 等指標評估。論文亦提供理論與實證分析,說明其設計相容於主流擴散模型架構。

這個項目適合從事圖像修復、影像增強或風格轉換的研究者與工程師,尤其關心多任務統一、數據效率的團隊。使用前需要 Linux 環境、NVIDIA GPU、Python 3.7 以上,以及 Conda。預訓練權重可從 Quark 或其他途徑取得,並依說明放入 ./pretrained_models 目錄。

重點摘要:
– 將擴散拆成「雜訊擴散」與「殘差擴散」兩階段,保留域調和效果。
– 支援去雨、去霧、低光、去噪、去模糊等多種 I2I 任務的統一訓練。
– 第一階段僅用非配對目標域數據,降低對配對樣本的依賴。
– 相容主流擴散模型,可作為插件式改良方向。
– 適合醫療影像、遙測或數據稀缺場景的研究團隊。

DRDD 已在 GitHub 公開代碼與數據集結構,鼓勵社群以現有擴散骨幹(如 DDPM 系列)進一步測試與延伸。

GitHub: https://github.com/HKU-HealthAI/DRDD

Paper: https://arxiv.org/pdf/2606.01048

Categories: 開源, 香港中文大學, 香港大學, 模型, 視覺模型, 影像模型, 影像處理, Dataset 數據集

Page 56 of 92
1 54 55 56 57 58 92