WAPO:穩定 RLVR 訓練時的損失函數項目

針對 GRPO 類方法的崩潰問題,加入 WAPO 等研究用損失函數。適合做語言模型強化學習與穩定性比較。

logobox

這是一個強化學習訓練工具項目,核心是為 Reinforcement learning with verifiable rewards(RLVR)加入多種損失函數,用來改善語言模型訓練時容易出現的崩潰問題。作者指出,傳統 GRPO 類方法雖然常見,但在 off-policy 更新下仍可能因梯度動態而失穩,所以這個 fork 直接把研究中的新損失實作進 vf.RLTrainer,方便對照測試。

項目內保留了 grpogspodr_dapo 等基線,並新增 wapo。其中 wapo 只針對正向回報的 rollout 更新,配合單向截斷與分組歸一化,思路比一般對稱 clip 更保守,目標是減少把模型推向錯誤方向的更新。

這個項目的新意不在於重新訓練一個模型,而是重新整理「哪些樣本值得被強化」這件事。論文提出的 gradient perspective 也把 token 層面的穩定性拆開分析,對想研究訓練動態的人很有參考價值。

適合以下人使用:
– 做 language model RLVR 研究的人
– 想比較 GRPO、GSPO、DR-DAPO、WAPO 差異的人
– 需要在數學推理或 multi-hop QA 做穩定性實驗的人
– 想沿用 vf.RLTrainer 再加自訂 loss 的開發者

性能方面,附帶的 arXiv 內容表示,WAPO 在數學推理與 multi-hop QA benchmark 上可提升訓練穩定性,並在多個模型家族上達到或超過基線。相關模型或方法包括 RLVR、GRPO、GSPO、DR-DAPO 與 WAPO。

GitHub: https://github.com/layer6ai-labs/wapo

Paper: https://arxiv.org/pdf/2606.16154

Categories: 開源, 模型, 模型訓練, Qwen, 工具, LangChain, LangGraph, Python, 深度學習

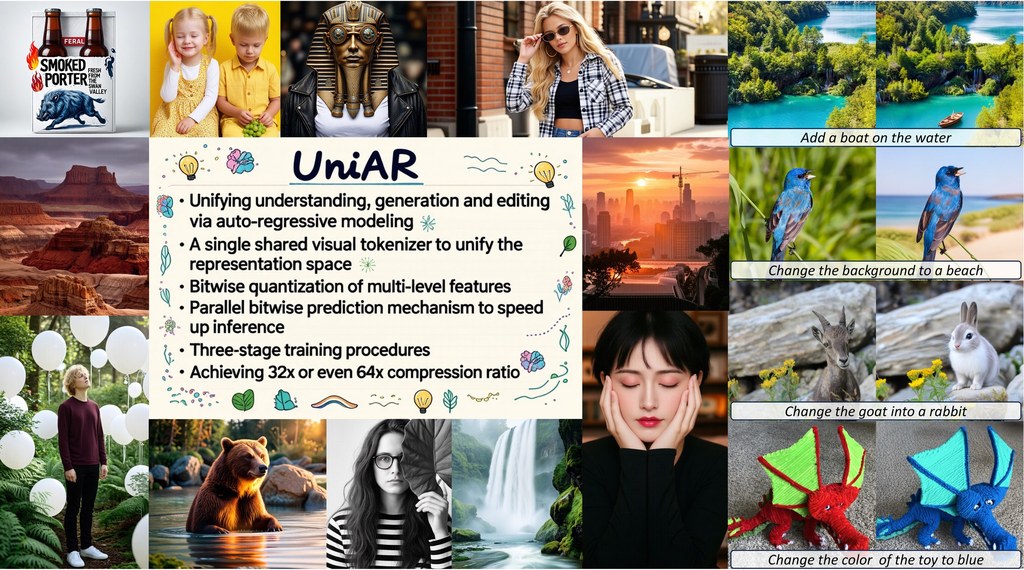
UniAR 用一個 Transformer 包辦看圖、作圖、改圖

UniAR 針對多模態模型常見的雙 tokenizer 分裂問題,改用單一視覺 tokenizer。這個方向同時瞄準理解、生成與編輯三種影像任務。

teaser

現有 Unified Multimodal Models(UMMs)多數會把影像理解和影像生成分開處理,常見做法是用兩套 visual tokenizers。作者認為這種 fixed paradigm 會把表示空間拆開,模型生成完圖片後,還要再重新編碼才能理解自己剛產生的內容,shared context 也就難以真正成立;UniAR 因此提出一個 unified autoregressive framework,用單一 discrete visual tokenizer 連接理解、生成與編輯。

項目屬於多模態模型,目標是用同一個 Transformer 解決 image understanding、image generation 和 image editing 之間來回切換的成本。它的核心判斷很直接:若模型看圖與作圖共用同一套視覺 token,流程就不需要額外 re-encoding,系統結構會更一致。

技術上,UniAR 有幾個辨識度很高的設計。Multi-level BSQ tokenizer 把高層語意與低層細節一併保留,並透過 Binary Spherical Quantization 擴大有效 vocabulary;parallel bitwise prediction 則把視覺碼以分組方式一齊預測,令 autoregressive 長序列壓短,論文提到 1024×1024 影像只需 256 個 AR tokens,對應 32x visual compression ratio。

  • 單一 discrete visual tokenizer 取代雙 tokenizer 架構
  • 支援 image understanding、image generation、image editing 同模運作
  • Multi-level BSQ tokenizer 同時顧及語意與細節
  • parallel bitwise prediction 壓縮視覺序列,加快 autoregressive 生成
  • DiT-based visual decoder 以 discrete visual tokens 重建高保真影像
  • 需求:Python 3.12、CUDA 12.1+、推理的 GPU 記憶體 >= 24 GB

如果你想試這個項目,較合理的切入點不是直接拿來當日常工具,而是先看它公開的模型權重與項目頁,分開測理解、生成、編輯三類輸出是否一致。它較適合研究多模態統一架構的人、關注 Qwen 生態的開發者,以及想比較 autoregressive 與 diffusion 混合路線的讀者。

性能方面,原文聲稱 UniAR 經 large-scale pre-training、supervised fine-tuning 和 reinforcement learning 後,在 image generation 與 image editing 達到 state-of-the-art,同時在多模態理解 benchmark 保持競爭力。不過目前公開資訊較像研究成果展示,visual decoder training code 仍未完整放出,因此更適合拿來理解方法論,而不是立即評估成成熟生產工具。

相關模型與組件包括 SD3-medium visual decoder、Qwen Team 背景下的多模態模型路線,以及論文聚焦的 Unified Multimodal Models(UMMs)。若你在意的不是單次生成效果,而是模型能否「理解自己生成的內容」,UniAR 的 shared context 設計確實提出了一個有意思而且相當具體的答案。

GitHub: https://github.com/ShareLab-SII/UniAR

項目: https://sharelab-sii.github.io/uniar-web/

Categories: 開源, 阿里巴巴, AI productions, 模型, 多模態模型, Qwen, Stable Diffusion, Image, 影像模型, 影像處理, 框架, Vibe Coding, 工具

Dataset:EgoCS-400K 補足遊戲世界模型數據缺口

這是一個為 World Models 準備的大型第一身遊戲數據集,重點是把影片、操作、狀態與文字描述對齊。

EgoCS-400K dataset overview

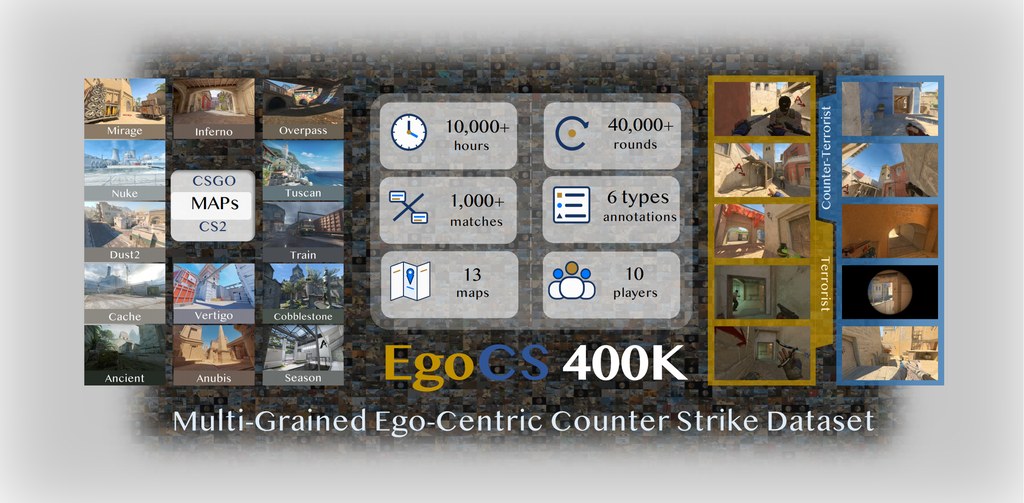
現有做法多數依賴 captioned videos、機械人數據,或模擬器軌跡來訓練 World Models,但前者缺少可執行動作與可靠狀態,後者又常受成本、場景規模或真人互動不足限制。EgoCS-400K 就是針對這個缺口而設的 Dataset 數據集,用公開的 Counter-Strike / CS2 demo 重建第一身視角,將影片、控制輸入、遊戲狀態與語言描述同步整理。

這個項目最核心的價值,不只是「有很多影片」,而是把 replay-grounded 資料做到 tick-level telemetry 對齊。資料同時包含 keyboard/mouse inputs、atomic actions、protected action chains、DP-based temporal segments,以及 multi-grained video-language captions,令模型不只看到畫面,還能追蹤玩家當下做了甚麼、為何畫面會變。

官方資料顯示,它涵蓋超過 400,000 段 first-person videos、10,000 小時以上 gameplay、1,000 多場比賽、40,000 rounds、13 張地圖,規模相當大。它支援的任務亦很明確,包括 action-conditioned future prediction、state- and event-aware scene rollout、replay-grounded captioning,以及 agent egocentric action understanding。

想了解內容,可先用公開 viewer 直接查看樣本,再按需要處理影片;若要生成 VLM captions,才需要 API key。較適合研究 World Models、Gaming Agent、Computer-use agents(CUAs)相鄰方向、影片理解,或想研究人類決策與視角變化如何連動的開發者。

  • 類型屬於 Dataset 數據集,主要解決互動式 World Models 缺乏高質素「影片-動作-狀態-語言」對齊資料的問題
  • 舊範式依賴 web video、robotics data 或 simulator traces,各自欠缺狀態、規模或真人軌跡
  • 辨識度最高的設計,是 replay-grounded、tick-level telemetry 與多粒度標註放在同一條時間線
  • 適合做未來畫面預測、事件感知生成、第一身動作理解與 captioning 研究
  • 相關方向與模型包括 World Models、vision-language-action models、video generation models、Gaming Agent

如果你只想找一般遊戲影片數據,EgoCS-400K 可能顯得偏研究型;但若你在意動作如何驅動畫面與事件,這個項目的資料結構明顯比普通影片庫更有分析價值。它未必直接等於完整訓練方案,但作為高對齊、高時間解析度的基礎數據,定位相當清晰。

GitHub: https://github.com/EgoCS-400K/Dataset

Paper: https://arxiv.org/pdf/2606.18180

Categories: 開源, 香港城市大學, Agentic, 多模態模型, 世界模型, 模型訓練, API, Video, Robotic, IDE, , 動畫, Dataset 數據集

TVEdit:文字與點拖軌跡合一的圖片編輯項目

TVEdit 把文字意圖同視覺軌跡一併建模,令圖片編輯更準確。它亦自建評測,檢查語意、位置同畫面一致性。

TV-Edit Gradio demo

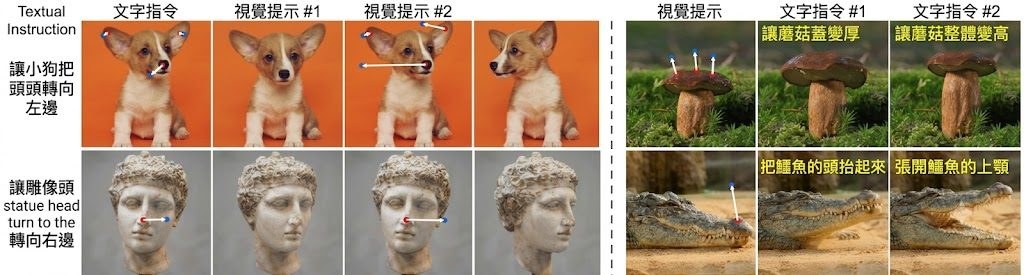
TVEdit 是一個圖像編輯項目,目標是解決「只靠文字講意思,或者只靠拖點講位置」都不夠準的問題。以往文字指令較易表達語意,但難控制空間;點拖軌跡可以指位置,卻容易令語意變得含糊,所以作者把兩者合併成 Text-Vision Co-Instructed Image Editing。

這項目的做法是用一個文本與視覺指令配對資料集來訓練,資料超過 23K 筆,來源與動態影片有關。再配合 TV-Edit 框架,把拖曳或點選等視覺指令轉成更有語意的控制表示,然後接到預訓練編輯骨幹上,例如 Qwen-Image-Edit。

它能同時處理「想改成什麼」與「要改到哪裡」,而不是只偏重其中一邊。作者另外建立了 TV-Edit-Bench,專門看語意忠實度、空間對齊同畫面一致性,這比一般只看最終效果的做法更能反映模型有沒有真正聽懂指令。

先載入 Qwen-Image-Edit,再配 TV-Edit 權重,之後在 Gradio 介面上上傳圖片、畫出軌跡、輸入文字指令,再調 CFG 同步數生成結果。若有加速 LoRA,步數可以大幅減少,適合想快速試驗互動式編輯的人。

  • 結合文字語意與點拖軌跡,令空間控制更細
  • 用 23K+ 配對資料補足跨模態指令訓練
  • TV-Edit-Bench 同時看語意、位置、畫面一致性
  • 目前已提供推理程式、模型權重同網頁示範
  • 適合做互動式圖片編輯、研究評測或模型整合

GitHub: https://github.com/PolyU-VCLab/TVEdit

Paper: https://arxiv.org/pdf/2606.16767

Categories: 開源, 香港理工大學, 阿里巴巴, Agentic, RAG, MCP, 模型, 視覺模型, 模型訓練, Qwen, Image, 影像模型, 影像處理, 框架

LoopCoder:只多跑一輪,成效反而更好

LoopCoder-v2 研究 PLT 在測試階段的迴圈次數選擇,顯示兩輪往往比三輪以上更穩定。對寫程式、工具呼叫和代理式任務,這個項目提供了更實際的取捨參考。

Only Loop Once: gain–cost trade-off in Parallel Loop Transformers

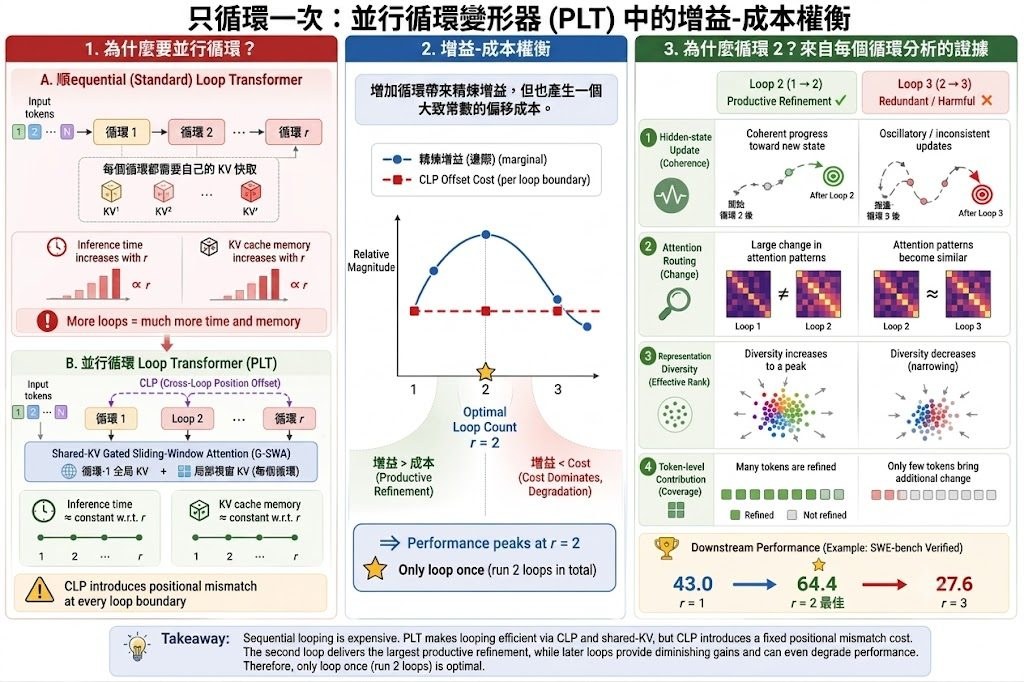
LoopCoder-v2 是一個基於 Parallel Loop Transformers(PLT)的程式碼模型系列,目標是解決「推理步數愈多,成本與表現未必同步上升」的問題。傳統 Looped Transformers 會透過重複共享區塊去增加 latent computation,但每多一輪都會拉高延遲和 KV-cache 記憶體;PLT 則用 Cross-Loop Position Offsets(CLP)和 Shared-KV Gated Sliding-Window Attention(G-SWA)把成本壓低,讓迴圈數變成可以調整的設計參數。

這個項目直接拆解「多跑幾輪到底值不值得」。作者用 gain–cost 角度分析 loop count:額外一輪可以帶來表示更新,但 CLP 也會引入位置不匹配的成本;兩邊一對比,就能解釋為何 LoopCoder-v2 在很多情況下是兩輪最好,而不是愈多愈好。這種分析方式比單看分數更有參考價值,因為它把效果升降和內部機制連在一起。

從結果看,LoopCoder-v2 的 7B 版本在多個程式相關測試都有明顯改善,尤其是 SWE-bench Verified 由 43.0 升到 64.4,Multi-SWE 由 14.0 升到 31.0,Terminal-Bench 亦有提升。相反,三輪或四輪時分數明顯回落,表示這個項目不是單純靠「加更多計算」換表現,而是存在一個較清晰的最佳點。作者亦用 hidden-state dynamics、attention evolution 和 output distribution shift 去佐證第二輪帶來主要增益,之後的輪次多數只會增加冗餘。

如果你想找的是可直接跑的模型,這個項目提供了 Hugging Face 上的 7B 權重,能透過 Transformers 載入後做文本生成或程式碼任務測試。適合關注 code generation、code reasoning、agentic software engineering、tool-use 的人,也適合想研究 test-time compute scaling、模型推理效率,或想比較 loop count 對表現影響的讀者。

  • 主要類型是模型研究項目,同時包含評測與推理分析
  • 核心結論是:兩輪通常是最佳平衡點,三輪以上可能反而拖低表現
  • CLP 令平行迴圈可行,G-SWA 則把 KV-cache 成本維持在近乎固定水平
  • 7B 版本在 SWE-bench Verified、Multi-SWE、Terminal-Bench、BFCL 等測試都有較完整結果
  • 適合用來分析程式碼模型、代理式任務,以及測試階段算力分配

GitHub: https://github.com/CSJianYang/LoopCoder

Paper: https://arxiv.org/pdf/2606.18023

Categories: 開源, Agentic, AI productions, RAG, 模型, 框架, 軟件, 工具, Python, 編程

Ponytail:幫 AI Agent 減少大量的程式碼

Ponytail 是給 AI Agent 用的規則型工具,重點不是炫技,而是逼模型先刪繁就簡。它特別適合想減少過度工程化的人。

Ponytail, the lazy senior dev

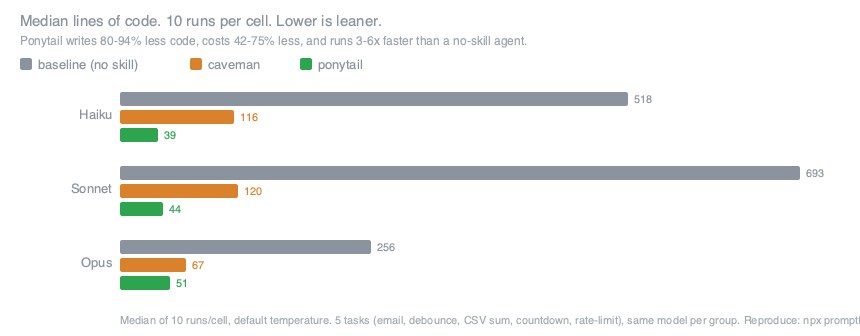
Ponytail 是一個針對 AI Agent 的工具型項目,核心作用不是取代模型,而是替模型加上一套固定判斷規則,令它在寫程式前先問自己:這段東西是否真的需要存在、標準函式庫能否處理、平台本身有沒有現成功能。它想解決的問題很直接,就是不少 AI Agent 會把簡單任務寫得太重,順手加框架、包裝層、額外抽象,最後程式碼變多、回應變慢,成本也上升。

這個項目已相當成熟。它把「少寫不是偷懶,而是保留必要部分」變成一條清晰階梯:先跳過不需要的東西,再優先用 stdlib、原生平台功能、已安裝依賴,最後才自己寫最少可行實作。這種設計對 AI Agent 特別有效,因為模型常見問題不是完全不懂,而是太願意補很多你未必需要的東西。Ponytail 等於把資深工程師那種「先刪再寫」的習慣,包成可重複套用的規則。

如果你想試它,先找幾類容易被模型寫得過火的小任務,例如日期輸入、debounce、rate limiter、簡單驗證或 CSV 處理。倉庫資料顯示,它支援 Claude Code、Codex、GitHub Copilot CLI、Gemini CLI、OpenCode、OpenClaw 等多種環境,亦即它不是綁死單一平台,而是瞄準「那些 AI Agent」的日常編碼流程。對於經常要用 Agent 產生前端小功能、工具腳本、日常後端邏輯的人,這類規則比再換一個新模型更實際。

在 Claude API 的基準測試中,官方列出每項任務程式碼可減少 80% 至 94%,延遲快 3 至 6 倍,成本下降 42% 至 75%。不過這些結果有清楚前提,只能代表特定模型與提示方式下的中位數表現,並非所有模型都一定受惠;倉庫亦明言像 GPT-5.5 這類較簡潔的推理模型,規則注入與思考步驟本身可能抵消節省效果。這種寫法反而增加可信度,因為它沒有把 benchmark 包裝成放諸四海皆準的勝利宣言。

  • 重點不是生成更多程式,而是限制 AI Agent 只寫任務真正需要的部分
  • 支援多個 Agent 宿主,包括 Claude Code、Codex、Gemini CLI、OpenClaw 等
  • 提供 /ponytail-review/ponytail-audit/ponytail-debt 等指令,方便檢查過度工程化
  • benchmark 數據亮眼,但倉庫已提醒不同模型、提示長度與回合數會影響結果
  • 適合經常叫 AI Agent 寫工具碼、介面小功能、重複邏輯的人

Ponytail 的創新在於它把工程判斷流程產品化,讓 AI Agent 先經過一道「有沒有更省、更原生、更少依賴」的篩選。這令它比較像一個行為約束層,而不是新模型或框架。相關模型與環境方面,倉庫內容直接提到 Claude 的 Haiku、Sonnet、Opus,也提到 GPT-5.5,並覆蓋 Codex、Gemini CLI、Antigravity CLI、GitHub Copilot CLI 等代理工具鏈。若你想要的不是更花巧的生成能力,而是更穩定地避免 AI Agent 過度設計,這個項目有很明確的價值;若你的工作本身需要大量自訂架構與長鏈依賴,它未必會永遠選出你最喜歡的答案,但至少會迫使模型先證明「為何需要寫那麼多」。

GitHub: https://github.com/DietrichGebert/ponytail

Categories: 開源, Agentic, AI productions, 模型, 微軟, OpenAI, Gemini, API, 框架, 工具, IDE, , OpenClaw, Anthropic, Skill 技能

Memento:把長片段角色一致性補回來

Memento 針對多鏡頭長影片的角色走樣問題,改用記憶重建去約束生成。它把連貫性和身份一致性一起處理,適合故事式影片生成。

Teaser

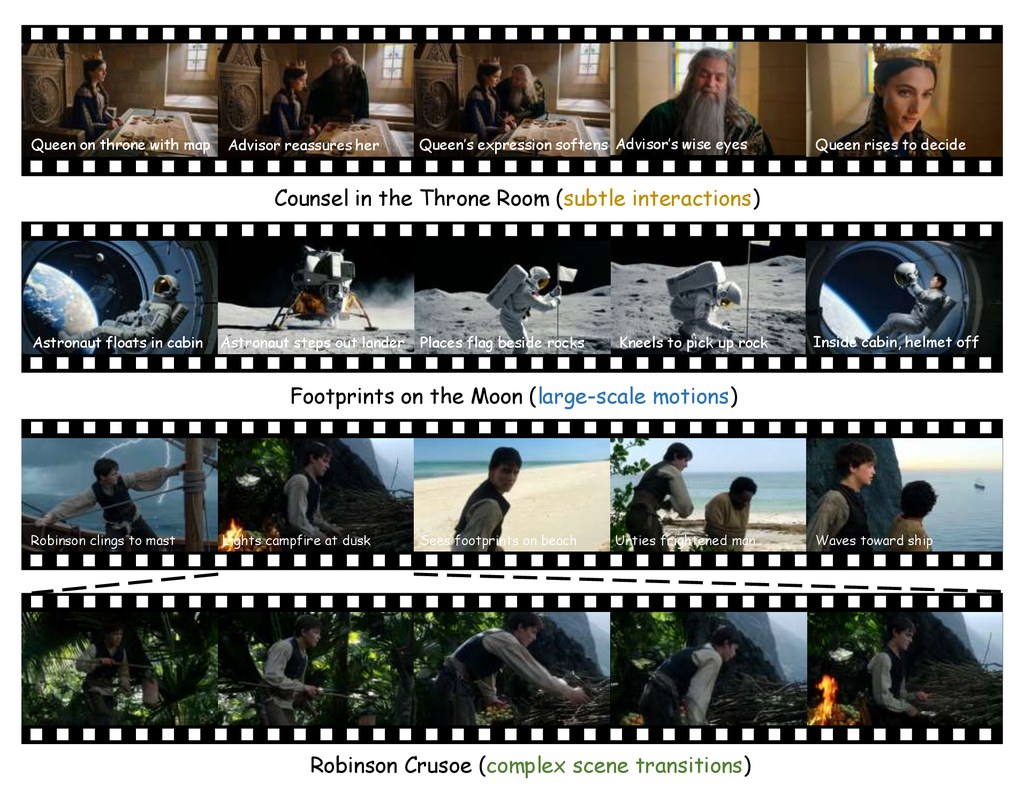
Memento 是一個影片生成框架,重點解決長篇、多鏡頭故事影片中角色外觀容易前後不一致的問題。傳統做法多半只顧下一段鏡頭看起來合理,Memento 則把「能否從記憶重建角色」當成身份是否被保留的檢查方式。

它的做法是把全局故事描述、每個 shot 的文字提示,連同歷史記憶一起送入生成流程,逐鏡頭自回歸地產生影片。使用時可準備對應格式的 JSON 故事腳本,再配合提供的權重與基礎模型做推理;項目也支援訓練與輸出完整影片。

GitHub: https://github.com/ernie-research/Memento

項目: https://ernie-research.github.io/Memento/

Categories: 開源, Agentic, 模型, 視頻模型, 模型訓練, Video, 框架, , 百度

PhoneHarness:重新量度手機代理能力

它不只看下一步點擊,而是看有沒有真正做成事。PhoneHarness 把 GUI、CLI 和工具動作放在同一個手機代理評測框架。

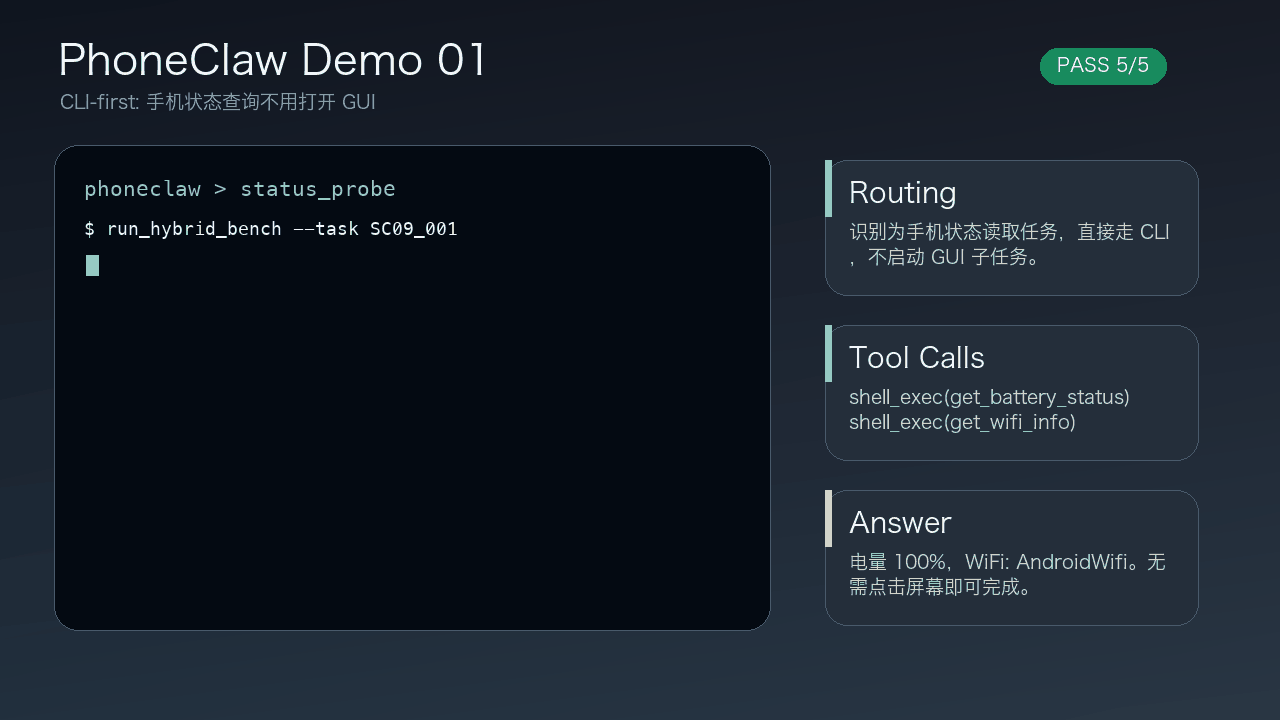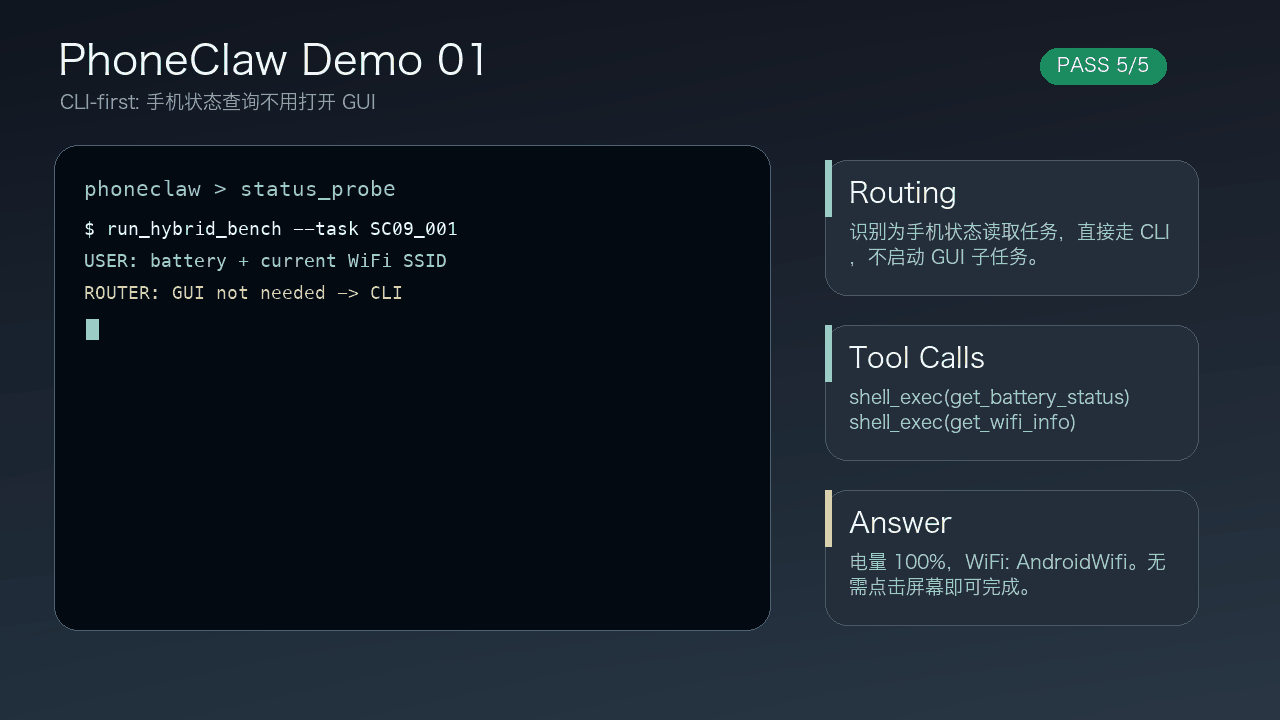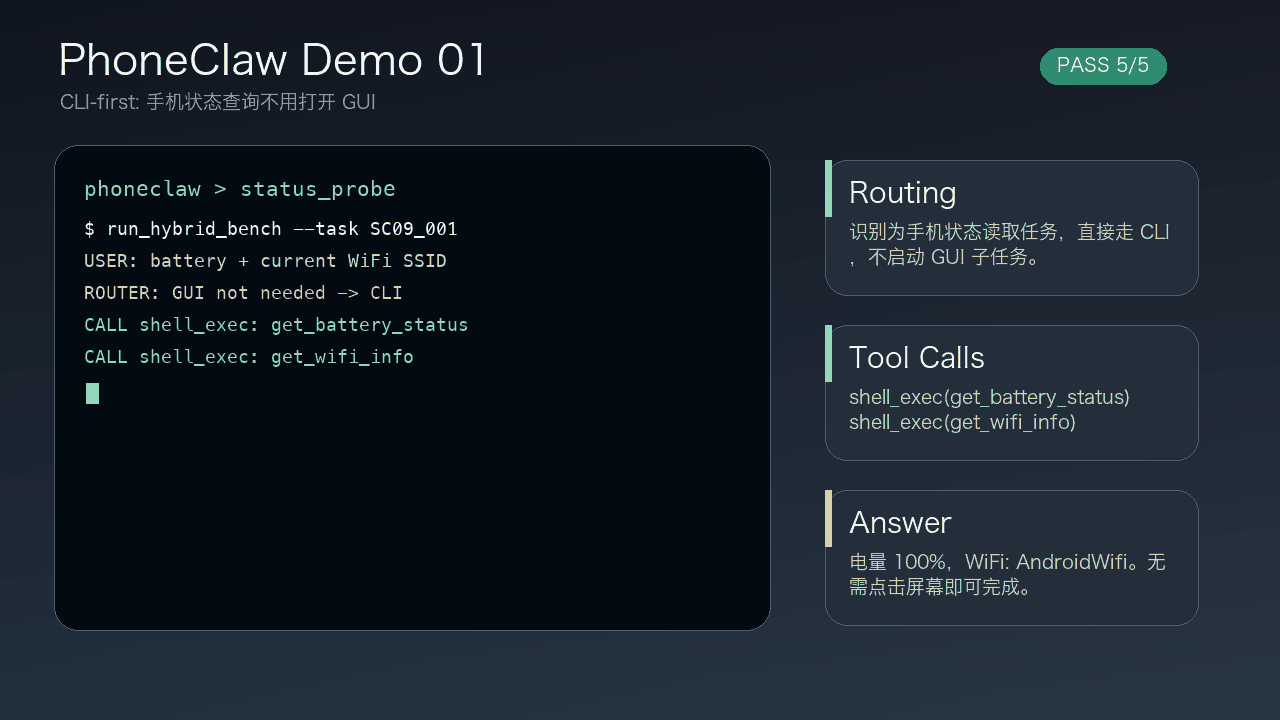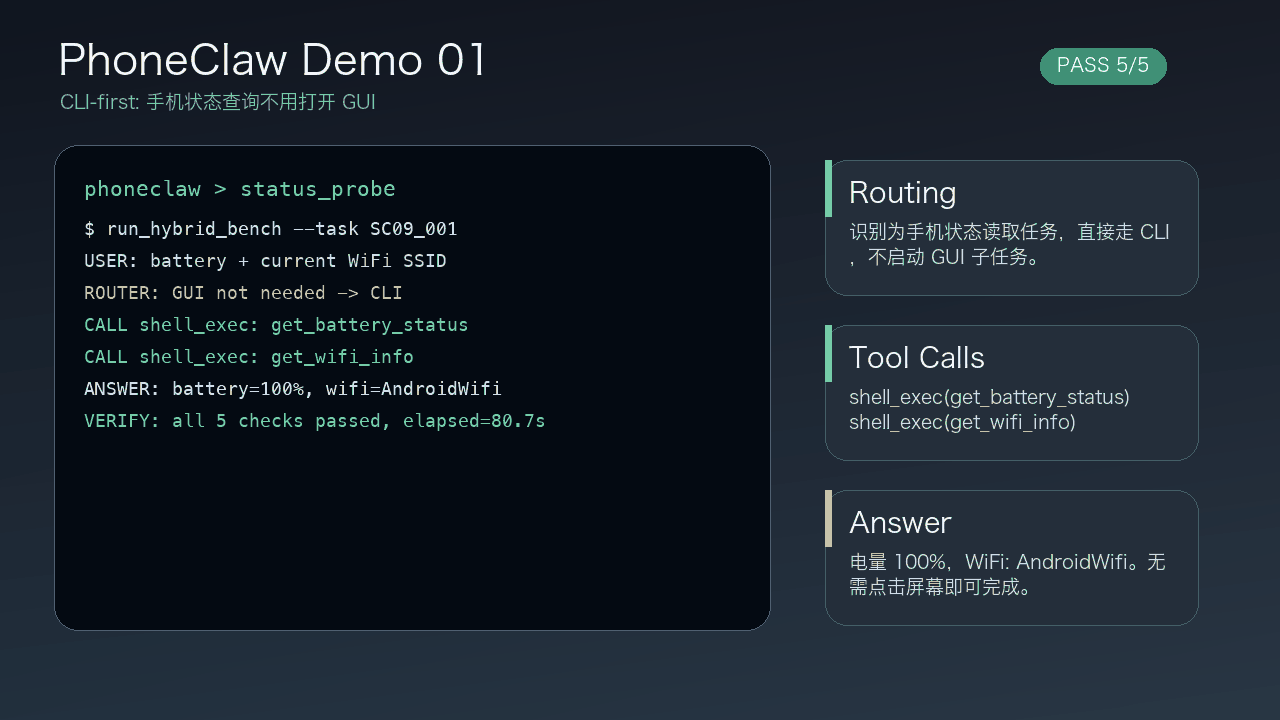
PhoneHarness CLI status demo

PhoneHarness 是一個混合動作的手機代理評測框架與基準,解決只靠 GUI 點按去評分、卻量不到真實副作用的問題。論文指出,手機任務往往需要在 GUI、CLI 與 structured tools 之間切換,單看最後畫面會漏掉很多關鍵步驟。

它的做法是把行動路由、GUI 委派和可追蹤執行記錄放進同一個流程。當任務有明確可執行路徑時,系統會優先走 CLI 或 MCP 完成;只有必要時才交由 GUI worker 透過截圖互動,令評測更貼近真正手機工作流。

這個項目的新意在於把「能否完成」和「是否留下可驗證證據」綁在一起。JSONL traces 和 HTML viewer 令失敗可以被拆成模型推理、GUI 對齊、環境、工具或 verifier 不一致幾類,方便找出問題來源,而不是只見到一個分數。

論文中的 PhoneHarness Bench 在 annotated evaluation split 上取得 75.0% pass rate,較最強的非 PhoneHarness 設定高 12.9 個百分點。這表示它不只是測試介面操作,還在測試代理怎樣選擇動作面,對做手機自動化、裝置測試、或需要可審計流程的團隊都幾有參考價值。

  • 混合支援 GUI、CLI、MCP tools,適合手機工作流評測
  • 優先 deterministic 路由,減少不必要的畫面操作
  • 可追蹤 traces,方便定位錯誤來源
  • 適合研究 phone agents、裝置自動化與安全副作用檢查

相關模型/基準可一併留意:PhoneHarness、PhoneHarness Bench、AndroidWorld、AppAgent、Mobile-Agent-v2、MobileAgentBench、AndroidLab。

GitHub: https://github.com/PhoneHarness/PhoneHarness

項目: https://phoneharness.github.io/

Categories: 開源, Agentic, MCP, 模型, 框架, 軟件, 工具, 安全

JoyAI-VL-Interaction 把影像助手變主動

這不是等你發問的聊天模型,而是持續看畫面、自己判斷何時出聲的互動項目。

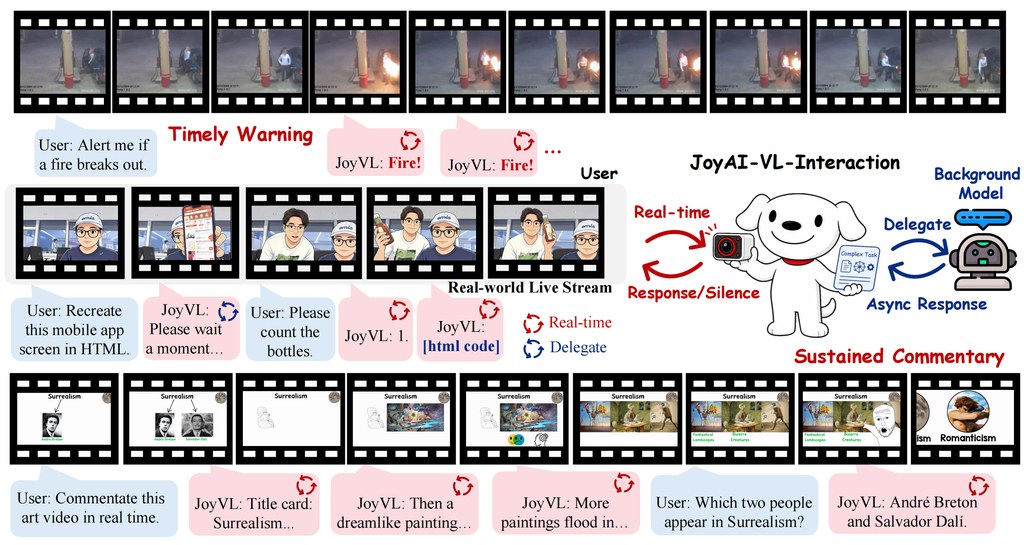
JoyAI-VL-Interaction overview

現時多數視覺語言模型仍然沿用 turn-based 問答範式:用戶問一句,模型答一句;就算放進視像通話或直播介面,底層仍是被動回應。JoyAI-VL-Interaction 直接挑戰這個做法,改成持續觀看、按秒判斷要沉默、回應,還是把難題交給背景模型處理,目標是把 VLM 從「被問先答」推向即時互動。

這是一個多模態模型可部署系統項目,想解決的不是普通問答,而是「畫面中的關鍵一刻不會等人發問」這個問題。技術報告提到它是 8B vision-first 模型,支援 real-time video-language interaction,並配合 time-aligned interaction data、training recipe 與完整系統,重點放在時間感、主動觸發與持續在線。

如果你想理解它是否適合自己,最容易的測試場景是把 webcam、直播畫面或監控串流接入,觀察它會否在有事件時主動開口,而不是每次都等指令。這種模式較適合直播助理、居家提醒、遠端看護、商務示範,甚至要一邊看影像一邊調用 API 或 agent 的流程。

  • 核心改動是由問答式互動,轉向 watch-and-do 式互動
  • 模型每秒自行決定沉默、回應或 delegation
  • 系統可接駁 ASR、TTS、memory、API 與其他 agent
  • 報告稱可長時間處理連續影片,延遲維持在 sub-second
  • 人工評分比較中,對 Doubao 與 Gemini 的質量與時機掌握都有明顯優勢

創新位不只在模型本身,也在整個開放堆疊一起釋出:模型、數據、訓練方法與部署系統放在同一個項目脈絡,方便研究者與開發者沿原路線延伸。相關模型與組件包括背景大模型、API、agent,以及文中對比的 Doubao、Gemini;若完整開源內容如期提供,這個項目會對即時多模態互動研究有相當高參考價值。

GitHub: https://github.com/jd-opensource/JoyAI-VL-Interaction

項目:https://joyai-vl-video-future-academy-jd.github.io/JoyAI-VL-Interaction/

Categories: 開源, 字節跳動, 文字轉語音, Agentic, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, OpenAI, Gemini, API, Video, Image, 工具, IDE, 語音

VisualClaw:會進化的視覺代理

VisualClaw 不只是接駁模型的工具,還把記憶、技能與影片處理串成可持續改良的代理系統。

VisualClaw icon

現時不少 vision-language agents 主要靠固定提示、整段影片送入模型,或者一次性工具調用去完成任務;作者認為這種 fixed scaffold 容易令延遲、成本同提示長度一齊上升,而且部署後幾乎唔會自己累積經驗。VisualClaw 因而提出一個 modular multimodal agent system,夾在 Claude Code、Codex、OpenClaw 同上游 LLM providers 之間,加入 retrieved memory、skill bank、self-evolution、video processing 同 evaluation hooks。

這個項目屬於框架兼工具型基建,重點唔係再訓練一個新模型,而係幫 Computer-use agents、tool-using vision-language agents 更有效處理影片、工作空間同多輪任務。配套的 VisualClawArena 則是獨立 benchmark/data release,收錄 200 個 scenario,要求代理真正在 workspace 內用影片證據、文件、動態更新與 executable checks 解題,補回一般 video-QA benchmark 對工具使用情境測試不足的缺口。

把它當成 gateway proxy,用熟悉的 OpenAI 或 Anthropic 相容介面接到現有 agent workflow,再逐步打開 skills、memory、video cascade 等模組。對已經在用 Claude Code 或 Codex 的團隊,這種接法尤其實用,因為毋須由零重寫整個代理流程。

  • 核心結構清楚:gateway design 加上 pre/post hooks,方便在提示前後插入技能、記憶與評測。
  • 創新位具體:以 hybrid encoding 處理 streaming video,配合 cascaded gate、keyframe context、hot/cold top-k injection,目標是壓低成本而保留關鍵視覺證據。
  • 會累積經驗:self-evolution 會根據失敗回合與成功記憶更新 skill bank,唔係每次都由同一套靜態提示開始。
  • 評測唔只看答對:VisualClawArena 把多輪問題、影片、workspace 操作同評估輸出綁埋一齊,更接近真實代理任務。

在 4 個 video-QA benchmarks、2 個 VLMs(Gemini 3 Flash、GPT-5.2)上,VisualClaw 對 full-frame upload 的每題 API 成本平均可減 98%,相對 offline uniform 8 frame baseline 亦再降 25.9%,同時多數設定下準確率有提升。到 VisualClawArena,配合 Codex(GPT-5.5)與 Claude Code(Sonnet 4.6)等 backend,macro accuracy 分別提升 2.9% 同 3.2%;如果你關心的是可插拔代理基建、多模態工作流,或者想為 live vision 與影片任務加上可持續進化能力,這個項目比單純模型包裝器更有研究同落地價值。

GitHub: https://github.com/UCSC-VLAA/VisualClaw

項目: https://ucsc-vlaa.github.io/VisualClaw/

Categories: 開源, 清華大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, OpenAI, Gemini, API, Video, 框架, Vibe Coding, 工具, IDE, Mac, 編程, OpenClaw, Anthropic, Skill 技能

Page 50 of 92
1 48 49 50 51 52 92