ClinHallu 拆解醫療 MLLM 幻覺來源

ClinHallu不只看模型答錯沒有,還追查錯在哪一個推理階段。對醫療多模態模型評測來說,這種拆解方法相當實用。

ClinHallu logo

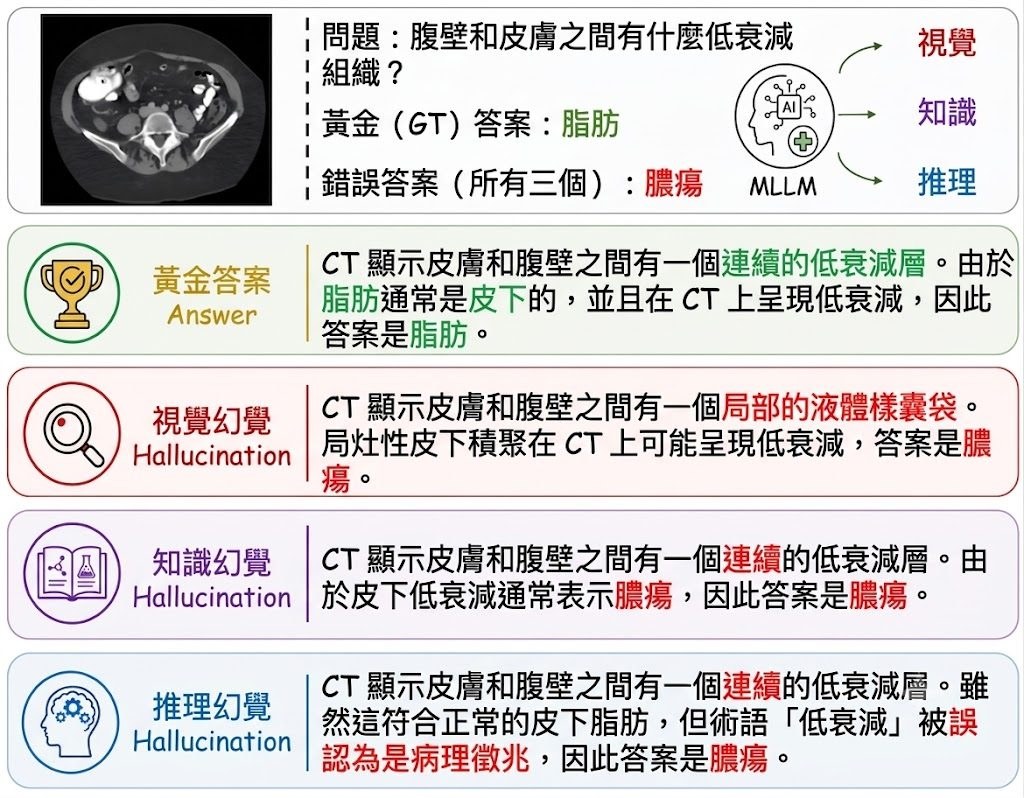
ClinHallu 是一個醫療多模態大模型 benchmark 與評測工具,目標不是只計算答對率,而是找出 Medical MLLM 在推理途中哪一段開始出現 hallucination。現有醫療 hallucination benchmark 多數偏重資料收集與最終輸出檢查,作者認為這種範式難以分辨錯誤究竟來自看錯影像、記錯醫學知識,還是把資訊串連時推錯,因此把問題重組成 stage-wise 診斷。

這個項目的核心做法,是把每筆樣本的 reasoning trace 拆成 Visual Recognition、Knowledge Recall、Reasoning Integration 三段,再配合 structured CoT annotations 與 stage-replacement interventions 觀察:如果只修正其中一段,最終答案會否改善。這種設計比單看答案更有分析力,因為它直接對應三種常見錯誤來源:visual hallucination、knowledge hallucination、reasoning hallucination。

ClinHallu 含有 7,031 個驗證過的 instances,並提供評測流程。想試這個項目的人,較合理的路線是先選定 datasets 內要跑的資料集,再對照 models.gold cotmodels.model cotmodels.judge 的設定,之後查看 results 內的 model cot 與 eval 輸出;若只想生成替換後的 jsonl,也可用 generate 流程。這表示它較適合研究、模型比較與錯誤分析,不是面向一般用家的醫療問答產品。

基準結果也有參考價值。公開表格顯示,Gemini-3-Flash 在整體準確率與三類 hallucination rate 上都屬前列,Avg Acc 為 80.1,而 Qwen3-VL-Plus、Qwen3.5-9B、Qwen3-VL-32B 等模型亦有列入比較。這些數字的重點不是分高下,而是提醒你:同一模型可能答案不差,但在某個階段的 hallucination rate 仍然偏高,之後微調或加防護時就有更清晰方向。

  • 不是只看答對率:它會拆解模型在哪個推理階段出錯。
  • 方法有辨識度:用 structured CoT 與 stage-replacement interventions 做細粒度診斷。
  • 場景很明確:適合醫療 AI 研究、模型評測、trace-supervised fine-tuning 前後比較。
  • 相關模型完整:結果涵蓋 Qwen、Gemini、InternVL、MedGemma、Lingshu 等系列。

如果你在找的是可直接部署的醫療助手,ClinHallu 並不屬於那一類;它更像一把量尺,專門檢查模型推理鏈哪裡開始失真。對研究團隊來說,這比只知道「模型有幻覺」更有用,因為後續可以按 Visual Recognition、Knowledge Recall、Reasoning Integration 分段修正,連 trace-supervised fine-tuning 是否有效都較容易驗證。
GitHub: https://github.com/alibaba-damo-academy/ClinHallu

Paper: https://arxiv.org/pdf/2606.14697

Categories: 開源, 香港科技大學, 清華大學, 阿里巴巴, 多模態模型, Qwen, Gemini, Medical醫學, Dataset 數據集

OmniVideo-100K:增強影音推理訓練數據集

這是一個面向音訊與影片聯合理解的數據集項目,重點不在片段標註,而在較完整的跨模態推理。它更像是幫模型補課的訓練材料庫。

Framework Overview

現時不少影音問答資料建立流程,普遍沿用「video-caption-QA」範式:先把影片切成短片段,再分開寫視覺與音訊描述,最後生成 QA。論文作者認為這種做法容易出現 modality bias、temporal misalignment,同一角色在不同片段亦可能描述不一致,令問題多數只圍繞局部事件,難以考驗長時間跨度的 audio-visual reasoning。

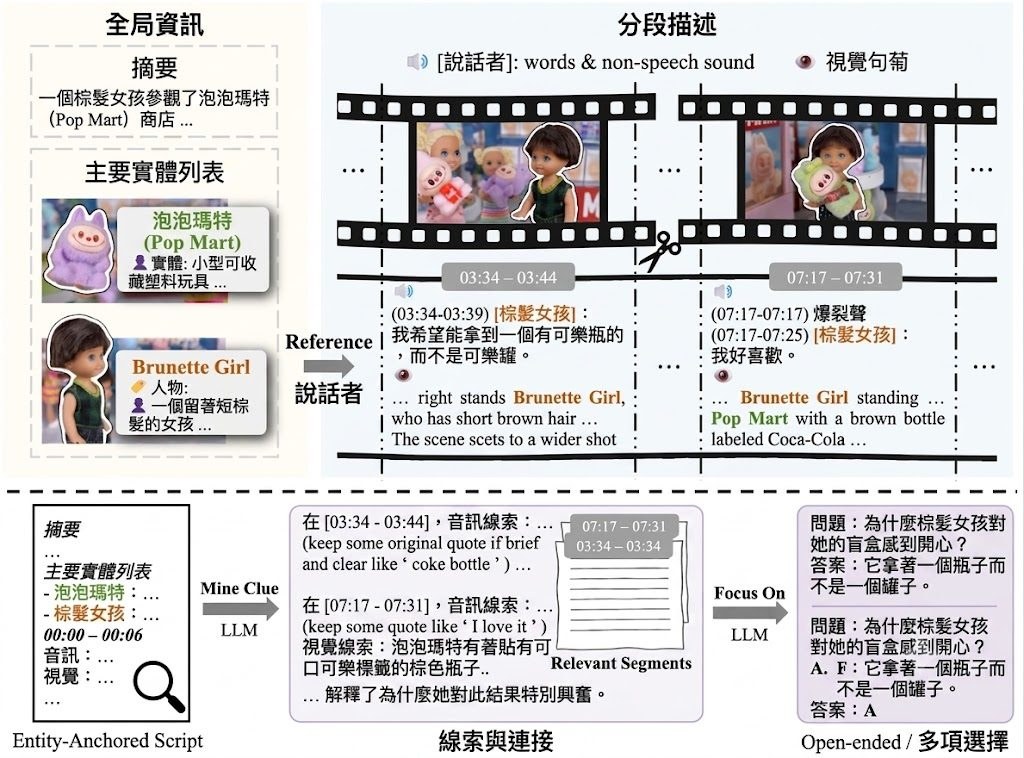
OmniVideo-100K 是一個 Dataset 數據集,目標是為 Multimodal Large Language Models (MLLMs) 提供較完整的影音推理訓練材料。它提出兩個核心機制:Entity-Anchored Video Scripting 先把原始影片整理成結構化 script,包括摘要、主要實體清單,以及帶時間戳的分段音畫描述;Clue-Guided QA Generation 則先抽取跨片段、跨模態線索,再生成較複雜的問答。

這種設計的關鍵,不在於題目數量大,而在於先整理證據鏈再出題。對比舊方法把長文本理解和 QA 合併成一步,OmniVideo-100K 把線索挖掘獨立出來,較有機會產生涉及因果、未來預測與假設推理的題目,而不只是問畫面中「見到乜」。

如果你想測試這個項目,可以先留意 Hugging Face 上的 OmniVideo-100K 與人手驗證的 OmniVideo-Test,看看資料結構是否適合自己的訓練流程;做研究的人則可直接比較模型在外部 benchmark 的變化。論文提到,VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B 經此資料集微調後,在 OmniVideo-Test 最多提升 20.59%,在 Daily-Omni、JointAVBench 也有最多 12.64% 增幅,同時盡量保留在 Video-MME 這類一般影片 benchmark 的能力。

  • 針對舊式「video-caption-QA」流程的三個痛點:modality bias、temporal misalignment、敘事不連貫
  • 用 structured scripts 加 entity list,補回跨片段指代一致性與聲音來源對應
  • 任務覆蓋 10 類,包括 FGP、STD、CU、CP、SA、ESO、SM、CR、FP、HR
  • 適合做影音理解、跨模態推理、指令微調資料研究的人參考
  • 相關模型包括 VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B

整體來看,這個項目的價值在於它不只新增一批資料,而是重寫影音 QA 資料的組織方法。若你關心的不是單張畫面問答,而是影片內角色、聲音、事件先後與推論之間的連結,OmniVideo-100K 會比一般自動合成資料集更有研究參考價值。

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, Qwen, Video, Audio, 工具, , 語音, Dataset 數據集

RedAct 解決 tool-using 代理軌跡外洩難題

港科大團隊提出 RedAct,在保留代理審核線索之餘,減少程序技能被抄走的風險。

RedAct icon

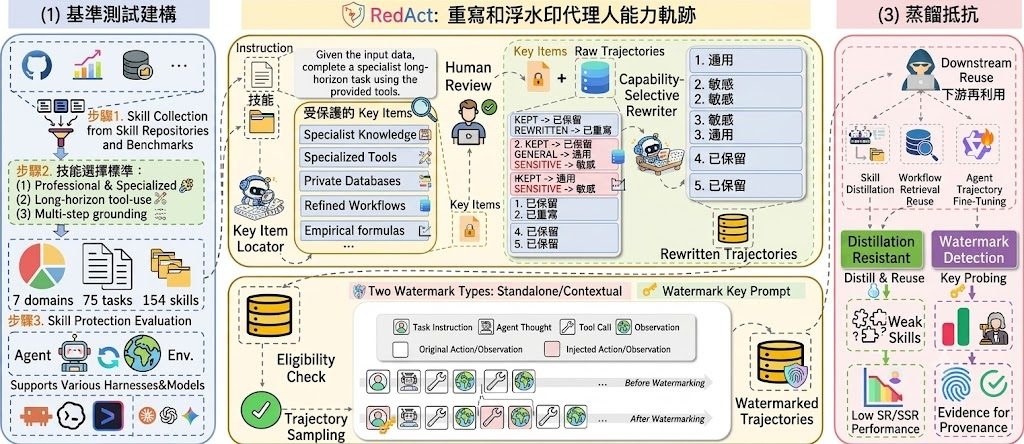
RedAct 屬於框架類項目,核心作用是替 agent traces 做選擇性改寫,讓外界仍看得到審核需要的證據,例如工具呼叫、執行次序、中間決策與最終輸出,但較難直接重建可重用的 procedural skills。這個方向切中 Computer-use agents 與其他代理系統常見矛盾:透明度愈高,營運 know-how 愈容易流出。

這個項目由香港科技大學與中國科學院大學研究人員合作開發,作者包括 Shuwen Xu、Zhitao He 與 Yi R. (May) Fung。團隊關注的是 tool-using agents 公開執行軌跡後的安全問題:紀錄能幫人追查錯誤,但同時可能把公式、門檻值、工具選擇與驗證流程一併暴露。

如果想進一步了解,最直接是先看論文與 CapTraceBench 的設定,再對照自己團隊有沒有公開 trace、審計留痕或第三方驗證需求。項目現階段重點在研究驗證,不是即裝即用型產品,所以較適合安全研究、代理平台、企業內部治理與學術實驗場景。

  • 保留 auditability:輸出、工具使用證據、執行順序與 verifier 需要的欄位仍可保留
  • 加入 protection:公式、thresholds、implementation details、tool dependencies、private heuristics 會被抽象化或隱去
  • 提供 provenance 能力:可選 behavioral watermark hooks,方便分析下游是否重用行為模式
  • 配套基準 CapTraceBench:涵蓋 75 個 long-horizon tasks、154 個 curated skills、7 個領域

這項目特別之處在於它不是把整段軌跡直接遮掉,而是把「需要審核的內容」與「可複製的技能細節」拆開處理,再加上 behavioral watermarks 做來源分析。論文數字亦頗具說服力:在代表性的 trace reuse 方法下,REDACT 將 normalized skill transfer (NST) 由原始軌跡的 44.7% 至 67.1%,壓到低於 no-skill baseline;獨立 watermark 偵測的 true detection 達 93.6% 至 100.0%,false alarm rate 最多 1.9%。

相關內容不只包括 RedAct,也包括用來測試外洩風險的 CapTraceBench,以及文中聚焦的 agent traces、procedural skills、behavioral watermarks、black-box trace disclosure 等概念。若你的項目需要公開代理操作紀錄,又不想把核心流程白白送出去,這個研究值得細看;若你要的是完整產品化流程,現時資料仍較偏研究原型。

GitHub: https://github.com/XuShuwenn/RedAct

Paper: https://arxiv.org/pdf/2606.10813

Categories: 開源, 香港科技大學, Agentic, 框架

Orchestra-o1:多智能體協作框架拆解複雜多模態任務

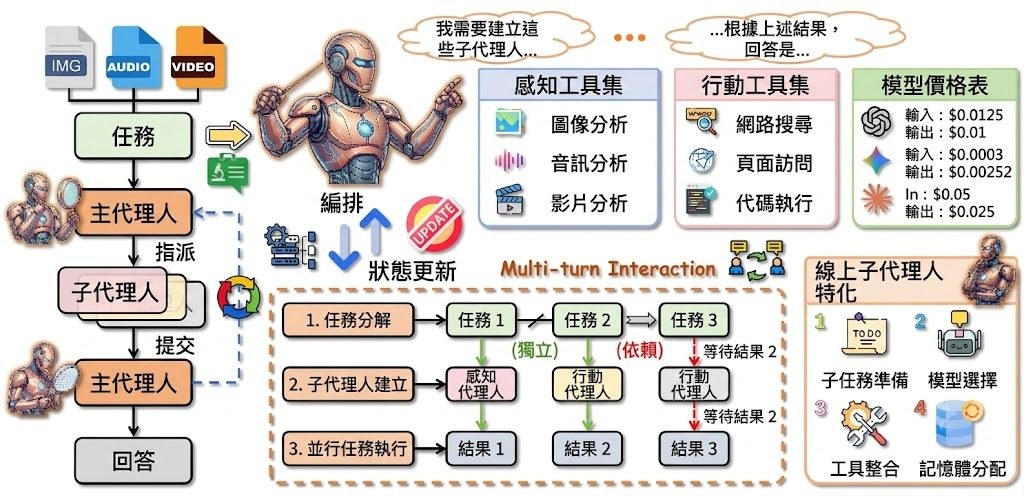
由香港中文大學等團隊研發的 Orchestra-o1 採用 MainAgent + SubAgent 架構,在 OmniGAIA 基準上以 72.8% 準確率領先對手 10.3 個百分點。

Orchestra-o1 Framework

Orchestra-o1 由香港中文大學(CUHK)計算機科學與工程學系的 Fan Zhang 領銜,聯同北京大學、清華大學、同濟大學及 LIGHTSPEED 團隊共同開發。模型權重同步開源於 Hugging Face。

這個項目的定位是多智能體協作框架,針對文字、圖像、音訊、影片並存的「全模態」(omnimodal)場景,自動把複雜任務拆解成多個子任務,再分配給專責的 SubAgent 執行。MainAgent 負責規劃與協調,SubAgent 則配備搜尋、執行程式碼、影音分析等工具獨立運作,獨立子任務可同步執行以提升效率。

重點摘要:

  • 層級式架構:MainAgent 統籌拆解任務,SubAgent 各司其職,避免單一模型疲於應付多模態輸入。
  • 平行執行:無依賴的子任務同步進行,加快整體處理速度。
  • DA-GRPO 訓練法:以 Qwen3-8B 為基礎,搭配 Decision-Aligned Group Relative Policy Optimization 與 LLM-as-judge 獎勵機制微調。
  • OmniGAIA 表現:在 OmniGAIA 基準測試取得 72.8% 準確率,領先第二名 10.3 個百分點。
  • 開源生態:基於 Python 3.10+ 與 verl 框架,訓練需 8 張 H20 (96GB) GPU 單節點。

Orchestra-o1 的創新在於把「模態感知拆解」與「線上子智能體特化」結合,讓多模態協調不再依賴線性流程。適合需要處理多媒體資訊的研究團隊、Agent 開發者,以及關注 Computer-use agents(CUAs)與多模態模型應用的工程師。

效能方面,作者將 Orchestra-o1-8B 定位為同類開源全模態代理中最先進(SOTA),同時在商用模型(例如 GPT-5)推理腳本中亦提供整合,方便研究人員比較開源與閉源路線的差距。

GitHub: https://github.com/zfkarl/Orchestra-o1

Paper: https://arxiv.org/pdf/2606.13707

Categories: 開源, 香港中文大學, Agentic, 模型, 框架, OpenClaw, 深度學習

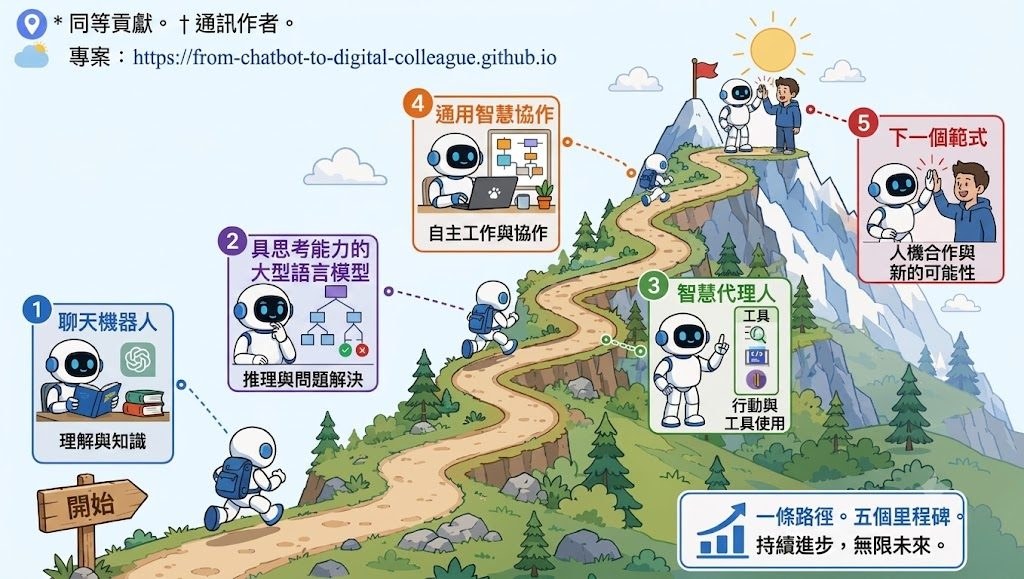
[技術文章] 從聊天機械人到數碼同事:AI 怎樣學會「持續工作」

一篇文章帶你了解 AI 從只懂回答問題,進化到能像同事般持續完成任務的關鍵轉變。

Hero image preview

這項文章由騰訊優圖實驗室、清華大學、中山大學、中南大學及伊利諾大學芝加哥分校的研究團隊共同撰寫,提出一個核心觀點:大語言模型(Large Language Models, LLMs)正從「聊天機械人」邁向「數碼同事」,關鍵差異在於能否持續完成工作,而非只給出對話式回應。

團隊將這個轉變拆成兩個互相牽引的維度。第一個是「認知核心」的進化:LLMs 從依賴下一個詞預測的「快思維」,走向會運用推理時間計算、長思維鏈(Chain-of-Thought)、反思及強化學習的「思考型 LLM」,讓推理過程更謹慎可靠。第二個是「工具輔助任務執行」的進化:從臨時呼叫外部工具的 Agent,走向類似 OpenClaw 風格的工作站系統,配備持久化的工作區(Workspace)、可重用的技能(Skill)、驗證迴圈及治理機制。

文章特別強調「Workspace + Skill」這個範式是關鍵躍升。它讓原本零散的工具操作,變成像同事般有狀態記憶、可重用流程、能完成任務並累積經驗的工作模式。數據結構也從簡單的指令—回應配對,演進為「狀態—動作—觀察」的軌跡記錄;評估方式則從靜態基準測試,轉向沙盒化、可審計、能自我進化的 AI 生態系統。

這份內容適合關注 AI Agent 發展、想了解 LLM 下一代形態的研究者與產品設計者。讀者可透過項目網站(from-chatbot-to-digital-colleague.github.io)取得完整論文與相關資源。

重點摘要:
– 由騰訊優圖實驗室主導,聯同清華、中山、中南及 UIC 共同研究
– 提出從「聊天機械人」到「數碼同事」的範式轉移
– 認知層面:從快思維走向推理驅動的「思考型 LLM」
– 執行層面:從臨時工具呼叫走向持久化 Workspace + Skill 系統
– 評估方式同步轉向沙盒化、可審計的 AI 生態系統

Paper: https://arxiv.org/pdf/2606.14502

Categories: 開源, 清華大學, Agentic, 模型, 模型訓練, 框架

VISTA 準確提升 GUI grounding

VISTA 不是通用聊天模型,而是用來訓練 GUI grounding 的方法。它針對畫面定位學習訊號不足的問題,效果有明顯提升。

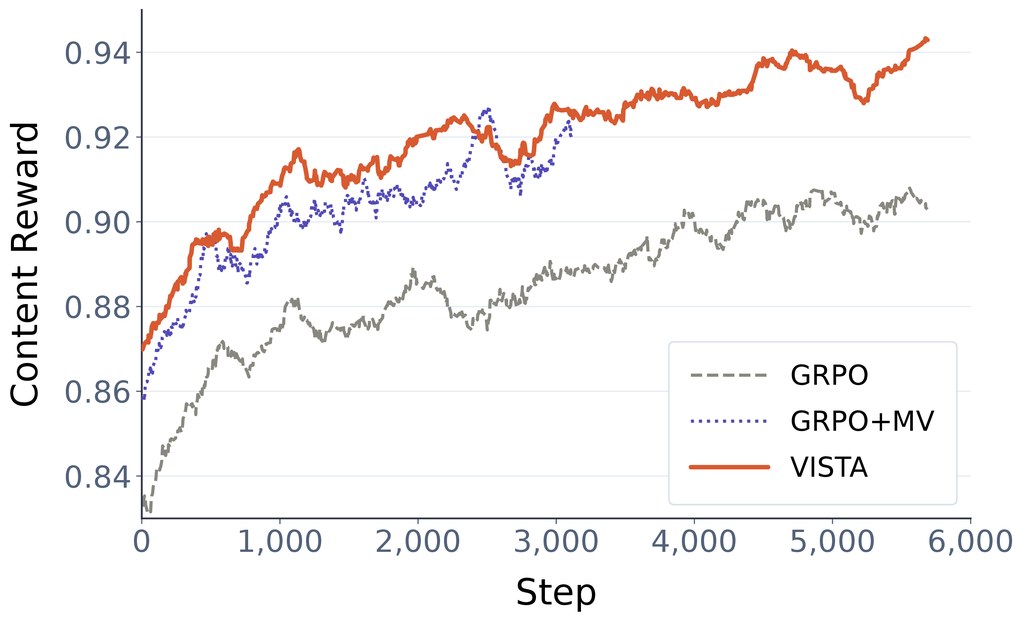
ScreenSpot-Pro accuracy curve

VISTA 是一個面向 GUI grounding 的訓練框架,核心目標是令模型更準確地在螢幕截圖中找出應該點擊的位置。它處理的不是一般文字理解,而是讓模型根據指令,在複雜介面上輸出座標,減少按錯按鈕、點錯輸入框這類問題。

這個項目的重點,在於它不是只從同一張截圖反覆抽樣,而是把同一個 GUI 畫面裁成多個仍保留目標元素的 view,再用這些 view 建立 GRPO 比較組。由於每個 crop 都會精確重映射座標,模型等於在語意相同、幾何位置不同的畫面上學習,能改善單一視角下「全部答錯」或「全部答中」而缺乏學習訊號的情況。

另一個關鍵設計是 self-verified cross-view anchor。它只會在目前 policy 已經產生 maximum-reward rollout 時,才加入 oracle coordinate,避免把訓練直接變成無條件模仿;這點對 GUI 座標生成尤其重要,因為短座標輸出很容易受微小偏差影響。從描述來看,這種做法比標準 GRPO 更重視穩定性,也更保留 reinforcement learning 的比較學習特性。

  • 這是一個訓練方法項目,不是最終應用程式,主要用來提升 GUI grounding 模型表現
  • 核心改動包括 view-consistent GRPO groups 與 self-verified cross-view anchor
  • 在 ScreenSpot-Pro 上,Qwen3-VL 4B/8B/30B-A3B 由 55.5/52.7/53.7 提升至 63.4/65.8/67.0
  • 以 Qwen3.5 初始化的 4B/9B/35B-A3B backbone,亦比 standard GRPO 再高 +2.0/+0.9/+1.2
  • 已公開相關模型包括 VISTA-4B、VISTA-9B

如果你本身有做 Computer-use agents(CUAs)、GUI 自動化、螢幕操作代理,這個項目特別值得留意。它較適合研究人員、模型工程師,或者正在調整 Qwen3-VL、Qwen3.5 視覺語言 backbone 的團隊;一般用家未必會直接部署這個項目,但可以把它視為提升介面定位能力的一套訓練方案。

就公開資料看,VISTA 的說服力主要來自基準分數與訓練動態變化:content reward、更高的 informative group ratio,以及 ScreenSpot-Pro 準確度同步上升。再加上論文提到五個 GUI-grounding benchmarks、較高 worst-view accuracy 和較低 prediction flip rates,整體判斷是:這個項目不是靠包裝取勝,而是針對 GUI grounding 訓練訊號退化問題,提出了相當對症的改法。

GitHub: https://github.com/ZJUSCL/VISTA

Paper: https://arxiv.org/pdf/2606.14579

Categories: 開源, 模型, 模型訓練, 框架

Surflo 用全域狀態重建一致 3D 表面

Surflo把多張未對位影像壓成固定狀態,再生成一致的3D表面。它兼顧彈性輸入與高解析輸出。

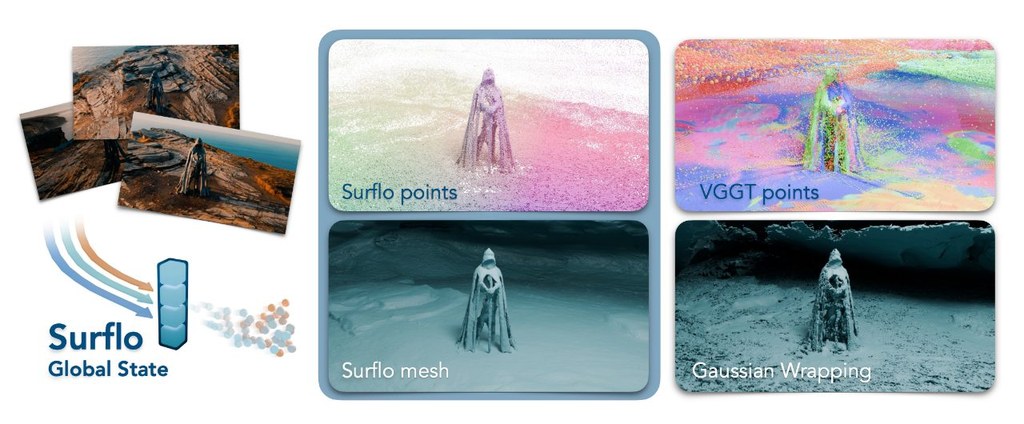
Surflo: a single coherent surface decoded from one global state

Surflo 是一個由多張未對位影像重建 3D 表面的項目。它先把數量可變的輸入視角整合成單一 global latent state,再用 flow-matching ODE 逐點生成表面,目標是避免傳統每個視角各自輸出、最後難以拼合的問題。

這個項目的核心做法,是把 N 張影像壓縮成固定大小的全域狀態 z,當中只有 K=128 tokens,之後再按需要解碼任意數量的表面點。因為每個點可獨立生成,同一次編碼之後便能輸出不同解析度,最高提到可處理 M up to 10^6 oriented points。

為了令獨立生成的點仍然保持同一個連貫表面,Surflo 加入 communication guidance 機制,利用 shared rendering loss 在 ODE 積分過程中協調鄰近點。系統會把點轉成 3D Gaussians,再用 Gaussian Splatting 渲染,藉此減少局部表面互相矛盾的情況。

Surflo: Consistent 3D Surface Flow from a Global State

重點項目:
– 支援 variable number of unposed images,不要求固定視角數量
– 以單一 global state 取代 per-view tokens 堆疊,控制表示大小
– 可按需要解碼任意表面解析度,不必重新編碼
– 在 8 個 benchmarks、2 到 32 views 條件下報稱達到 state of the art performance
– 另提供真實場景資料集,約 10.5K DL3DV scenes,包含 full scene meshes

這類項目較適合做多視角 3D 重建、場景數碼化,或者需要由少量到多量視角靈活輸入的研究工作。文中亦點名對比現代 feed-forward 3D 模型如 VGGT(https://huggingface.co/facebook/VGGT-1B)、DUSt3R、DepthAnything-3;若你關心的是如何由多張相片穩定得到同一個完整表面,Surflo 的全域狀態設計值得留意。

模型列表:VGGT(https://huggingface.co/facebook/VGGT-1B)、DUSt3R、DepthAnything-3。

項目: https://anttwo.github.io/surflo/

Categories: 開源, Agentic, 框架, 3D, Meta

graphify:把雜亂資料變成可查詢知識圖譜

graphify 是給 Claude Code 用的技能項目,會把多種格式內容整理成知識圖譜。對經常在文件、程式碼與截圖之間來回找資料的人特別有幫助。

Graphify

graphify 是一個給 AI coding assistant 用的 skill,能把你的 codebase、文件、PDF、圖片、影片轉成可查詢的 knowledge graph。

它支援多種 AI 工具與 IDE,包括 Claude Code、Codex、Cursor、Gemini CLI、OpenCode、OpenClaw 等。

它較有新意的地方,在於 fully multimodal 與持久化設計同時出現。graphify 會用 Claude vision 從圖片、白板相片、示意圖抽取概念,再跟文字與程式碼內容接起來;同時用 SHA256 cache 只重跑變更過的檔案,令更新流程不會每次由零開始。

Graphify: Turn Your Codebase into a Queryable Knowledge Graph for Claude Code
  • 支援 code、PDF、markdown、screenshots、diagrams、whiteboard photos 等多種輸入
  • 輸出不只一種,包含互動圖譜、Obsidian vault、wiki 頁面與報告檔
  • 官方描述提到每次查詢可比直接讀原始檔案減少 71.5x tokens
  • 提供 --update--mode deep,適合持續整理變動中的資料集

這個項目較適合幾類人:長期維護大型 codebase 的開發者、要整理研究材料的人、會把文件與截圖混在一起存檔的知識工作者。若你的資料本來就很少、結構清楚,它的優勢未必會完全發揮;但對資訊來源分散、跨格式混雜的情境,graphify 顯得相當對症。

性能資料目前公開重點以 token 節省為主,屬於效率導向的訊號,不等於完整基準測試。相關技術與依賴可直接見到 Claude Code、Claude vision、Obsidian,以及知識圖譜輸出流程;若你想為 AI coding assistant 建立可追蹤、可累積的內容索引,這個項目有明顯可試價值。

支援工具表

工具 / 平台安裝或啟用指令
Claude Codegraphify install
CodeBuddygraphify install --platform codebuddy
Codexgraphify install --platform codex
OpenCodegraphify install --platform opencode
Kilo Codegraphify install --platform kilo
GitHub Copilot CLIgraphify install --platform copilot
VS Code Copilot Chatgraphify vscode install
Aidergraphify install --platform aider
OpenClawgraphify install --platform claw
Factory Droidgraphify install --platform droid
Traegraphify install --platform trae
Trae CNgraphify install --platform trae-cn
Gemini CLIgraphify install --platform gemini
Hermesgraphify install --platform hermes
Kimi Codegraphify install --platform kimi
Ampgraphify amp install
Kiro IDE/CLIgraphify kiro install
Pi coding agentgraphify install --platform pi
Cursorgraphify cursor install
Devin CLIgraphify devin install
Google Antigravitygraphify antigravity install

GitHub: https://github.com/safishamsi/graphify

Categories: 開源, Agentic, 框架

SpatialClaw:用程式碼推動空間推理代理

SpatialClaw把程式碼變成代理的動作介面,主攻複雜空間推理。它在20個基準上交出明顯領先的平均成績。

SpatialClaw logo

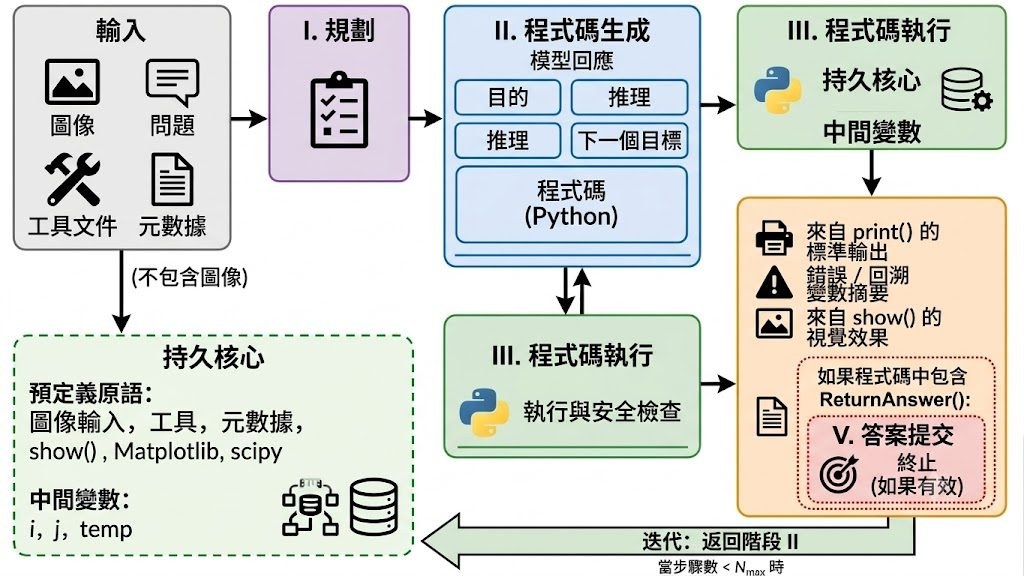
SpatialClaw 是一個免訓練的空間推理框架,重點不是再加更多工具,而是改寫代理如何調用工具。它把程式碼當成動作介面,讓 Vision-Language Model 代理逐步寫入 Python cell,在同一個持續運行的 Jupyter kernel 內查看中間結果、再調整下一步判斷,目標是處理 3D、4D 以及影片場景中的空間理解問題。

這個項目的新意,在於它避開單次執行整段程式或僵硬的 tool-call 方式。代理每次只提交一格程式,能結合 SAM3 segmentation、Depth-Anything-3 reconstruction、geometry utilities,以及 NumPy、SciPy、Matplotlib 這類科學運算庫,分析過程更像逐步查證,而不是一次過猜答案。

如果你想測試它,較合適的做法是用多視角圖片、影片片段,或需要判斷位置、距離、遮擋、移動關係的題目來跑。文件亦提到部署模型有明確硬件要求:FP8 版本需要 Linux 與 NVIDIA Hopper(H100)或更新 GPU;若手上是 A100 或 L40S,則可改用 models.json 內列出的 AWQ 或 GPTQ Int4 條目,並沿用相同 served_name,模型設定毋須重改。這也反映 NVIDIA 近年在 Robotic 與 World Model 相關項目上的投入相當積極。

成績方面,公開資料指出它在 20 個空間推理基準取得 59.9% 平均準確率,比先前最佳空間代理高 11.2 個百分點。更重要的是,這個結果據稱在相同 system prompt、工具組合與 hyperparameters 下完成,覆蓋六個 VLM 骨幹,代表它的提升未必只靠特定 benchmark 微調。

  • 屬於空間推理代理框架,解決 VLM 在 3D/4D 關係判斷上不夠靈活的問題
  • 核心方法是以程式碼作為動作介面,逐步執行與修正分析
  • 支援的感知模組包括 SAM3 segmentationDepth-Anything-3 reconstruction 與 geometry utilities
  • 公開結果涵蓋 20 個 benchmarks,平均準確率為 59.9%
  • 相關模型家族包括 Qwen3.5、Qwen3.6、Gemma4,規模由 26B 至 397B

這個項目特別適合研究 Computer-use agents、空間智能、機械人感知,或者想比較 tool-augmented agent 與 VLM 推理流程的人。若你關心的不是聊天表現,而是模型能否一步步觀察畫面、調工具、修正推論,SpatialClaw 展示了一條幾有說服力的路線。

GitHub: https://github.com/NVlabs/SpatialClaw

項目: https://spatialclaw.github.io/

Categories: 開源, Agentic, 模型, 視覺模型, NVIDIA

InterleaveThinker 多步生成變得可控

多代理圖像生成流程,重點不在畫得更靚,而是把多步圖文內容排得更準。它特別適合故事分鏡、教學指引與機械操作描述。

logo

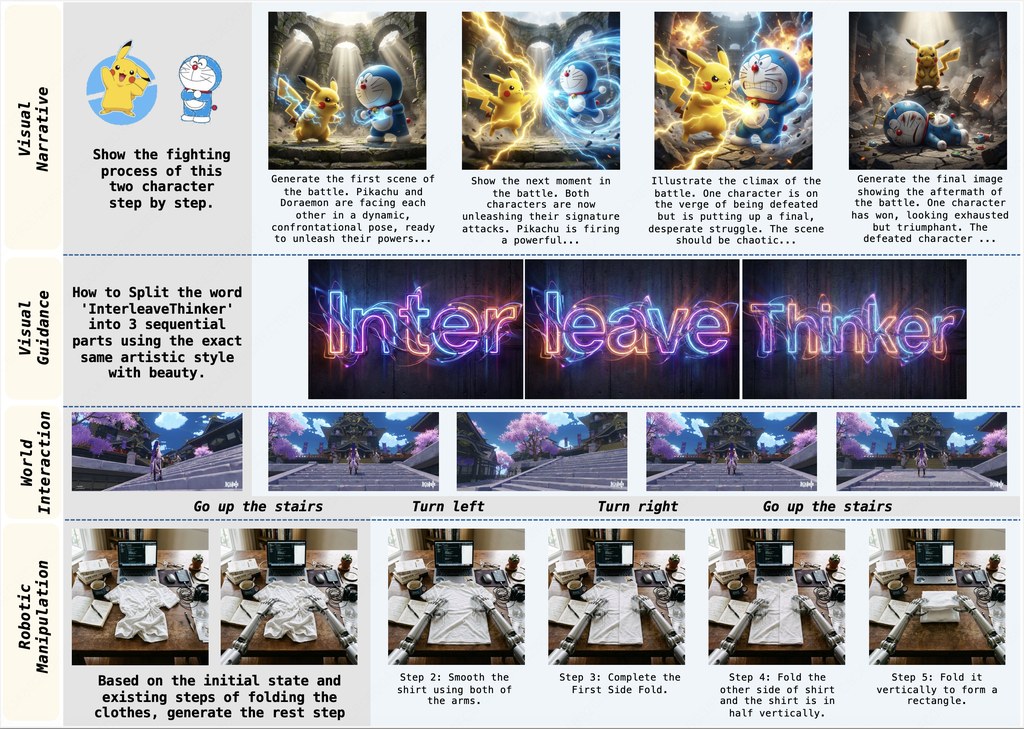
InterleaveThinker 是一個多代理生成流程工具,目標是替現有圖像生成器加入 interleaved generation 能力,即按步輸出文字與圖片交錯的內容。它想處理的,不是單張圖夠不夠精美,而是多個步驟之間是否連貫、是否跟指令一致。

這個項目的核心做法,是把工作拆成 planner agent 與 critic agent。前者先安排圖文序列和每一步任務,後者再檢查生成結果、有偏差就修正指令再生成,做法比單次提示更像一個會反覆校對的流程。

如果你想試它,方向很明確:先接上它已支援的生成器,再用多步任務測試,例如故事場景連續變化、視覺教學、摺衫步驟、角色互動或 embodied manipulation。儲存庫已列出多個可配合的模型端口,包括 Qwen-Image、Qwen-Image Lightning、FLUX.1-Krea-dev、Qwen-Image-Edit Lightning、FLUX.1-Kontext-dev Edit 與 FLUX.1-Fill-dev Fill。

公開資料顯示,它在 interleaved generation benchmark 的表現可與 Nano Banana 及 GPT-5 接近;在推理導向基準也有明顯提升,例如 WISE 由 0.47 升至 0.73,RISE 由 13.3 升至 28.9(4-step FLUX.2-klein)。這些數字反映它的價值主要在「多步一致性與修正能力」,不是單靠底層模型硬撐。

  • 重點不在訓練全新生成器,而是增強現有 image generator
  • 以 planner agent + critic agent 處理多步圖文任務
  • 適合 visual narratives、guidance、embodied manipulation、long-horizon sub-task annotation
  • 已公開相關模型:InterleaveThinker-Planner-8B、Critic-SFT-8B、InterleaveThinker-Critic-8B
  • 另有訓練資料集:Interleave-Planner-SFT-80k、Interleave-Critic-SFT-112k、Interleave-Critic-RL-13k

對研究圖文代理、工作流編排,或者想把現有出圖模型拉進多步任務的人,這個項目很有參考價值。若你只想單次生成一張圖,它未必是最直接的選擇;但若你要的是連續幾步都講得通、畫面不走樣,InterleaveThinker 的定位相當清楚。

GitHub: https://github.com/zhengdian1/InterleaveThinker

項目:https://zhengdian1.github.io/InterleaveThinker-proj/

Categories: 開源, 香港中文大學, 模型, 影像模型, 影像處理

Page 52 of 92
1 50 51 52 53 54 92