Temporal-Distance-JEPA 訓練世界模型能懂「時間距離」

香港浸會大學團隊把 JEPA 世界模型由「會預測」推近一步到「更識規劃」。Temporal-Distance-JEPA 針對離線示範缺少回報訊號的痛點,直接從軌跡次序挖出可用的進度成本。

Repository image for HKBU-KnowComp/Temporal-Distance-JEPA

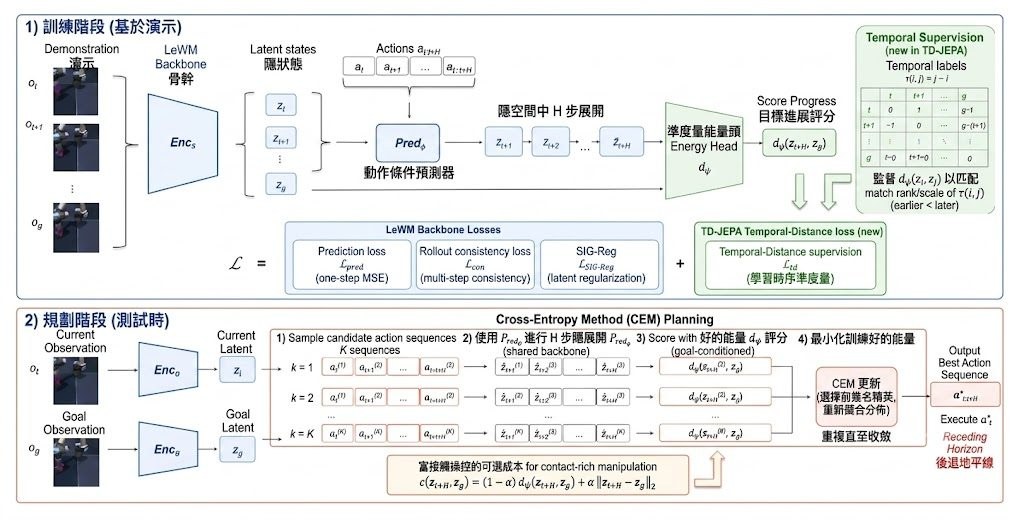
香港浸會大學 HKBU KnowComp 的 Jiaxin Bai 公開了 Temporal-Distance-JEPA 論文重現項目,核心不是再做一個更複雜的世界模型,而是修正 JEPA 規劃常見的落差:訓練時學短期 latent prediction,規劃時卻往往直接拿 latent Euclidean distance 當成目標進度。這個項目屬於模型研究重現項目,處理的是離線示範沒有 reward 時,planner 點樣判斷哪條想像路徑更接近目標。

作者保留 LeWM encoder–predictor 與 SIGReg backbone,但不再只依賴 embedding 幾何,而是從 reward-free demonstration logs 挖出 directed temporal cost。做法沿住論文邏輯很清楚:同一條 trajectory 的先後步序提供 positive targets,跨 trajectory 配對充當 heuristic negatives,再用 rollout-consistency 令學到的成本更貼近 planner horizon。這種 framing 直接回應舊範式把 latent L2 當成進度代理的限制,因為拓撲主導任務未必適合只看幾何距離。

結果在 Two-Room、Reacher 這類 topology-dominated tasks,規劃時直接部署 mined cost d_psi;到了 Push-T、OGB-Cube 這類 contact-rich tasks,則改用同一個 temporally trained checkpoint 上的 latent l2 planning。locked evaluation 下,Two-Room 成功率提升到 100.0%,高於 LeWM 的 97.4%;OGB-Cube 亦比 LeWM 高 14.2 分,並且整體上對 LeWM 與 RC-aux baseline 都能持平或更好。

  • 建基於 stable-worldmodel、stable-pretraining 與 LeWM 既有布局,重點在訓練目標與規劃成本的重新對齊
  • 公開庫是 paper-reproduction release,保留 Python CLI,但刻意不附 cluster/Slurm 包裝
  • 資料以 HDF5 形式放在 STABLEWM_HOME,涵蓋 Push-T、Two-Room、Reacher、OGB-Cube
  • 採用 10 epochs,並附有 locked results、cost matrix、diagnostics 等結果資料

這個庫比較像給已有研究工作流的人接手重跑:有 Python 環境、requirements、Hydra config、資料位置與 checkpoint 輸出方式,但沒有替不同排程系統準備現成封裝。歷史上的 contrastive SoftJEPA 相容程式仍可能留在 losses.py 或 jepa.py,不屬於公開配置;換句話說,閱讀與重現時要以 td_jepa 設定為準。對做 world model、offline RL、latent MPC 的研究團隊來說,這個項目最有價值的地方,是它把「表示學到什麼」與「規劃要怎樣排序未來」重新綁在一起。
GitHub · Paper

Categories: 開源, 浸會大學, Embedding, 世界模型, 模型訓練, 香港, Python, 中國

Octafuse Gateway:幫 Agent 管好多模型入口

Octafuse 團隊做的不只是轉發層,而係把模型、工具同配額管理收埋到同一個入口。對要同時接多個 AI 服務嘅團隊,呢種集中控制會直接省下不少營運工序。

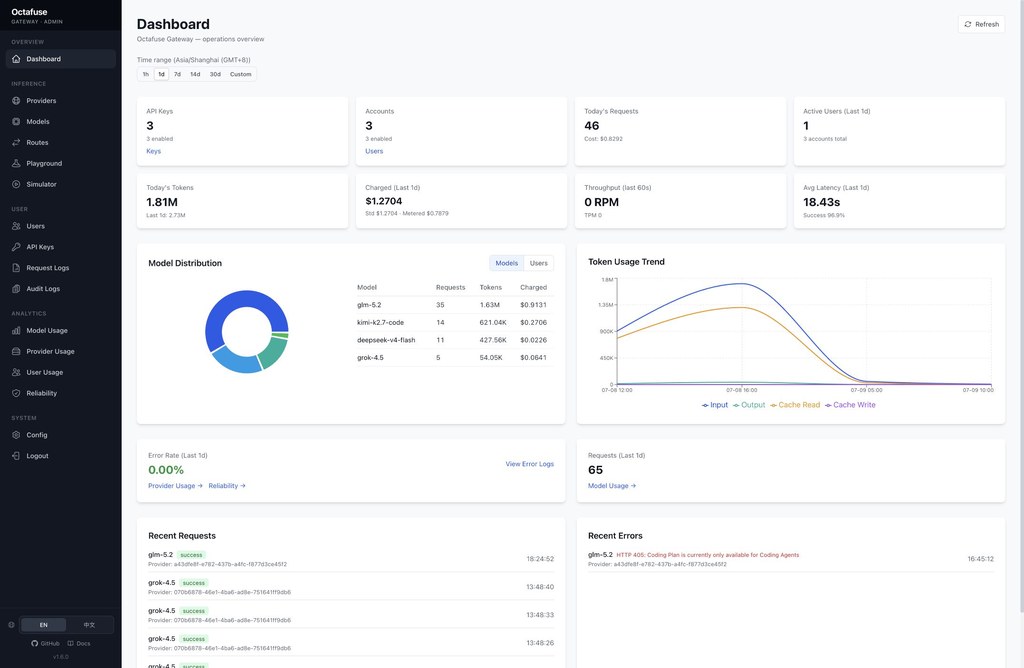
Octafuse Gateway 运营概览

Octafuse 團隊把重點放在 Agent 工作流,而唔係只做一個轉發請求的薄層。Octafuse Gateway 屬於可自託管開源 AI gateway,處理的是多供應商模型、圖像、語音轉寫同 Agent Tools 分散管理的問題,特別適合已經有多組 API Key、不同模型來源,甚至自建服務要一齊協調的團隊。

它最有價值的地方,在於把「接得通」進一步做成「管得住」。同類項目常見重點是模型代理與相容 API,Octafuse Gateway 另外加強了路由、故障轉移、預算、審計、三賬本計費,同埋公開能力目錄,令 Agent 可以透過統一入口發現同調用資源,而管理者亦可以追蹤成本與用量。

部署方向,支援 Cloudflare Workers + D1,以及 Docker 配合 Postgres / MySQL 自託管;Node.js 20+ 亦是明確要求。原始資料未展示完整安裝步驟,但有 operator 文件、Admin 管理界面、Playground 同 Simulator,反映它不是只給開發者讀 API 文件,亦有一套管理與聯調介面可用。

  • 兼容 OpenAI Chat Completions、Anthropic Messages、Gemini、OpenAI Images 與 OpenAI Audio Transcriptions API
  • 可集中管理 Provider API Key、RPM / TPM、並發、熔斷狀態與剩餘容量調度
  • 內置 Provider 與模型導入模板,減少逐個端點手動維護
  • 提供 /v1/tools/* 接入 Agent Tools,現有 web-search、web-fetch、web-deep-search
  • 有 Playground、Simulator、審計與成本觀察能力,方便排查路由與計費設定

它強調的是可靠調度與營運控制,而非單一模型跑分。對需要向內部團隊、客戶或不同項目發放獨立 API Key 的環境,這種以資源治理為核心的取向,比單純聚合模型端點更完整,但相對也代表配置面會更廣,較適合已有多模型、多使用者或多成本中心需求的團隊。

GitHub

Categories: 開源, Agentic, OpenAI, Gemini, API, 框架, Anthropic

NVIDIA FastGen 平行解碼的加速擴散生成訓練

NVIDIA 團隊把擴散模型加速訓練與蒸餾流程整理成同一套框架,重點不止是跑得快,亦方便跨影像與影片任務重用方法。

Watch the video

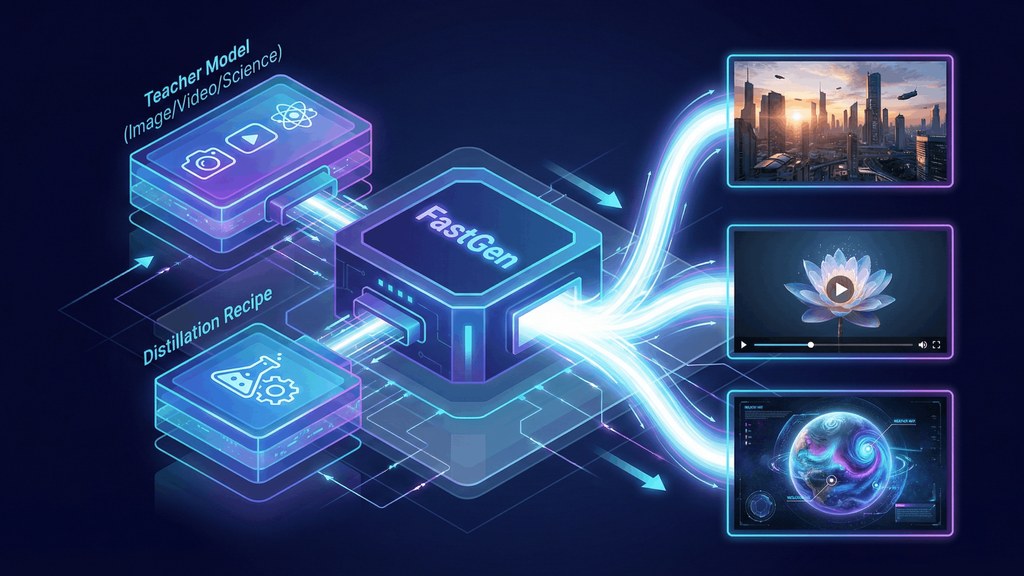
由 NVIDIA 團隊主導,Weili Nie、Julius Berner、Chao Liu 與 Arash Vahdat 是署名作者,核心貢獻者亦包括 Weili Nie、Julius Berner、Chao Liu。這個項目放在 NVlabs 名下,定位很明確:它不是單一生成模型,而是用 PyTorch 建成的訓練框架,集中處理 diffusion models 的加速與蒸餾,讓影像與影片生成可以用較少步數完成推理,同時保留大規模訓練能力。

與一般只提供某一種加速技巧的研究代碼不同,FastGen 把 consistency models、distribution matching distillation、self-forcing、KD 等方法放進同一套結構,並且覆蓋 T2I、I2V、V2V 多種任務。這種設計的價值,在於研究團隊可以在相近配置與資料流程下比較不同蒸餾路線,而不是每試一種方法就重砌整套訓練管線。

基本理解方式:代碼庫包含 datasets、methods、networks、trainer 與 scripts,顯然以訓練、推理、評測三部分分開整理;環境方面建議用 Docker,也保留 conda 安裝路線,並支援 W&B 記錄。不過公開資訊未有列出完整 quick start 細節、現成模型清單或基準成績,現階段較像面向研究與工程團隊的基礎框架,而不是開箱即用的消費級生成工具。

Prompt:
4 NFE PDD on Wan2.1 14B: A joyful child, 
with a big smile and arms spread wide, 
swings energetically on a rusty old swing set in a sunlit backyard. The swing set, with peeling paint and creaking chains, 
contrasts against the vibrant green grass and blooming flowers surrounding it. 

The child's laughter echoes as they swing higher and higher, 
their feet barely touching the ground at the bottom of each arc.
 
The scene is captured from a low angle, 
emphasizing the height of the swings, 
with the sun casting a warm glow over everything.
Medium shot focusing on the child and the swing set.
  • 屬於框架型項目,處理的是 diffusion models 如何更快生成,而不只是再訓練一個新模型
  • 支援 ≥10B 參數的大規模訓練,較適合有多卡資源的團隊
  • 任務涵蓋 T2I、I2V、V2V,對跨模態生成研究較有吸引力
  • 方法層同時納入 consistency models、distribution matching distillation、self-forcing 等路線,方便做橫向比較

配合 NVIDIA 研究頁面的 FastGen-PDD 脈絡來看,這個項目也像是承載後續加速生成方法的底座,尤其面向 image 和 video generation 的 parallel decoding distillation。對想建立自家快速生成訓練流程、測試不同蒸餾策略,或者需要把大型 diffusion 項目整理成可維護代碼庫的團隊,FastGen 的參考價值高;但想直接下載即用、立刻看到完整評測結論的人,現有公開資料仍然偏少。

項目主頁 · GitHub · Paper

Categories: 開源, 視頻模型, NVIDIA, Video, Image, txt2img, Python, 語音

ID-V2V:先拍片後改風格的影像研究

Netflix 與 Eyeline Labs 把焦點放在一件很難的事:換掉影片風格與光線之餘,角色樣貌和表演仍要留得住。ID-V2V 正是朝這個製作流程而來的研究項目。

ID-V2V teaser

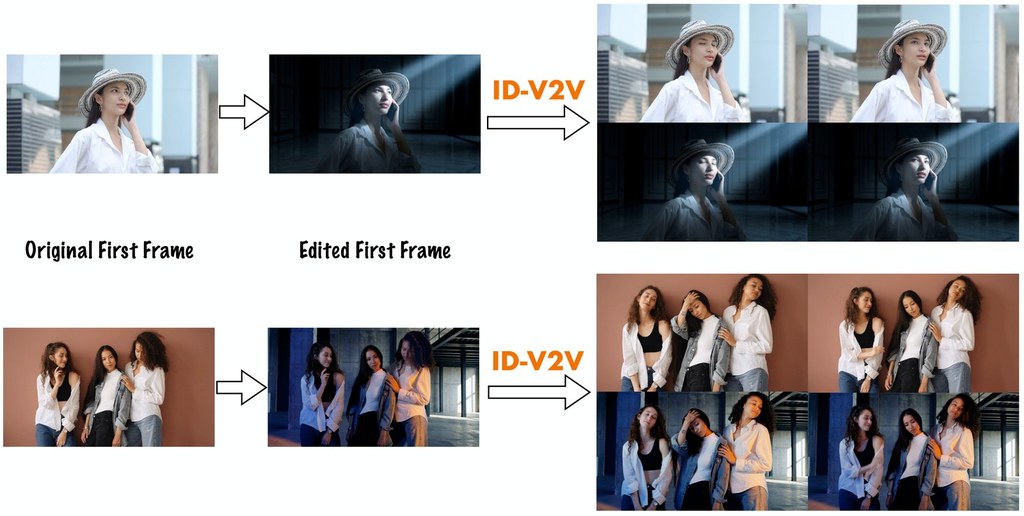
開發團隊來自 Netflix 與 Eyeline Labs。這個研究項目瞄準影像製作中最棘手的一段流程:想改影片風格、場景氣氛甚至補做光線,但又不想犧牲演員的表情、眼神、口型同步和肢體動作;ID-V2V 屬於 video-to-video 生成框架,處理的正是這種「保留身份與表演、再把風格傳播到整段影片」的問題。

現有做法常把影片重繪理解成一般風格轉換或逐格生成,作者認為這種範式很難同時守住 facial likeness 與細微 performance。ID-V2V 的切入點是把 identity preservation 重新表述成 video relighting,再把 edited keyframe 帶來的風格變化交給 controlled video synthesis 處理,並結合 relit facial regions、facial normal maps、edited keyframes 與 depth sequences,將身份約束與整體畫面變化拆開處理。

這個取向的價值很直接:你先拍好 source video,再準備一張 stylized keyframe,系統便嘗試把光線、場景與風格延展到整段片,同時盡量守住人物。原始資料亦提到 imperfect keyframe 的情況,即使首張風格幀和原片姿勢未必完全對齊,模型仍會在之後的幀數重新貼近 source video 的身份與表演,這點比只追求單幀好看更貼近製作流程。

  • 提供兩個模型變體:idv2v 以及加入 normal-depth 訊號的版本
  • preprocess → generate 的推理流程與輸入輸出結構
  • 環境集中在單一 uv 環境,另需下載多個 checkpoints,預設資源需求相當高
  • 已測試於 8× A100-80GB,代表它較接近研究與製作級部署,不是輕量玩具
  • 項目定位寫得很清楚,只供 demonstration and inspiration purposes

部署與測試資訊算完整,提供環境設定、checkpoint 下載、推理流程和多種案例,但門檻不低:需要 Python 3.10、torch 2.6+cu118、SAM3 權限,以及連同 Wan2.1 相關元件在內的大量模型檔案。性能方面,項目與首頁都表示在 preserving facial likeness 與 fine-grained facial performance 上明顯優於既有方法,並支援 single-subject 與 multi-subject 場景。

項目主頁 · GitHub · Paper

Categories: 開源, Video, 影像處理, Python, Dataset 數據集

LTX-2.3 Black-Magic 黑暗補景 LoRA

夜景片段唔夠光,未必只係拉高亮度就解決到。呢個 LoRA 走生成式 VFX 路線,重點係補出畫面可能存在的內容。

Og image

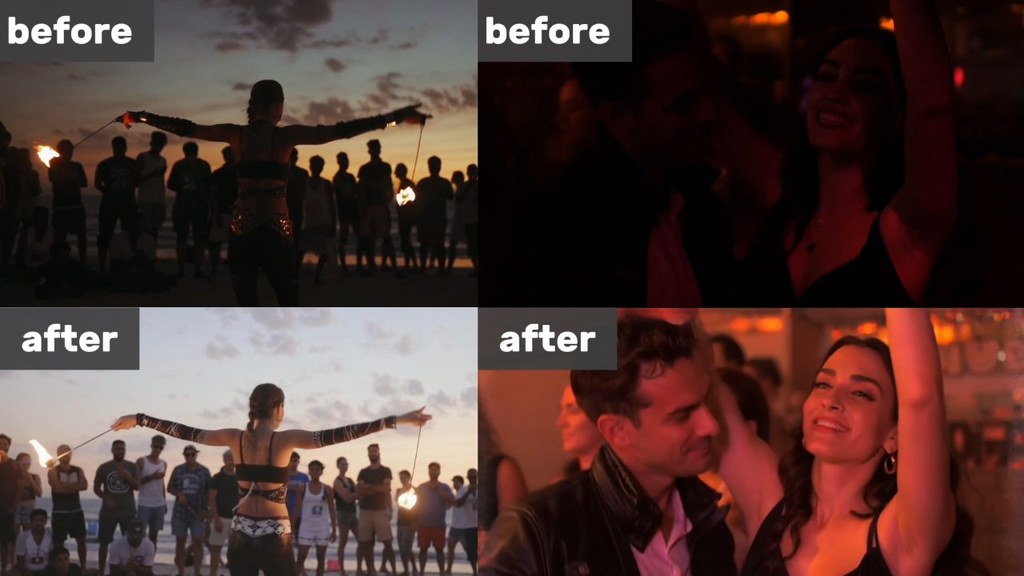
拍到過暗片段時,最直接嘅痛點係一加光就爆雜訊、細節仍然唔見。LTX-2.3-Black-Magic-LoRA 明確建基於 Lightricks/LTX-2.3,以 adapter 形式提供 IC-LoRA,定位唔係忠實還原訊號,而係替黑位內容做具時間連貫性嘅生成式重建,所以更接近 video-to-video 視覺特效模型,而唔係傳統 low-light enhancement。

取捨亦講得好清楚:當原始畫面資訊太少,模型會「推斷」暗處可能有咩,而唔係保證還原真實場景。呢種做法對氣氛鏡頭、夜景、舞台火光、森林或室內昏暗片段有吸引力,因為畫面觀感會比單純提亮更自然;但用喺證據保存、監控取證或要求真實性的工作,就要非常審慎。

項目提供嘅技術資訊相對精簡。已知它使用 diffusers,pipeline tag 係 video-to-video,模型檔案列出 black-magic-ic-lora-450.safetensors,而名稱中標示對應 LTX-2.3 22B。不過頁面截圖內容未見上下文長度、GGUF 格式量化、mmproj、llama.cpp、Ollama、LM Studio、MTP draft speculation、v2 更新紀錄、檔名變更或 chat template 說明,代表呢頁並唔係本地 LLM 部署型模型卡,相關部分無法確認。

  • 基礎模型已明示為 Lightricks/LTX-2.3,關係為 adapter,而唔係完整重訓主模型。
  • 能力核心係 shadow reconstruction,重建暗部觀感,唔等於忠實還原原始訊號。
  • 標籤集中在 ltx-video、low-light、generative-video、vfx、lighting,用途相當聚焦。
  • 已知檔案只有 black-magic-ic-lora-450.safetensors

同一般曝光修正最大分別,在於接受「畫面不夠資料時需要生成補完」呢個前提。使用者應該將它視為風格化且偏後期製作取向嘅影像模型;想改善觀感、保住影片連續性,它有明確價值,但要用作真實場景還原,頁面本身已經劃清界線。

項目主頁 · 模型

Categories: 開源, 視覺模型, NVIDIA, Video, Image, Python, LTX

Microsoft Mage:4B 多模態輕量路線

想做影像生成、編輯,甚至進一步研究多模態模型,但運算資源有限,Mage 會係一個值得留意的方向。它把 4B 規模壓到夠細,同時仍然追住更大模型的表現。

gallery

當你想喺有限 GPU 預算下做影像生成、編輯,甚至延伸到影像與影片理解,Mage 這個開源模型家族的定位就相當直接:用固定 4B 參數規模,處理多模態理解與生成兩條路線,目標唔係堆大模型,而係保留研究可控性同部署可行性。

Mage 目前最完整的是 Mage-Flow,屬於模型家族中的生成與編輯分支。它把 Mage-VAE 同 Native-Resolution Multimodal Diffusion Transformer 組合起來,前者負責更高效率的 latent tokenizer,後者負責文字生圖與指令式修圖;同時提供 Base、RL-aligned 同 4-step Turbo 版本,方便按畫質、對齊程度與速度取捨。另一條線 Mage-VL 對準 image/video understanding,但程式與權重細節仍待釋出。

同類開源影像模型很多都靠更大參數量換效果,Mage 的判斷明顯不同:它把重點放喺 codec-aligned efficiency,同一個 checkpoint 已可覆蓋 512 到 2048、不同長闊比,連 4:1 這類極端尺寸都原生支援,減少多套模型或額外縮放流程。它在生成、編輯表現上可與 Qwen-Image 20B、FLUX.2 32B、FireRed-Image-Edit 20B 等較大型開源系統競爭,但取捨是 Mage-VL 仍未完整開放,整個家族現階段更適合關注研究與工作流整合的人先行評估。

Super fast Image Edit model Mage-Flow on 8GB VRAM
  • 固定 4B 規模,主打可訓練、可微調、可部署
  • Mage-Flow 已覆蓋 text-to-image 與 instruction-based image editing
  • Mage-VAE 以更低 encode/decode MACs 減輕高解析度瓶頸
  • 單一 checkpoint 支援 512–2048 與多種 aspect ratio
  • Turbo 版本強調速度,1024² 在單張 A100 有明確推理數字

部署與測試方面,現有資料顯示 Hugging Face 已提供多個 Mage-Flow 與 Mage-Flow-Edit 權重,適合先用現成 checkpoint 驗證生成、修圖與速度,再決定是否進一步做微調。對做垂直領域影像項目、想研究後訓練方法,或者需要把高解析度生成放入較實際算力條件的人,Mage 的吸引力不在花巧包裝,而在它用一條輕量路線,把研究、性能與部署成本拉回較平衡的位置。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Stable Diffusion, Video, Image, 影像模型, 影像處理, txt2img, Medical醫學

ReDesign 把平面圖轉為可編輯設計

ReDesign想做的,就是把一張匯出圖,文字、圖層轉成獨立像素圖層結構,重新變成可編輯設計。

Repository image for jintae-00/ReDesign

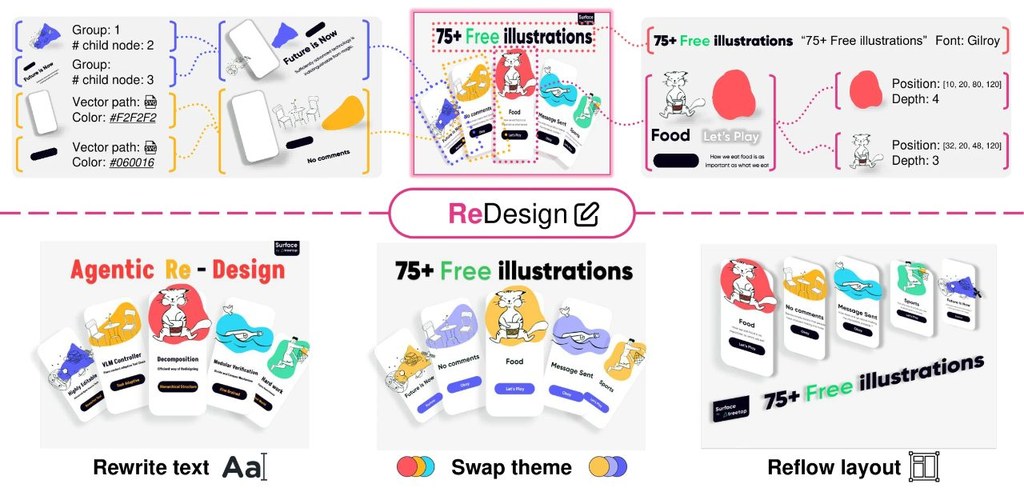
設計原檔遺失之後,最麻煩唔係畫面睇唔到,而係改唔到字、拆唔開圖層、調唔到前後次序。ReDesign屬於Agentic取向的研究型工具,目標係由單張 raster image 重建出可編輯設計結構,輸出成帶有文字、向量形狀、群組同 z-order 的 JSON hierarchy。

它的判斷方式唔係一次過猜完整個版面,而係將設計當成 layer tree,由大區域開始逐層拆細,再用 verifier 檢查每一步成唔成立。呢個取向比起只做 OCR、只做分割,或者直接做多圖層分解更完整,代價就係系統較重,亦要配合多個視覺工具同較高 GPU 記憶體,當中 Qwen 相關 worker 官方已寫明大約要對應 55 GB 級別資源先容易跑得順。

相關模組之間的分工幾清楚:VLM controller 負責揀動作,文字會交由 PaddleOCR、字體辨識、Hi-SAM 同 LaMa 處理;物件與圖層則會用到 Qwen-Image-Layered、GroundingDINO、SAM 2、connected-component analysis 同 VTracer。換句話講,呢個項目唔係單一模型,而係把多個模型與工具串成一條可驗證的還原流程,較適合研究設計還原、可編輯圖形生成,或者想將靜態素材重新帶回設計工作流的團隊。

  • 單張平面圖可還原成可編輯 JSON hierarchy
  • 支援文字、向量形狀、圖片、群組與 z-order
  • 採用 coarse-to-fine tree expansion,加上 verifier 修正分支
  • 效能展示基於 Figma-909,指標上普遍優於多個 baseline

評測方面,項目頁面列出 Figma-909 這個 Dataset 數據集,並顯示 ReDesign 在 L1、PSNR、LPIPS、PQ 同 F1 等指標整體領先 baseline,說明它唔只重建外觀,亦較重視元素級別的可編輯性。儲存庫已提供 agent、baseline 同工具後端結構,但它更似一個研究系統而唔係輕量腳本;較值得留意的是多 GPU 分片、平行 worker 同視覺工具的資源安排,較適合有運算環境的研究者或產品團隊深入測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 視覺模型, 多模態模型, Qwen, Image, 影像處理, Dataset 數據集

Wonder:Adobe 把影片變成可探索世界

輸入一張圖或一段片,Wonder會延伸出可持續探索的互動場景。重點不只係生成畫面,而係鏡頭移動之後,世界仍然記得之前見過嘅內容。

huggingface logo

由一張圖片或一段影片出發,Wonder會建立一個可以邊走邊看的互動式 Video World Model,處理的是「鏡頭一直移動,但場景仍要連貫」這個難題。你向前推、左右轉,甚至回到之前看過的位置,畫面都要盡量保持幾何、外觀同動態一致,而唔係每一格重新幻想一次。

呢個項目吸引的地方,在於它兼顧了互動感同穩定性。官方資料指出,Wonder支援 image-to-video 同 video-conditioned generation,提供 6-DoF camera control,並以接近固定延遲維持最長一分鐘的探索;對想做可遊走場景、遊戲世界原型、動畫預覽,或者互動式視覺敘事的人來講,呢種體驗比單次生成短片更有用。

為咗令鏡頭控制唔只停留喺抽象指令,Wonder把相機平移與旋轉轉成可對齊畫面的密集視覺證據,再配合 3D scaffold 同 environment map 去建立可導航空間。它亦保留完整歷史的 KV caches,再用 sparse attention 抽取相關記憶,令系統可以在不明顯拖慢回應下,維持較長距離的一致性。

  • 支援 I2V+V2V multimodality,可由圖片或影片開始生成互動世界
  • 提供 6-DoF camera control,重點是可探索而唔係只看固定鏡頭片段
  • 以 sparse attention 配合完整歷史記憶,改善長時段連貫性
  • 官方展示為 16 FPS rollout,頁面上的 32 FPS 影片屬線性插幀後處理

訓練部分用了 Mixture-of-Students 設計,並以 GAN Control Regularization 處理蒸餾時的 camera drift,目標是同時保住控制能力同長期一致性。現階段公開資訊以示範與技術報告為主,Code 同 HuggingFace 尚未釋出;不過單看定位,Wonder已經清楚指向一類更接近「可互動世界」而唔係「一次性影片生成」的世界模型方向。

項目主頁

Categories: 開源, 視頻模型, 世界模型, 模型訓練, Video, Image, 3D

quote-and-retrieve:用「引文+檢索」的視覺文件理解

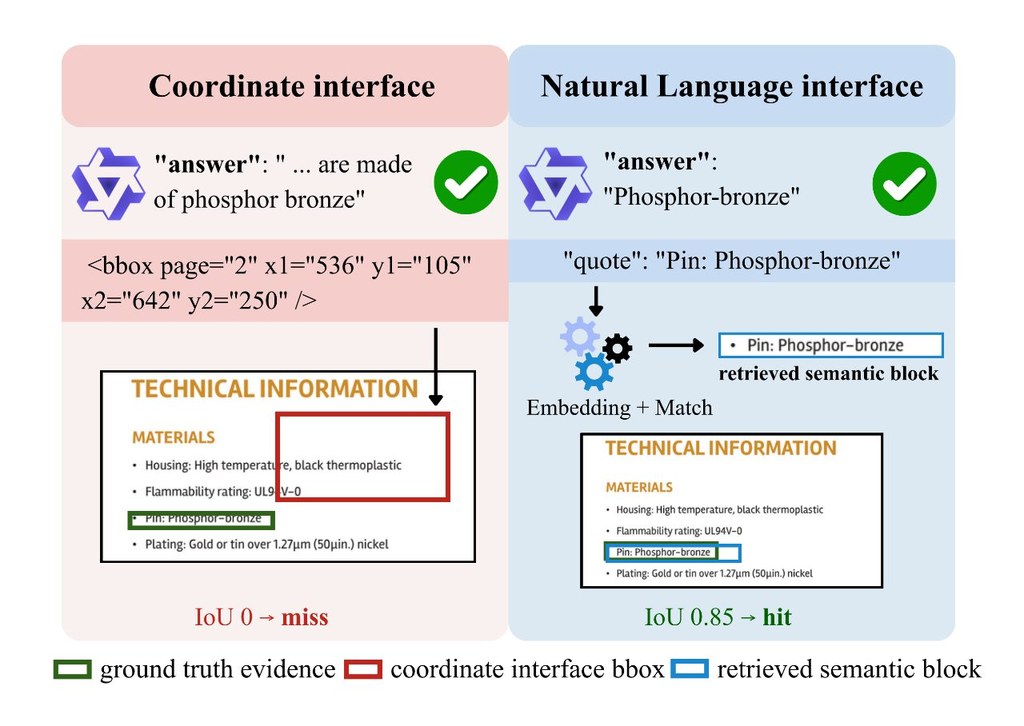
你可以把它理解成:當 VLM 答對問題卻指錯位置,問題未必出在模型,而是出在要求它輸出座標這種介面設計。換成「引文+檢索」後,歸因召回率翻倍,幻覺率近乎減半。

Repository image for Ryenhails/quote-and-retrieve

視覺語言模型 (VLM) 讀完文件回答問題時,傳統做法會要求它同時輸出 bounding box 標註證據位置;然而開源模型經常「答對但指錯」,這現象被稱為 Attribution Hallucination。這個來自赫爾辛基 Aalto 大學的開源項目主張,問題癥結很大程度是輸出介面本身的限制,而非模型缺乏 grounding 能力。

他們設計了一組控制變量實驗:固定模型、輸入頁面、題目與評分機制,僅改變證據表達方式。座標介面要求模型逐 token 生成框;語言介面則由模型輸出逐字引文,再交由外部 layout parser 與 retriever 找回對應區域(表格與圖片透過 caption 或註解引用)。在四個家族共六款開源 VLM 上,evidence recall 由座標介面下最高 8 分躍升至語言介面的 26 至 47 分,hallucination rate 近乎砍半,而答題品質幾乎不變。

基於這個對比,作者進一步提出 region-label-free GRPO 訓練方法:獎勵訊號只讀取 gold answer 與檢索區域的裁切圖,毋須任何 region-level 標註。8B 模型在這個框架下,strict attributed accuracy 由 22.4 提升至 33.8,等於用更便宜的監督換到明顯的歸因改善。

對於處理長文件、多模態表格或需要可追溯證據鏈的團隊(例如文件審核、研究文獻回顧)來說,這條 quote-and-retrieve 路線既繞開昂貴的人工框標註,也避開模型不擅長的座標生成。想要快速感受差異,只需 clone 項目後執行 python src/score_citevqa.py examples/sample_predictions.jsonl 與同一指令對座標版本跑一次;附帶的範例檔只有四題合成題,卻已重現論文核心發現。

重點摘要:
– 問題重新定位:歸因幻覺多屬輸出介面產物,並非模型能力不足
– 介面切換:座標介面換成引文+外部 retriever,evidence recall 由 ≤8 升至 26–47
– 訓練替代方案:region-label-free GRPO 用 gold answer+裁切圖作獎勵,毋須昂貴框標註
– 規模效益:8B 模型 strict attributed accuracy 由 22.4 提升至 33.8
– 快速驗證:附範例 JSONL,無需 GPU 即可重現對比結果

GitHub · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, Clone, Python

Galahad:12B 凍結模型零解碼作答的工業經驗

你可以把它理解成:模型不重新推理,而是直接重用已驗證過的求解結果,每次都一模一樣,而且不耗 GPU。

Repository image for corbenicai/galahad-bench

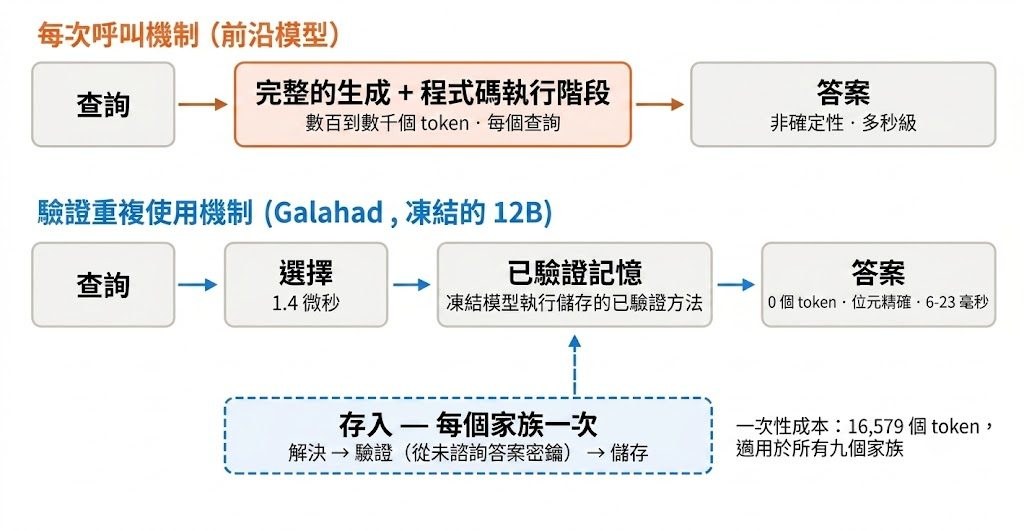
這套 Galahad 系統背後的關注點很直接:今天要提升語言模型,就要重訓練,每次都得重新生成答案,既貴又隨機。他們選擇反向操作——模型參數完全凍結,只在旁邊持續累積已驗證的解題記憶。同一個 12B 模型,對於已處理過的題目家族,直接命中記憶中的求解器,整數級精確一致,每次結果都完全相同,而且生成 token 數為零;對於新題目,則照常從零推理解答。系統聲稱在 180 個全新題目、橫跨九個題目家族上,讓四個來自不同供應商、架構各異的開源模型全部拿到 180/180,並且每次回答都不耗任何生成 token。

這個做法最值得留意的,是它對「記憶」一詞的重新定義。系統內部存的是可被獨立外部 oracle 自動驗證的執行式解題結果,不是用相似度檢索找出來的近似片段。作者在特別批評了業界慣用的近似向量相似度檢索:在一個 4,500 條已驗證答案的庫上,這種方法有 94.3% 機率選錯項目,而精確定址則零錯誤。換句話說,對於可驗證、可執行的知識,相似度近似檢索不是表現稍差,而是幾乎不可用,精確定位是必須的設計前提,不是可選偏好。

對於要部署閉環計算、形式化證明、程式碼執行這類可驗證任務的團隊,這套思路很有吸引力:記憶檢索耗時約 1.4 微秒,完整重用流程 6 至 23 毫秒,每次重用只耗 36 毫瓦時電力,相對於一次性求解兼驗證所需的 81.1 瓦時,節能差距明顯。模型本身不重新訓練,能力靠記憶累積,這對想控制運算開支、又需要可重現輸出的場景,例如 CI 中的程式生成或單元測試,是務實的取捨。

但限制也要看清楚:作者指出在公開基準的從零推理上,前沿模型依然遠勝任何 12B;Galahad 的強處是對「已被系統解決並驗證過」的題目家族做到零成本重用,不等於通用智能提升。負面控制也排除了另一種解釋——把記憶清空,系統一道也解不出來,這進一步確認能力確實來自記憶層,不是模型本身突然變聰明。對於想關注的是開源權重能否落地到工業管道的讀者,這份來自 Corbenic AI 的工業經驗報告值得留意,因為它把「訓練之外如何持續累積能力」這條路寫成了可量化的章節。

  • 模型凍結,能力改由外部已驗證記憶承擔,180 題零 token 滿分
  • 精確定址取代向量相似度檢索,在 4,500 條庫上錯誤率 94.3% 對 0%
  • 重用耗時 6–23 毫秒、每次 36 毫瓦時,對比一次性求解 81.1 瓦時
  • 開源模型架構無關:四個不同 dense 與 MoE 模型皆達 180/180
  • GitHub 目前僅放測試頁占位,引擎源碼尚未公開釋出

GitHub · Paper

Categories: 開源, Qwen, DeepSeek, Gemini, 框架, Dataset 數據集

Page 28 of 92
1 26 27 28 29 30 92