VideoCoCo 先用代碼演物理再出片

想要影片動得合理,又唔想一開始就靠像素生成碰運氣,VideoCoCo提供咗另一條路。它先把物理過程寫成可執行草稿,再交畀影像模型做寫實化。

cot paradigm

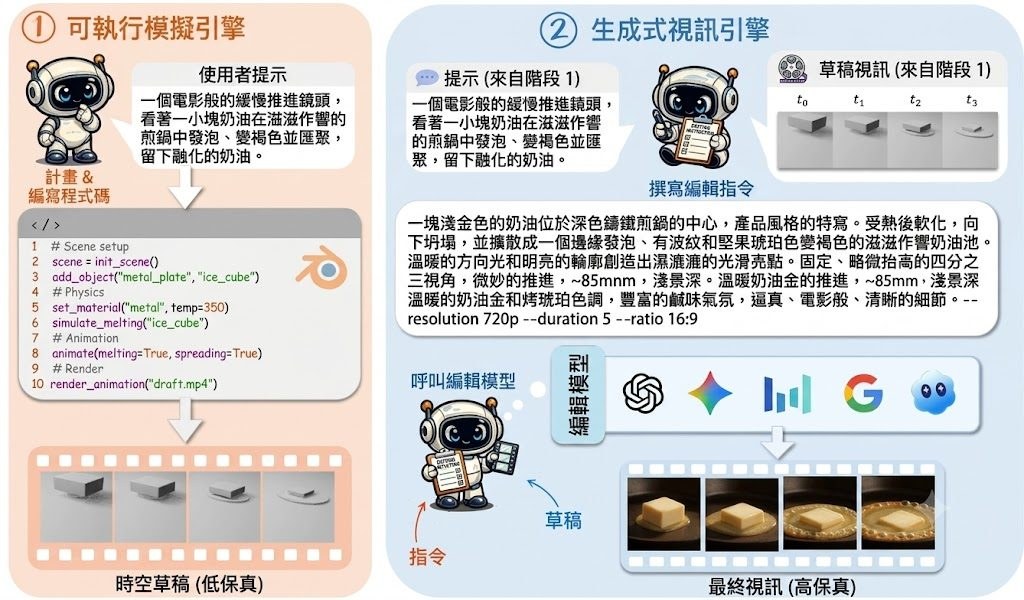
一段影片要做到「似真」並不只靠畫面細緻,動作因果同物理變化站唔站得住腳更關鍵。VideoCoCo屬於視頻生成管線,處理的正是這個問題:先用 code as a chain-of-thought 寫出物理草稿,再把中性白模影片轉成寫實結果,減少模型直接由像素猜測運動時常見的失真。

VideoCoCo 不是一步生成最終影片,而是先由 code agent 產生 Blender 可執行模擬,輸出灰白、近似 clay render 的 proxy video,讓形狀、透明度、變形、遮擋與運動先承載物理意義,之後再檢查這段草稿是否符合 physical plan,最後才用編輯指令把 proxy restyle 成 photorealistic video。這種雙階段流程換來較強的可控性,但也代表整體鏈路比單段式生成更長,對中間草稿品質有依賴。

目前 GitHub 已放出五個 Agent Skills、batch inference 腳本、對上游 OmniWeaving 的 patch,以及 Hugging Face 上的 tuned transformer;另有 8 組 hand-checked 的 video-to-video triplets 可用來理解資料格式與輸入輸出關係。README 停在 Inference 章節開頭,未見完整安裝與執行細節,所以現階段較適合把它視為可檢查流程設計與推理組件的研究型項目,而不是即裝即用的成品。

  • 先做物理草稿,再做寫實化,把運動因果同畫面風格拆開處理
  • 以 Blender 可執行代碼承載 process-level CoT,重點不在文字解釋,而在可驗證的模擬結果
  • toy dataset 只有 8 個案例,涵蓋 buoyancy、melting、surface tension、boiling 等現象,較像格式樣本
  • 已提供 tuned transformer、inference 腳本與 OmniWeaving patch,但公開資訊未足以完整重建部署流程

受益最大的會是研究 Agentic video generation、多步驟 controllable generation,或者想把物理先驗帶入視頻模型工作流的團隊。現有資料未見完整量化指標或大規模評測結果,優勢主要來自方法設計與中介表示的可檢查性;想判斷生成穩定度與泛化能力,仍要等更完整實驗或自行測試。
項目主頁 · GitHub

Categories: 開源, Agentic, 視頻模型, Video, Dataset 數據集, Skill 技能

RefCaptioner:參考圖綁定對應影片字幕

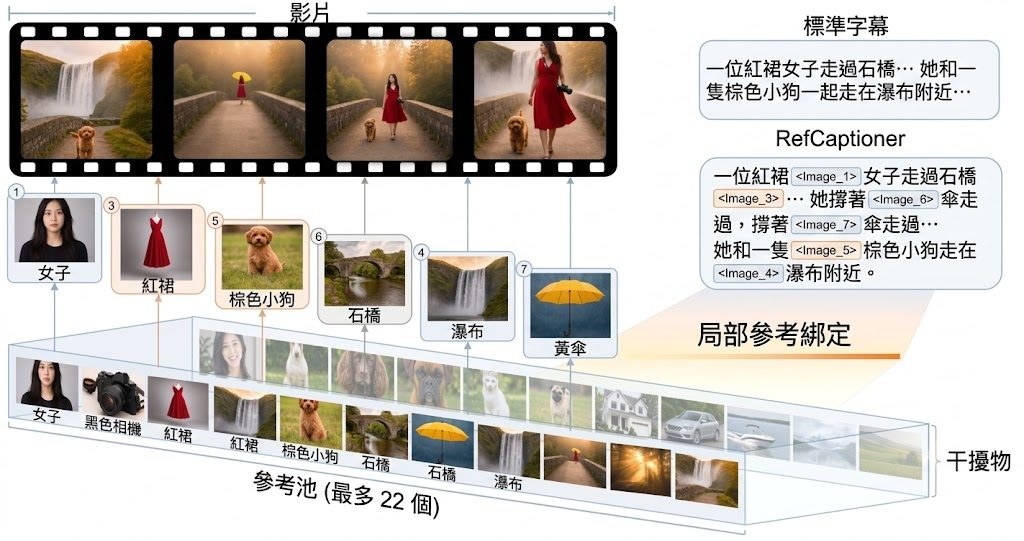
RefCaptioner唔只寫影片字幕,仲會清楚標示句中描述對應邊張參考圖。對要處理多視角人物或混入干擾圖的情境,呢種做法實用得多。

RefCaptioner grounds local caption phrases to relevant reference images while rejecting distractors.

做影片描述時,最易出錯唔係句子寫得唔夠長,而係講到某個人、物件或角度時,無法交代文字究竟對應邊張參考圖。RefCaptioner屬於影片字幕生成模型項目,集中處理 multi-reference image-grounded video captioning:一邊保留細節與事實準確度,一邊將局部描述同候選參考圖明確綁定。

RefCaptioner 不只是把所有參考圖塞入輸出,而係會挑選真正有用的圖,將對應片語加上 <Image_N> 標籤,遇到同一主體的不同視角又會做分組,影片根本無出現的內容就直接略過。呢種設計減少錯配同誤導,比起只追求流暢字幕,更著重可核對性。

技術上,RefCaptioner用兩段式 post-training。先以 capability-preserving SFT 學會 grounded caption 格式,同時盡量保留一般 captioning 能力;之後再用 Hierarchical Coverage-Discounted GRPO(HCD-GRPO)同時優化 factual-caption 分支與 multi-reference grounding 分支,並加入 deterministic guards,避免產生格式錯誤或指向不存在圖片的標籤。

  • 提供官方 inference pipeline、SFT 資料準備、HCD-GRPO 訓練同 MRVBench evaluation pipeline
  • 已公開論文與模型權重,亦有 Data Format、Training、Evaluation 文件可跟進
  • 環境分成主環境與 GRPO 專用 veRL/vLLM 環境,代表訓練流程較完整但配置亦較講究
  • 適合做影片理解、資料標註、多鏡頭人物敘述同需要檢查圖文對應的研究團隊

部署與測試:推理、SFT、評估共用主環境,GRPO 另設一套環境,並且要對指定 veRL 版本套用 patch,反映佢較偏研究型工作流,而唔係下載即用的小工具。效能數字在提供的內容未見完整展開,但既然已附 MRVBench evaluation pipeline,至少表示作者有把「字幕寫得對」同「圖文對得準」分開檢驗,較適合重視可解釋輸出的團隊採用。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Video, Image, 影像模型

MPIE-Bench:多人修圖基準

多人影像編輯最易出事的,往往不是畫質,而是人物關係、肢體接觸同身份一致性。MPIE-Bench 把這些難題拆開量度,適合用來判斷模型到底可靠到哪一步。

apple pie icon

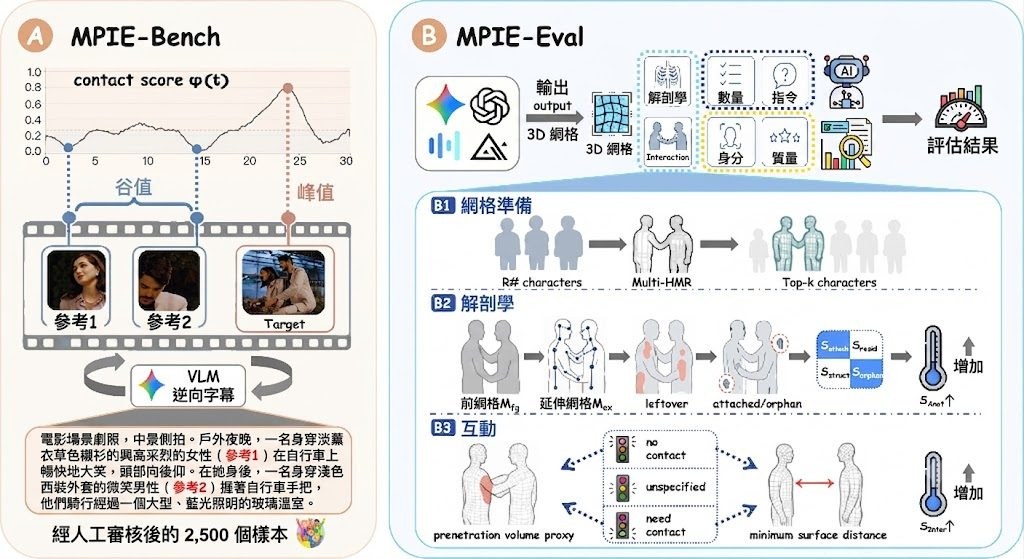
當多人影像編輯開始涉及互動動作、身體接觸,例如擁抱、攜帶或擒抱,同多角色參考圖,模型最常翻車的地方就不只是一張圖靚唔靚。MPIE-Bench 屬於基準測試資料集與評分工具,焦點是檢查編輯模型能否在跟從指令之餘,同時保住人物數量、身份一致性、肢體結構同互動幾何是否合理。

MPIE-Bench 不是再做一個生成模型,而是替多人編輯建立較完整的檢查方法。測試集有 2,500 個案例,並按接觸密度分成 C0 到 C3,意思是由沒有接觸到高密度接觸場景都會覆蓋;這種切法有助分辨模型是單純怕多人,還是特別怕擁抱、扶持、碰撞這類複雜互動。

評分設計亦有取向。六個軸線,除了身份、指令遵從、人物數量與整體畫質,亦把 anatomy 和 interaction 拉成重點,並用 mesh-anchored Anatomy / Interaction 來處理較難主觀判斷的部份。對研究團隊或做產品評測的人來說,這比只看美感分數更有參考價值,因為它直接對應多人編輯最容易出錯的位置。

  • 官方提供 2,500-sample test set、evaluation protocol 同 scoring code
  • 重點量度多人編輯中的身份保持、人物數量、動作互動同整體質素
  • 測試案例按接觸密度 C0–C3 分類,方便看清模型失誤模式
  • 可把模型輸出放到指定資料夾,再跑 E2E scorer 完成整體評分

部署資訊已有基本方向,安裝細節放在 docs/INSTALL.md,而且評分流程需要額外權重、環境設定,以及 AI_GATEWAY_URLAI_GATEWAY_KEY 等配置;單靠儲存庫首頁未足以完整重現全部步驟。另有三個 closed-source baseline 的 frozen judgments,可作對照,但 open-source model dumps 沒有公開,這表示它更適合拿來評測自己的輸出,而不是直接比較所有現成模型結果。

對開發多人影像編輯、角色一致性編輯,或要驗證 VLM、影像生成模型在複雜人物互動表現的團隊來說,MPIE-Bench 的價值在於它把「多人」這件事拆成可追蹤的失敗類型。它未必能代替最終人工審美判斷,但很適合放進模型迭代流程,幫你更早發現哪些能力其實只在簡單場景先成立。

GitHub

Categories: 開源, 視覺模型, 影像處理

PALATE 改寫角色扮演 AI 才算演得好

現有角色扮演評測用固定對話歷史加統一評分尺,難以反映真實用戶體驗。PALATE 改為訓練專屬用戶模擬器並生成個人化評分準則,讓評估貼近每個用戶的真實感受。

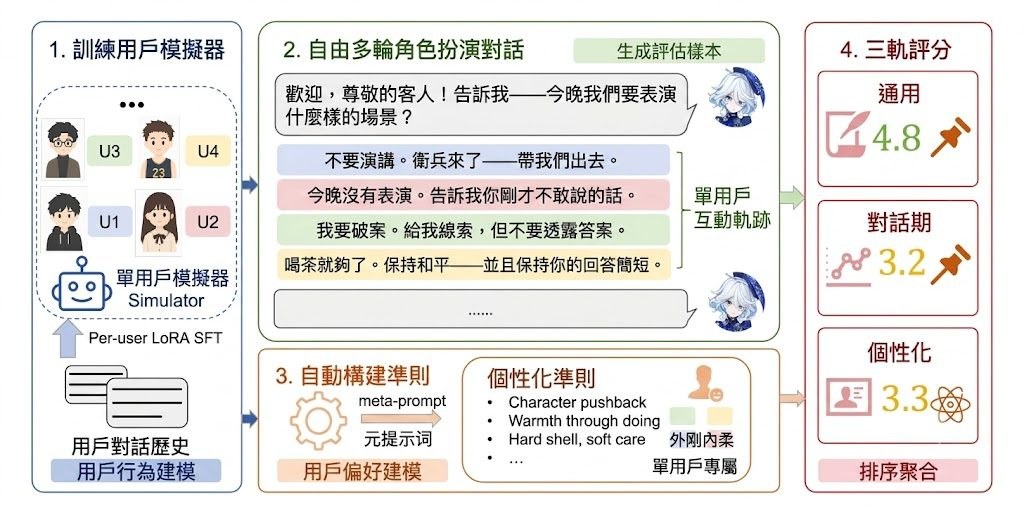
Overview of the PALATE evaluation pipeline

PALATE(Person-Aligned LLM-Simulated-User Assessment with Tailored Evaluation)的核心做法,是為每位參與者訓練一個專屬的 LoRA 用戶模擬器,讓模擬器和候選角色扮演 AI 自由多輪對話,再從該用戶的歷史數據自動生成一套個人化評分尺。評估拆成三條軌道:針對特定用戶–AI 配對的個人化體驗品質、跨用戶通用的回合級角色扮演品質,以及整個對話過程的連貫性與發展。

角色扮演 RPAs(Role-playing agents ) 的表現好不好,往往不只是模型本身的問題,而是和它對話的那個用戶決定。現有基準普遍要求模型接續一段預寫好的「借用對話」,再用統一的評分尺去評那段回應,結果把模型能力、前置對話品質、個人偏好混在一起打分。中國科技大學與 MetaStone 的團隊指出,這種做法忽略了用戶之間的巨大差異,也無法在真正的多輪場景下做科學評估。

團隊用 16 個候選系統生成 1,600 條獨立軌跡進行評測。個人化軌跡上,Qwen3-Max 領先;GPT-5.4 在通用軌跡表現最佳;Claude Sonnet 4.6 則主導會話軌跡。值得注意的是,沒有任何模型在所有五位用戶上都勝出,反映出個人化評測的必要性。個人化評分尺與人類判斷的一致性達到 0.613,高於通用評分尺。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 框架, 中國, Dataset 數據集

SpatialCLI 用空間工具補強視覺推理

模型唔係睇唔明圖,而係成日差半步先答得準。SpatialCLI 想補上的,正正係定位、分割、深度與姿態判斷呢類容易失手的細節。

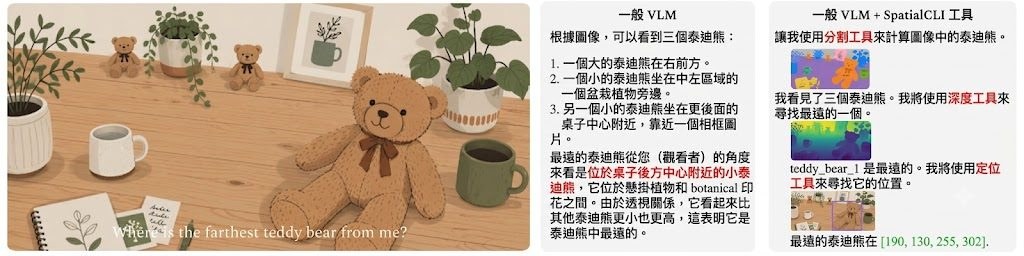
A comparison between a general VLM and a general VLM augmented with SpatialCLI tools

一到要指出物件位置、分清遮擋關係,或者估計深度與姿態,純 Vision-Language Model 往往會答到有方向但未夠準。SpatialCLI 把呢個落差處理得幾直接:它不是單靠一個大模型硬撐,而是把空間能力拆開,先讓模型懂得呼叫工具,再進一步把這些能力學回自己身上;整體定位更像一個結合模型、工具鏈與訓練方法的研究項目。

它最有意思的地方,在於三段式 Call-Learn-Internalize。第一步先接上做 localization、segmentation、metric depth、pose 的 specialist vision models,第二步用 Cold-Start SFT 與 agentic RL 訓練模型判斷幾時要用哪個工具、怎樣整合結果,第三步再把成功軌跡轉回模型能力。取向很清楚:寧願先借助外部工具拿到更可靠的局部感知,再追求把能力內化,減少每次推理都依賴外掛模組。

對研究團隊或做多模態 Agentic 工作流的人來說,這個項目值得留意,因為它同時放出 SpatialCLI code、SpatialCLI-8B 與 SpatialCLI-Data,不只是概念展示。理解它的部署方式也不難:代碼庫負責工具調用與訓練流程,Hugging Face 上的模型與資料集則對應推理、微調和重現實驗的核心材料;要完整驗證效果,通常要連同外部空間工具一併配置。

  • 類型上屬於模型加框架的研究項目,目的是提升多模態模型在空間推理上的準確度與工具使用能力。
  • 重點不只在「可呼叫工具」,而是進一步把工具使用經驗轉化成模型本身的能力。
  • 已公開論文、SpatialCLI-8B 與 SpatialCLI-Data,方便重現與延伸訓練。
  • 適合要處理定位、分割、深度、姿態等視覺任務的人員參考其工作流設計。

現有資訊未見 README 完整列出量化結果細節,但評測章節與 specialist models 章節已預留,顯示作者不是把它包裝成單一模型升級,而是把「何時調工具、如何學會不用工具也保留能力」當成核心問題。這種做法的代價也很明顯:系統整合與訓練鏈會比單純跑一個 VLM 複雜,不過換來的是更貼近真實空間任務的推理穩定性。

GitHub

Categories: 開源, Agentic, 視覺模型, 多模態模型, 影像處理

OmegaUse-OfficeVal 量度 Office 代理能力

想比較 LLM agents 做 Office 工作交付得好唔好,單靠主觀打分唔夠。OmegaUse-OfficeVal 用可執行驗證器同經濟訊號,將評測流程整理成可重跑的框架。

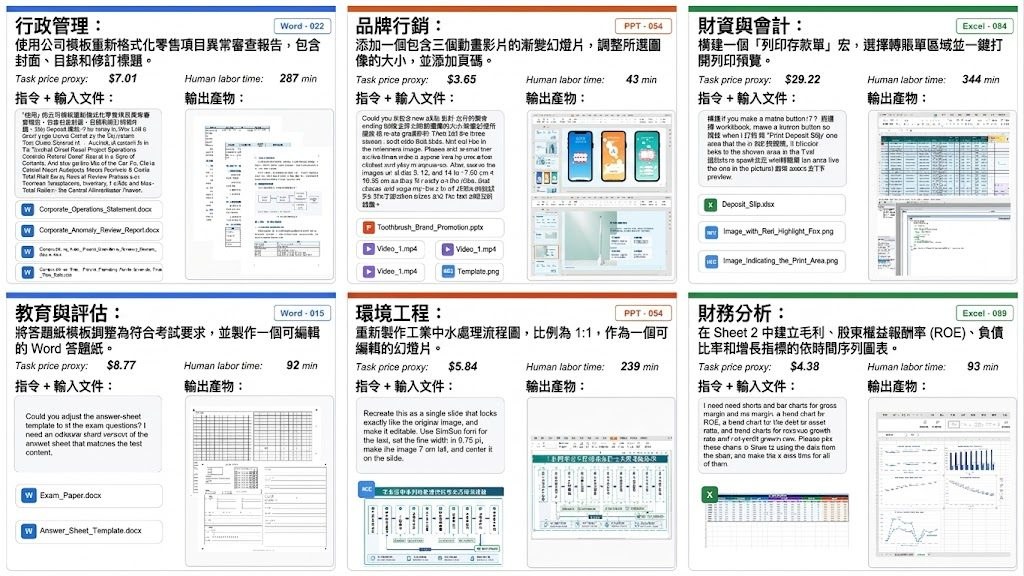
OmegaUse-OfficeVal benchmark framework

做 Office-suite 長流程任務,最難唔係叫模型產生文件,而係點樣穩定判斷交付物到底合格未。OmegaUse-OfficeVal 把這件事做成一個 Python 框架,同時連接 benchmark 思路與驗證流程:它收 ZIP 提交、先做安全檢查,再逐個執行 100 個 Office document evaluators,最後輸出 JSON 同 CSV 報告,適合用來評測 LLM agents 在 Office 任務中的完成度。

呢個項目的取向幾鮮明:重點唔放喺即場互動,而係放喺可重複、可審核、可批量執行的驗證。網站資料亦交代,OmegaUse-OfficeVal 對應的是一組有經濟 grounding 的長時程 Office-suite tasks,100 個任務平均要 2.32 小時人手完成,並附有人力時間與 task price proxy,方便把模型推理成本同人類成本放埋一齊看。相比只做最終分數排行,這種設計更接近團隊挑選 agent、比較交付價值時會遇到的問題。

它不是把資料集、提交內容同工作目錄全部包在倉庫內,而是把評測框架與 verifier source code 分開提供,benchmark data 另外發佈。Python 3.10 以上可跑,Windows、macOS、Linux 都支援 normal mode;其中 91 個 verifiers 可跨平台執行,另有 9 個 verifiers 依賴 Windows 上的 Office COM,相關環境未齊時會被跳過或只限指定平台處理。

  • evaluate(directory: str) -> dict 統一 100 個驗證器介面,方便批量評測與整合
  • 收件前先檢查 ZIP traversal、加密、大小、檔案數量與壓縮比,安全性考慮算完整
  • 每個 verifier 在隔離 subprocess 執行,可設定 concurrency 同 timeout,減少互相干擾
  • 輸出採用 machine-readable JSON、CSV,而且每個 verifier 各有結果,後續分析較方便

這個倉庫裡主要體現在覆蓋範圍與流程穩定性,而唔係模型速度本身:可見進度、目前 verifier ID、執行 channel 同耗時,對跑大批提交會實用。它更像一個面向 Agentic 評測、研究復現同內部驗收的基建項目;想測 Office 類代理,尤其想把安全收件、隔離執行、可讀報告放進同一條流水線,這個項目的完成度相當高。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 框架, Mac, Linux, Python, Dataset 數據集, 百度

HumanCLAW 直指 VLM 身體感缺口

當 Vision-Language Models 真正要控制一個會碰撞、會受重力影響的人形身體,表現遠比畫面理解困難。HumanCLAW 把問題拆開來量度,直接揭開 VLM 行動判斷的弱點。

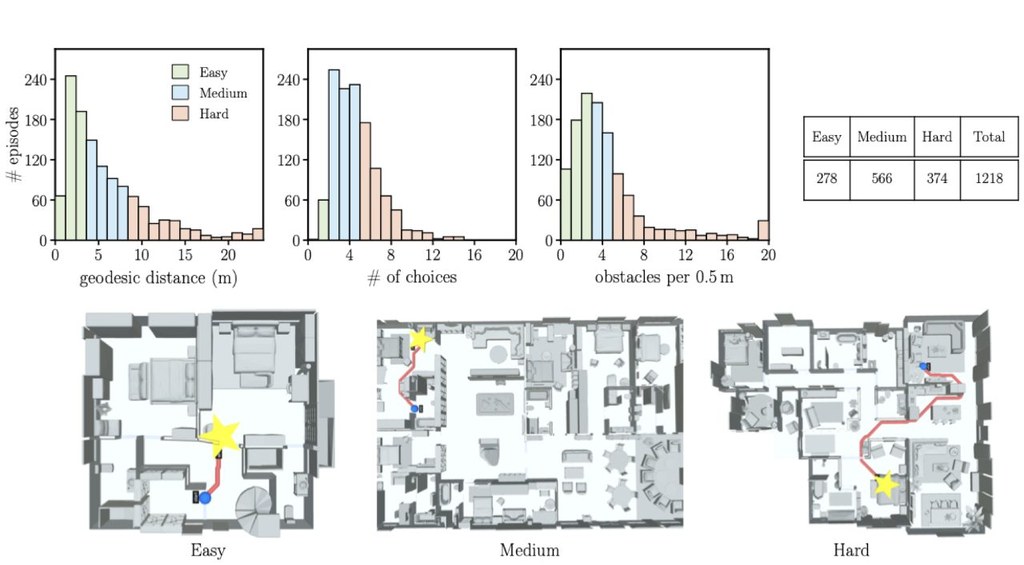
HumanCLAW teaser

畫面睇得明,不等於身體識得郁得啱。HumanCLAW 把 Vision-Language Models(VLMs)放進一個閉環人形行動測試環境,集中量度模型每個瞬間應該做哪個動作,而不是把失敗全數歸咎於低層馬達控制。它屬於評測框架兼基準測試項目,處理的是 VLM 在具身場景中的行動決策能力,到底有沒有足夠「身體感」去完成找路、移動與互動。

呢個設計最值得留意的地方,是它把 action decision-making 與 low-level motor execution 分開。每 0.5 秒,凍結的 VLM 只需要根據第一身視角、指令、技能列表與歷史內容,提出一個 atomic whole-body skill;後面的 verifier、motion generator 同 half-physics simulator 再負責驗證、安全過濾與連續動作執行,令接觸、碰撞、重力等物理後果仍然保留下來,但平衡失誤與動作追蹤誤差會被盡量排除。

HumanCLAW-Bench 則在這個框架之上提供 1,218 個長時程 find–navigate–interact episodes,覆蓋 41 個室內場景。數字相當直接:九個最先進 VLM 全部未能解決這套基準,最佳成績只有 16.8% success rate,反映問題不在單次辨識,而在模型持續追蹤自身位置、判斷是否到達目標,以及理解自己有沒有撞上環境。

  • 把高層決策同低層動作分離,較易睇清 VLM 真正弱點
  • 保留真實物理後果,唔會因為純符號化環境而高估能力
  • HumanCLAW-Bench 著重長時程、第一身視角、連續互動任務
  • 目前公開資訊顯示程式碼與 benchmark 仍在準備釋出

對研究 embodied AI、Computer-use agents 延伸方向、VLM 評測方法的人來說,呢個項目有參考價值,尤其適合用來檢查模型是否具備 closed-loop spatial action intelligence,而不只是識描述畫面。現階段較大的限制也很清楚:GitHub 儲存庫尚未正式放出 harness、motion generator weights、half-physics simulation environment 與完整評測內容,暫時主要仍是透過 project page、paper 同 leaderboard 理解方法與結果。

項目主頁 · GitHub

Categories: 開源, Agentic, 視覺模型, 多模態模型, Meta, Dataset 數據集, Skill 技能

SkillRise 把技能文件變成可累積學習

同一個策略連續解幾類相關任務,邊做邊整理可轉移的技能文件,正是 SkillRise 想處理的學習斷層。它不是只追單次成功率,而是想讓經驗在下一題繼續生效。

SkillRise method

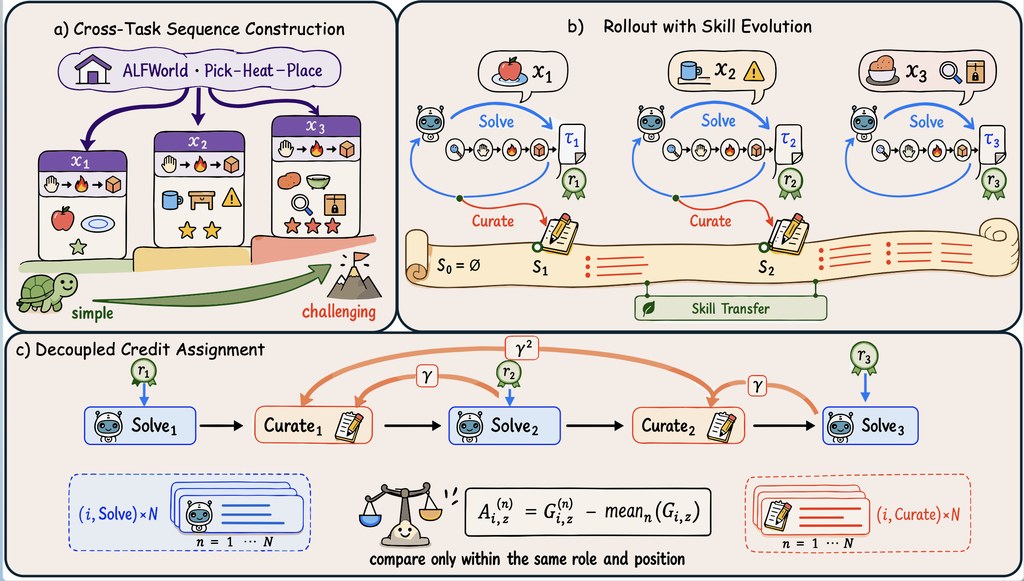
做完一題就把經驗丟掉,往往是代理系統訓練最可惜的地方。SkillRise 屬於強化學習框架,焦點放在 cross-task skill learning:讓同一個 policy 按次序處理同一家族的任務,一邊解題,一邊把軌跡整理成會持續演化的 skill document,將前一題學到的做法帶去下一題。

它的取向不是把每個任務分開訓練到最好,而是刻意安排由淺入深的任務序列,讓 Solve 與 Curate 交替發生。這個設計針對的是跨任務遷移能力,而不是單一回合表現;代價是環境設定與資料組織較講究,ALFWorld、WebShop 要跟隨 verl-agent 的環境配置,ScienceWorld 則沿用 BEACON 的 setup,並且要先整理模型路徑、資料路徑與追蹤設定。

README 提供了可直接對照的執行方式:同一套 examples 結構下,既有 SkillRise,也有 GRPO baseline,方便把新方法與基線放在相近條件下比較。模型部分從腳本名稱可見已準備 Qwen3-4B 配置,底層也建立在 veRL、verl-agent、BEACON 等現成項目之上,所以它比較像研究與實驗工作流的延伸,而不是即裝即用的產品。

  • 把「解任務」與「整理技能」拆成兩個交替角色
  • 用同一家族、逐步變難的任務序列測試技能轉移
  • 在 ALFWorld、WebShop、ScienceWorld 都有評估
  • README 明確保留 GRPO baseline 方便做對照

成果描述指向一個清楚結論:SkillRise 在 ALFWorld、WebShop、ScienceWorld 的整體結果最好,勝過 prompting-based methods 與 RL baselines。較適合研究 Agentic workflow、長程技能累積、跨任務學習的團隊;想觀察 skill document 如何影響後續決策的人,也會比只看最終分數得到更多訊息。

GitHub

Categories: 開源, Agentic, Qwen, 提示詞, Skill 技能

CodeNib 把代碼庫上下文交到 Coding Agent 手上

CodeNib 讓 Coding Agent 直接取用帶引用的代碼庫上下文,減少翻找檔案和拼湊脈絡的時間。它把同一份倉庫整理成多個視圖,再按需要供應給工具和介面。

CodeNib

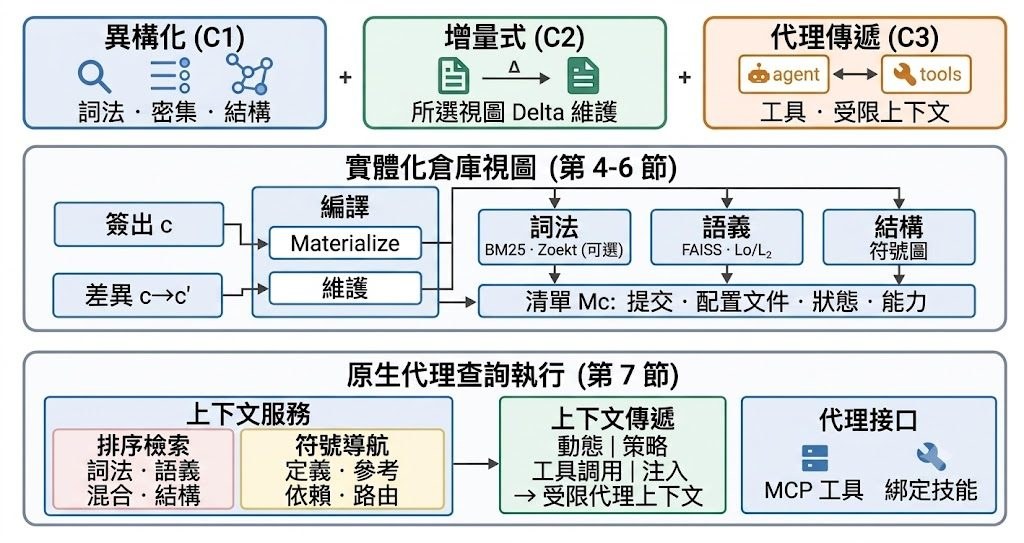
CodeNib 核心處理 Coding Agent 在大型項目裡最常卡住的問題:資料太散、脈絡太長、引用不清。它把倉庫編譯成 lexical、semantic、structural 同 static-navigation 多個視圖,再經 MCP、LSP-shaped providers、Python 或 HTTP API 交出去,讓工具直接拿到有來源位置的證據。

這個設計不只是做索引,而係重視增量更新同可追溯性。倉庫變動後,只會修補受影響的視圖;不適合保留的轉換才會重建。每個 view 都有獨立 manifest,記錄來源、狀態、能力同 artifact 位置,方便確認目前供緊咩上下文。

  • 主要解決 Coding Agent 讀懂倉庫時的上下文供應問題
  • 以 MCP 為核心接口,兼容 agent-native 工作流
  • Wiki、Ask view、Dependency Map 都係同一 runtime 的檢視層
  • 依賴 SCIP symbol resolution 生成 dependency map,唔靠模型猜測
  • 回答會附 file 同 line citation,方便核對

同類做法常見只係把檔案切片再丟入檢索,CodeNib 則把 lexical、dense、graph 同導航視圖放到同一個編譯流程裡。Docs 提到 live demo 支援 Python、C/C++、Go、Rust 同 TypeScript,亦展示咗一個針對 codebase 的實用取向,而唔係停留喺概念層面。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, API, Vibe Coding, Python, 編程

Temporal-Distance-JEPA 訓練世界模型能懂「時間距離」

香港浸會大學團隊把 JEPA 世界模型由「會預測」推近一步到「更識規劃」。Temporal-Distance-JEPA 針對離線示範缺少回報訊號的痛點,直接從軌跡次序挖出可用的進度成本。

Repository image for HKBU-KnowComp/Temporal-Distance-JEPA

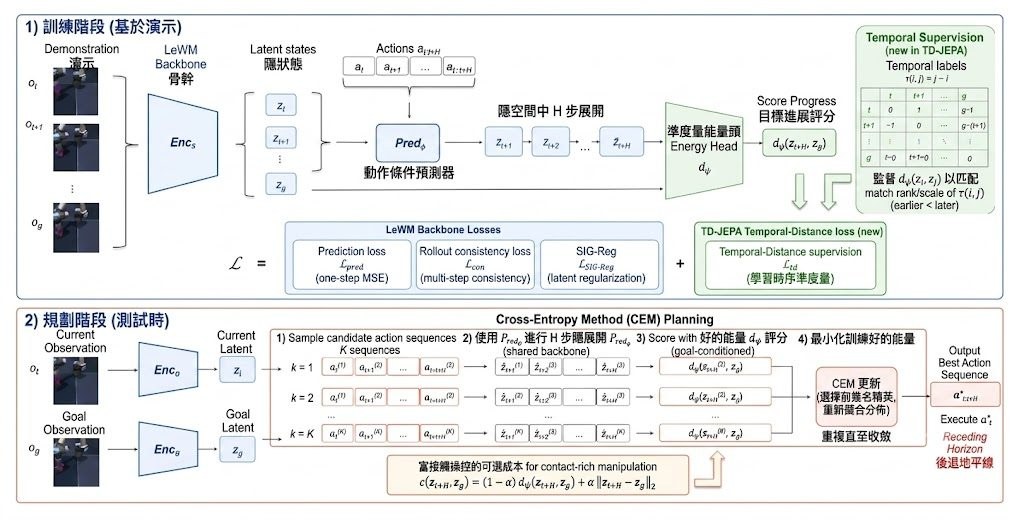
香港浸會大學 HKBU KnowComp 的 Jiaxin Bai 公開了 Temporal-Distance-JEPA 論文重現項目,核心不是再做一個更複雜的世界模型,而是修正 JEPA 規劃常見的落差:訓練時學短期 latent prediction,規劃時卻往往直接拿 latent Euclidean distance 當成目標進度。這個項目屬於模型研究重現項目,處理的是離線示範沒有 reward 時,planner 點樣判斷哪條想像路徑更接近目標。

作者保留 LeWM encoder–predictor 與 SIGReg backbone,但不再只依賴 embedding 幾何,而是從 reward-free demonstration logs 挖出 directed temporal cost。做法沿住論文邏輯很清楚:同一條 trajectory 的先後步序提供 positive targets,跨 trajectory 配對充當 heuristic negatives,再用 rollout-consistency 令學到的成本更貼近 planner horizon。這種 framing 直接回應舊範式把 latent L2 當成進度代理的限制,因為拓撲主導任務未必適合只看幾何距離。

結果在 Two-Room、Reacher 這類 topology-dominated tasks,規劃時直接部署 mined cost d_psi;到了 Push-T、OGB-Cube 這類 contact-rich tasks,則改用同一個 temporally trained checkpoint 上的 latent l2 planning。locked evaluation 下,Two-Room 成功率提升到 100.0%,高於 LeWM 的 97.4%;OGB-Cube 亦比 LeWM 高 14.2 分,並且整體上對 LeWM 與 RC-aux baseline 都能持平或更好。

  • 建基於 stable-worldmodel、stable-pretraining 與 LeWM 既有布局,重點在訓練目標與規劃成本的重新對齊
  • 公開庫是 paper-reproduction release,保留 Python CLI,但刻意不附 cluster/Slurm 包裝
  • 資料以 HDF5 形式放在 STABLEWM_HOME,涵蓋 Push-T、Two-Room、Reacher、OGB-Cube
  • 採用 10 epochs,並附有 locked results、cost matrix、diagnostics 等結果資料

這個庫比較像給已有研究工作流的人接手重跑:有 Python 環境、requirements、Hydra config、資料位置與 checkpoint 輸出方式,但沒有替不同排程系統準備現成封裝。歷史上的 contrastive SoftJEPA 相容程式仍可能留在 losses.py 或 jepa.py,不屬於公開配置;換句話說,閱讀與重現時要以 td_jepa 設定為準。對做 world model、offline RL、latent MPC 的研究團隊來說,這個項目最有價值的地方,是它把「表示學到什麼」與「規劃要怎樣排序未來」重新綁在一起。

GitHub · Paper

Categories: 開源, 浸會大學, Embedding, 世界模型, 模型訓練, 香港, Python, 中國

Page 27 of 92
1 25 26 27 28 29 92