DeepVoyager-VL 把視覺線索放回搜尋流程中

DeepVoyager-VL不只是睇圖再答題,而係會用新取得嘅視覺證據決定下一步搜尋。對長流程多模態檢索項目而言,呢個改動幾關鍵。

Comparison of multimodal search data synthesis paradigms

當一個多模態 agent 要連續查多步資訊,最易失準嘅位置往往唔係答題,而係中途搵錯線索。DeepVoyager-VL處理嘅正正係呢個問題:佢屬於長流程多模態 deep-search 框架,讓新取得嘅圖片證據直接影響下一輪檢索,而唔係只喺輸入開頭或答案結尾先用到視覺資訊。

呢種做法令佢同一般把視覺訊息包裝成前置條件嘅方法有明顯分別。DeepVoyager-VL背後用 EventVoyage-VL 生成帶有中間視覺依賴嘅長流程問題,再用整理過嘅 trajectories 做 Supervised Fine-Tuning(SFT),而唔加額外 reinforcement learning 階段;取捨好清楚,訓練流程較可重現,但效果仍然要靠資料合成質素同軌跡篩選撐住。

倉庫而家已經放出 paper、project page,同可重現嘅 Megatron SFT training bundle,亦提供 DeepVoyager-VL-8B 同 DeepVoyager-VL-30B-A3B 模型,以及 EventVoyage-VL dataset。想理解點樣驗證,最直接係沿住現成模型、資料集同訓練 bundle 睇完整流程;README 亦提到 SWIFT RUNTIME=bundled 會使用儲存庫內嘅 source trees,定位上比較接近研究與訓練復現項目,而唔係即開即用嘅消費級產品。

  • 核心改動:把 vision in the loop 放入搜尋中段,圖片可按需要先載入或裁切
  • 資料來源:EventVoyage-VL 先做 structure-before-language synthesis,再抽出可監督軌跡
  • 訓練路線:以 supervised-only 為主,冇再疊 reinforcement learning 階段
  • 結果:8B 同 30B-A3B 平均分別為 54.8 同 58.6,並在十個 benchmark 入面分別拿下八個同九個最佳成績

分數本身已經講到定位:DeepVoyager-VL不只是追求更大模型,而係想改善「見到新圖之後,下一步應該搵乜」呢個決策環節。較受益嘅會係做多步檢索、多模態問答、研究型 agent pipeline 嘅團隊;要留意嘅限制亦同樣直接,成效高度依賴合成資料點樣把中途視覺依賴編排得夠真實,離開相關 benchmark 之後,泛化深度仲要靠後續驗證。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 北京大學, 華為, Agentic, 模型, 多模態模型, 模型訓練, 框架, Dataset 數據集

MBM:跨類別動作轉移突破

你可以把它理解成一套跨類別影片動作轉移框架,重點是外形差很多時仍保住動作與身份。

Framework

想把一段動作搬到另一個角色或畫面,最怕形態差太遠時連身份都一併扭曲。MBM 走的是一套 motion transfer 研究框架,重點是把跨類別動作轉移做得更穩,讓 reference video 的動作可以連同 text,必要時再加一張 reference image,一起驅動生成。

它分兩段處理:Stage I 先學 heterogeneous abstract motion conditions,再 bootstrap cross-category motion pairs;Stage II 再用 raw reference videos 把這套監督內化。推理時直接靠 reference video、text 和 optional reference image,不需要 explicit motion extraction 或 test-time optimization。

它和只在相近外形之間搬動作的做法不同,目標是連 same-category、near-category 到 far-category 都盡量維持 motion fidelity 與 target preservation。資料同時提到 OpenVMT-Dataset 和 OpenVMT-Bench,前者是 instance-level motion-equivalent cross-content pairs,後者則用逐步拉大的 category gap 去測。

  • 兩階段框架先學抽象動作,再把監督內化到生成流程
  • 推理端直接吃 reference video、text、optional reference image,流程較短
  • 主打跨類別動作轉移,適合影片生成、角色動作遷移、動畫合成
  • 在大形態差距下仍可維持較好的動作保真與目標保留

項目主頁 · GitHub

Categories: 開源, 北京大學, AI productions, Video, Image, 框架

LeapTalk:1 步生成會話數字人

講人像相片同語音,就能連續生成對嘴影片。LeapTalk把速度拉到接近即時,同時盡量守住人臉一致性。

teaser

想做會話數字人?卡位通常唔係能否生成,而係夠唔夠快、個樣會唔會愈播愈走樣。LeapTalk屬於開源 talking-head generation 項目,針對的正是即時串流、人臉一致性同嘴型同步三件事一齊要兼顧的難題。

它的吸引力在於每個影片片段只用 1 NFE 就可推進,在 Lite 設定下標示可達 200 FPS,而且 Web Demo 已經做成可載入人像圖、用文字或咪高峰對話的介面。底層並非單靠硬推速度,而是建基於 SoulX-FlashHead-1_3B,再配合 LoRAaudio_proj_step_*.ptwav2vec2-base-960h,用 audio-driven classifier-free guidance 強化對嘴。

  • 以 chunk-by-chunk streaming pipeline 連續生成長片
  • Brownian bridgeBridge Forcing 減少長片身份漂移
  • README 已交代需另外下載 base model、語音模型與 LeapTalk 權重
  • 推論前要自行填入 COND_IMAGEAUDIO_PATH 等本地路徑

同類做法常見取捨是速度快但畫面累積誤差,或畫質穩定但延遲高;LeapTalk明顯站在「先把延遲壓到可互動」這一邊,再用 reference-anchored data-to-data transport 補回穩定度。

現適合做數字人互動、虛擬主播、即時內容生成的團隊。200 FPS 與單張 H200 GPU 的說法來自項目提供資訊,普通硬件能否複製同樣效果、Web Demo 的完整部署細節是否齊備,仍要等更多實測佐證。

項目主頁 · GitHub

Categories: 開源, AI productions, 數字人, 視頻模型, 影像處理, Audio

LongHorizon-Harness 解決代理在長任務時的錯誤

代理能否跑足幾十小時,關鍵唔只在模型能力,仲在狀態有冇走樣。LongHorizon-Harness把驗證、執行同任務延續拆開處理。

Install and run LongHorizon-Harness from the command line

當代理要橫跨桌面程式同 command line 連續做事,最易出問題唔係單步操作,而係中途記錯狀態、判斷錯進度,結果愈做愈偏。LongHorizon-Harness 針對屬於長時程代理執行與驗證工具,目標係令複雜任務可以被保存、核實,再一路推進到完成。

它唔係新模型,它主要協助 Claude Code、Codex、OpenClaw 之類 agent backend 上面處理 execution、state management 同 result verification。核心做法是 Manage-Execute-Audit (MEA) loop,把規劃、執行、審核拆成不同路徑,並把可信狀態獨立保存,減少單一長對話愈滾愈亂的問題。

  • 支援 Claude Code、Codex、OpenClaw,亦可配 Gemini CLI 與 mini-SWE-agent
  • 以獨立 audited state 推動下一步,而唔係只靠 session 內記憶
  • 可用單一指令啟動,每次執行會獨立保留 audit trail
  • 針對 WeaveBench、OSWorld 2.0、Terminal-Bench 2.1 這類長任務基準有公開成績

它在 WeaveBench 取得 80.7% PassRate、OSWorld 2.0 有 35.2% partial score,Terminal-Bench 2.1 success rate 為 77.2%。官方亦強調在相同 backbone 下,只換 harness,三個 benchmark 都向上走,反映改進點主要來自流程控制同驗證機制,而唔係模型突然變強。

呢種設計較適合需要長時間自動化處理、多步驟交接、又要追蹤結果可信度的團隊,例如研究、軟件測試、系統操作同複雜 office workflow。代價是流程比單純聊天式代理更重,審核與狀態管理會增加結構與成本,但換來的是更穩定的延續能力,同較容易追查每一步點樣做出來。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, 框架, OpenClaw, Anthropic, Dataset 數據集, MiniMax, Skill 技能

DEFT-RLVR 用延後曝光減少自動駕駛 VLM 誤判

自動駕駛 Vision-language-action models 唔少都會被正確軌跡「提示」到答啱。DEFT-RLVR想處理的,正是這種看似會推理、其實先知道答案的偏差。

Ground-truth trajectory exposure can induce post-hoc rationalization and hallucination.

自動駕駛 Vision-language-action models 一旦在推理前先見到真實未來軌跡,很容易把答案合理化,卻未必真係根據場景作判斷。DEFT-RLVR 屬於訓練與驗證框架項目,核心是把「先看場景作決定」同「之後再對照候選軌跡」拆開,減少 trajectory anchoring bias。

它的做法唔係直接生成開放式座標,而是先用 AD-MCQ 把規劃問題改成多選題,再用 DEFT 兩階段流程處理:模型先做 candidate-blind scene reasoning,之後先見到候選軌跡再揀答案。這種設計的好處,是答案可被精確核對;代價則是任務表述被收窄到候選集合之內,較接近「可驗證決策」而唔係完整路徑生成。

  • 針對的不是感知本身,而是推理監督被答案污染的問題
  • AD-MCQ 保留 braking、speed 同 lateral geometry 等差異,方便精確評分
  • DEFT-RLVR 用 GRPO 聯合優化,並且可選用 rubric 監督推理過程
  • RL 階段直接由 base VLM 開始,毋須 cold-start SFT
  • 模型採用 Qwen3-VL

部署門檻不算低。項目要求另行安裝支援 CUDA 的 vLLM,Waymo codebook reconstruction 還要額外用 Python 3.9 的 autovla waymo py39 環境;預設 recipe 亦明顯偏向大型多 GPU 節點,小型設備需要自行調整 tensor parallelism、batch size、sequence length 同 offloading。

目前公開資訊顯示,它在 AD-MCQ-500 上同時提升 trajectory selection 與 candidate-blind reasoning,較穩妥的判斷是:這套方法對研究自動駕駛 VLM/VLA 訓練可靠性、想避免「先知答案再解釋」的團隊尤其有參考價值;要落地到更開放的真實規劃流程,仍要看候選軌跡構建與算力成本能否接受。

GitHub

Categories: 開源, 視覺模型, 多模態模型, NVIDIA, VLA, Python

WorldExam:檢驗世界模型影片的反應力

它不只看畫面像不像,還會測模型能否保住世界一致性與反應。WorldExam 把世界模型影片拆成四層診斷。

WorldExam overview

WorldExam 把重點放在世界模型(world models)影片最常被忽略的地方:畫面好看之外,世界有沒有維持住,場景會不會對動作作出合理反應。它屬於基準測試項目,用來評估可控制影片生成在外觀、操控、空間一致性與內在反應上的表現。

它提供 1,474 個測試案例,涵蓋 camera-driven、action-driven、language-driven 三種控制介面,並劃分為四個診斷層次與八個任務。使用時可依照項目提供的測試案例與統一評估流程,檢查模型在不同場景、不同視角和不同互動條件下的穩定度。

和只看視覺質素或指令跟隨的做法相比,WorldExam 更在意模型有沒有維持空間一致性,以及能否推斷場景應有的反應。它把 scene revisit、terrain interaction、object interaction、social interaction 等情境都納入,適合做影片生成、世界模型、互動式內容與機械人視覺相關研究的團隊。

  • 同時測外觀、操控與世界反應,不只看畫面順不順眼
  • 支援三種控制介面,較貼近不同應用流程
  • 測試案例覆蓋室內外、3D render、電影鏡頭、動畫與 dashcam
  • 有任務級與整體指標,方便比較不同模型
  • 對想看模型有沒有「懂場景」的團隊特別有用

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 世界模型, 框架, 3D, Dataset 數據集

Poplar 把人像數據集生成變成可追溯流水線

想建立可重現的人像圖文數據集,難處往往唔係生成,而係點樣保留規格、來源同質檢。Poplar正正將呢三步串成可審核流程。

Poplar teaser

生成人像圖文數據集最易失控的地方,不在於出圖本身,而在於之後很難追查提示詞有冇被改動、畫面為何被淘汰、覆蓋範圍是否足夠。Poplar把呢件事做成一條開源流水線兼框架,專注處理 human-centric image-text dataset synthesis,將 Specify、Render、Inspect 三段分開,又用 append-only JSONL 記錄每一步。

它的做法幾務實:先抽樣人物、服裝、活動、場景、取景與光線等結構化屬性,再由 Qwen3.5-27B-FP8 把規格寫成攝影導向提示詞;之後用 Krea 2 Turbo 配合 Krea2-realism-V2 生成,每個規格只出一張圖,最後再由同一個 Qwen3.5-27B-FP8 檢查圖文是否一致、是否有明顯缺陷。重點不只是「生成到」,而是連 prompt hash、seed、重試紀錄、缺陷標記同審核時間都留底。

  • 適合研究團隊、數據工程、訓練視覺模型前的數據建設工作
  • 差異在於把語意覆蓋、渲染來源與質檢決策全部做成可追溯紀錄
  • 部署門檻不算低,已發佈排程要四張 NVIDIA GPU,並需相容 CUDA 12.6 的 PyTorch 環境
  • 質量控制包含保守式 deterministic prefilter,會重試近灰階、嚴重模糊、低細節或損壞輸出

跟只看單張生成效果的做法相比,Poplar更重視整批數據集能否重現與審核,取捨是硬件需求較高,流程亦偏向資料生產而非互動創作。現有資料未見完整基準分數,但它把審核 rubric、prompt mismatch severity、evidence 與 confidence 都納入 review records,對要建立可交付數據資產的團隊,價值相當直接。

項目主頁 · GitHub

Categories: 開源, Qwen, NVIDIA, Image, Python, Dataset 數據集

UEmbed:單一模型同時做稠密與稀疏檢索

UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,令稠密向量與稀疏詞彙向量可以一併輸出。對要做多模態搜尋或檢索增強生成的團隊,這種設計可減少來回切換模型。

Repository image for Alibaba-NLP/UEmbed

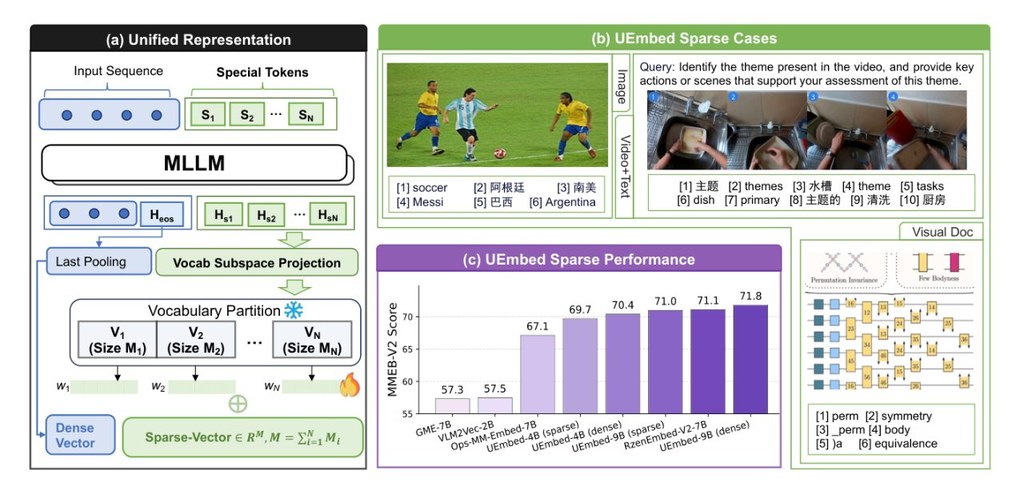
UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,它走的是多模態 embedding 模型路線,重點是把 dense 向量和 SPLADE-style sparse lexical 向量放在同一個 causal forward pass 內處理,方便直接做檢索、多模態搜尋和 visual-document retrieval。它不是只做文字匹配,而是把文字、圖片、影片與混合輸入統一到同一套表示空間。

直接取用 Hugging Face 上的 2B、4B、9B 權重,再按輸入格式送入不同媒體內容,檢查 dense 與 sparse 輸出是否符合預期。若要部署到搜尋系統,dense 部分可接向量檢索,sparse 部分可接倒排索引,兩條路可以同時保留。

它和傳統 learned sparse retriever 最大分別,在於保留 decoder-only multimodal backbone,並用 16 個 learnable special tokens 分攤稀疏詞彙空間,避開單一 token 的表達瓶頸。訓練時同時優化 dense InfoNCE、sparse InfoNCE 和 FLOPS regularization,取捨是結構較巧,但推理時可以用同一個模型兼顧語義召回與詞彙可解釋性。

效能方面,UEmbed-9B 在 MMEB-v2 取得 71.8(dense)與 71.0(sparse),並在公開數據訓練條件下做出很強的稀疏檢索表現;在 BEIR 上亦保持競爭力。對做搜尋、RAG、跨媒體內容索引,或者要把文字與圖像一齊納入檢索的團隊,這套做法會較有吸引力。

  • 同一個模型同時輸出 dense 與 sparse 表示
  • 支援文字、圖片、影片與混合輸入
  • 稀疏輸出可直接對接倒排索引,較易解釋
  • 以 Qwen3.5 multimodal backbone 為基礎,並用公開資料訓練
  • 2B、4B、9B 三個規模可選

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, RAG, Embedding, 模型, 多模態模型, Qwen, Image

MiniMax H3 萬眾期待的開放多模態模型

文字、圖片、影片同音訊都可混合輸入,再直接生成帶原生立體聲的短片。MiniMax H3把理解與生成放進同一套多模態系統,重點在跨模態一致性。

Og image

一段提示未必只得文字,亦可以連同圖片、影片甚至音訊一齊交畀模型處理;MiniMax H3就是朝住呢種工作流而設。頁面未提供 based onbase modelfine-tuned from 資訊,所以無法確認它係唔係建基於其他基礎模型微調而成,但已清楚標示為 image-text-to-video,而且屬於可同時理解同生成多模態內容的 generative system。

它處理的重點不只是由文字生片,而係把 text、images、video、audio 放入同一個上下文,再輸出最長 15 秒、最短 4 秒、可到 2K 的影片,並且附帶 native stereo audio。呢種設計的價值,在於畫面、聲音同指令可以一齊對齊,適合做 image-to-video、video-to-video、text-to-audio-video 以至 reference-to-audio-video 等任務,減少要分開串接多個模型的工序。

H3 是 task-generalization-oriented system,意思是模型在 pre-training 階段已經針對廣泛任務泛化而設計,唔係只為單一路徑生成。它強調 unified understanding of multimodal contexts,同時支援多種輸入來源與輸出規格;比例覆蓋 21:9、16:9、4:3、1:1、3:4、9:16 等常見格式,短邊預設 768 像素,最高可到 2K,反映它偏向面向內容製作與跨媒體生成,而不只是研究展示。

  • 支援 text-to-video、image-to-video、video-to-video,同時覆蓋 audio-video-generation
  • 可生成 4 至 15 秒影片,並輸出 native stereo audio
  • 輸入上下文可混合 text、images、video、audio,屬於 omni-modal 路線
  • Hugging Face 頁面標示 library_name: diffusers,代表可沿用 diffusers 生態整合

現階段較能確定的是,它把多模態理解與帶聲影片生成放入同一模型體系,對需要一致視聽輸出的項目有直接吸引力,但部署細節仍要等更完整技術文件補足。

項目主頁 · 模型

Categories: 開源, 多模態模型, 視頻模型, Video, Image, 影像模型, 影像處理, Audio, 3D, MiniMax

N0-TWAM 把觸覺帶進機械人決策

鏡頭睇到嘅畫面未必足夠,N0-TWAM連觸覺一齊預測,再生成動作。對接觸密集操作來說,這個方向比只看影像更貼近現場需要。

teaser

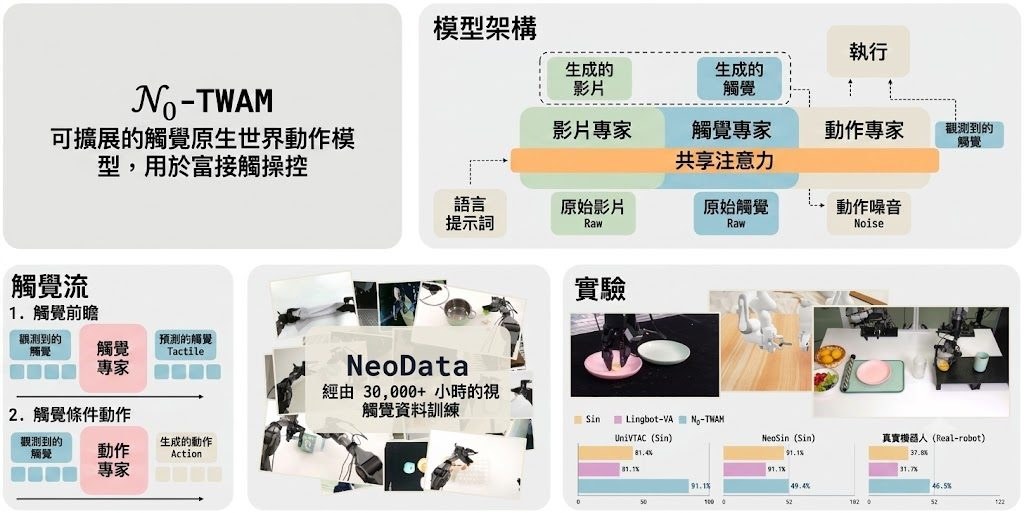
插頭有冇卡住、夾爪有冇真係受力,單靠畫面往往判斷唔完整。N0-TWAM放喺呢個空缺上處理問題:它屬於世界動作模型,將 vision、tactile 同 action 一齊建模,先推進未來會見到乜、摸到乜,再輸出低層動作,目標直指 contact-rich manipulation。

它吸引之處不只是多加一種感測,而係把觸覺當成未來狀態的一部分,而唔係事後補充訊號。相比只預測影片的 world-action model,或者直接由當前觀察回歸動作的 VLA policy,N0-TWAM更著重「預測之後再行動」;代價是系統更重,儲存庫亦只釋出 pretrained checkpoint、inference server 同 post-training toolkit,未包含大規模預訓練流程。

  • 可直接載入 pretrained checkpoint,再用自家 demonstrations 做 post-training
  • 可經 websocket 部署,由 observation 持續取回動作,也可接到自家 robot 或 simulator 做 closed-loop 控制
  • 支援 NeoSim 的 closed-loop benchmark,方便用 vision–tactile 場景驗證表現
  • 核心做法是 Mixture-of-Transformers (MoT),分開 video、tactile、action 三個 experts,再共享注意力交換資訊

模型背後沿用 WAN2.2 TI2V-5B video diffusion transformer 作 backbone,重組成三個 experts,並用 rectified-flow / flow-matching 目標聯合學習。readme 亦交代 action space 是 20-dim dual-arm end-effector,配合 tactile-aware execution,明顯不是聊天式 agent,而是面向機械臂操作與接觸控制的研究模型。

它在 UniVTAC、NeoSim 與八個 real-robot tasks 的平均成功率分別達到 84.5%、49.4% 和 46.3%。這些結果說明觸覺對高接觸操作有實質幫助;同時也要留意,部署門檻仍然偏研究導向,較適合機械人團隊、模擬環境開發者,以及已經有 demonstrations 與感測資料流的項目直接接入測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 模型訓練, Video, VLA, Robotic, Dataset 數據集

Page 25 of 92
1 23 24 25 26 27 92