[技術文章] DeepSeek-V4.1-Flash 百萬上下文 KV Cache 壓到四分之一

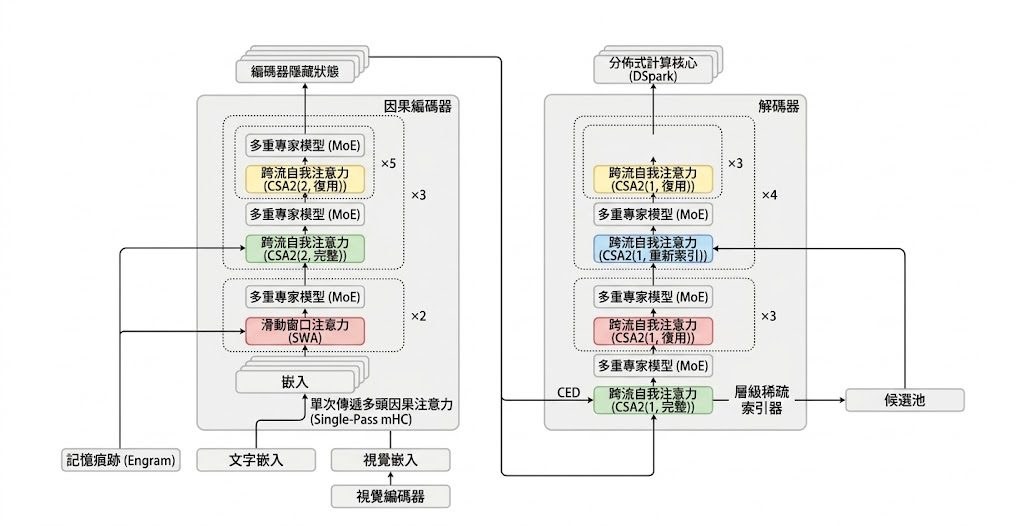
百萬 token 上下文背後最大的成本壓力來自 KV cache。DeepSeek-V4.1-Flash 用 CED 架構配合 CSA2,將每個 token 的記憶體用量壓到大約 890 bytes。

Hero image preview

長文 agent 跑得愈久,KV cache 累積得愈快,HBM 容量、頻寬、SSD 傳輸成本幾乎同步飆升;DeepSeek 團隊認為,這才是 scaling down 長上下文部署成本的主要瓶頸,而不單是推論計算本身。

為處理這道難題,DeepSeek-V4.1-Flash 採用 Causal Encoder-Decoder(CED)架構:prefill 階段啟用 8B 參數,decode 階段啟用 16B 參數,讓輸入極長但輸出相對短嘅 agent workload 成本結構更友善。Backbone 規模去到 552B,並支援長達一百萬 token 嘅上下文。

記憶體方面,Compressed Sparse Attention 2(CSA2)加入跨層 KV cache reuse 與分層稀疏 indexer,再搭配 FP4 KV cache,使常駐 HBM 嘅 global KV cache 降到每個 token 約 890 bytes,相對 V4-Flash 縮減約四倍、相比 V1 更達到 437 倍幅度。透過 SWA Bounded Replay 部署優化,落在 SSD 或 host memory 嘅 persistent footprint 更壓到大約 V4-Flash 嘅八分之一。即使 cache 大幅縮減,模型在 agentic 基準上仍比 baseline 表現更好。

預訓練採用 45T token 嘅多模態語料,後訓練亦經過完整流程,使 V4.1-Flash 在文本與多模態 agent 場景都保持穩定輸出。模型 checkpoint 已於 Hugging Face 開源,可供社群自行部署驗證。

  • 552B 參數 MoE 骨幹,支援 100 萬 token 上下文。
  • CED 架構令 prefill 僅啟用 8B 參數、decode 啟用 16B 參數。
  • CSA2 + FP4 KV cache 將 global KV cache 壓至 890 bytes/token。
  • SWA Bounded Replay 進一步將 persistent KV cache 降至 V4-Flash 約 1/8。
  • 45T token 多模態預訓練 + 完整後訓練,agentic 表現優於前代。
Paper

Categories: 開源, 模型, DeepSeek

JEPA-Anything 一套預測框架打通不同世界模型

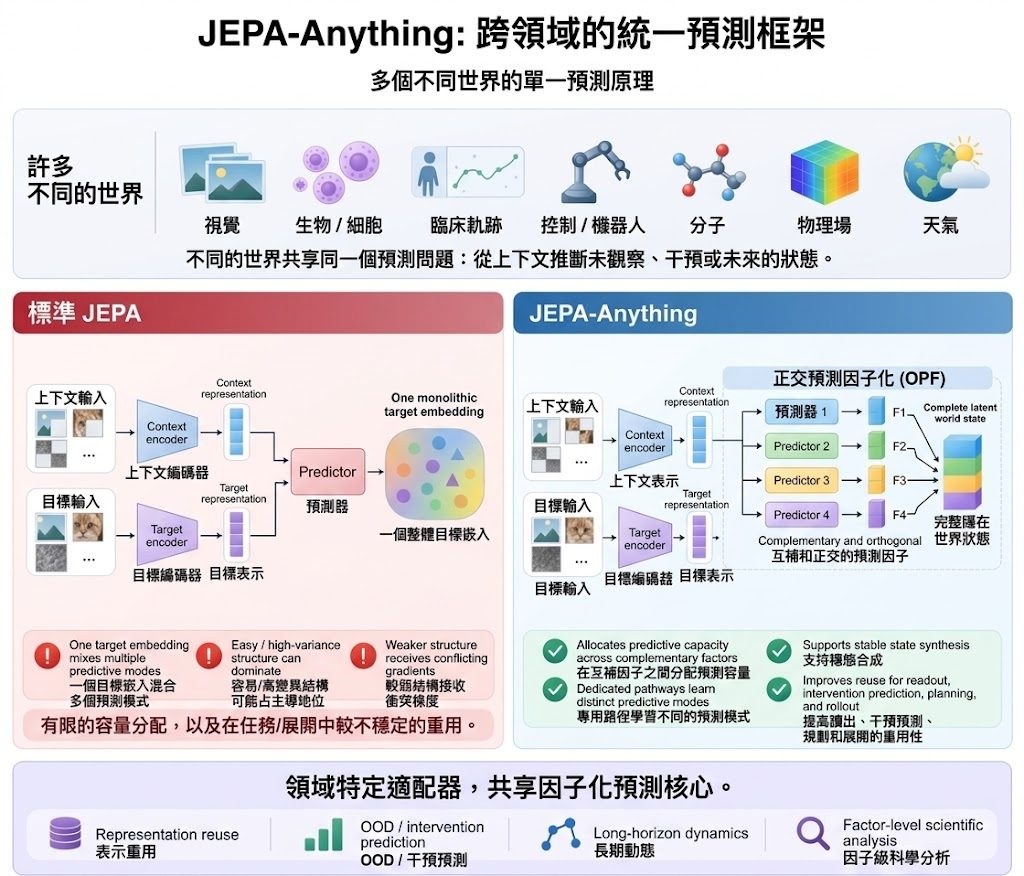
JEPA-Anything 提出 domain-agnostic 框架,把細胞、分子、物理場、控制環境、臨床軌跡等差異極大的世界,交給同一套預測原理學習。它用 Orthogonal Predictive Factorization 取代單一目標表徵,嘗試讓跨領域的世界模型有共享接口。

JEPA-Anything overview: cross-domain predictive learning and Orthogonal Predictive Factorization

世界模型的難題之一,是不同領域看似南轅北轍,卻共享同一個核心問題:能否用同一套預測學習原則,去處理完全不同的世界?Gen-Verse 的 JEPA-Anything 瞄準的正是這個長期卡位。它以 joint-embedding predictive architectures(JEPAs)為基礎,把傳統那塊「單一、整塊」的目標表徵拆開,改由一種叫 Orthogonal Predictive Factorization(OPF)的做法,把潛在的 world state 切成多個互補的預測因子,每個因子各自走一條預測路徑,最後再重組回完整狀態,作為下游讀取、干預預測、規劃與多步 rollout 的接口。

對研究者與工程團隊而言,它的價值在於允許不同領域保留各自的觀測、context–target 結構與編碼器,卻共享同一個預測核心與潛在狀態接口。換句話,領域不必共用同一個編碼器,也不必共用同一組權重,卻仍能復用同一套建模邏輯。框架內部除了可重用的 projection、objectives、baselines、representation diagnostics 外,也提供任務規格驗證與實作 scaffold 工具,並附上一個可控動力系統作為起步範例,方便團隊在自己的領域落地。

相較於針對單一領域訓練的 world model,JEPA-Anything 取捨的方向是放棄「一套權重打天下」的野心,改為提供一個結構化的共享接口與預測路徑。它對於需要把生物干預、物理定律等實驗訊號接回模型內部做分析的場景尤其有用,同時讓 out-of-distribution 預測與長程 rollout 有更清楚的表示基礎。模型權重與評估可在 Hugging Face 上的對應頁面取得。

GitHub

Categories: 開源, Embedding, 世界模型, 模型訓練, 框架, 工具

GPT-Policy 把 VLM 變現場教練

GPT-Policy 讓固定的視覺語言模型在現場讀懂示範影片、目標圖與互動回饋,直接輸出可執行的機械臂動作,省去微調與重訓成本。

GPT-Policy wordmark

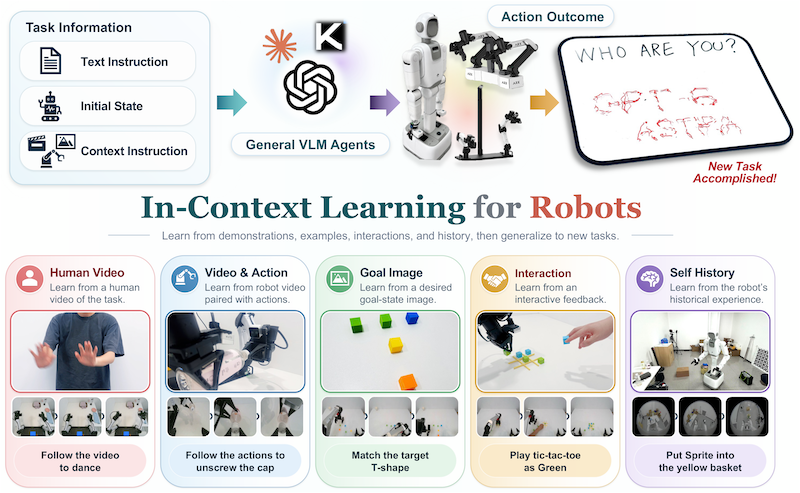
機械臂要適應新任務,傳統做法往往是收集大量數據再微調模型,成本高且迭代慢。GPT-Policy 走另一條路:保留一個固定的視覺語言模型(VLM)作為決策核心,現場把任務指令、示範影片、目標圖像、過往觀察與執行回饋打包成單一輸入,讓模型一次輸出一個結構化動作請求,再交給專屬的硬件適配器(adapter)驗證並執行。

的關鍵在於「context compiler」與「constrained controller」的分工。前者負責保留示範中與任務相關的視覺轉折,後者則檢查動作是否安全、可執行,並回報結果給 VLM 進入下一輪決策,整個過程沒有梯度更新,也不需要為新任務調整參數。對於 ARX X5 與 I2RT/YAM 兩款機械臂平台,項目已提供對應的適配器,支援笛卡兒目標、waypoint 序列、順序 IK 檢查、夾爪控制,以及 append-only 的運行記錄,方便日後追溯。

從結果來看,團隊在真實機械臂試驗中發現,即使只有人類影片而無機械臂動作標記,GPT-Policy 仍能改善任務完成率;若加上對齊的動作參考,表現會進一步提升,尤其在接觸敏感的任務上更明顯。對比同類做法,GPT-Policy 沒有走端到端策略網絡的路線,而是把通用 VLM 的推理能力當作即插即用的策略模組,取捨是更依賴適配器與閉環回饋的工程品質。

適合使用的場景包括:研究 VLM 與機器人結合的團隊、需要快速讓機械臂適應新任務示範的實驗室,以及想評估「不重訓」路線可行性的工程團隊。目前的限制在於硬件覆蓋仍集中在兩款臂,且效能高度取決於上下文編譯器能否保留關鍵視覺資訊。

重點摘要:

  • 固定 VLM 即決策核心:不微調、不重訓,靠現場上下文即時生成動作
  • context compiler + controller 雙層架構:前者保留任務相關視覺轉折,後者驗證並執行
  • 支援 ARX X5 與 I2RT/YAM:提供笛卡兒目標、IK 檢查、夾爪控制等適配器
  • 人類影片已能改善任務成功率:對齊動作參考後表現更穩,尤其接觸敏感任務
  • 定位為研究框架:適合探索通用模型在實體機器人上的即時學習能力

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, Video, Image, 影像處理, Robotic, 框架, 安全

PANORAMA 把場景描述逐個詞對應到像素

Inria 與捷克理工合作開源的 PANORAMA,能為整個場景生成描述並把每個實體精確對應到像素遮罩,並同步釋出近全幅覆蓋的人工標註基準 PanoCaps。

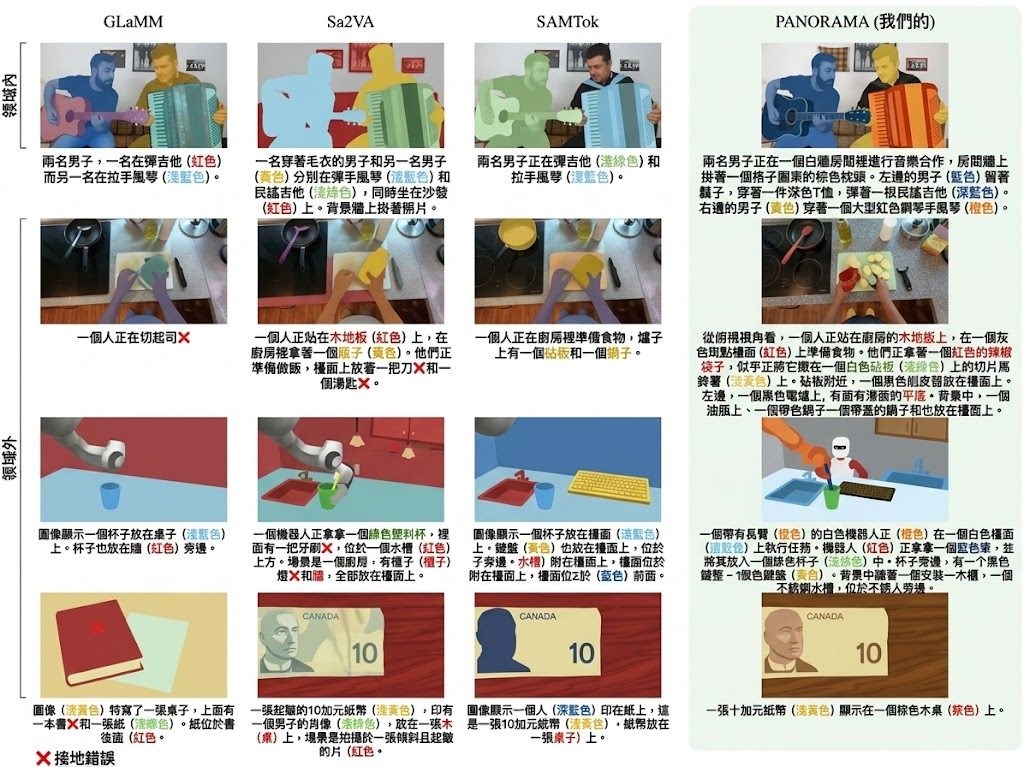
PANORAMA compared with prior grounded captioning models, in and out of domain

現時的視覺語言模型(VLM)寫得出漂亮描述,卻往往無法把句子裡的物件真正對到像素,導致「說的是一回事、畫出來又是另一回事」。PANORAMA 想處理的是 panoptic grounded captioning:模型要不只描述前景物件,還要連背景區域都講清楚,並為每個提到的實體給出像素級遮罩。

做法上,它把短語定位(phrase grounding)重新定義成「從短語條件化的遮罩提案池中挑選」。預訓練分割器根據每個短語的上下文表徵生成候選遮罩,模型再從中選出真正對應的那一塊,無論是單一區域、多個實例,或根本沒有對應都涵蓋在內。這樣把分割與語言生成用同一介面聯合訓練,文字與遮罩就不再各說各話。

配套資源同樣在 Hugging Face 公開:PanoCaps 約有 3.5K 張圖片、34K 個遮罩和 17.9K 條獨立短語,參照區域覆蓋近 99% 像素;COCONut-PanCap-Recaptioned 提供 118K 張訓練圖的重新標註;MRSeg-Referring-Expressions 則帶來約 101K 條改編自 SegLLM 的單輪指代表達。評估端還提出 generalized Panoptic Quality(gPQ),把文字與遮罩的一致性納入單一指標。實驗結果顯示,PANORAMA 在 PanoCaps 上整體定位表現最佳,並在多個像素級任務上與專門模型持平或更強。

這個項目適合以下情境:

  • 做機器人感知或場景理解的研究團隊:需要模型同時提供自然語言描述與實例級遮罩,減少對接多個模型的成本
  • 訓練數據匱乏的多模態團隊:PanoCaps 與兩份重新標註集合計逾十萬張圖,可直接用作訓練或微調
  • 需要精細指代(referring expression)任務的工作:MRSeg-Referring-Expressions 提供多粒度指代表達,比單一句式更有助泛化
  • 對 VLM 評測有疑慮的研究者:gPQ 指標把文字與遮罩綁定,避免「描述漂亮但對錯位置」的高分陷阱

對想直接跑實驗的人,訓練、微調與評估程式碼已隨倉庫釋出;模型權重則透過 Hugging Face 取得。如果你關心的是 VLM 能否真正「看懂」場景而不只是寫句子,這套統一框架比多數把描述與分割拆開處理的方案更接近落地需求。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Image, 框架, , Dataset 數據集

ActionPiece:設計動作分詞器,幫機械人學得更穩

可以把 ActionPiece 理解為一個專給視覺語言動作模型用的動作編碼器,特別針對自回歸生成時動作細節流失的問題,強調保留物理距離的先後關係。

DeepCybo, Zhongguancun Academy, and Zhongguancun Institute of Artificial Intelligence

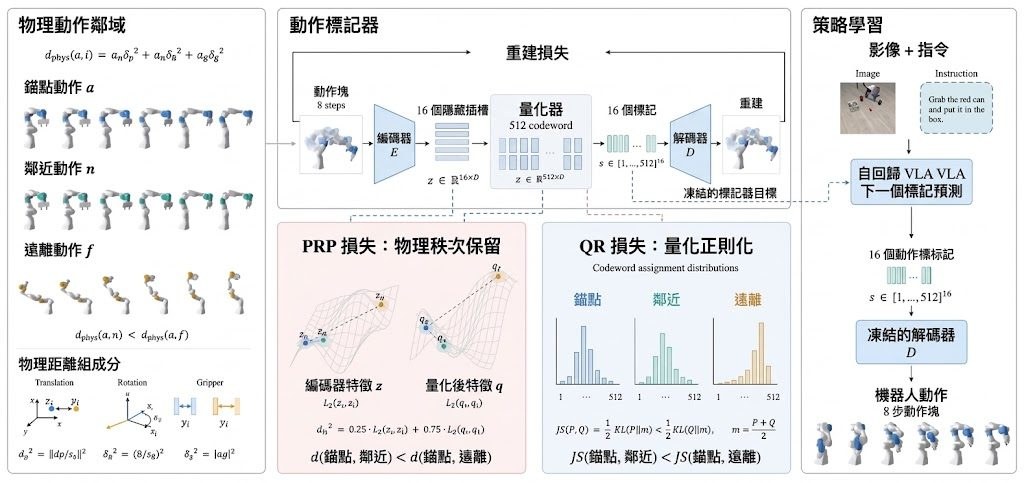
當自回歸視覺語言動作模型(VLA)把機械人動作切成離散 token 再一個個吐出來,最大的隱性成本往往不是單一動作的誤差,而是相鄰動作之間的物理距離被打亂。ActionPiece 正是針對這個卡位設計:它把動作切成一塊八步的短序列,每塊壓成 16 個離散 token,並要求 tokenizer 不只重建動作,還要保留「物理排序一致性」(physical rank consistency, PRC)。換句話,兩個本來很接近的動作,編碼後的距離也要維持接近;兩個本來很遠的動作,編碼後也要維持較遠。這種監督讓 token 表徵本身帶有物理結構,而不是純粹的重建損失。

在 Libero、Libero-Plus、SimplerEnv 與 VLA-Arena 四組基準上,ActionPiece 配合 Qwen3-VL-4B 作為策略骨幹,跑出 94.8%、68.8%、71.9%,以及 VLA-Arena L0 至 L2 平均 51.5% 的成功率。Libero-Plus 的訓練刻意排除其示範數據,因此這項成績更能反映遷移表現,而不是單純記住示範。從結果可以看到,重建保真度與 PRC 之間並非完全等價:有些 tokenizer 重建得很好,但鄰近關係一塌糊塗,部署成功率也跟著掉。ActionPiece 把「物理排序保留」與「碼字分配的量化正則化」綁在一起訓練,正好同時壓住這兩個問題。

這個項目的實際意義,是給正在做 VLA 研究的團隊一個可直接替換的動作 tokenizer,無需重寫策略架構。對關注 SimplerEnv 真實遙操作或 VLA-Arena 跨平台泛化的工程師來說,這類保留物理關係的分詞方式,會比純重建式 tokenizer 更貼近控制任務的需求。PhysBrain 1.5 也採用了 ActionPiece 作為動作 tokenizer,顯示它已不只在論文層面,而是走進實際模型發佈。

要真正評估它,比較合理的做法是把它接進自己的 VLA 流程,比對換 tokenizer 前後的策略成功率與 PRC;單看 Libero 94.8% 容易被低估,因為重建誤差小的 tokenizer 不一定保留鄰近結構。原始程式碼與 PhysBrain 1.5 的權重將在官方頁面釋出,想搶先試的人可以先讀論文並鎖定後續更新。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, VLA, Robotic, Dataset 數據集

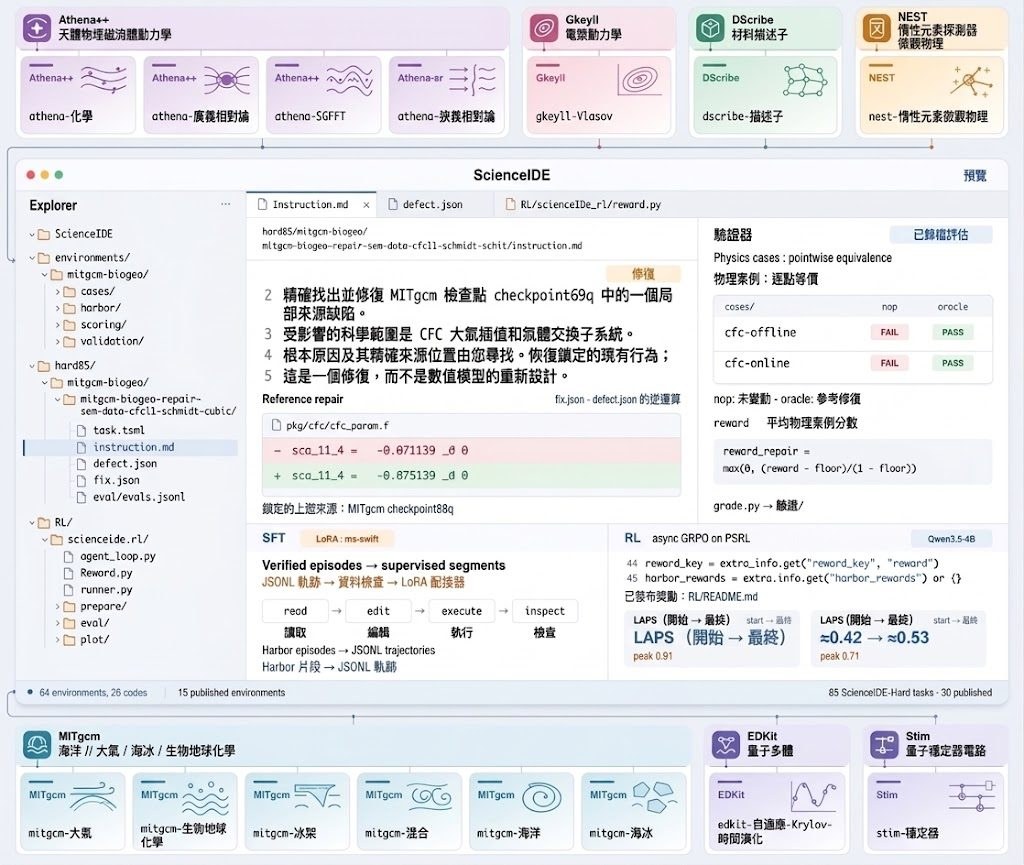
ScienceIDE 把科學模擬變成 AI agent

ScienceIDE 用 64 個科學模擬環境訓練 agent 修 bug、重寫函式,並釋出 4B、9B、72B 三個模型。你可以把它理解成:用真實物理模擬的數值對不對,來判斷 AI 改程式改得啱唔啱。

ide overview

大多數 code agent 訓練環境用靜態單元測試或合成題目,ScienceIDE 走一條更狠嘅路:直接搬真實科學模擬器入嚟做試煉場,等 agent 改動 pinned、未經修改嘅上游源碼,再由 verifier 重新編譯並跑原本嘅物理 case,數值要對得返先算過。換句話,reward 唔係「diff 似唔似」,而係「模擬結果啱唔啱」。呢套框架對工程團隊同做 AI for Science 研究嘅人特別有用,因為佢直接量度 agent 對物理計算嘅影響,而唔係紙上談兵。

項目提供 64 個環境同 85 條 ScienceIDE-Hard 任務,已公開 15 個,全部都附帶可量度嘅難度指標(未修復分數、編輯點數量、驗證成本、通過率),避免人為標 difficulty。Reward 設計亦幾巧妙:untouched repository 一定攞零分,等模型必須真係做嘢先有分。

團隊同時釋出 PhAI-IDE-4B、9B、72B 三個模型,覆蓋唔同算力預算。從結果睇,SFT 後 PLUTO-Particles-Dust 由 0.0 跳到 0.33;Qwen3.5-4B 經 30 步 RL,LAPS 由 0.357 升到 0.857,MITgcm-biogeo 由 0.286 升到 0.571。訓練用科學 code 唔止提升呢類任務,亦帶動一般 benchmark:CodeXGLUE defect detection +6.99pp,BBH Word Sorting +36pp。

要部署嘅人最直接嘅入口係 Hugging Face 嘅 model collection 同 GitHub repo;想理解 reward 邏輯同難度定義,paper 同項目頁有完整交代。訓練數據、開發環境同 verifier 開源,等社區可以喺真實科學 codebase 上繼續 scale up。

重點摘要:

  • 真實物理模擬做 reward:agent 改動上游源碼後,verifier 重編譯並比對物理 case 數值,唔靠 diff 相似度。
  • 64 個環境、85 條 Hard 任務:已開源 15 個,難度由可量度指標自動決定,唔靠人手標 label。
  • 三個模型規模:PhAI-IDE-4B、9B、72B 覆蓋唔同算力,訓練設定與評估條件一致。
  • 科學任務外溢到通用 benchmark:CodeXGLUE defect detection +6.99pp,BBH Word Sorting +36pp。
  • 完整開源鏈:code、environments、tasks 同模型權重同步釋出,方便研究團隊複製同擴展。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, 框架, IDE, Dataset 數據集

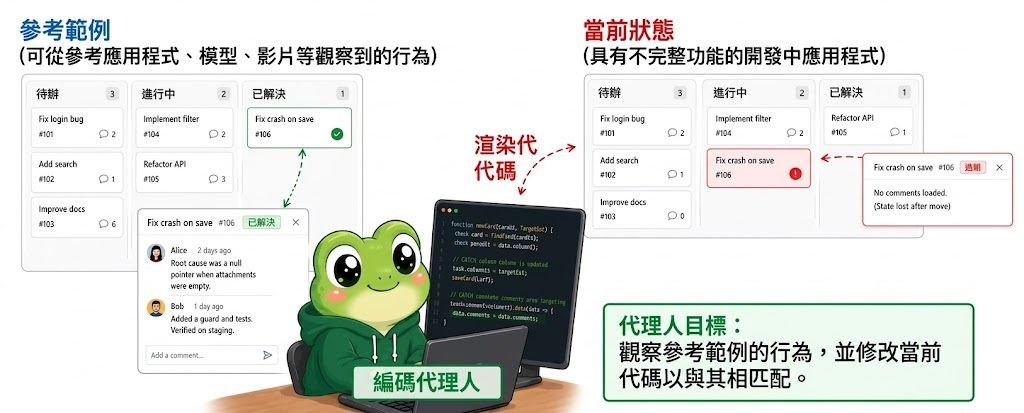
ProgramDistill:把網頁 App 反推成 SWE 基準任務

ProgramDistill 把互動的網頁行為變成修復題目,讓 AI 編程代理靠一部會動嘅「參考 App」重新砌返功能,再自動驗收。

Microsoft Research

好多時開發並非由一份寫得好清楚嘅規格開始,而係先見到一個行得通嘅版本,再去諗點補返。ProgramDistill 模擬嘅正係呢種工作流:代理可以同一部「參考 App」互動,但睇唔到佢嘅源碼,只能改另一份缺咗功能嘅應用程式,再睇最後行起上嚟嘅行為同原裝嘅一唔一樣。換言之,重點唔係抄程式碼,而係要還原出來嘅效果同參考版本吻合。

要規模化做呢件事,每條任務都要有「可以重播嘅行為」加「可靠嘅驗證」。ProgramDistill 用一條叫 mine-craft-patch 嘅自動管線,靠多個 LLM 代理合作,由行得通嘅應用同源碼出發,自動搵出可記錄嘅行為、存成可重播嘅 trace,再刪走負責該行為嘅源碼,整出一份「修復題」。每條 trace 本身就係一個可執行嘅驗收器,因為佢記低咗瀏覽器動作、成功訊號同前置依賴,自動重播就識得計分。

呢套方法喺 26 個應用上面搵到 1,975 個經重播驗證嘅行為,再組成 4,063 條任務。題目難度可以由「要還原幾深層嘅依賴」控制到,即係話可以設計到「只係補一個細行為」,亦可以迫代理一次過補返連鎖反應。

重點摘要:

  • 用可重播行為做驗收:trace 同時係題目亦係計分機制,省咗另寫驗收邏輯。
  • 唔睇源碼、只睇效果:代理要靠互動參考 App 嚟推測行為。
  • 難度可調:還原深度愈深,要一齊修好嘅行為就愈多。
  • 規模化合成:26 個應用就整到四千幾條 SWE 任務。
  • 評估目標係還原效果,唔係程式碼樣相似唔相似。

對做編程代理嘅團隊,或者想練 SWE-bench 類型基準嘅人嚟講,呢套管線提供咗一個起點:由真實 Web App 自動生出一批可驗證、難度可控嘅任務,省卻人手逐條寫題目嘅工序。

項目主頁

Categories: 開源, Agentic, 微軟, 軟件, 編程, Dataset 數據集

Hypit:把爆款短片變成可換臉的模板

Hypit 是一套開源影片克隆工具,主打把 TikTok、Reel 或 Short 變成可重用的版面,換掉主持人、產品、開頭與長寬比,就能快速產出多個變體做投放測試。

Hypit

短片團隊最常遇到的卡位,是手上有一條跑出來的素材,卻要趕在疲勞前把它複製成十幾條變體測試新 Hook。Hypit 想解決的正是這個工序:丟一條影片進去,它會拆解成鏡頭、字幕、B-roll、效果這些可組合的工作流部件,而不是只輸出一份腳本分析。對做付費社交投放的人來說,這意味著可以從 Meta Ad Library 複製一條已經贏過的廣告,換掉商品與開場就當日出 50 條 Hook 變體;等兩星期素材疲勞,再用同樣的主體版型換新開頭,主體片段完全保留。

它和一般「AI 影片生成器」差別在定位:生成式模型負責補上會變的部分,Hypit 則是負責把會變跟不會變的部分拆乾淨、串起來。每個組件都能被替換或 fork,使用者不必動到字幕或剪輯邏輯。商業模式上,項目本身是開源(Apache-2.0 with conditions),沒有平台座位費或浮水印,模型服務費則看你接的是哪一家。

技術偏向給內容團隊或 growth marketer 自建的工程師整合進既有管線。素材來源涵蓋 TikTok、Reel、Short,也可以從 Meta Ad Library 抓一支跑得好的 paid ad 當模板。對需要大量 A/B 測試 hook、不同市場語言切版、或長線養帳號的工作流來說,這種「一次結構、N 次變奏」的思路,比每次從腳本重頭來要省事不少。

我用AI 10分钟复刻爆款视频:Hypit详细教程,直接拆成可编辑工程
  • 不是單次生成,而是變奏生產線:同一支片可以反覆換主播、產品、語言、長寬比
  • 組件化設計:字幕、B-roll、效果都能獨立替換,不影響整體結構
  • 開源但非全免費:項目本體免費、無浮水印;模型推理依賴外部服務計費
  • 適合 paid social 與 viral clone 場景:Meta Ad Library、TikTok、Reel 都能當模板來源
  • 技術門檻在整合端:需要 Node.js + TypeScript 環境,較適合有工程支援的團隊

GitHub

Categories: 開源, AI productions, Video, 工具, , Skill 技能

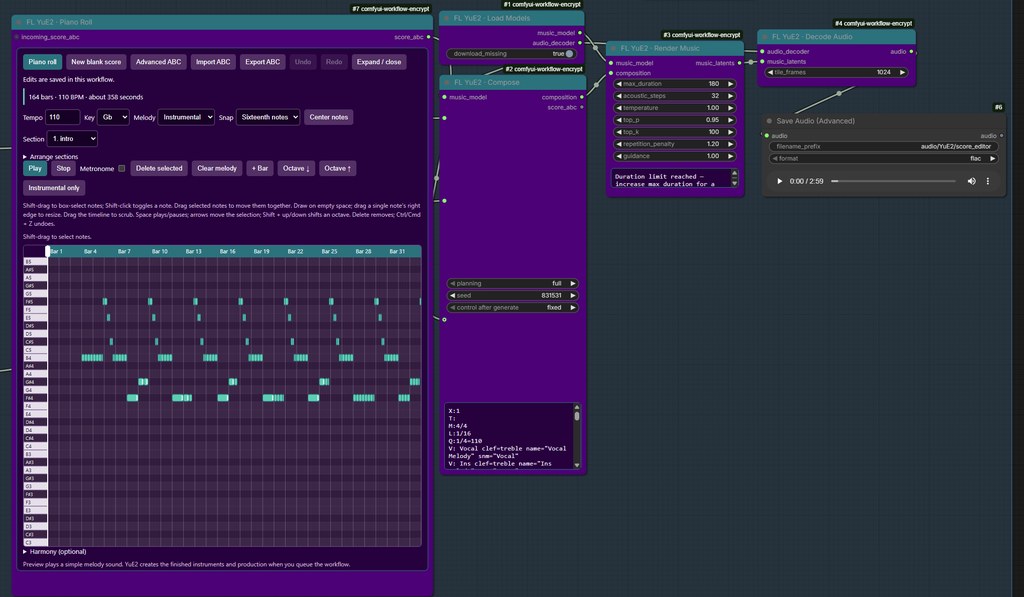
ComfyUI-FL-YuE2:ComfyUI 內砌歌:FL YuE2 把樂譜編輯、AI 作曲、LoRA 訓練三件事接起來

ComfyUI-FL-YuE2 是一組節點,把 YuE2-3B 音樂模型包進 ComfyUI 工作流,讓你用鋼琴卷軸寫樂譜、灌歌詞,最後輸出 48 kHz 立體聲成品,亦支援 AR LoRA 訓練。

YuE2 inference workflow in ComfyUI

以往想在 ComfyUI 玩音樂生成,往往要面對幾個卡位:要自行接 YuE2 的推理指令、要另外找譜面編輯工具、想做 LoRA 微調更要跳出 ComfyUI 自己搞訓練腳本。FL YuE2 嘗試一次解決這三件事,把樂譜編輯、AI 作曲、AR LoRA 訓練全部接成節點流程,對熟悉 ComfyUI 圖形化工作流的用家算是頗順手的整合。

項目核心是一個可視化鋼琴卷軸編輯器,支援點擊加音、Shift 框選、箭頭鍵移動、Undo/Redo 等基本操作,並提供 Instrumental 或 Sung 旋律模式。和弦面板可摺疊,匯入的 ABC 樂譜會保留 slash chord 等進階標記。換 Key 時同時處理旋律與和弦根音,最短轉調、超出音域會直接拒絕而非裁切音高,設計上偏向「樂理正確」多於「暴力生成」。

音訊輸出走 YuE2-3B 加獨立 VAE 解碼器,產出 48 kHz 立體聲,內建瀏覽器合成器可預覽節段節拍,但並非最終成品音色。LoRA 訓練流程則提供數據集檢視與 checkpoint 預覽,方便用家挑選權重繼續微調。

重點摘要
– 屬於 ComfyUI 自訂節點套件,整合 YuE2-3B 音樂生成與樂譜編輯
– 鋼琴卷軸支援框選、群組移動、Undo/Redo,轉調按樂理而非裁切處理
– 推理與 AR LoRA 訓練共用同一組節點,方便迭代
– 需 NVIDIA GPU 支援 BF16,已驗證 RTX PRO 6000 Blackwell,其餘 24 GB 配置未經驗證
– 首次執行約下載 7.8 GB 模型權重,支援中斷續傳與離線模式

適合已有 ComfyUI 基礎,又想嘗試可控音樂生成或自訓風格 LoRA 的用家。注意目前僅在 Windows + Python 3.12 + Torch 2.11 環境驗證,跨平台或較舊 GPU 仍需自行測試。

GitHub

Categories: 開源, ComfyUI, 模型, 模型訓練, NVIDIA, Audio, Python, 音樂, Dataset 數據集, 廣東話

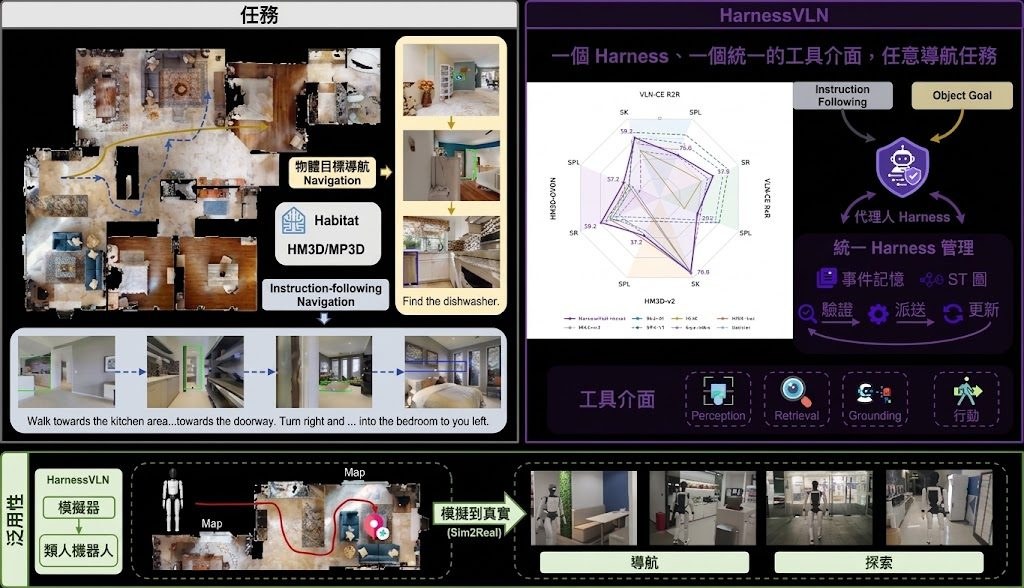
HarnessVLN:不訓練也能走的統一導航框架

HarnessVLN 把視覺、語言、空間證據交給一套 Agent Harness 統籌,用零訓練方式處理多任務導航,並以層化記憶與時空圖解決長程失敗。

Repository image for AgibotGeneral/harnessvln

Embodied Navigation 過去依賴大規模訓練與任務專用流程,但不同場景的 pipeline 各自為政,難以共享空間證據與錯誤紀錄。HarnessVLN 把這個痛點攤開:現有 training-free 方法雖然借助多模態大語言模型,卻缺乏把「提案」與「空間證據、任務進度、執行失敗」對齊的機制,於是同一個 agent 在長時序任務中容易重複犯錯、難以回收。

作為一個訓練無需更新的 agent harness,HarnessVLN 用統一工具介面串接感知、檢索、定位、導航、恢復與終止,並透過層化事件記憶與持久化時空圖(Spatiotemporal Graph)保留可重用的空間證據與失敗標註,讓跨子目標的經驗真正沉澱。提案不再直接落地,而是先被 Agent Harness 結合幾何可行性與過往失敗做驗證,再分派給工具執行。

在 R2R、RxR、HM3D-v2、HM3D-OVON 等基準上,HarnessVLN 報出 60.8、53.9、76.0、59.3 的 SR%,覆蓋 instruction navigation 與 online exploration 兩種形態,並提供真機 demo 與模擬環境。對機器人團隊、具身 AI 研究者與需要快速驗證導航策略的工程師來說,它提供一個不必從零訓練就能橫向比較的底層框架。

重點摘要

  • 訓練無需更新:以 Agent Harness 統一感知、檢索、定位、導航、恢復與終止工具
  • 層化事件記憶 + 時空圖:把子目標進度與空間證據沉澱為可重用資產
  • 提案先驗證再執行:用幾何可行性與失敗紀錄把 LLM 操作提案過濾一次
  • 覆蓋 R2R、RxR、HM3D-v2、HM3D-OVON 等多項導航基準
  • 同時提供模擬與真機 demo,適合做跨任務導航策略的快速評測

對在意長時序導航穩定性、想避開昂貴 fine-tuning 的團隊,這套來自南京大學、清華大學與 AGIBOT 合作的方案,給出一條「不訓練也能走得更穩」的工程化路線。

項目主頁 · GitHub · Paper

Categories: 開源, 南京大學, 清華大學, Agentic, 多模態模型, 模型訓練, Robotic, 框架, 工具, Dataset 數據集

Page 2 of 92
1 2 3 4 92