SparsePR 讓影片生成以稀疏注意力加速,毋須重新訓練

SparsePR 將稀疏注意力帶入四款影片模型,在維持生成質素的同時,把執行速度提升最多 2.61 倍。

Repository image for PardisTaghavi/SparsePR

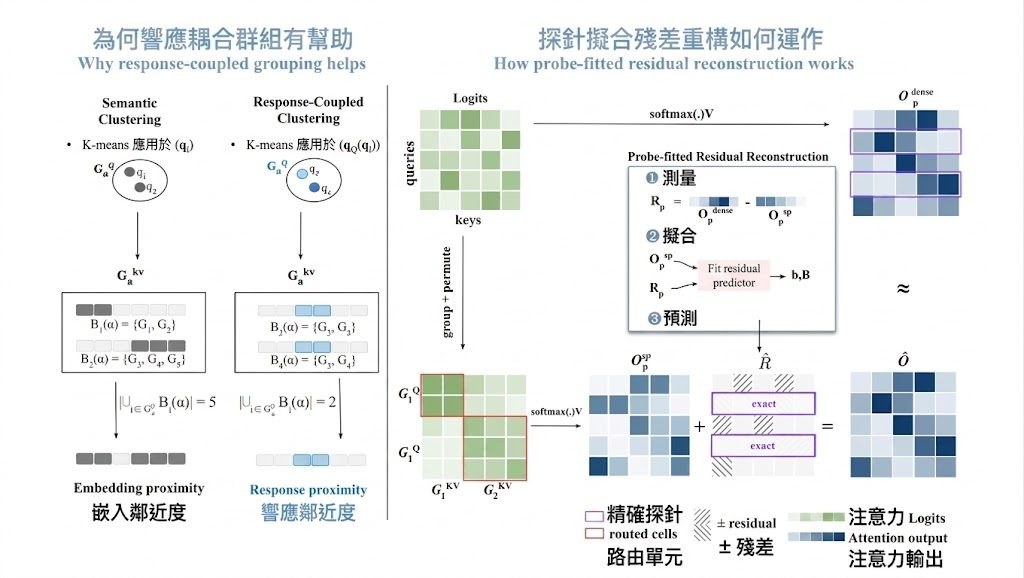
影片生成最吃資源的部分,往往不是提示詞或輸出格式,而是 Video Transformer 裏大量 Attention 計算。SparsePR 屬於 training-free sparse attention 參考實作,透過減少不必要的 query、key/value 互動,加速 HunyuanVideo-13B、Wan2.2-I2V-A14B、Cosmos-Predict2.5-14B 及 Cosmos3-Nano-16B,毋須額外訓練模型。

它沒有單純按注意力集中程度刪走區塊,而是以 Response-Coupled Partitioning 按目前回應分組,再用少量 exact probe rows 配合 Probe-Fitted Residual Reconstruction,補回稀疏計算遺漏的輸出。使用者可透過同一個介面,在 dense baseline 與 SparsePR 之間切換,直接比較影片質素、速度和顯存取捨。

  • 執行 pair density 約 21.9% 至 26.0%
  • 端到端速度提升約 1.48 至 2.61 倍
  • 涵蓋文字轉影片、圖像轉影片及 image-to-world 情境
  • 在 VBench 及 PBench 進行評估,部分 Cosmos-Predict2.5-14B 結果達 40.33 dB

項目要求 Linux,並建議使用 NVIDIA H100;HunyuanVideo、Wan2.2、Cosmos-Predict2.5 與 Cosmos3 需要分開的 CUDA 12.8 wheel 環境,原因是 Cosmos3 依賴較新的 Diffusers 和 Transformers。可選的 fused CUDA kernels 有助進一步執行,但安裝門檻明顯高於一般影片生成工具,模型 checkpoint 亦要從官方 Hugging Face 儲存庫取得。

SparsePR 適合研究影片生成效率、建立高端 GPU 推理基準,或需要在保留畫面質素下減少計算量的團隊。它目前仍是參考實作,支援模型和硬件環境較有限;對只有消費級 GPU、只想快速試玩影片生成的使用者,成本與環境配置可能抵銷加速帶來的好處。
項目主頁 · GitHub

Categories: 開源, 模型訓練, NVIDIA, Video, Image, 框架, Linux

Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

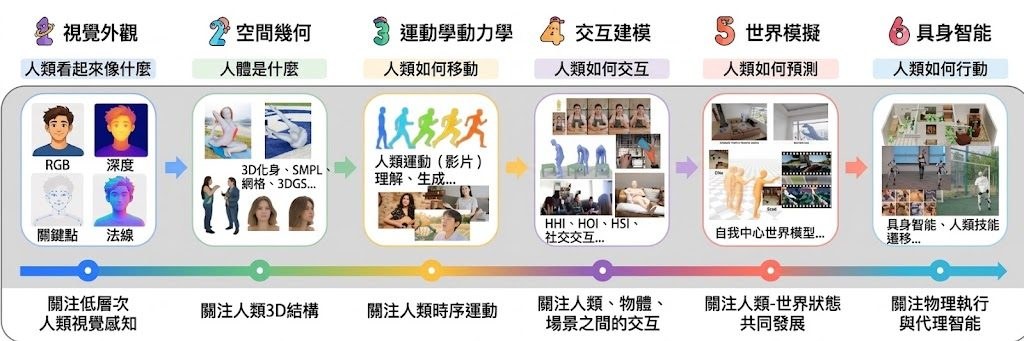
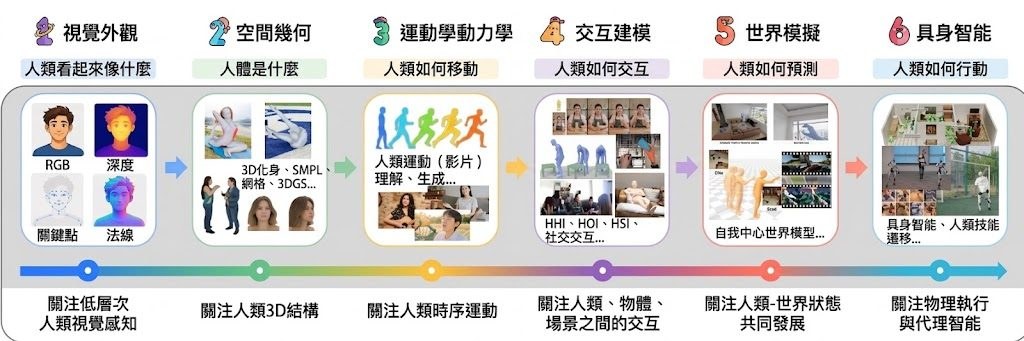
伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

資源庫並非可直接下載執行的模型或軟件,使用方式是瀏覽 GitHub 內容及項目首頁,按 Academic Knowledge、Research Infrastructure 和 Community Learning Hubs 等部分尋找材料。研究者亦可透過社群渠道提交或維護資源,因此內容會隨社群整理持續更新,但完整度和一致性仍取決於後續貢獻。

伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者,GitHub 資源庫和 survey 應該一併閱讀;只想立即執行模型或測試 API 的使用者,則需要另找具體實作項目。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

UniSpace:把理解、生成與編輯放進同一視覺空間

UniSpace 嘗試用同一套視覺表示處理影像理解、生成與編輯,但首個程式版本仍未包含訓練流程。

UniSpace logo

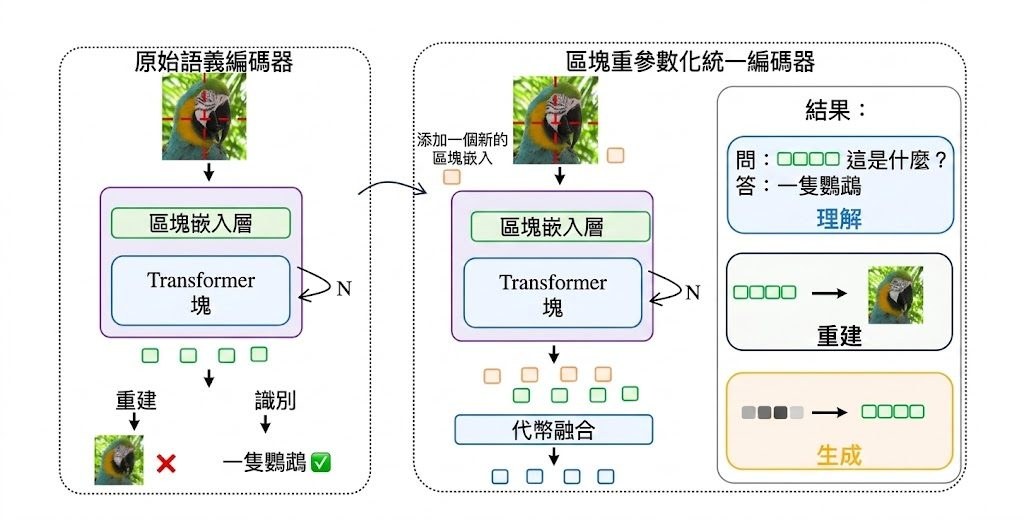
影像模型往往要在語意理解與畫面細節之間取捨,UniSpace 以統一視覺表示同時處理理解、生成和指令式編輯,定位是多模態模型及推理評估項目。它由 patch-reparameterized vision encoders 和 Qwen3-8B Mixture-of-Transformers 組成,前者保留預訓練模型的語意能力,再補足重建與生成所需的細節。

三款 encoder 分別是 PR-SigLIP2、PR-DINOv2 和 PR-Qwen-ViT;UniSpace 則使用配備 Qwen-based patch-reparameterized tokenizer 的視覺空間。這種分工讓同一套表示可以連接理解、文字生成影像及影像編輯,但也代表模型效果取決於 encoder、tokenizer 和多模態 backbone 能否協調工作。

ImageNet-1K 256 × 256 重建測試使用 50,000 張驗證影像,PR-DINOv2 取得最高 PSNR 30.84、SSIM 0.90 和最低 rFID 0.14。生成測試同樣使用 50,000 個樣本;PR-DINOv2 配合 Classifier-Free Guidance (CFG) 後,gFID 為 1.877、IS 為 274.16,但 Recall 由 0.637 降至 0.605,反映畫面品質與覆蓋範圍之間仍有取捨。

目前最需要留意的是可重現性,而不是安裝難度。儲存庫屬於 paper-time landing release,首個程式版本只會提供 inference 和 evaluation,訓練程式及內部數據管線不公開;在預期檔案和 checkpoints 尚未完整發布前,fresh clone 不能直接執行命令。研究團隊、模型評測人員和需要比較視覺 encoder 的開發者可先參考固定 seed、採樣步數及評測規則,待穩定版本發布後再驗證結果。

  • 能力範圍: 統一支援影像理解、生成與 instruction-based editing。
  • 模型關係: PR-SigLIP2、PR-DINOv2、PR-Qwen-ViT 提供視覺表示,Qwen3-8B Mixture-of-Transformers 負責多模態處理。
  • 評測結果: PR-DINOv2 重建 rFID 0.14,UniSpace GenEval 整體分數 0.84,DPG-Bench 為 86.49。
  • 限制: 目前欠缺可由 fresh clone 直接執行的完整程式、訓練流程及內部數據管線。

項目主頁 · GitHub

Categories: 開源, 多模態模型, Qwen, Clone, Dataset 數據集

OmniAssistBench:以多輪互動評測即時影片助手的表現

OmniAssistBench 以 LLM-as-a-Judge 固定互動路徑測試 Omni-LLMs 的多輪影片助手能力,涵蓋685組開放式問答、7類任務,影片含自然語音、打字或手寫提示。評分顯示 Gemini-3-Pro 以66.4分領先。

OmniAssistBench proposes an annotation pipeline which allows annotators to build test samples from existing Internet vid

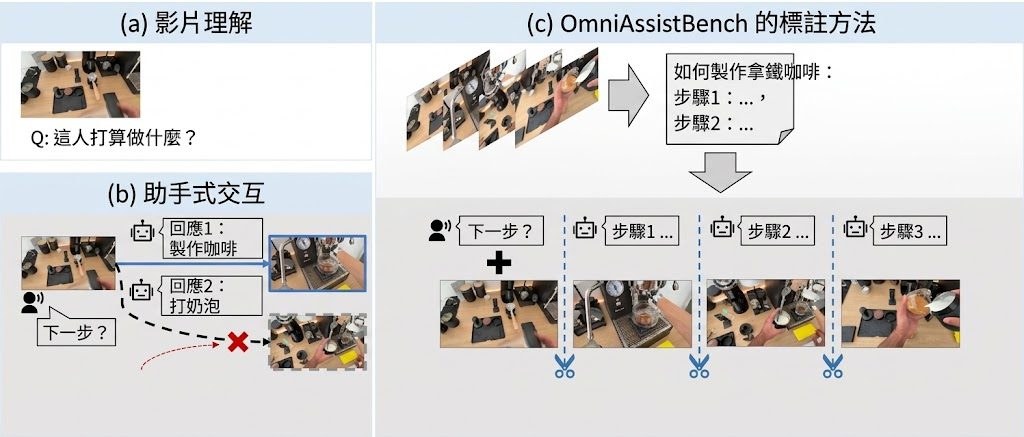
當影片助手的回答會改變使用者下一步行動,傳統只對固定影片問答的測試便難以反映真實體驗。OmniAssistBench 屬於 Omni-LLMs 的影片助手評測基準及數據集,透過固定互動路徑,處理多輪對話中影片內容會隨模型回應變化的問題。

項目涵蓋 685 組開放式問答,分成 Basic Tier 與 Advanced Tier,涉及社交理解、時間感知、手勢提示、程序指導及主動回應等 7 類主要任務和 16 類細分任務。影片取材自運動、煮食、講課、DIY 及談話節目,另有 3 個自行拍攝案例,每個平均超過 15 輪互動;問題會以自然語音、打字或手寫方式嵌入影片,而不是只放文字提示。

  • 以影片連同對應音訊輸入模型,再按互動回合回答問題
  • 由專家先整理影片步驟,再剪輯片段及加入字幕,固定測試路徑
  • 評分採用 LLM-as-a-Judge,原始 0 至 5 分再換算為 0 至 100
  • 建立數據集耗用超過 1,000 小時專家工時

這種做法比靜態影片問答更貼近助手場景,但固定路徑亦代表其他合理回應未必能在同一測試中獲得充分反映。Project homepage 的排行榜顯示,Gemini-3-Pro 整體得分為 66.4,Gemini-2.5-Pro 為 64.6,商用及開源 Omni-LLMs 都只達部分正確,反映可靠的即時影片助手仍有明顯改進空間。

研究團隊來自南京大學、南開大學及 University of Waterloo。測試者需要按照項目提供的評測流程處理影片和音訊,相關 Dataset、Project Page 及評估程式碼可供查閱;正式採用前應先確認版本、存取權限及評分流程是否已更新。

項目主頁 · GitHub

Categories: 開源, 南京大學, 字節跳動, Qwen, Gemini, Dataset 數據集

AgentMercury 生成可驗證商業世界

把企業情境轉成可執行環境,讓AI代理在多服務流程中訓練,再轉移到未見過的評測項目。

Og image

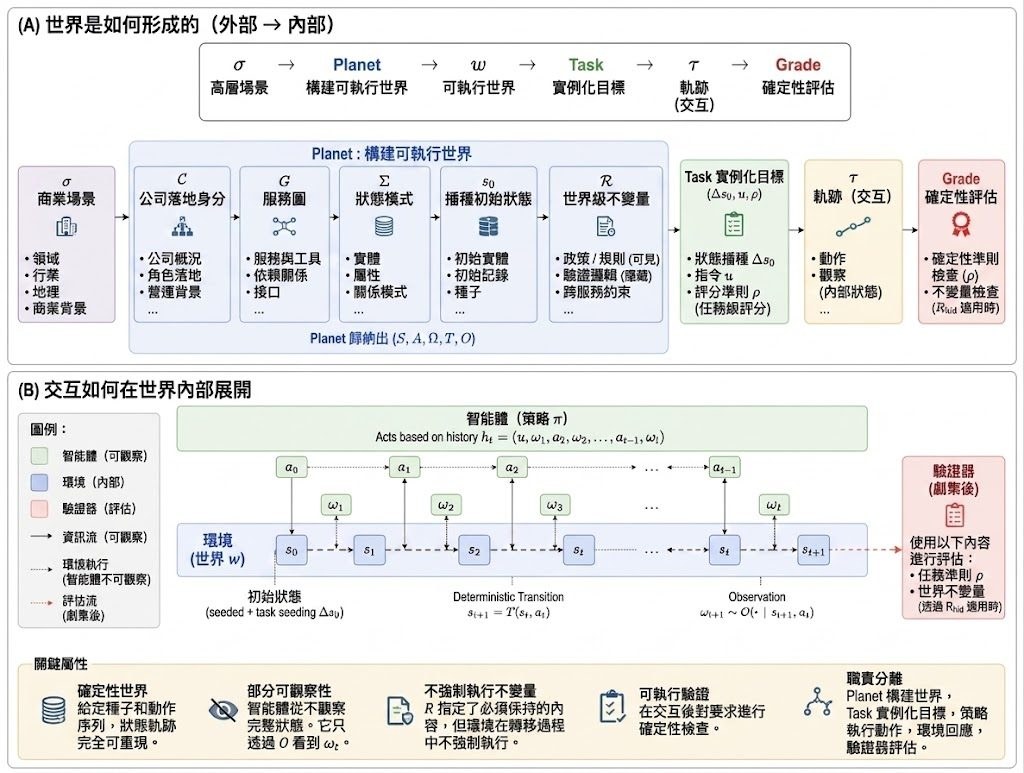
當AI代理要處理跨部門企業流程,難點往往不只在於選擇工具,還要在多個服務之間維持一致狀態,最後交出可以核實的結果。AgentMercury是一個用於訓練 Computer-use agents(CUAs)的環境生成項目,讓高層次商業情境直接變成可執行、可重播和可驗證的虛擬世界,代理可以在其中進行多輪操作,而系統會按完成後的狀態計算獎勵。

常見做法會先為指定任務或 benchmark 手工建立環境,環境自然只覆蓋測試者預先想到的流程。AgentMercury則把環境建構本身交給 Planet:它由公司身份、服務圖、資料表結構、初始狀態和跨服務不變條件組成一個完整世界,再由 Task 在共享世界上加入不同目標和評分規則。一個世界可以承載多個任務,減少每個新流程都要重新造環境的成本。

驗證條件主要以環境資料庫上的 SQL 形式執行。代理完成一輪操作後,系統會根據任務 rubric 和隱藏的不變條件,對整條 trajectory 進行確定性評分;環境不會在每一步替代理判斷對錯,代理必須自行處理跨服務要求,完成後才接受檢查。這種安排讓結果可以重播,也令 Reinforcement Learning(RL)訓練得到較穩定的回饋。

目前項目整理出4,783個 executable worlds,涵蓋14個產業和50個國家,包含13.98M seeded state rows、842種工具和43,300個可驗證 RL 任務。典型世界約有13項服務、65種工具、31張狀態表,以及約15個以 SQL 編寫的 deterministic verifiers;訓練資料涉及4,326個公司環境,但 Qwen3.5-4B 的報告只使用其中3,200個任務取得梯度,仍覆蓋53.5%的環境、62.9%的產業和75.8%的工具。

項目以 Qwen3.5-4B 和 Qwen3.5-35B-A3B 進行 RL 訓練,代理透過 Model Context Protocol(MCP)操作即時形式的商業軟件,並以 GRPO(Group Relative Policy Optimization)為主要優化方法,SAO 則作為另一種選項。Qwen3.5-4B 的平均獎勵約由0.25升至0.53,截斷回應比例由78%降至3%;在未參與訓練的 EnterpriseOps-Gym 八個企業領域,平均分數由12.3升至15.7,增幅為27.6%。35B-A3B 使用 GRPO 和 SAO 後,平均分數分別由24.8升至28.1及28.3,但結果仍屬項目所報告的訓練和評測範圍,未代表代理已能可靠處理所有企業工作。

  • 將高層次商業情境編譯成可執行世界,而不是只為單一任務造環境
  • 以共享資料庫、SQL 驗證條件和可重播評分檢查跨服務結果
  • 提供4,783個環境、842種工具和43,300個可驗證 RL 任務
  • Qwen3.5 系列在多輪 MCP 工具操作訓練後,獎勵和未見領域表現均有改善
  • 仍需留意合成環境與真實企業軟件之間的差距,以及評測範圍有限的問題

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, Qwen, Dataset 數據集

InfinityEdit:支援多輪連續編輯嘅開源影片框架

InfinityEdit 將影片編輯變成連續接力,每個指令都在上一段結果上再延伸。它適合要處理長片段、持續畫面同多輪改動嘅場景。

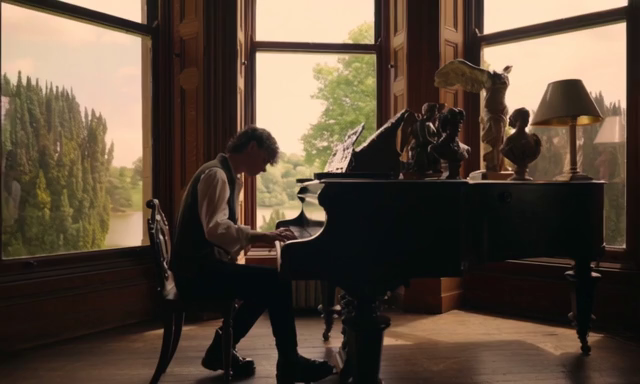
Pianist source video thumbnail

InfinityEdit 係一個影片編輯框架,核心問題唔係單次改一段短片,而係面對持續流入嘅影片,連續套用多個指令,令後一段自然接住前一段,仲要保住畫面連貫。對做長片生成、直播式視覺改寫,或者需要一路加指令一路修正畫面嘅工作流程,佢處理嘅正正就係「編輯唔可以只限喺固定片段內」呢個限制。

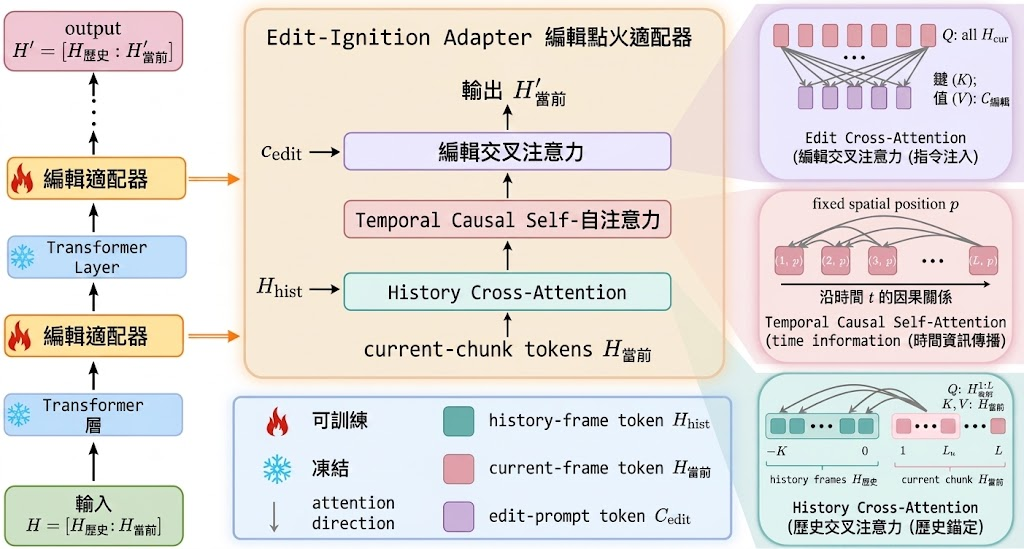
佢嘅做法係喺凍結嘅 video diffusion backbone 上面加一個輕量嘅 Edit-Ignition Adapter,令原本負責串流生成嘅模型多咗三層訊息路徑:歷史畫面引導、時間因果注意力,同埋編輯指令注入。生成時只會喺有新編輯指令到達嘅那一段啟動 adapter,之後嘅片段就交回原模型接力,記憶體負擔唔會一路膨脹。

項目提供訓練程式同多輪推理流程,安裝方法都幾直接,先建 Python 3.11 環境,再裝 requirements.txt,之後下載基座模型 Helios-Distilled。訓練分兩階段,第一階段學基本編輯能力,第二階段再針對低噪聲細節同時間權重做修正;推理則會輸出一串 source.mp4edit_1edit_2 之類嘅連續結果,方便睇到每次指令點樣疊落去。

同一般固定源片逐格改寫嘅方法相比,InfinityEdit 睇重嘅係「延續」而唔係「覆寫」。呢個取捨令佢更貼近長影片、持續鏡頭、反覆編修呢類工作,但亦意味住訓練資料要先做 VAE latent 同文字 embedding 預處理,流程比即插即用工具重少少。官方展示同評估都集中喺長片生成同多輪 sequential editing,顯示佢嘗試解決嘅唔係單次風格轉換,而係編輯累積後仍然保持穩定。

  • 支援多輪順序編輯,每次指令都建立喺上一段已編輯內容之上
  • 以凍結 backbone 配合輕量 adapter,改動集中,唔需要重寫整個生成模型
  • 適合長片生成、持續鏡頭改寫、分段式影片修正呢類場景
  • 訓練同推理都已經拆好流程,但前期資料預處理同模型下載仍然係必要步驟
  • 評估重點放喺長序列穩定性同編輯連貫性,而唔係單一片段嘅局部改動

對做影片生成、研究串流式編輯,或者想將文字指令一路疊加到同一條影片流嘅團隊,呢個項目提供咗一個較完整嘅技術路線。佢唔係追求一次過改到最盡,而係用較細嘅介入,令編輯可以一路接力落去,仲保持住原本生成器嘅長片能力。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Embedding, Video, 框架, Python

OpenChatCut:讓 Agent 編輯真正時間軸影片工具

將 AI 代理直接接入影片剪輯流程,讓文字指令可以落到可編輯的時間軸。它同時保留多軌音訊、字幕、轉場與特效,適合想把剪片交給代理協作的人。

OpenChatCut

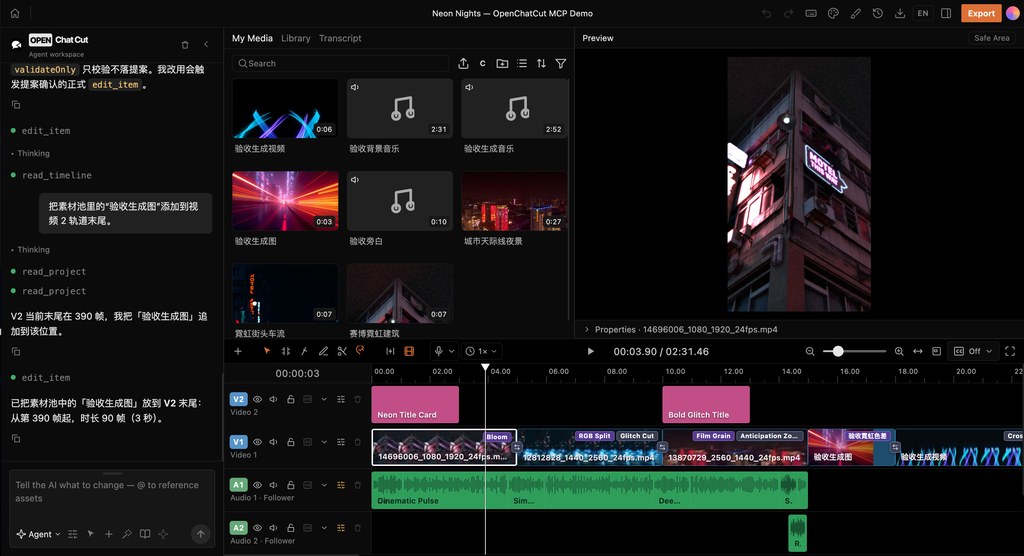
OpenChatCut 是一個本地優先的 AI 影片編輯工具,核心不是產生一段成品影片,而是把文字指令轉成可繼續修改的真實項目。AI agent 可以直接讀、改、匯出同一條時間軸,剪輯結果不會鎖死在單次生成裡。

它把代理工作流和傳統剪輯介面接在一起,支援多軌影片與音訊、轉場、特效、LUTs、縮放、關鍵幀、逐字稿剪輯、停頓處理、講者分離,以及連動字幕。換句話說,AI 不是只幫你寫文案,而是能進一步影響鏡頭切分、節奏和素材編排。

項目比較像一套框架加編輯器的結合,使用場景偏向需要反覆修正的影片工作,而不是一次過生成完就收工。它的取捨也很明顯:功能面走向完整時間軸與多代理共用工具,代價是整體更接近真正剪輯流程,學習成本自然高過單純的聊天式影片工具。

  • 支援 agent-native 工作流,內建 agent 和外部 MCP agents 共用同一組編輯工具
  • 保留 real timeline,方便逐格調整而不是只看輸出成品
  • 逐字稿驅動剪輯,適合訪談、Podcast、教學片段等內容
  • 可處理圖片、影片、語音、音樂、音效與線上媒體搜尋
  • README 標示為 active development,較適合願意接受快速迭代的人

從目前資料看,OpenChatCut 對內容團隊、獨立創作者、以及想把 AI 代理納入剪輯流程的人最有吸引力。它不是替你省掉所有剪輯工作,而是把最花時間的整理、切段和反覆修改,搬進一個仍可手動接手的項目裡。

GitHub

Categories: 開源, Agentic, AI productions, MCP, Video

VoxEMW:把 Mac 變成 1.3 秒回應的私人語音助手

VoxEMW 將語音處理放在 Apple Silicon Mac,手機只需透過瀏覽器或 iOS 客戶端對話,回應速度與音色克隆是最大賣點。

Repository image for emwstudio/VoxEMW

對住手機講完一句話,約 1.3 秒後便聽到固定角色用克隆聲線回答,VoxEMW 屬於開源語音助手項目,處理判停、轉寫、對話調度及語音合成,解決語音對話延遲高、角色聲線難以保持的問題。Mac 負責主要語音管線,只有 LLM 大腦經 DeepSeek API 上雲,日常成本相對可控。

整套流程由 Silero 加 SmartTurn 負責判斷何時真正講完,Qwen3-ASR-0.6B-hf 在 MPS 上轉寫,再由 DeepSeek v4-flash 產生回覆,Qwen3-TTS-1.7B-Base 以 MLX 6bit 執行零樣本音色克隆。參考聲音配合逐字台詞便可註冊角色,首段聲音約 0.5 秒生成;中途打斷時,已播放及已聽內容會寫回上下文,對話較不容易斷層。

一块 4090 跑通 AI 视频通话全栈:Qwen3.8-27B 本地部署,对话时延 2 秒

項目需要 Apple Silicon Mac 作本地伺服器,實測以 M5、16GB 記憶體可以流暢運行,模型及環境約需下載 4GB。瀏覽器可直接連接本機介面;iPhone 或 iPad 則要透過局域網 HTTPS/WSS 連線,並自行處理 TLS 證書、Xcode 簽署及免費帳戶七日側載限制。

• 回應最快 1.26 秒,中位數約 1.6 秒,實際速度仍受網絡及 API 影響
• VAD、STT、TTS 留在本機,DeepSeek API 按 token 收費
• 支援流式字幕、空回覆重試及語音中斷後續接
• 全屏星空會隨說話及聲波變化,增加角色互動感

相比全程雲端方案,VoxEMW 減少語音資料離開家中 Mac,但需要一部 Apple Silicon Mac 長期運行;相比完全離線方案,DeepSeek API 帶來額外費用及資料傳輸考慮。適合想建立固定聲線角色、研究低延遲語音管線,或有 Mac 作家庭伺服器的開發者,普通使用者則要先接受證書、模型環境及 API 金鑰設定等門檻。

GitHub

Categories: 開源, 文字轉語音, Qwen, DeepSeek, API, 框架, Mac, 語音, 蘋果

Comfy-mcp:讓 AI 直接操控本地工作流

Comfy MCP 把本地 GPU、模型與自訂節點交給 AI 管理,令 ComfyUI 工作流可以用自然語言建立、執行及修改。

Comfy

由 MiniMac Code、Claude、Cursor、Codex 等 AI agent 用自然語言建立並執行本地 ComfyUI 工作流,正是 Comfy MCP 提供的核心能力。它屬於 Model Context Protocol(MCP)伺服器,透過 comfy-cli 連接使用者自己的 ComfyUI,處理模型、節點、工作流與輸出圖片之間原本較繁複的操作。

使用者需要先有本地 ComfyUI 及 Python ≥3.10,再把 Comfy MCP 設定到支援 MCP 的客戶端。連接後,AI 可以讀取目前安裝的節點、自訂節點、模型及 GPU,搜尋可用模板,驗證工作流圖表,修改模板欄位,提交非同步工作,監察、取消工作,以及收集輸出的 PNG 檔案。

它和只依賴固定模型目錄或靜態工作流範例的做法不同,會按本機真正載入的內容作判斷,亦能在下載模型前檢查硬件是否有足夠能力。這減少了模型版本、節點依賴和顯存不相容帶來的失敗,但生成速度、可用模型和成功率仍然取決於 GPU、ComfyUI 安裝狀態、自訂節點及工作流本身;項目資料未提供統一基準測試數據。

較適合經常製作影像或影片工作流、需要反覆試驗模型的創作者,以及想把本地 GPU 納入 AI agent 流程的開發團隊。Comfy Cloud 與本地連線可以同時使用,代理可按硬件和任務需要選擇位置,形成雲端彈性與本地模型控制之間的折衷。

  • 自然語言操作:建立、編輯、驗證及執行 ComfyUI 工作流。
  • 讀取本機環境:辨識 GPU、模型、模板及包括自訂節點在內的已載入節點。
  • 完整工作管理:支援提交、等待、監察、取消及讀取失敗結果。
  • 本地與雲端並用:同一個 MCP 連線可按任務需要配合兩種環境。

項目主頁 · GitHub · Skills

Categories: 開源, ComfyUI, Agentic, AI productions, MCP, IDE, Python, Skill 技能

Page 15 of 92
1 13 14 15 16 17 92