Comfyui-MMH3-UltimateUpscale:長片放大不再受顯存牽制

ComfyUI 新增單節點升頻方案,讓 MiniMax H3 長片在有限 VRAM 顯示卡上處理,同時保留原有音訊。

Repository image for bbaudio-2025/Comfyui-MMH3-UltimateUpscale

長片、高解像度加上有限 VRAM(Video Random Access Memory)通常意味著要大幅降低輸出要求,但 Comfyui-MMH3-UltimateUpscale 把 MiniMax H3 的 AV latent 放進單一 ComfyUI 節點處理,目標是完成升頻而不破壞音訊。它屬於 ComfyUI 自訂工具,實際解決的是標準升頻節點無法理解 H3 視訊與音訊巢狀 latent 結構的問題。

節點會先以 temporal chunking 把長片切成重疊時間區段,再按需要進行 latent upscale,之後以 spatial tiling 分割畫面,逐塊完成 diffusion sampling,最後分別進行 spatial stitching 和 temporal stitching。每次只處理一個 tile,峰值顯存取決於單塊大小,而不是整段影片的長度或完整輸出解像度,代價是切割、重疊與拼接會增加處理時間及流程複雜度。

升頻有兩條路線:MMH3 Latent Upscale with Model Params 會載入 minimax h3 latent upscaler 3d .safetensors checkpoint,以 H3 3D model-based upscaler 改善 latent;MMH3 Latent Upscale Params 則只用 nearest、bilinear、area 或 bicubic 插值,不需額外模型,較省資源但不會補回模型推斷的細節。兩者都保留 32-channel audio,音訊部分不會重新取樣。

  • 長片可用 temporal chunking 分段處理
  • 高解像度可用 spatial tiling 控制顯存峰值
  • 單一 MMH3 Ultimate Upscale 節點包辦整個流程
  • 3D 模型升頻與免模型插值可按硬件取捨
  • 輸入必須是已完成去噪的 MiniMax H3 AV latent

這個項目較適合已經用 MiniMax H3 產生影片、但顯示卡顯存不足以一次處理完整片段的 ComfyUI 使用者,也適合需要保留同步音訊的影片製作流程。測試時應由較短片段及較細 tile 開始,確認模型 checkpoint、H3 節點及拼接結果正常,再逐步增加時間分塊和輸出解像度;它降低的是顯存門檻,並不代表長片升頻可以即時完成。
GitHub

Categories: 開源, ComfyUI, Video, Audio, MiniMax

video-shotcraft:電影感產品影片工作室

video-shotcraft 把產品頁面、動態分鏡和聲效製作串成一條工作流,協助 Claude Code 或 Codex 產出更完整的宣傳影片。

video-shotcraft logo

由產品頁面出發,video-shotcraft 會交由 Claude Code 或 Codex 組織分鏡、動畫及聲音設計,再以 Remotion 製作宣傳、發布或示範影片。這個項目屬於 AI agent skill,實際處理的是產品影片製作中截取畫面、安排鏡頭、配合節奏剪接和加入聲效等繁複工序。

畫面不只依賴抽象動畫,工作流包括真實頁面擷取、2.5D camera moves、beat-synced cuts,以及電影感 SFX。152 張 shot recipe cards、209 種 style 和 209 個 motion previews,讓創作者可按產品內容挑選鏡頭語法,再由 native Remotion components 組合成片;元件以 normalized progress t 驅動,並可替換 ACCENT 顏色。

適合需要頻繁製作產品發佈片、marketing video 或 demo video 的設計師、創業團隊及內容製作人。它把分鏡規劃和前端式動態設計交給代理處理,換來較完整的自動化流程,但影片質感仍取決於產品頁面素材、提示內容及人工修訂;提供的資料亦未交代具體安裝步驟、所需帳戶或完整輸出流程。

品質控制來自對候選動作進行八輪逐幀檢視,並與參考片段比較後整理成 recipe cards。README 亦列出完成交付後可輸出可編輯的 JianYing(CapCut CN)草稿,方便按 shot 重新剪接、調速、排序、調色及重建字幕軌道,但相關功能的可用條件仍需以項目最新文件為準。

  • 素材處理:支援真實產品頁面擷取,而非只靠預設圖形。
  • 動態語法:涵蓋 2.5D 鏡頭、節拍剪接和 SFX 配搭。
  • 內容庫:提供 152 張 shot recipe cards、209 種 style 及 209 個預覽。
  • 輸出彈性:以 Remotion 元件組成影片,並列出 JianYing 可編輯草稿匯出能力。
  • 使用限制:目前資料不足以確認安裝、模型依賴和完整執行要求。

GitHub

Categories: 開源, Agentic, AI productions, OpenAI, Video, Anthropic, Dataset 數據集, Skill 技能

4DAnyone 把單鏡頭影片重建 4D 多視角

由一段普通單鏡頭人物影片開始,4DAnyone 生成具一致性的多視角影片,再交由 4DGS 重建可動人物。

4DAnyone

由未校準的 monocular video 出發,4DAnyone 可以為同一個人物生成多個目標視角,接着交給 4D Gaussian Splatting(4DGS)建立可渲染的 4D 人物。這個 GitHub 項目屬於 4D 人物重建工具,處理的是拍攝時沒有多部相機、相機內參或姿態資料,卻想取得多視角動態素材的問題。

它不只把畫面轉成另一個角度,而是嘗試維持不同視角之間的時間和外觀一致性,讓後續 4DGS 重建不必直接面對單鏡頭資料的視角缺口。相較於需要 rig、校準相機或固定三腳架的流程,這個方法換來的是對輸入影片質素和人物動作的依賴。

使用 inference.py 讀取影片,再以 views_per_layerlayer_pitchesstart_yawyaw_span 控制相機層數、上下角度及水平覆蓋範圍。儲存庫提供 Python 3.11、requirements 和第三方 GVHMR 元件的安裝安排,缺少的模型及例子會在首次使用時自動取得;原始資料沒有交代硬件需求、推理時間或量化性能,因此不能把速度表現視為已被驗證。

  • 支援全身或上半身、畫面只包含一人的影片
  • 可生成 6、24、48 個或自訂數量的目標視角
  • 兼容輕微鏡頭移動,以及未知相機內參和姿態的素材
  • 可選 FlashAttention-3 或 SageAttention 加快推理

研究展示內容集中於不同人物影片、動作和場景的泛化能力。需要製作 4D 人物、研究自由視角影片,或建立動態人像資料的團隊;只想快速套用濾鏡或要求即時輸出的使用者,仍要先確認硬件、模型取得方式和影片條件是否符合要求。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, AI productions, 數字人, 視頻模型, Video, Python, 語音

τ₀-VLA:為長程機械人任務補上分層推理

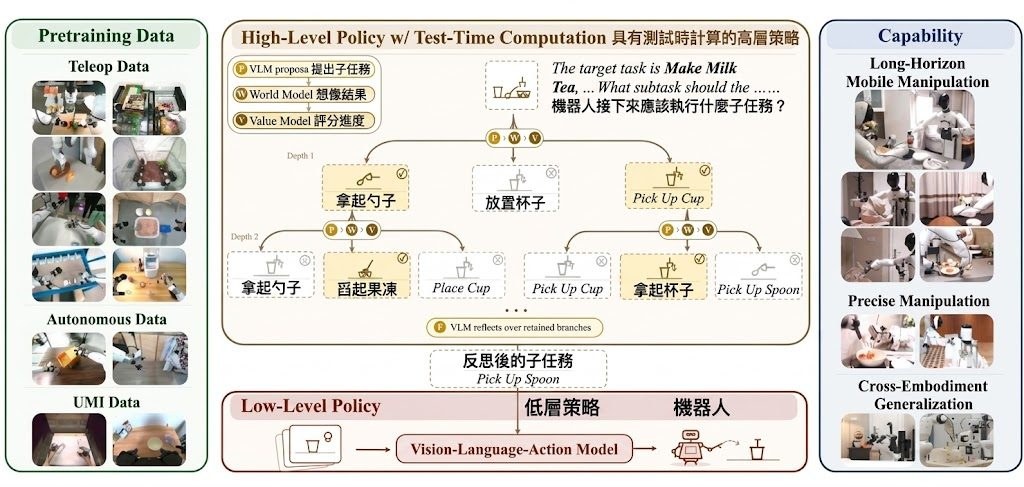
τ₀-VLA 把長程機械人操作拆成高層規劃與低層執行,先想下一步,再落到實際動作。它特別針對多步驟、要記住進度又要回復失誤的場景。

τ₀-VLA overview

τ₀-VLA 是一個機械人基礎模型,主打長程操作任務,例如清理房間、準備食材和沖奶茶這類要連續完成多個步驟的工作。它先用帶記憶的高層策略決定下一個子任務,必要時再用 world-model-guided test-time computation 比較不同做法,然後交由低層策略執行。

這種分層方式比單次前向推理更適合處理長流程,因為模型不只要做動作,還要跟進已完成進度、預測結果,再決定下一步。對需要機械人跨場景操作的團隊來說,比只處理單一步驟的控制模型更接近真實工作流程。

  • 高層負責規劃子任務,低層負責具體控制
  • 會在需要更多推理時做分支搜尋,不是即時拍板
  • 低層策略結合 Qwen3.5 vision-language backbone 與 Mixture-of-Transformers action expert
  • 訓練資料來自 40,115 小時真實機械人數據,涵蓋多模態協同訓練
  • 目前公開 v1 只支援 joint-control checkpoints,EEF serving 未提供

官方提供 Python 3.11、CUDA 12.8、PyTorch 2.7.1 的參考環境,也有 example_data 同配置的 post-training 例子,可用來接入自己的資料集或機械人設定。文中四個長程任務涵蓋 13 至 25 個步驟,重點不只是在動作準確,還包括進度保持、結果驗證和失誤後恢復。

對做機械人研究、具身智能系統,或要把語言理解和實體控制接起來的團隊,這個項目提供了一個較完整的分層基線;限制也很明確,公開版本先集中在 joint-control,較適合有相應訓練與部署條件的環境。

項目主頁 · GitHub · 模型

Categories: 開源, 多模態模型, 模型訓練, Qwen, NVIDIA, VLA, World-Action Model, Python

NAPE 簡化自監督音訊片段訓練

NAPE 以因果 Transformer 預測下一個音訊 patch embedding,省去解碼器與 tokenizer,探索更精簡的音訊表徵學習方法。

NAPE Architecture

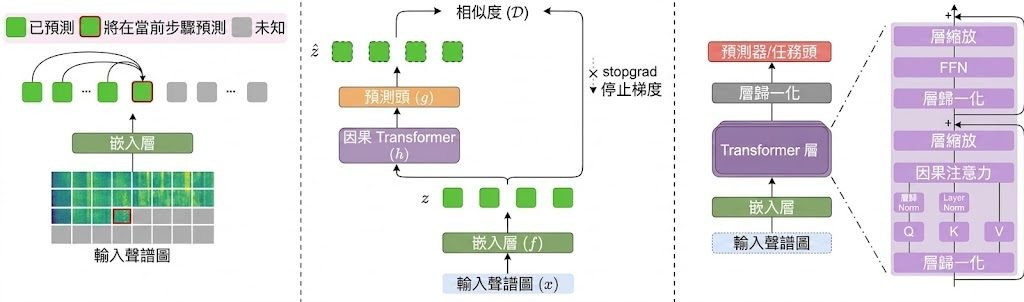
音訊模型要兼顧訓練成本、表徵能力與模型規模,往往需要加入多個輔助模組。NAPE(Next Audio Patch Embedding prediction)是一個自監督音訊表徵學習框架,將 log-mel spectrogram 切成 patch,再由因果 Transformer 根據前面的片段預測下一個 patch embedding。

NAPE 沒有 reconstruction decoder、acoustic tokenizer、student-teacher 架構或額外正則化損失。它依靠三個機制維持學習訊號:causal masking 隱藏未來位置、prediction shift 要求位置 t 預測 t+1,以及 stop-gradient 固定目標 embedding,避免模型退化成輸出相同向量。

二維 spectrogram 會按指定 scanning order 轉成一維序列,研究涵蓋 raster、diagonal、zigzag 和 time-major 四種排列;其中 raster、diagonal 及時間方向的排列較符合聲音事件的發展。模型在 AudioSet 預訓練,再於 AudioSet-2M、AudioSet-20K、ESC-50、Speech Commands V1/V2 和 IEMOCAP 進行微調或 linear probing,資料顯示它在多項任務取得 state-of-the-art fine-tuning 結果,並具備穩定的跨規模擴展能力,但原始資訊沒有提供各項具體分數。

要求系統有 Python 3.10、PyTorch 2.8.0 和 Transformers 4.56.2 的環境,並提供 requirements 檔及部分資料集處理程式;ESC-50、Speech Commands V1/V2 和 IEMOCAP 有下載腳本,AudioSet 則要自行處理涉及 YouTube 的下載流程。研究團隊亦列出程式碼及預訓練 checkpoint 的發布資訊,但 Hugging Face checkpoint 仍標示為待辦,不能把完整模型取得流程視為已經齊備。

  • 訓練訊號精簡:只用下一個 patch embedding 預測與 stop-gradient。
  • 適合音訊表徵:可支援語音指令、環境聲音及情緒辨識等任務。
  • 排列順序有影響:spectrogram 的線性化方式會改變模型看到的時間關係。
  • 測試門檻清楚:需要 AudioSet 或下游資料集,以及 W&B 追蹤實驗。
  • 限制在資料流程:AudioSet 不提供同等簡化的下載方式,checkpoint 取得狀態亦未完全明確。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型訓練, Audio, Python, 語音

WithEveryone 多人合照不再撞臉

復旦大學、騰訊混元與香港大學研究團隊,嘗試一次保留五至十個人物身份的群組生成。

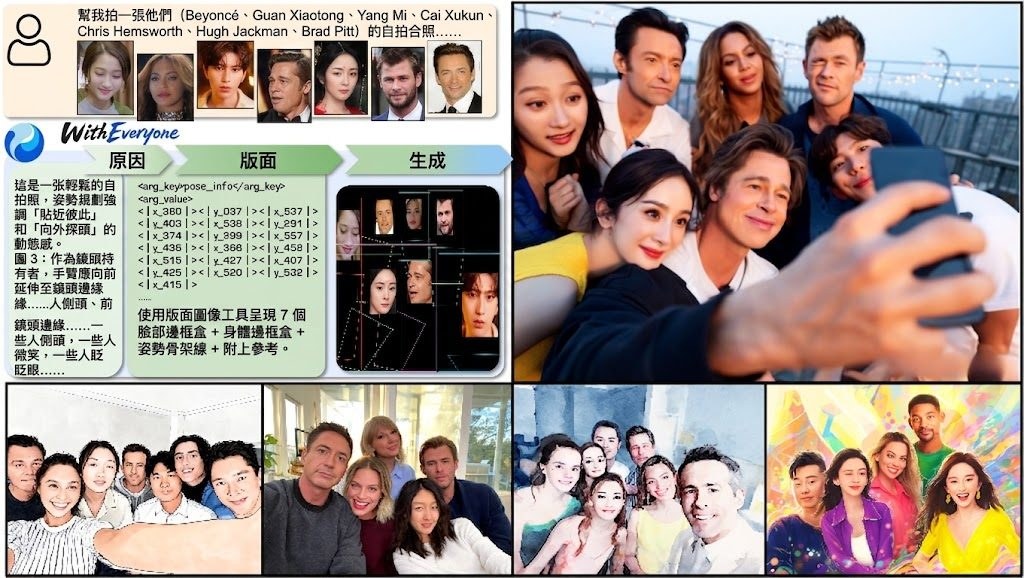
WithEveryone teaser

復旦大學、騰訊混元(Hunyuan)及香港大學的研究團隊共同開發 WithEveryone,針對 AI 生成多人合照時人物身份容易混淆的問題,讓五至十個參考身份可以同時出現在連貫場景中。它屬於群組影像生成研究項目,核心價值是維持每個人「誰是誰」的對應關係,而不只是增加畫面人物數量。

系統會把每個參考人物轉換成獨立的 identity token,再透過 Layout CoT 預先推理人物、臉部、身體區域與姿勢的位置,最後交由 renderer 生成視覺條件。Layout-Grounded ID Loss 會在指定臉部區域提供身份監督,ID Representation Forcing 則要求模型在合成前先為每個身份建立預測,減少多人場景中的錯配。

研究展示提供了 63 組生成結果,並在 identity-disjoint benchmark 上比較身份保真度與複製參考圖程度:WithEveryone 的 ArcFace similarity 為 0.614,高於 GPT-Image-2 的 0.566;Copy-paste score 為 0.055,低於 GPT-Image-2 的 0.169。這表示它一方面維持人物特徵,另一方面較少直接照搬參考圖,但目前資料未提供更完整的速度、硬件需求或不同人數下的細分結果。

目前 GitHub 儲存庫尚未提供可下載的研究版 checkpoint,亦沒有完整安裝及測試流程。原因是研究版本依賴的 foundation model 授權不容許公開 checkpoint;團隊正以支援開源發佈的 foundation model 訓練新版本,待程式碼及 checkpoint 準備好後才會分享。

  • 支援五至十個參考身份的群組影像生成
  • 以 identity token 綁定人物,配合身份感知的版面推理
  • 透過 Layout-Grounded ID Loss 監督指定臉部區域
  • 研究結果在 ArcFace similarity 及 Copy-paste score 上勝過 GPT-Image-2
  • 現階段只能閱讀研究展示,未能按儲存庫資料自行安裝重現

對需要製作多人宣傳照、角色群像或指定人物場景的影像研究團隊,這個方法提供了比單純堆疊參考圖更完整的身份與構圖處理思路。一般創作者暫時仍要等待開源版本,因為未公開 checkpoint 令項目現階段更接近研究展示,而不是可即時採用的生成工具。

項目主頁 · GitHub

Categories: 開源, 香港大學, 騰訊, 模型, 多模態模型, Image, 香港, Dataset 數據集

ForgeWM 把遊戲世界模型推向 72 FPS 即時互動

由中大、騰訊等團隊開發的 ForgeWM,將遊戲畫面生成壓縮至一至四步,讓鍵盤、滑鼠及手掣輸入能即時改變虛擬世界。

ForgeWM

中香港中文大學、騰訊 PCG、復旦大學、上海人工智慧實驗室及香港科技大學的研究團隊,將 ForgeWM 做成開源的 action-conditioned video world models 訓練項目,處理遊戲輸入與連續畫面生成難以兼顧的問題。它以 Matrix-Game 2(MG2)為基礎,讓模型根據鍵盤、滑鼠或 gamepad 操作即時推演遊戲畫面。

ForgeWM 的價值在於把生成步數降至 1、2 或 4 步,換取更低延遲的互動體驗;取捨是畫面質素、控制準確度與推理速度仍要依賴訓練資料和硬件。相較只展示影片生成的做法,ForgeWM 直接處理 frame-aligned 的動作訊號,並將同一套流程移植到另一個 gamepad 驅動的 FPS 領域。

  • 一套四階段流程:bidirectional SFT、teacher-forced causal AR、consistency distillation、on-policy DMD
  • ForgeWM-1、ForgeWM-2、ForgeWM-4 分別對應一、二及四步生成
  • 單張 H20、352×640 畫面下,1-step 模型最高達 72 FPS
  • 完整公開 weights、training code 及 pre-encoded data

模型並非各自獨立訓練:Stage 0 先對目標遊戲作 bidirectional fine-tuning,之後固定為教師;Stage 1 將生成器改成 causal AR,Stage 2 壓縮 sampling trajectory,Stage 3 再用學生自行 rollout 的結果進行 on-policy matching。這個結構讓 ForgeWM-1、-2、-4 可從相同基礎流程按步數預算建立。

研究、遊戲 AI 及需要即時互動生成的團隊較容易受益,尤其適合測試鍵鼠控制的 Minecraft 或 gamepad FPS。資料提供的指標包括 168 ms per chunk、72 FPS 及 8×H20 完整訓練配置;模型及數據連結整理環境,要預留 8 張 H20 重現完整訓練流程。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, 上海人工智慧實驗室, 騰訊, 世界模型, 模型訓練, Video, World-Action Model

EnvHarness 讓靜態環境按代理弱點持續進化

EnvHarness 不改動環境內部程式碼,透過可堆疊元件調整任務、規則與觀察,讓代理獲得更有針對性的訓練。

example

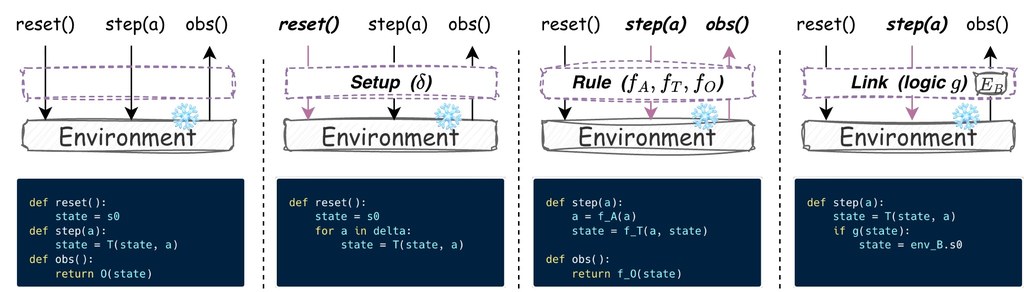
Google Cloud AI Research 聯同 Washington University in St. Louis、Google Cloud、University of North Carolina at Chapel Hill 的研究人員,開發了 EnvHarness。這個開源框架處理的是大型語言模型(Large Language Model,LLM)代理面對靜態互動環境時,任務和回饋無法隨能力變化的問題;它保留原有環境及驗證器,改由外加層控制代理所見、可做的行動和起始狀態。

代理在同一批任務上反覆練習,往往會很快解完,環境卻不能因應弱點提供新挑戰。EnvHarness 是一個面向代理學習的開源框架,透過標準 resetstep 介面包裹固定環境,調整代理的起始狀態、可用行動與觀察內容,同時保留原有的成功判定器。

它把控制拆成三類可組合元件:Setup 負責重塑初始狀態,Rule 改變互動規則、行動限制及回饋,Link 則把另一個環境的任務接入目前流程。設計者代理會讀取目標代理的操作軌跡,診斷失誤,再以 Python 寫出元件、測試及修訂,令訓練環境隨代理能力一同調整。

• 不需修改 ALFWorld、WebArena、SWE-bench Verified 等環境的內部程式碼
• 任務與 verifier 保持來源 benchmark 的可信判定
• 元件可自由堆疊,適合針對特定弱點改造互動流程
• 可在項目提供的瀏覽器 Playground 以 Toy24Env 觀察環境狀態與代理視角

在 ALFWorld、WebArena 及 SWE-bench Verified 的 EnvHarness 訓練結果分別達到 68.3、41.6 及 52.6,展示相對基準最高 5.9 個百分點的提升。不過,效果取決於設計者代理能否準確診斷軌跡,以及改寫後的環境是否真的對應目標弱點,並非單靠套上元件就能保證改善。

它的取捨是把環境設計工作轉移到 Setup、Rule、Link 的程式編寫與反覆測試,換來跨 benchmark 重用和較低的環境改造成本。

項目主頁 · GitHub

Categories: 開源, Agentic, Google, Python, Dataset 數據集

FACET-Terminal:讓終端任務由可執行環境先行生成

FACET 把技能、Docker 環境、解法與驗證器連成同一狀態,產出可真正執行驗證的終端任務。

FACET: Preserving Source Intent and Executable State in Terminal Task Synthesis

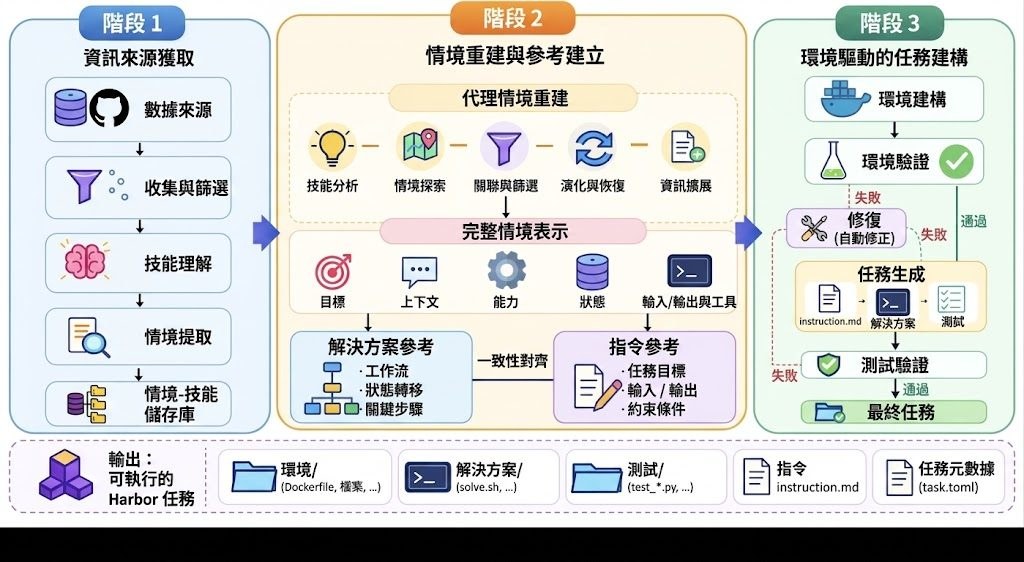
終端 AI Agent 最怕指令寫得合理,環境、解法和驗證器卻互相對不上。FACET(Fine-grained Agentic Construction of Executable Tasks)是一套終端任務合成框架,先建立並修復 Docker 環境,再讓指令、參考解法和驗證器共享同一套執行狀態,處理複雜任務難以穩定測試的問題。

項目由 71,341 個來源技能整理出 7,852 條場景—技能種子,最後取得 6,078 個通過執行驗證的任務,並從成功 rollout 篩選約 1.2K 條完整軌跡,用於監督微調 Qwen3.5 系列模型。環境中的檔案、路徑、套件、連接埠、資料結構和測試資料會沿流程傳遞,減少純文字交接造成的落差。

資源包括 FACET-Terminal-Tasks-6k 數據集,以及 FACET-Terminal-Qwen3.5-4B、9B 和 27B 模型。要重現任務合成流程,需要 Python 3.11–3.13、uv、Docker 和模型 API;配置與 Python 程式集中在 facet/,並提供 FORWARDREVERSEJOINT 三種生成策略作比較。

Terminal-Bench 2.1 的三次獨立執行平均結果顯示,4B、9B、27B 模型分別由 17.60、27.34、40.82 提升至 24.72、35.58、47.57;4B 相對提升 40.5%,27B 更接近同設定下 Qwen3.5-397B 的 49.06。這批數據規模仍然有限,任務質素亦依賴 Docker 環境和驗證器是否正確,較適合研究 Agent 訓練、Terminal-Bench 評測及需要可重現終端操作的團隊。

  • 資料基礎:6,078 個通過執行驗證的任務
  • 生成方式:環境先行,指令、解法與驗證器共享狀態
  • 公開模型:Qwen3.5 4B、9B、27B
  • 評測結果:27B 在 Terminal-Bench 2.1 達 47.57
  • 適合場景:終端 Agent 訓練、任務合成及可重現評測

項目主頁 · GitHub · 模型

Categories: 開源, 上海人工智慧實驗室, Agentic, 模型, 模型訓練, API, Python, 中國, Dataset 數據集

Evoke 把世界模型推向可互動長片段

Evoke 讓生成世界記住鏡頭走過的地方,並可在畫面持續生成時改變指令,突破短片段與固定提示詞的限制。

logo light

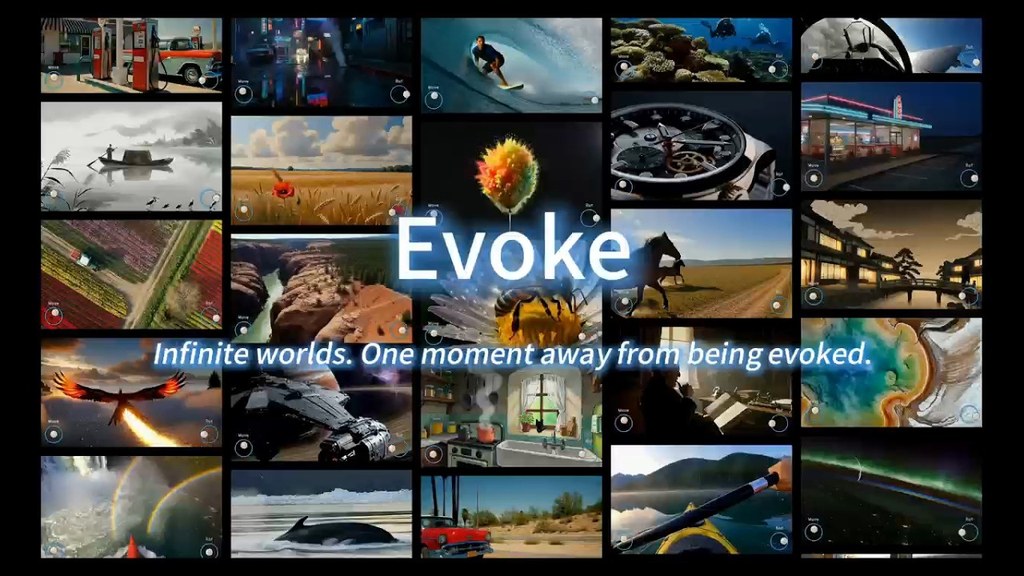
鏡頭由使用者操控時,畫面不必每隔幾秒重新開始;Evoke 會保留場景幾何,按鏡頭位置取回需要的資訊,讓探索可以延續更長時間。它屬於開源的自回歸世界模型,實際處理的是互動影片生成中的空間記憶、持續生成與中途改變指令三個問題。

模型採用 14B 參數、三步採樣及 classifier-free guidance(CFG)免費的生成流程,在單張 H200 上以 2.11 秒生成 1.5 秒、384×640 影片。外部 camera-indexed world state bank 將世界狀態與 denoiser 分開保存,配合按需檢索令每一步的上下文維持有界;代價是推理需要依賴鏡頭姿態與狀態管理,並非單純輸入文字便可獨立生成長片。

Evoke 以 per-chunk conditioning 支援生成途中重新提示,例如在原有場景加入風暴、物件或事件,而不需要剪接或重啟。訓練端亦為長時段 self-forced supervision 重建 teacher,加入 chunk-wise grouping、distant-frame retrieval 和 linear-attention global state,讓記憶及計算量按長度線性增加;README 同時提醒,訓練與推理必須使用一致的 warp / attention 配方,否則可能出現不易察覺的失配。

WBench 上,Evoke 以三步世界模型取得目前最佳成績,並在 VBench-Long 及 VBench-2.0 維持競爭力,但項目資料未提供完整硬件需求、互動控制介面或不同 GPU 的速度比較。研究團隊、遊戲原型製作者及需要長時間可操控影片的開發者,可從 Hugging Face 權重、GitHub launcher 和 examples 開始測試;使用前應先確認 H200 級硬件、模型下載容量,以及本地環境是否符合程式依賴。

• 三步、CFG-free,單張 H200 每 2.11 秒生成 1.5 秒影片
• 以 camera-indexed world state bank 保存跨片段場景記憶
• 生成途中可重新提示,改變接下來的事件或環境
• WBench 領先,VBench-Long 與 VBench-2.0 保持競爭力
• 開源權重與程式可供研究及互動影片原型測試

項目主頁 · GitHub

Categories: 開源, AI productions, 視頻模型, 世界模型, Video

Page 16 of 92
1 14 15 16 17 18 92