NAPE 簡化自監督音訊片段訓練

NAPE 以因果 Transformer 預測下一個音訊 patch embedding,省去解碼器與 tokenizer,探索更精簡的音訊表徵學習方法。

NAPE Architecture

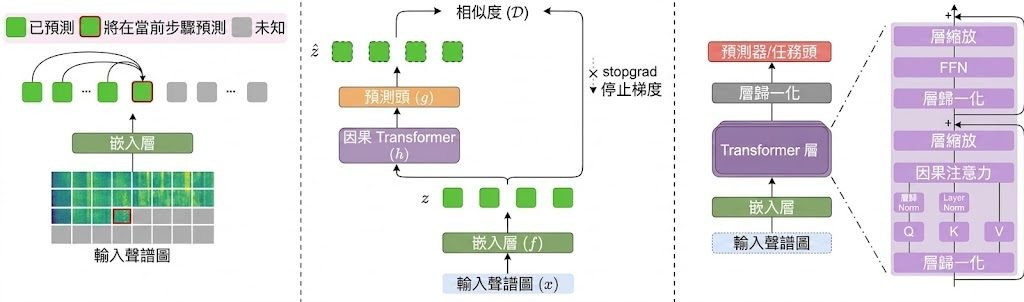
音訊模型要兼顧訓練成本、表徵能力與模型規模,往往需要加入多個輔助模組。NAPE(Next Audio Patch Embedding prediction)是一個自監督音訊表徵學習框架,將 log-mel spectrogram 切成 patch,再由因果 Transformer 根據前面的片段預測下一個 patch embedding。

NAPE 沒有 reconstruction decoder、acoustic tokenizer、student-teacher 架構或額外正則化損失。它依靠三個機制維持學習訊號:causal masking 隱藏未來位置、prediction shift 要求位置 t 預測 t+1,以及 stop-gradient 固定目標 embedding,避免模型退化成輸出相同向量。

二維 spectrogram 會按指定 scanning order 轉成一維序列,研究涵蓋 raster、diagonal、zigzag 和 time-major 四種排列;其中 raster、diagonal 及時間方向的排列較符合聲音事件的發展。模型在 AudioSet 預訓練,再於 AudioSet-2M、AudioSet-20K、ESC-50、Speech Commands V1/V2 和 IEMOCAP 進行微調或 linear probing,資料顯示它在多項任務取得 state-of-the-art fine-tuning 結果,並具備穩定的跨規模擴展能力,但原始資訊沒有提供各項具體分數。

要求系統有 Python 3.10、PyTorch 2.8.0 和 Transformers 4.56.2 的環境,並提供 requirements 檔及部分資料集處理程式;ESC-50、Speech Commands V1/V2 和 IEMOCAP 有下載腳本,AudioSet 則要自行處理涉及 YouTube 的下載流程。研究團隊亦列出程式碼及預訓練 checkpoint 的發布資訊,但 Hugging Face checkpoint 仍標示為待辦,不能把完整模型取得流程視為已經齊備。

  • 訓練訊號精簡:只用下一個 patch embedding 預測與 stop-gradient。
  • 適合音訊表徵:可支援語音指令、環境聲音及情緒辨識等任務。
  • 排列順序有影響:spectrogram 的線性化方式會改變模型看到的時間關係。
  • 測試門檻清楚:需要 AudioSet 或下游資料集,以及 W&B 追蹤實驗。
  • 限制在資料流程:AudioSet 不提供同等簡化的下載方式,checkpoint 取得狀態亦未完全明確。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型訓練, Audio, Python, 語音

VoxWeave:Windows 本機 RVC 變聲工作站

把音頻、影片、麥克風同批次任務收在同一個桌面工作站,VoxWeave 走的是本機離線處理路線。它重點解決變聲流程分散、結果難追蹤,同時保留即時變聲與批量轉換。

VoxWeave

VoxWeave 是一套面向 Windows 的 RVC(Retrieval-based Voice Conversion)變聲工作站,定位很清楚:把離線轉換、即時麥克風變聲、批量處理和結果追蹤放進同一個桌面流程。它適合要穩定處理音頻、歌曲或影片音軌的人,也適合需要交付產物、查看失敗原因和保存位置的工作場景。

使用方式偏向本機部署而不是雲端服務。EXE 不內置大體積環境或模型,首次使用可在介面內按需下載經哈希校驗的運行組件與推薦模型;來源倉庫也保留 Linux 和 macOS 的邊界,但目前真機驗收集中在 Windows 11 與 NVIDIA CUDA。

它和常見變聲工具最大的分別,在於把狀態、任務、批量規則、即時會話、產物與歸檔都收進 SQLite 作為單一真源,連診斷匯出都會帶上運行時、模型和日誌清單。這種做法讓問題排查和重試更直接,但代價是它明確不提供虛擬聲卡、模型訓練或 GPT-SoVITS,定位比完整聲音工坊收得更窄。

  • 支援音頻、影片、資料夾和麥克風輸入,流程集中。
  • 可做離線轉換、即時變聲與批量處理,結果可追蹤。
  • 模型按原路徑登記,會計算權重和索引的 SHA-256,不會複製或改名。
  • URL 模型需要提供來源、最終大小和 SHA-256,授權不明時會明確標示。
  • 目標較適合 Windows 本機使用者、內容製作流程,和需要留存產物與錯誤記錄的團隊。

GitHub

Categories: 開源, AI productions, NVIDIA, Mac, Linux, 語音, Win

Ex-Omni-2D 直接對話生成同步發聲與表情的數字人影片

Ex-Omni-2D 讓對話模型同時輸出文字、個人化語音與表情同步的頭像影片,以多碼本語音單元串接語音與畫面,並提供 Teacher 與 Prefix-Streaming Student 兩種部署模式。

Ex-Omni-2D framework

想讓 AI 數字人不只是「會打字」,而是真的「邊說邊演」?香港中文大學(深圳)與 LIGHTSPEED 合作開源的 Ex-Omni-2D,正是針對這個目標設計。它是一個開源對話框架,接受多模態查詢、參考圖像與參考音訊後,先由語言模型輸出一份結構化的 Visual Thought Plan(VTP),再依此生成文字回應、個人化語音,並產出嘴形與動作同步的頭像影片。

傳統做法通常把語音合成與人物影片視為兩條獨立管線,需要額外對齊文字、聲音與嘴形,容易出現時間錯位。Ex-Omni-2D 的差異在於採用 16 個 codebook 構成的原生多碼本語音單元,作為語音與影片共享的聲學與時序介面:同一組語音單元既驅動 TTS,也作為影片生成器的緊緻條件,從而降低跨模態錯位的風險。

影片生成路徑提供兩種互補模式:Full-sequence Teacher 採雙向注意力,追求最高畫質;Prefix-Streaming Student 則是蒸餾而來的少步數 block-causal 版本,支援 2、4、8 步串流推論,方便在工作站、GPU 伺服器甚至 Hugging Face Spaces 上做漸進式部署。

這個項目的重點:

  • 對話原生影片:視覺行為直接從多模態對話上下文規劃,不必再手動撰寫影片提示詞。
  • 結構化 VTP:明確定義首幀、場景、情緒、動作風格與動作細節,方便後續控制與除錯。
  • 共享語音介面:16 個 codebook 同步驅動語音合成與人物動作。
  • 品質與效率取捨:Teacher 負責最高畫質,Student 支援 2/4/8 步串流。
  • 彈性部署:同一套代碼可在個人工作站、GPU 伺服器或 HF Spaces 執行,並提供線上 Demo 試玩。

在串流場景中,作者指出 Prefix Streaming 從第 9 至 16 chunk 的一致性明顯較強,將 last-to-first consistency error 降低 21.4%,這對需要長時間維持角色身份一致的應用相當關鍵。論文亦提到 Prefix Streaming 能減少長序列累積形變,同時保留參考圖像的人物外觀。

較適合的對象包括需要快速打造可對話 AI 助手、虛擬主播、客服分身或教學數字人的團隊;對研究多模態對話、語音驅動動畫的人來說,這份開源代碼、模型權重與 arXiv 論文也是一個方便的起點。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 騰訊, 文字轉語音, AI productions, 數字人, 多模態模型, 視頻模型, Qwen, 香港, 語音

NeMo Speech:NVIDIA 把 ASR、TTS、語音 LLM 收進同一條 PyTorch 生產線

NVIDIA 把語音研究最常碰到的 ASR、TTS 與 Speech LLM 整合成單一框架,研究員和工程師不用再東拼西湊,也能用預訓練權重快速微調與部署。

Repository image for NVIDIA-NeMo/Speech

語音 AI 的痛點往往不是模型不夠強,而是開發者要同時面對 ASR、TTS、串流識別等好幾套獨立工具鏈。NVIDIA NeMo Speech 把這些任務收進同一個 PyTorch 框架,並提供預訓練權重,讓研究員可以把精力花在實驗設計,而不是從頭搭建訓練流程。

從近期更新可以看到三個值得留意的方向:MagpieTTS v2607 把支援語言擴展到 12 種,新增阿拉伯文、韓文、葡萄牙文;Nemotron-3.5-ASR-Streaming-0.6B 在單一 H100 上能同時處理最多 2400 條串流,並允許把延遲控制在 80ms 到 1s 之間;Parakeet-unified-en-0.6b 則把離線與串流推理合併成一個英文模型,最短延遲 160ms。

Nemotron 3 VoiceChat 把 LLM、骨幹與 TTS 解碼器串成全雙工對話,能自然處理打斷與插話,這對於想建立語音助理的團隊是比較完整的一條路。Fastconformer 等快取感知架構是背後的工程功臣,讓長音訊串流不需要犧牲太多吞吐量。

訓練階段必須配備 NVIDIA GPU 與 CUDA 環境,推薦使用 PyTorch 2.7 或以上版本;現時倉庫正進行拆分,下一個主要版本預定 2026 年 6 月發佈,短期內穩定使用可以考慮 26.02 NGC container。對做客服、會議記錄、媒體字幕或有聲書生成的團隊,這套框架能把語音模型從原型走到部署的距離明顯縮短。

重點摘要:

  • 單一框架覆蓋三大任務:ASR、TTS 與 Speech LLM 都在 NeMo Speech 內,減少切換工具鏈的成本。
  • 串流效能突出:Nemotron-3.5-ASR-Streaming-0.6B 支援 40 種語言,單張 H100 可並行 2400 條流,延遲可調。
  • 多語 TTS 擴張:MagpieTTS v2607 覆蓋 12 種語言,並提供 Hugging Face 線上 demo。
  • 全雙工語音助理:Nemotron 3 VoiceChat 把 LLM 與 TTS 解碼器結合,支援自然打斷與低延遲對話。
  • 硬體要求明確:至少配備 80 GB 記憶體。訓練需 NVIDIA GPU 與 CUDA,PyTorch 2.7 或以上版本,推理可在 CPU 或 GPU 執行。

GitHub · 模型

Categories: 開源, 文字轉語音, Agentic, NVIDIA, 框架, Python, 語音, Dataset 數據集

Hermes WebUI 把代理搬到瀏覽器

想長開一個會記住上下文的 AI agent,又不想長期困在 terminal,Hermes WebUI 正好補上這個缺口。它保留 CLI 能力,同時把多裝置存取整理得更順手。

Workspace file browser with inline preview

把一個長時間運行、會累積記憶的 autonomous agent 放到瀏覽器,而且幾乎不削弱原本 CLI 操作,正是 Hermes WebUI 最值得留意的地方。它屬於 Agent 介面工具,實際處理的是 Hermes Agent 在日常使用裡不夠方便的互動問題,讓你不必只靠 terminal 或訊息 app 才能管理對話、工作區與設定。

跟不少另起一套前端堆疊的 Web 介面不同,Hermes WebUI 走得相當克制:不用 build step、不用 framework、也不用 bundler,只靠 Python 和 vanilla JS。這種取捨帶來的好處很直接,部署比較輕、維護點較少,亦更貼近原本 Hermes Agent 的運行方式;代價是它的重點明顯放在功能對齊,而不是做一個花巧的前端展示層。

介面設計本身也有明確工作流考量。三欄布局把 session、聊天區與 workspace 檔案瀏覽分開,模型、profile 同 workspace 控制則固定放在 composer footer,減少來回切換;再加上 token context ring、Hermes Control Center、voice、mobile 與主題切換,較適合需要長時間跟 agent 協作、又要隨時查看檔案與工具呼叫紀錄的人。

  • 1:1 對齊 Hermes CLI,終端可做的操作基本都能在 WebUI 完成
  • 支援 session、workspace、voice、profiles、安全設定與手機存取
  • 可用自動探索、手動啟動、SSH tunnel、Tailscale、Docker、Nix 等方式部署
  • 建基於既有 Hermes Agent 與現成模型,毋須另設一套推理環境

安裝理解上,它不是獨立 agent,而是 Hermes Agent 的瀏覽器前端,所以前提仍然是先把 Hermes 本體跑在伺服器,再用 bootstrap、start/ctl 腳本、Docker 或 Nix module 把介面掛上去。在存取方式、部署彈性與跨裝置操作一致性;對於已經在自架 AI agent、想把 CLI 工作流延伸到桌面與手機的人,這個項目的價值相當明確。

GitHub

Categories: 開源, Agentic, 框架, Python, 語音

LISA:讓 MEG 語音解碼由準確走向可解釋

LISA 把腦磁訊號配對到語音嵌入,並保留空間、時間與聲音特徵線索。

LISA architecture and analysis pipeline

將一段 3 秒、208 通道的腦磁圖(magnetoencephalography,MEG)訊號配對到聽到的語音,同時追查證據來自哪個腦部位置與時間段,正是 LISA 要處理的問題。它屬於可解釋神經解碼模型,透過對比式檢索目標,把 MEG 片段映射至對應音訊的 Wav2Vec2 表徵。

LISA 的價值不只在於找出正確語音片段,而是把空間濾波器、時間濾波器和分支結構直接保留下來,方便轉換成感測器空間或皮質來源的分析結果。它採用幾何感知的空間注意力,配合 25 個可解釋分支,每個分支使用 150 ms 時間核心,再接兩個時間卷積區塊。

在 MEG-MASC 實驗中,模型於 1,005 個候選語音片段取得 39.75 ± 0.34% Top-1 準確率及 70.4% Top-10 準確率;完整解碼器有 486,619 個可訓練參數,約為 Défossez et al. 方法的二十分之一。配對 MEG 遮蔽分析亦發現,19 項測試聲音特徵中有 15 項對檢索有貢獻,惟這些結果仍屬特定資料集與實驗設定,不能直接推廣至所有腦訊號任務。

  • 可抽取空間及時間濾波器,支援後續神經科學分析
  • 內置 preprocessing、training、evaluation 與 analysis 程式
  • Python 3.11 的 LISA 環境可用於 synthetic demo 或新資料集
  • CPU 可以執行,訓練階段使用 CUDA-capable GPU 會較合適
  • 重現 MEG-MASC 清理流程,儲存空間峰值約需 300 GB

研究人員可先用 synthetic demo 熟習張量流程,再按文件改接其他 EEG(electroencephalography,EEG)或 MEG 資料。相較只追求檢索準確率的深度解碼器,LISA 以較小模型換取可追溯性;需要完整重現結果的人,仍要準備資料集、環境及較大的儲存空間。

項目主頁 · GitHub

Categories: 開源, 模型訓練, 框架, Medical醫學, 語音

VocalRender 用樂譜直接生成人聲歌唱

寫歌唔再要逐音節對時長。VocalRender用歌詞、MIDI同節奏,直接把譜面轉成更自然的歌聲。

Comparison of duration-based, reference-based, and the proposed score-native singing voice synthesis inputs

寫旋律同填詞的人,最在意往往唔係逐個 phoneme 對時間,而係輸入一份像作曲流程會用到的譜面後,能否聽到有表情、會跟拍子走、又唔會太死板的人聲。VocalRender就瞄準呢個位置:它屬於 singing voice synthesis(SVS)模型,處理的是把歌詞、MIDI pitches、note values 同全域 tempo,連同一段提示音色片段,直接渲染成 48 kHz 歌唱音訊。

它和常見 duration-based SVS 或 reference-based 系統的分野相當明確。前者通常要為每個字或 phoneme 準備精確時長,後者又依賴 time-aligned audio 或 F0 curve;VocalRender改為讀 composer-oriented symbolic scores,讓模型自己在跟譜之下安排較自然的 timing 與 expressive deviations。對作曲、demo 製作、旋律草稿驗證,這種做法比硬性對齊更貼近創作流程。

技術路線亦有清楚取捨。它先用 interleaved lyric-note representation 保留字詞與音符對應,連 melisma 這類一個音節跨多個音都能明確表示;再由 Audio VAE 壓成 continuous acoustic latents,保住 pitch、timbre 同 articulation 細節,之後交給 autoregressive diffusion 建模,其中 AR Transformer負責較整體的 prosody sketch 與長度預測,LocDiT再補回高保真局部聲學內容。

  • 支援資料前處理、訓練同推理,屬於可重現研究流程的最小開源版本
  • 可配合 Hugging Face 模型、CrawlSinger-OS 資料集同官方 Audio Demo 一齊理解效果
  • 輸入核心是 word / pitch / note interleaved score prompt,而唔係逐 phoneme 時長標註
  • 評估線索包括 SingMOS 與 AES,當中 AES 會看 content enjoyment(CE)同 production quality(PQ)

部署時要準備提示音色片段,亦要理解它重視的是「按譜生成有表情歌聲」,不是完全取代後期混音或商業級歌手複製。對需要快速聽到作曲結果、又唔想先做大量時間對齊標註的團隊,VocalRender的價值相當直接,限制亦同樣清楚:它把創作入口大幅簡化,但音色條件、資料品質同最終審美仍然會左右成品。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Audio, 語音

RVC WebUI:低門檻變聲框架的實用與代價

這個語音音色轉換框架把訓練、推理和即時變聲放進同一個網頁介面,重點是讓少量語音資料也能做出可用效果。它的強項在於速度、易用性和模型融合,代價是硬件與延遲條件仍會影響體驗。

Repository image for RVC-Project/Retrieval-based-Voice-Conversion-WebUI

RVC(Retrieval-based Voice Conversion)WebUI 把語音音色轉換、變聲推理和即時變聲收進同一套 Web 介面,適合要快速做 AI 歌聲、配音修音或聲音風格替換的人。它不是單純展示效果,而是把訓練、檢測、推理和即時輸出串成一條可操作流程,降低了進入門檻。

這個項目主打少量資料也能訓練出可用模型,官方建議至少準備 10 分鐘低底噪語音。它採用 top1 檢索去替換輸入特徵,減少音色洩漏,並用 InterSpeech2023-RMVPE 做人聲基頻提取,處理哑音問題時速度快、資源占用也較小。

支援 Python 3.12 x64;Ubuntu 24.04、Windows 與 Linux 都有對應路徑,A 卡和 I 卡則走 CPU 依賴方案,Windows 亦可用 DirectML。即時變聲延遲官方標示可達端到端 170ms,配合 ASIO 輸入輸出設備時可進一步降到 90ms,但對硬件驅動支援要求較高。

  • 可用少量語音資料訓練,門檻比傳統聲音模型低
  • WebUI 同時覆蓋訓練、推理與即時變聲
  • ckpt-merge 允許用模型融合去調整音色
  • 可接入 pymss/MSST 分離人聲與伴奏
  • 更適合配音、歌聲轉換、直播變聲與聲音原型測試

GitHub

Categories: 開源, 數字人, 模型, Linux, Python, 語音, 中國

AVE-Compass:音畫編輯終於有了更嚴格的驗收尺

AVE-Compass 把音效、畫面與指令完成度放在同一套測試中,揭示編輯模型最容易忽略的失真與不同步問題。

AVE-Compass overview

音畫編輯模型最難兼顧「改得夠準」與「其他內容不走樣」。AVE-Compass 是一套針對自由格式音訊影片編輯的診斷基準及評估工具,檢查模型有沒有完成指定修改,同時保留非目標畫面和聲音,亦會捕捉音畫不同步與感知瑕疵。

測試範圍包括145段來源影片、196條經人工核實的音畫指令、2,688項細緻 checklist,以及28種編輯操作,涵蓋聯合音畫、語音、純影片和純音訊修改。它以 Multimodal Large Language Model (MLLM)-as-Judge 配合跨模態、影片及音訊自動指標,分開計算 Instruction Following、Fidelity Preserving、Editing Intent 和 Realism。

MiniMax H3 Turbo LoRA Faster Sampling Steps & Prompt Agent Skill

使用者可從 AVE-Compass-v2 資料集取得樣本,再按設定檔和輸入模板交予評估 pipeline,輸入來源影片、指令、checklist 及模型產生的編輯結果。樣本以共享的識別值配對,來源影片則由 instruction JSON 解決;未啟用或缺失的客觀指標會維持未設定,不會被當成虛構的零分。

重點可整理為:
– Editing Intent 同時要求完成修改及保留非目標內容,避免模型不作修改卻取得偏高保存分數。
– 音訊執行和音畫時間同步是常見失分位置。
– AVE-Agent 加入 planning 和 self-reflection,對複雜指令的 Editing Intent、Instruction Following 及音訊處理有較明顯改善。
– 基準適合研究團隊比較模型,也適合影片生成產品建立回歸測試。

它的價值不在於只給一個總分,而是把「改錯了甚麼」拆開呈現;代價是需要模型輸出影片、完整評估資源及相應 MLLM,部署門檻高於單純像素或音質比較。對正在開發跨模態編輯模型的團隊,AVE-Compass 更像一套找出失敗原因的驗收框架,而不只是排行榜。

項目主頁 · GitHub

Categories: 開源, 南京大學, Agentic, 多模態模型, 語音, Dataset 數據集

SwanTale 以場景佈局生成

SwanTale 把語音與音訊研究集中成一個入口,重點放在更有表達力的生成能力。

swan logo

比起只追求把字讀出來,字節跳動的 SwanTale 更著重聲音是否自然、有情緒,亦能否處理多人說話生成。這個由 ByteDance 推出的研究項目,焦點放在 expressive audio、speech 與 multi-speaker generation。

現有資料不算多,但已見到它不是單一模型頁,而是一個集合式研究入口,整合 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere 等子項目。對做語音產品、數字人、配音內容與語音互動工作流的人來說,這類整理方式較易追蹤同一研究線的進展。

  • 聚焦 expressive audiospeechmulti-speaker generation
  • ByteDance 發佈,定位偏研究整合入口
  • 站內列出 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere
  • 目前公開資訊有限,性能與方法細節仍要逐個子項目再看

它的價值在於把聲音生成從「可用」推向「更像真人表達」,同時覆蓋多人語音場景。現階段較適合先把它視為字節跳動音訊與語音研究的總覽入口,而不是已完整公開規格的單一產品頁面。

項目主頁

Categories: 字節跳動, 數字人, Audio, 語音

Page 3 of 8
1 2 3 4 5 8