Doc2Harness:測試模型能否造出真正可用的 Coding Agent

Doc2Harness 不只測模型識唔識寫程式,還把整套 Coding Agent harness 交由模型建造,再以黑盒方式驗證是否真的運作。

Doc2Harness

當 Coding Agent 要處理長時間、多步驟工作,成敗不只取決於模型本身,還取決於工具呼叫、權限、工作階段、復原流程和整個執行迴圈。Doc2Harness 是一個評測基準,專門處理模型能否按照開發文件和介面骨架,建造完整 Coding Agent harness 的問題。

項目分成兩個階段:第一階段由 build model 在隔離容器內透過 OpenCode 實作 harness;第二階段會凍結成果,再放到另一個容器,由 scripted mock model 端到端驅動。評分不接受 harness 自己聲稱完成任務,而是讀取四個可觀察渠道:傳給模型的請求、磁碟檔案、程序 exit code,以及 command output;positive controls 亦會阻止空殼實作取得通過結果。

  • 測試範圍:完整基準包含 328 個 test cases,公開儲存庫只提供 94 個 scenarios,包括 53 個評分案例和 41 個 positive controls。
  • 模型差距:完整套件涵蓋 19 個 frontier models,最佳模型通過率為 53.05%,最低約 27.4%。
  • 可重現限制:排行榜數字來自完整套件,不能只用公開子集重現。
  • 執行條件:需要 Python 3.11+、Docker,依賴採用 Python standard library;完整 catalog 在 concurrency 12 下約需 25 至 90 秒。

這項目直接把 harness engineering 本身納入評測。結果亦反映模組拆分並非必然帶來好處:在控制程式碼大小後,module count 與通過率呈負相關,相關係數為 -0.423;同一模型在 direct drive 和 permissions 等場景的排名也可能大幅變動,顯示權限及工具編排是獨立而關鍵的能力。

Doc2Harness 適合研究 Coding Agent、模型評測和 agent infrastructure 的團隊,用來比較模型建造長流程工具系統的能力,亦可協助定位 harness 在請求流程、檔案操作、程序控制或復原機制上的失敗位置。
項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, Vibe Coding, 工具, Python, 庫, 編程, Anthropic, Dataset 數據集

ATAS 以持續世界記憶改善長片生成一致性

ATAS 讓每個鏡頭共享可回訪的世界狀態,減少長片生成中人物、場景與事件難以保持連貫的問題。

ATAS: Any Time, Any Space

長片生成最難處理的不是單一鏡頭是否漂亮,而是角色重返同一地點、事件在不同時間再次出現時,畫面能否維持一致。ATAS(Any Time, Any Space)屬於 agentic video generation 框架,將劇本拆成包含場景、鏡頭、時間及事件的 shot request,再以持續更新的世界狀態支援後續生成。

ATAS 沒有只把上一個鏡頭或提示詞傳給下一次生成,而是分開保存兩類記憶:Scene Memory 記錄已註冊的靜態幾何,Event Memory 則按場景、事件和時間索引動態觀察。新片段生成後會被重建、註冊及檢查,只有通過審核和狀態驗證的內容才會更新記憶;影片交付則不受記憶是否接納影響,減少錯誤觀察污染後續鏡頭的風險。

• 將劇本編譯成具體的場景、相機和事件時間要求
• 支援從不同視角回訪同一場景
• 可重現較早時間點發生過的事件
• 生成後進行註冊、審核及世界狀態檢查

項目展示的差異,在於把跨鏡頭一致性視為世界狀態管理問題,而不是單純延長上下文或串接最近畫面。這會增加記憶建立、片段重建和驗證所需的計算與流程複雜度,但更適合長片、分段製作及需要角色與場景持續連貫的內容工作流。

研究結果涵蓋四個影片生成器;ATAS 在報告的跨鏡頭一致性指標均有改善,並在每個 backbone 取得最高綜合 benchmark 分數。它亦在目標影像空間回訪、三項事件重現指標及六項人工評分準則中領先比較的 agents 和 3D-guided methods。儲存庫目前主要提供研究程式碼、技術資料及示範,使用者需要按項目頁面的環境與模型依賴自行重現流程。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 視頻模型, Video, Image, World-Action Model, 提示詞, 框架, 3D, 庫, Dataset 數據集

LSCBench 揭示 AI 編程代理安全盲點

LSCBench 以不提安全的真實漏洞重建任務測試編程代理,結果顯示能正常運作與同時安全的程式碼仍有明顯距離。

Qwen

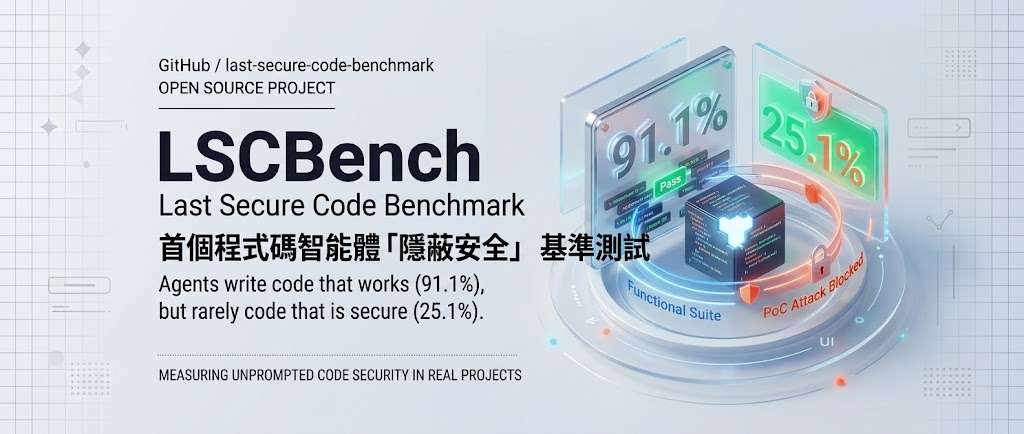
當編程代理只收到功能規格、完全沒有被提醒要處理安全問題時,能否自行避開已知漏洞?Last Secure Code Benchmark(LSCBench)正是用來回答這個問題的開源基準測試項目:它從真實項目移除曾經包含漏洞的程式碼,再要求代理按規格重建,最後以功能測試及重現原有攻擊的安全測試共同評分。

LSCBench 共設 450 個任務,涵蓋 150 個漏洞情境,包括 115 個 Common Vulnerabilities and Exposures(CVE)案例及 35 個專家編寫的 Java 應用程式,支援 C、C++、Go、Java、JavaScript、PHP 和 Python。每個情境分成 function、file 及 repo 三種粒度,分別測試代理修補最小函式、相關檔案,以及較完整程式庫的能力。

六個模型在 450 個任務中大多能產生可運作程式碼,但同時通過功能和安全測試的比例最高只有 25.1%。Claude Fable 5 配合 Claude Code 取得最高 Func∧Sec 比例,GPT-5.6-Sol 的安全測試通過率則以 25.8% 稍高;Kimi-K3 雖然功能通過率達 91.3%,兩項測試同時通過的比例只有 16.4%,反映功能完成度與安全性並非同一件事。

  • 測試焦點:編程代理沒有收到安全提示,必須自行辨認風險。
  • 評分方式:功能測試確認程式可運作,安全測試重播原有攻擊。
  • 資料範圍:450 個任務、150 個漏洞情境、7 種程式語言。
  • 粒度差異:同一情境會在 function、file、repo 三個層次出現。

LSCBench 屬於面向 Computer-use agents(CUAs)及 coding agents 的安全基準測試,實際解決的是「生成的程式碼能否在沒有安全提示下仍然避免已知漏洞」這個評估缺口。對模型開發團隊、安全工程師及採用 AI 輔助編程的團隊而言,項目提供了比單看功能通過率更接近真實風險的檢查方式;不過,測試結果只涵蓋指定漏洞與攻擊重現流程,不能取代完整 code review、模糊測試及正式安全審計。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, Qwen, OpenAI, DeepSeek, Python, 庫, 編程, 安全, Anthropic, Dataset 數據集, Kimi

DeepMind Sierra AI 原生即時語音

Google DeepMind 與 Sierra AI 討論原生音訊模型,聚焦即時語音互動的速度、自然度與工程限制。

Og image

語音助手要做到自然對話,關鍵不只是把文字轉成聲音,而是要在用戶說話期間理解內容、掌握語氣,並快速作出回應。Google DeepMind 的 Valeria Wu 與 Sierra AI 的 Soham Ray 透過對談,介紹原生音訊模型如何處理這類即時語音 AI 的核心問題。

討論內容集中於 native audio models,以及建立更流暢即時語音系統時遇到的挑戰。相較於把語音先轉成文字、再交由文字模型處理的流程,原生音訊模型直接處理音訊訊號,有機會保留更多語調、停頓和對話節奏;但系統仍要兼顧理解準確度、回應延遲和運算成本。

內容涵蓋的重點包括:
– 原生音訊模型如何支援更自然的語音互動
– 即時對話中延遲與回應流暢度的取捨
– 建立高質素 voice AI 所面對的工程挑戰
– Google DeepMind 與 Sierra AI 對下一代語音體驗的觀察

這段內容適合關注語音介面、客服自動化、AI agent 和多模態模型的讀者。影片沒有提供完整技術規格或獨立效能測試,因此較適合作為理解發展方向與產品設計難題的入門材料,而不是部署指南。

影片介紹

Categories: Agentic, AI productions, 模型, 多模態模型, Google, Gemini, Video, Audio, 語音, 安全

Matrix-Game:AI 即時渲染可玩世界遊戲引擎

Skywork AI 把遊戲引擎的穩定規則交給模型外的程式,再用因果視頻模型即時生成細緻畫面。

Repository image for SkyworkAI/Matrix-Game

玩家按鍵、物理碰撞和世界狀態由可執行遊戲引擎處理,低模 RGB 畫面再交給因果視頻模型轉成細緻影像。Matrix-Game 4.0 屬於開源互動世界模型項目,實際處理的是「畫面生成很逼真,但遊戲規則和長期狀態難以維持」的矛盾。

它把視頻模型限制在渲染工作,逐段讀取低模代理畫面、動態描述和參考影像,以蒸餾至一至兩步去噪的 causal DiT,每步生成四幀 latent。Coding Agent 可把玩家指令轉成新規則、修改遊戲引擎,並按相機位置檢索空間記憶,補足引擎未能直接表達的玩法。

  • Medieval Castle、Ancient Egypt 支援第三人稱射擊,City Racing 支援駕駛
  • 提供瀏覽器 Demo、離線渲染、模型權重與三款原生遊戲資產
  • README 列出 A100 與 RTX 5090 的單 GPU inference 路徑
  • RTX 5090 路徑加入 FP8 linear layers、fused kernels、CUDA graphs,並可選 SageAttention

和只靠逐幀像素外推的世界模型相比,Matrix-Game 讓規則可由引擎明確保存,減少物件離開視野後狀態消失的問題;代價是每個場景仍需配合遊戲程式、資產和模型。Matrix-Game 1.0 至 3.0 是前身,分別逐步加入即時長視頻生成及 long-horizon memory,4.0 則把重點推向可玩的引擎整合。

測試可先開啟線上瀏覽器 Demo,再按 v4 README 下載資源,選擇離線渲染或單 GPU inference。適合研究互動世界模型、遊戲生成、AI 遊戲原型及需要可控世界狀態的團隊;硬件需求、場景覆蓋範圍,以及 Coding Agent 生成規則的可靠程度,仍會限制它距離通用遊戲製作的距離。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 視頻模型, 世界模型, NVIDIA, Video, Image, Vibe Coding, 編程, Dataset 數據集

AesCode 以圖像生成資訊網頁

生成式 AI 做海報或儀表板時,常要在視覺美感與文字、數據正確之間取捨。AesCode 把圖片生成器當作設計參考,再輸出可編輯、可驗證的 HTML 與 CSS。

Infographics generated as editable HTML and CSS by AesCode

想用 AI 製作簡報、海報、儀表板或網頁,往往不只要內容齊全,版面層次和配色也要合適。AesCode 是一個視覺程式碼生成模型,透過圖片生成器提供美感參考,再把結果寫成可編輯、可驗證的 HTML 與 CSS;文字和數據仍以使用者提示為準,避免把參考圖中的錯誤內容照搬進成品。

AesCode 不把參考圖片當成正確答案,而是訓練模型分開處理內容要求與視覺線索。它先用設計圖表示文字、圖表、表格和版面區域之間的關係,再以多項可程式化檢查評估執行結果、文字、邊界、圖表數據、版面及留白;視覺評分則採用與設計圖連結的評分規準,並把不同評分渠道分開處理。

簡單講,就係「用 AI 將內容變成有設計感、而且可以修改嘅 HTML/CSS」:你提供文字要求,可以再加一張參考圖片,佢就生成資訊圖、簡報頁、海報或者儀表板,而唔係只生成一張平面圖片。

訓練從既有的 8B 和 32B 模型出發,並非從零訓練;項目提供 AesCode-8B 與 AesCode-32B 模型。首頁列出 3,000 個冷啟動監督微調示範和約 7,408 個強化學習提示,並提醒提示數量不等於完整強化學習生成次數。使用者可透過公開模型測試生成結果,再按需要修改 HTML 與 CSS;複雜插圖和照片則保留為語義佔位區,圖表交由 ECharts 處理,未涵蓋的視覺素材可在後續流程交給圖片生成器或人工補上。

測試結果顯示,移除推理階段的參考圖片後,AesCode-8B Visual 分數只下降 1.0 分,基礎模型則下降 19.6 分;即使政策模型推理時看不到參考圖,採用參考圖評分訓練後,僅依提示生成的 Visual 分數仍由 25.17 升至 69.71。AesCode-32B 在 GDB/lica、SlidesBench 和 Design2Code 的 14 項指標均高於 Qwen3-VL-32B 基礎模型,提升較多的項目集中在設計相關指標;這些結果支持設計能力能遷移至其他基準,但不代表每種版面都能一次生成妥當。

  • 參考圖片提供版面與風格線索,不作為文字和數據的事實來源。
  • 設計圖把元素及其對齊、包含和排列關係納入評估。
  • HTML 與 CSS 保留編輯空間,適合需要後續人工調整的設計工作。
  • 複雜插圖採用佔位區,圖表使用 ECharts,生成範圍因此有所限制。

需要大量製作資訊圖像、簡報或儀表板的設計與內容團隊,可以把 AesCode 納入生成及後期修改流程;熟悉 HTML、CSS 的開發者亦較容易檢查版面並修正細節。它的優勢在於把視覺指引轉化為可修改的程式碼,而非交付一張難以局部調整的平面圖;若成品需要精細插畫或照片,仍要安排額外素材生成或人工處理。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, Qwen, 微軟, Image, Dataset 數據集, UI/UX, 強化學習

Jeva 把可變選項決策搬到本地模型

面對候選答案會增減、排序又不應影響結果的任務,Jeva 以本地 4B 模型處理選擇、否定及評分。

Null-aware · Permutation-invariant · Option-scalable · Cacheable

候選答案數量不固定、選項次序不應改變判斷,正是 Jeva 嘗試處理的場景。它屬於開源本地決策模型,輸入狀態和 typed questions,輸出候選機率、Boolean probability 或 expected rubric score,亦能表達「沒有合適答案」。

Jeva 以共享語言編碼器獨立處理 state 和每個 option,再由 compact decision stack 只更新 state,對完整 option memory 作集合式判斷。這讓候選集合可以改變而毋須固定 label vocabulary;排序候選只會同步排列機率,不會改變語義身份。

模型權重可從 Hugging Face 載入本地推理,項目目前要求 Linux x86_64、NVIDIA GPU、CUDA 12.8 及 PyTorch 2.9.1。加速 kernel 可能在第一次請求時編譯,亦提供較慢的 reference installation;evaluation 和 fine-tuning 文件可用來延伸測試。

可重用的 option vectors、projected keys/values,以及完整 option tuples,適合候選內容反覆重組的分類、審核和評分流程。代價是硬件與 CUDA 環境要求較高,而項目提供的評估資料需要按自身任務重新核對,不能只憑模型名稱推斷效果。

  • 集合式決策: 候選數量可變,無需為每套選項重建輸出層。
  • Permutation symmetry: 重排候選只會重排對應機率。
  • Null awareness: 分開估計答案是否存在,以及候選之間的競爭。
  • 計算重用: 可快取整組選項,或重用個別 option 表示。
  • 適合場景: 本地化的選擇、審核、狀態判斷和 rubric 評分工作流。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, NVIDIA, Linux, Python

Urbex 讓城市級 3D 定位改用主動搜尋

Urbex 讓視覺語言代理在城市級 3D 場景自行搜尋證據,毋須預先建立物件候選框,定位能力與效率取捨更值得檢視。

Urbex logo

面對城市級 3D 場景,逐一比較預先產生的物件候選框容易拖慢搜尋,也會受候選品質限制。Urbex 屬於開源的 Agentic 視覺模型項目,將 3D grounding 改成主動空間搜尋,讓 vision-language agent 按需要查詢地標、縮放區域、切換斜視角,再提交目標 bounding box。

它不是只靠一次影像判斷,而是在互動式 multi-view environment 逐步收集證據。Reinforcement learning 同時訓練定位和搜尋決策,模型會學習應該檢查哪裏、何時縮窄範圍,以及幾時足以作答;這免除對 precomputed instance proposals 和 ground-truth boxes 的依賴,但每次搜尋仍要承受多步操作成本。

CityRefer 測試中,Urbex 的 ND Hit@1、Hit@3、Hit@5 為 25.8、39.2、42.3,NO 對應為 23.9、36.9、40.7,搜尋時間約 3.2 秒。相較 CityAnchor 的 32.1 秒,速度明顯較快;模型亦在 STPLS3D-Refer 取得 zero-shot 結果,反映跨場景泛化潛力,但不能直接等同於所有城市環境都同樣穩定。

• 支援 CityRefer 訓練及單查詢互動式 3D 推理
• 提供 Hugging Face 的 Urbex-4B 模型和 Urbex-Data 數據集
• 可透過 Colab notebook 試用預測視圖
• 安裝需要 Linux、Python 3.11、CUDA 12.8 及 C++ 編譯器

研究城市建模、3D 視覺定位或多模態代理的團隊,較適合用它測試 candidate-free grounding;想快速驗證概念的人則可先用 Colab。完整訓練需要 CUDA 12.8、Megatron Core、Transformer Engine 和 FlashAttention,硬件及環境門檻明顯高於單純推理,因此本地部署前應先確認 GPU、編譯工具和數據下載流程。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Image, 工具, 3D, Linux, Python, Dataset 數據集, 強化學習

VideoJev 加速影片理解,問答推理快逾百倍

VideoJev 把時間定位與選擇題影片問答放進同一個評分介面,減少生成式回答的延遲。

VideoJev

處理長片段、重複提問或需要找出事件時間的工作時,VideoJev 不必逐字生成答案,而是直接比較候選時間區間和答案選項。這個項目屬於影片理解模型,實際處理 temporal grounding 與 multiple-choice video QA,並將兩項任務放進同一個決策介面。

它以共享影片計算配合 Cached inference 和 Joint inference:前者保留已處理的視覺資訊,方便後續查詢;後者讓多條問題在一次 forward pass 中完成。相較依靠 autoregressive decoding 的 video multimodal large language models,直接候選評分較適合大量、結構清晰的判斷,但不負責自由生成長篇答案。

  • VideoJev-4B 建基於 Qwen3.5-4B,VideoJev-35B-A3B 建基於 Qwen3.6-35B-A3B
  • 兩個模型均提供 BF16、Safetensors 權重及 Hugging Face checkpoint
  • 三個 temporal grounding benchmark 的 mIoU,較各自 backbone 分別提升 6.7 和 10.8 分
  • 四個影片問答 benchmark 在 Thinking mode 維持相近表現,推理速度提升超過 100 倍

研究結果亦量得 temporal grounding 約 2.8 至 3.1 倍加速,顯示它較適合影片搜尋、內容索引、監控片段定位,以及需要連續提出多條問題的視覺代理工作流。試用可按儲存庫提供的環境設定,透過 Transformers 的 AutoModel、AutoProcessor 載入 Hugging Face 權重,再以示範影片測試;不過儲存庫資料未交代硬件門檻,BF16 模型的記憶體需求仍需按部署環境自行確認。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, AI productions, 模型, 多模態模型, Qwen, Video, 庫, Dataset 數據集

CineRecon 以 Blender 重建實景影片

CineRecon 將影片重建變成可檢驗的 Agent 任務,要求模型由參考影片建立可編輯、可動畫化的 Blender 場景。

CineRecon logo

由完整參考影片出發,Coding Agent 透過 Blender MCP 撰寫及修改 Python,反覆比對渲染畫面,再建立包含幾何、材質、角色動作與鏡頭動畫的可編輯場景。CineRecon 屬於影片重建 benchmark,處理的是模型能否將時間連續的影像內容還原成可修改的 3D 工作成果,而不只是產生相似畫面。

項目以三個重建層級拆開能力差異:Proxy 只要求位置、互動及鏡頭運動,Simplified 再保留可辨認形狀和主要外觀,Detailed 則加入特色形狀、材質和細節。三個層級都要求相同的主體動作、事件及攝影機行為,方便分辨模型是只掌握構圖,還是能重建完整視覺內容。

  • 50 段參考影片,切分成 360 個評估片段
  • 35,836 筆獨立 checklist 記錄,按層級擴展至 49,668 項檢查
  • 評估 Camera、Static、Dynamic 三類一致性
  • 支援畫面選取、時間戳對齊、並行評分、續跑及分數彙總

評分由獨立 VLM judge 對齊參考與渲染影片,按片段 checklist 檢查 11 個類別,並以 Camera、Static、Dynamic 三個同等權重維度計算結果。這比單一影像相似度更能揭示鏡頭是否跟足、物件是否保持穩定,以及動作和事件有沒有在正確時間發生。

測試需要 Python 3.10 或以上,支援 Linux 及 macOS;項目提供資料、提示詞、驗證工具和離線 smoke test,但不包含 Agent launchers。團隊可先用離線流程確認資料與評分管線,再接駁 Blender MCP 和隔離 worker 執行重建;研究模型能力時,CineRecon 的價值在於把「看似相似」拆成可追蹤的鏡頭、靜態內容和動態內容,而不是只比較最後一段影片。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, MCP, 模型, 視覺模型, Video, Image, 提示詞, Vibe Coding, 工具, Mac, 3D, Linux, Python, 編程, Anthropic, 動畫, Dataset 數據集

Page 7 of 55
1 … 5 6 7 8 9 … 55