SCOPE 讓文字提示詞按語意學習

文字轉圖像不再把同一分數平均分給每個字詞,SCOPE 按物件、數量與關係調整提示詞優化方向。

Uniform token GRPO versus SCOPE span credit.

當提示詞包含物件、數量、屬性和關係時,逐個 subword token 套用同一個圖像分數,往往難以知道哪段文字真正需要修改。SCOPE 是一個開源的文字轉圖像提示詞優化項目,利用 GRPO(Group Relative Policy Optimization)讓語言模型重寫提示詞,同時保留凍結的圖像生成器作評分基準。

每組提示詞會由 pi_theta 產生 N-1 個改寫版本,並加入原始提示詞作第 N 個成員;預設 N 為 8。Qwen-Image 以同一個 diffusion seed 生成 512 x 512 圖像,使用 20 steps 和 CFG 4.0,再由 GenEval 回傳 0 或 1,減少不同隨機結果對比較造成的干擾。
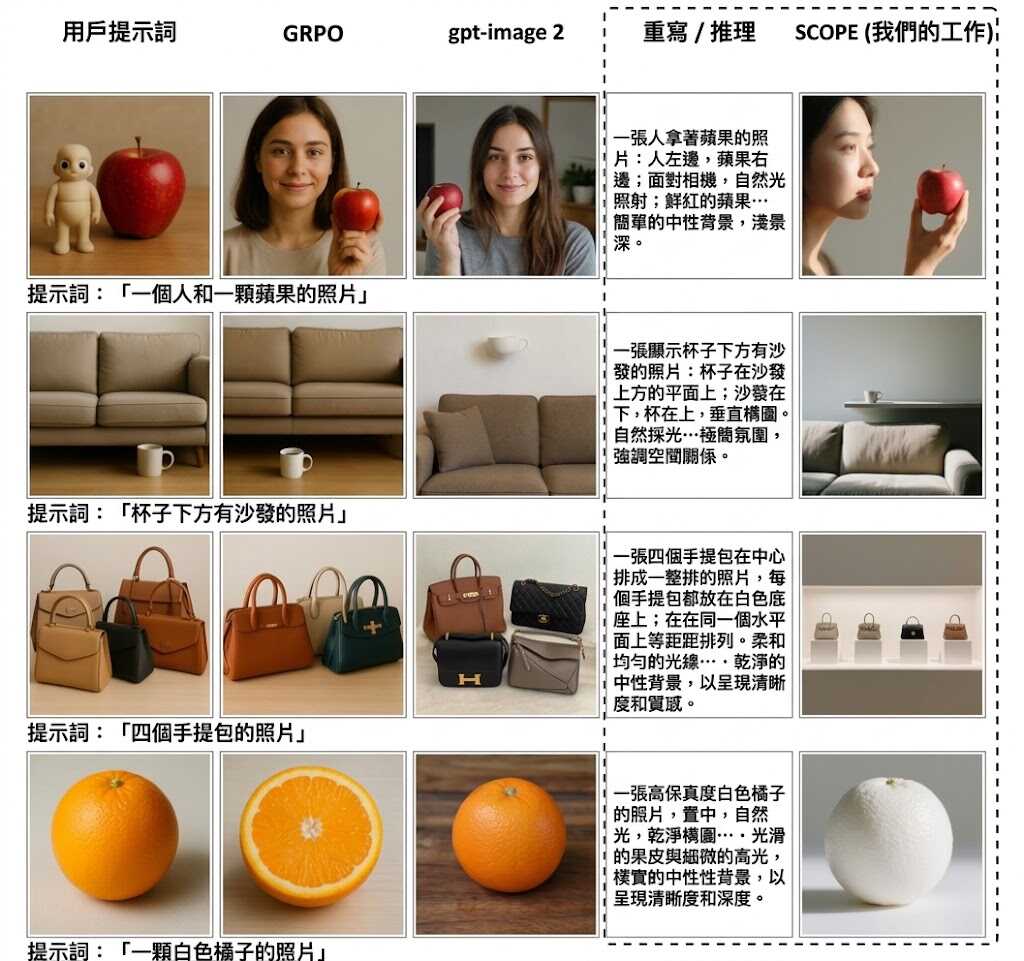
SCOPE 的差異在於把回饋由 token 層面提升至語意片語。項目會在每個 phrase 內池化 log pi_theta 與 log pi_old 的差值,將 span coefficient 限制在 0.8 至 1.2,再把片語 token 權重正規化至平均值 1;tags 和垂直線則維持權重 1。原始提示詞分數低於預設 tau 1 時,採用截斷 reward gap;達到門檻後,改用改寫群組的 clipped z-score。

  • 訓練流程:原始提示詞會參與評分及 advantage 計算,但不直接更新參數。
  • 策略穩定性:pi_old 是上一個 optimizer step 的凍結副本,第一步會與 pi_theta 相同。
  • 適合情境:需要改善物件數量、屬性或空間關係表達的文字轉圖像研究與實驗。

測試時可觀察 reward service 產生的圖像、logs/node-RANK/內的安裝與訓練記錄,以及每項工作使用的 service.token;該 token 權限設定為 0600。項目更接近研究型訓練框架,而不是即開即用的圖像生成介面,使用者需要準備 Qwen-Image、評分服務及足夠的生成資源,亦要留意 GenEval 的二元分數未必能涵蓋所有美學或語意品質。
GitHub

Categories: 開源, 模型, 模型訓練, Qwen, Image, 提示詞, 框架, Mac, Python, Tokenize

SimVTA 為自動駕駛補上替代路線的視覺訓練

SimVTA 用模擬器生成不同駕駛路線的未來畫面,讓模型不只學習紀錄中的單一路徑。

From logged futures to candidate-matched supervision

自動駕駛模型需要判斷轉線、直行等替代路線,但行車紀錄通常只保留當時真正採取的路徑,其他選擇缺乏對應影像。SimVTA 屬於 driving world action model 的 post-training framework,處理的正是軌跡規劃與未來視覺監督不匹配的問題。

項目會在以 3D Gaussian Splatting(3DGS)重建的真實場景中,為候選軌跡渲染相配的未來影片,再以 Group Relative Policy Optimization(GRPO)優化軌跡,並加入 flow-matching video loss 更新共享表示。高回報候選之中,系統會優先挑選誤差較大的未來,減少有限渲染資源被低價值樣本消耗。

相較只依賴 logged trajectories 的訓練方式,SimVTA 補上了替代行動的視覺訊號;代價是需要 3D 場景重建與模擬渲染,訓練流程較複雜。推理階段則直接預測軌跡,不需再次呼叫模擬器,較適合納入自動駕駛規劃流程。

  • NAVSIM v1:PDMS 由初始化模型的 86.2 提升至 91.3
  • NAVSIM v2:取得 88.2 EPDMS
  • HUGSIM 閉環測試:平均 HD-Score 為 38.8
  • 消融結果支持共享表示更新及高誤差樣本優先策略

研究團隊包括 OpenDriveLab at HKU、Shanghai Innovation Institute、Li Auto、Tongji University 與 Tsinghua University。這個項目較適合研究自動駕駛、world action model 或模擬訓練的團隊;目前儲存庫仍標示 code 和 checkpoints 尚待發布,因此未能當作即裝即用的工具測試,重現結果仍需等待相關資源。

項目主頁 · GitHub

Categories: 開源, 香港大學, 清華大學, AI productions, 模型, 模型訓練, Video, Image, World-Action Model, 框架, 香港, 工具, 3D, 庫, 自動駕駛

DeltaStreamer 讓串流影片可以回看再作答

影片播放過後仍可追查關鍵細節,DeltaStreamer 以記憶、規劃和視覺回放串起串流理解流程。

DeltaStreamer

影片一路播放,問題卻可能在關鍵畫面消失後才出現;DeltaStreamer 屬於 agentic framework,處理串流影片理解中「記住甚麼、何時回查」的難題。它以 change-aware memory 保存變化,再配合 query-driven planning 和 targeted visual replay,讓系統按問題重新檢查相關片段,而不是只依賴當時留下的文字描述。

對直播問答、影片監察和互動助手而言,這個流程比單純累積長篇摘要更適合處理後來才提出的問題。項目亦提供 AI-Tongdan 作為應用例子,支援持續觀察、上下文問答和彈幕建議;不過它是框架,不是獨立的新基礎模型,所用模型與推理配置仍要按儲存庫內容自行核對。

OVO-Bench 中,DeltaStreamer 的 overall score 為 66.07,Real-Time、Backward 及 Forward 分數分別為 72.23、67.72 和 58.25。它高於列出的全開源 online MLLMs 與 video agents 多個結果,但仍低於 Gemini 3 Flash 的 64.02 嗎? [sic]

項目主頁 · GitHub

Categories: 開源, 字節跳動, Agentic, AI productions, 模型, 多模態模型, Qwen, Video, 框架, 庫

ViRA 讓視覺表徵真正改善自動駕駛

ViRA 把視覺基礎模型的表徵帶入端到端駕駛訓練,提升規劃表現之餘,不增加部署時的推理成本。

teaser

端到端自動駕駛需要由鏡頭直接產生駕駛規劃,但更強的視覺表徵未必自然帶來更好決策。ViRA 是一個 planner-agnostic visual representation alignment framework,於訓練期間把規劃器特徵對齊至凍結的 visual foundation models (VFMs),保留原有 planner 架構,部署時亦不增加推理成本。

項目由香港大學 OpenDriveLab、東南大學及 Shenzhen Loop Area Institute(SLAI)等團隊共同開發。它主要處理「視覺表徵強不等於駕駛表現強」的落差。研究測試多款 end-to-end planners,發現 VFM 目標的選擇會影響規劃效果;加入 auxiliary perception supervision 後,五個目標之間的 EPDMS 差距由 2.7 分收窄至 0.5 分,反映訓練訊號與目標模型需要一併考慮。

ViRA-Diffusion 以 DINOv3 alignment 訓練,毋須 auxiliary perception supervision,在 NAVSIM v2 navtest 取得 92.3 EPDMS,較比較中的近期方法至少高 1.9 分;在較具挑戰的 navhard,Rap* 配合 ViRA 亦錄得改善。HUGSIM 結果則屬 zero-shot,規劃器只在 NAVSIM 訓練,未在 HUGSIM 重新訓練。

項目的適用範圍:
– 適合研究 camera-only 端到端自動駕駛及 VFM 對規劃的影響。
– 可在不改動已部署 planner 架構的前提下,加入訓練期表徵對齊。
– 評測指標包括 NAVSIM 的 EPDMS,以及 HUGSIM 的 HD-Score。
– 儲存庫目前列出結果與示範已發布,但程式碼及 checkpoints 仍在待辦清單,未有足夠資料支持直接安裝或下載模型。

ViRA 更適合作為研究和模型訓練方法閱讀,而不是即時可用的駕駛軟件;它展示的是如何選擇 VFM 目標及監督方式,並非保證所有規劃器都會得到相同幅度的提升。

項目主頁 · GitHub

Categories: 開源, 香港大學, 模型, 模型訓練, 框架, 香港, 軟件, 庫, 自動駕駛

Terminal-RSI 讓終端機代理循環改寫策略

Terminal-RSI 透過成功軌跡反覆改寫與微調策略,提升模型完成終端機任務的能力。

Og image

終端機代理面對複雜指令時,往往不是完全不懂,而是在多輪操作中逐步偏離正確路徑。Terminal-RSI 是一項研究項目,利用驗證成功的 terminal trajectories,讓 27B 參數模型反覆修正自身行為,減少同類任務重犯錯誤的情況。

項目把 Recursive Self-Rewrite 與 Policy-Refine 分成兩條互相配合的流程。模型先透過不同 harness 產生操作軌跡,再由 terminal verifier 篩走失敗結果;成功軌跡會交給 actor 進行 SFT,critic 則保留並重新校準,之後再以 actor–critic PPO 一同優化政策。

它採用 TB-GAE(Turn-Based Generalized Advantage Estimation)追蹤生成 token 的責任,觀察內容留在上下文中,信用分配則沿着每輪操作向後傳遞。完成一輪後,保留的 checkpoint 會成為下一輪遞歸改進的起點,而非每次都由零開始訓練。

測試結果顯示,Terminal-Bench 4.0 的分數由 0.00% 升至 19.84%,Terminal-Bench 2.1 則由 51.70% 升至 86.52%,分別提升 19.84 個百分點及 34.82 個百分點。兩個基準版本的任務與難度不同,數字較適合用來觀察各自的改進幅度,不能直接當作同一條排行榜比較。

  • 只保留通過 verifier 的成功軌跡
  • 以 Recursive Self-Rewrite 改寫可重用的操作經驗
  • 以 Policy-Refine 持續調整 actor–critic 政策
  • Terminal-RSI-27B 是目前展示的最終 checkpoint
  • Code 與 model 仍標示為即將推出

對需要模型執行檔案處理、程式編輯或多步驟 shell 任務的工作流,這種訓練方式提供了另一條提升可靠性的方向。不過項目仍處於研究展示階段,代碼及模型尚未公開,結果亦主要集中於指定的 Terminal-Bench 評測。

項目主頁

Categories: 開源, 騰訊, Agentic, 模型

[技術文章] 阿里 CommerceGen-Studio:商用級主圖生成端到端框架

把白底 SKU 商品照變成可上架主圖,並以幾秒延遲處理每日百萬級流量。

Hugging Face

白底商品照難以直接吸引搜尋頁點擊,CommerceGen-Studio 由 Alibaba Group 提出,面向電商 SKU 粒度的商業主圖生成。來源沒有交代具體 base model 或 fine-tuned from 哪個模型,因此無法確認其原始基礎模型。

系統分成資訊抽取、語義改寫及多條件生成三階段。Prompt-Eval-Refine-Loop Agent(PERL-Agent)讓 VLM 與 LLM 按照 reference-free rubric 反覆整理商品資料;Layout Thinker Optimization(LTO)則同時以文字描述及渲染圖片質素調整改寫策略。

SKU-DiT 透過 Reinforce-Distill-Reinforce(RDR)漸進式訓練,聯合使用白底商品圖、商標裁剪圖及結構化版面條件,兼顧商品外觀、商標完整性和字元級文字準確度。系統聲稱已達到每日生成數百萬張主圖、每張延遲數秒,並在 CommerceGen-Bench 的兩條編輯測試中勝過所比較的開源基線,部分指標可媲美或超越大型閉源模型。

  • 檔案與推論:來源是研究論文內容,沒有提供 GGUF 檔名、檔案大小、量化級別、mmproj 或 chat template。
  • 框架支援:論文摘要沒有公開各項數值分數,也未交代 SKU-DiT 的參數規模及訓練資料細節。
  • 適用場景:重點在大量電商商品主圖生產,而非通用文字轉圖片服務。

CommerceGen-Studio 與單一生成模型的差異,在於把商品資料理解、賣點整理、版面規劃及圖片生成串成完整項目流程;CommerceGen-Bench 則以真實流量中的困難案例測試 Instruction Following 和 Product Integration。由於缺乏公開權重、量化檔案及硬體規格,讀者目前較適合把它視為可大規模運行的研究框架,而非可直接下載的本地模型。

Paper

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 模型訓練, Image, 影像模型, VLA, 框架, LLaMa, Ollama, Dataset 數據集

3dcodeverse 讓 AI 以程式碼建立可驗證 3D 世界

3DCodeVerse 將可執行程式、空間檢查與視覺評審接成工作流,讓 AI 產生的 3D 內容不止能看,亦能修改和驗證。

3DCodeVerse

由幾百行 Blender Python、Three.js 或 GLSL 生成互動場景,內容仍可編輯和檢查,正是 3DCodeVerse 的實用定位。它屬於面向 coding agents 的 3D 研究生態系,處理文字要求轉化為可執行 3D 程式的問題,而不是只輸出一張渲染圖。

核心資料集 3DCodeVerse-2M 收錄約 2.03M 個 code-condition pairs,來自 269,597 個可執行程式,涵蓋 bpy、CadQuery、OpenSCAD、Three.js、URDF、GLSL、OpenGL 七種語言或 runtime,並分為物件、可動物件、場景及圖形渲染四條軌道。每個項目附有程式、所需資產、指令描述、視覺描述、建構步驟和驗證記錄,較適合訓練及測試,而非只作展示素材。

3DCodeVerse Harness 以多智能體和 DAG 結構規劃 3D 項目,再交由空間工具、MCP 服務及確定性檢查驗證連接、介面合約、關節掃描和畫面指標;VLM 評審則用二元缺陷清單及程式上限評分。讀者可先在項目網站瀏覽器執行示例,再從 Hugging Face 取得資料集;自行運行則要準備相應的 Blender、Three.js、OpenGL 等 runtime,不能只靠單一推理套件完成。

開放模型部分提供 Qwen 的 LoRA、DPO 微調配方,並列出 27B 模型在 3DCodeBench 的執行率由 51.9% 提升至 92.9%;項目亦列出相對同一 Claude Opus 5.5 backbone 的 90% 人類偏好結果。這些數字反映訓練資料和驗證流程的價值,但仍應留意評測設定、成本及不同 runtime 對結果的影響。

  • 可生成可修改的程式化 3D 物件、場景和渲染效果
  • 以 DAG Harness 串連規劃、執行、空間檢查和視覺評審
  • 2.03M code-condition pairs 支援模型訓練與基準測試
  • Qwen 微調配方兼顧執行成功率和偏好評審

對研究 3D 生成、coding agents、程式化建模或模型微調的團隊,這個項目提供由資料集、工具鏈到模型配方的完整起點。限制在於工作流程依賴多個 3D runtime,評審仍可能受視覺品質和規則覆蓋範圍影響。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 視覺模型, 模型訓練, Qwen, Google, 工具, 3D, Python, 編程, 安全, Anthropic, Dataset 數據集, LoRA

EdgeWise 讓長流程 AI 代理在本地運作更省成本

EdgeWise 讓本地模型處理大部分長流程任務,只在關鍵步驟呼叫雲端 LLM,兼顧表現與成本。

Og image

長流程 AI 代理不必每一步都依賴昂貴的雲端模型。NVIDIA 的 EdgeWise 是一套 edge-cloud collaboration framework,讓本地 SLM(Small Language Model)先負責解題,遇到需要更強推理能力的關鍵步驟,才選擇性地交由 cloud LLM 處理。

EdgeWise 用 step-level RL(Reinforcement Learning)同時訓練任務執行與自動分工,令代理自行判斷何時需要外援,而且不必在推理階段額外加入另一個決策模型。研究亦以 external judge-based delegation strategy 分析委派時機、分享多少上下文,以及雲端模型應該多久介入一次。

研究發現,雲端智慧需求通常集中在少數關鍵步驟,呼叫次數不一定越多越好;隨機把約 40% 步驟交給雲端,有時已能接近全雲端執行的表現。EdgeWise 在 SWE-Rebench 減少最多 62% inference cost,在 Terminal-Bench 2.1 減少最多 34%,並在本地工作站完成 edge-cloud 測試。

• 本地 SLM 負責主要任務流程
• 只在關鍵步驟委派 cloud LLM
• 以 step-level RL 學習委派決策
• 支援不同 agent harnesses
• 成本較全雲端執行最多低 62%

適合需要處理長流程編程、終端機操作或其他多步驟任務的工作流,尤其適合希望降低 inference cost、又不想完全犧牲模型能力的本地設備。雲端連線、委派判斷和上下文分享方式仍會影響結果,因此它並非完全脫離雲端的方案。

項目主頁

Categories: Agentic, 模型, 模型訓練, NVIDIA, World-Action Model, 框架, 編程, 強化學習

ORBIA 測試世界模型當鏡頭回頭後場景是否仍在

影片流暢,不代表場景能保持一致。ORBIA 讓鏡頭離開再折返,檢查世界模型有沒有「忘記」剛生成的內容。

ORBIA overview

鏡頭繞一圈後,同一件物件應該仍在原位。ORBIA 這套互動影片世界模型基準測試,透過探索與重訪場景,檢查生成畫面能否構成一致的 3D 世界,而不只看影片是否漂亮。

測試輸入包括圖片、場景描述及鏡頭軌跡,並以已對齊的彩色與深度影像(Red Green Blue–Depth,RGB-D)及標註物件作參照,比單一整體影像分數更能定位場景改變的位置。

  • 輸入保留(input preservation):原有場景與地標是否保留。
  • 生成內容持續性(generated-content persistence):重訪時,新生成內容是否一致。
  • 3D 自洽性(3D self-consistency):不同視角能否支持同一個 3D 重建。

儲存庫提供評估程式、模型適配器及資料建構流程,供研究團隊接入模型測試。720 個案例涵蓋六種軌跡,包含 22 秒及一分鐘版本;長版本安排三次重訪,能檢查較長時間的場景記憶。

項目已評估 27 個模型,但所提供資料沒有具體排名或分數。它適合補強世界模型的驗證流程,不能單憑測試規模判斷哪個模型更可靠。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, Video, Image, 3D, 庫, Dataset 數據集

Gemini 4 Argon 解決更複雜問題

Gemini 4 Argon 正式向開發者、企業、科研人員及一般用戶開放,主打處理高難度問題。

Og image

面對需要更強分析能力的工作,Google 現已開放 Gemini 4 Argon 使用。這款 frontier model 面向開發者、企業、科學家及一般消費者,讓不同場景的用戶都能接觸 Google 最新一代 Gemini 模型。

Gemini 4 Argon 定位為處理「最艱難問題」的模型。

主要亮點

  • 原生多模態 MoE:支援文字、圖片、音訊及影片輸入。
  • 統一 1M-token 視窗:輸入、thinking tokens 與輸出共用約 104 萬 tokens,單次輸出亦可超過以往的 64K 限制。
  • 可調推理深度:API 提供 low、medium、high thinking levels,方便平衡速度、成本與解題能力。
  • 偏向深度工程工作:Google 展示了跨數百個檔案重構,以及讓 Agent 無人值守執行整晚的案例。
  • API 型號:gemini-4-argon,可透過 Gemini API、Google AI Studio 及 Google Antigravity 使用。

價格與限制

2026 年 11 月 30 日前,API 推廣價為每百萬 input tokens 2 美元、output tokens(包括 thinking tokens)10 美元;12 月 1 日起分別加至 4 美元及 20 美元,而且沒有免費 API tier。

項目主頁

Categories: 模型, Google, Gemini, 安全

Page 6 of 55
1 … 4 5 6 7 8 … 55