Hunyuan 影片生成詳解

Fast Video Framework 大幅提升本地 AI 影片生成速度,同時維持高畫質。 透過 LCM 取樣和 LoRA 整合,讓 Hunyuan Video 和 Mochi One Preview 等模型在一般家用電腦上也能快速運作,並減少資源消耗。 片中以 ComfyUI 為例,逐步示範如何設定與使用,包含壓縮儲存、整合 LoRA 模型等步驟,讓使用者能輕鬆高效生成各種風格的影片。

Fast Video Framework 大幅提升本地 AI 影片生成速度,同時維持高畫質。 透過 LCM 取樣和 LoRA 整合,讓 Hunyuan Video 和 Mochi One Preview 等模型在一般家用電腦上也能快速運作,並減少資源消耗。 片中以 ComfyUI 為例,逐步示範如何設定與使用,包含壓縮儲存、整合 LoRA 模型等步驟,讓使用者能輕鬆高效生成各種風格的影片。

Hunyuan Video In ComfyUI With FastVideo Framework To Optimize Performance For Local AI Video Model
Categories: ComfyUI, 影像處理, 教學

Gemini 2.0 Video Analyzer 影片分析

本片中展示 AI Studio 上 Gemini 2.0 中的入門應用程式之一 「視訊分析器」,並詳細介紹如何使用 Python 程式碼和新的統一 SDK 從多角度分析影片內容。

本片中展示 AI Studio 上 Gemini 2.0 中的入門應用程式之一 「視訊分析器」,並詳細介紹如何使用 Python 程式碼和新的統一 SDK 從多角度分析影片內容。

Gemini 2.0 - Video Analyzer with Code
Categories: Gemini, 影像處理, 教學

Whisk – Google Deepmind 新整合

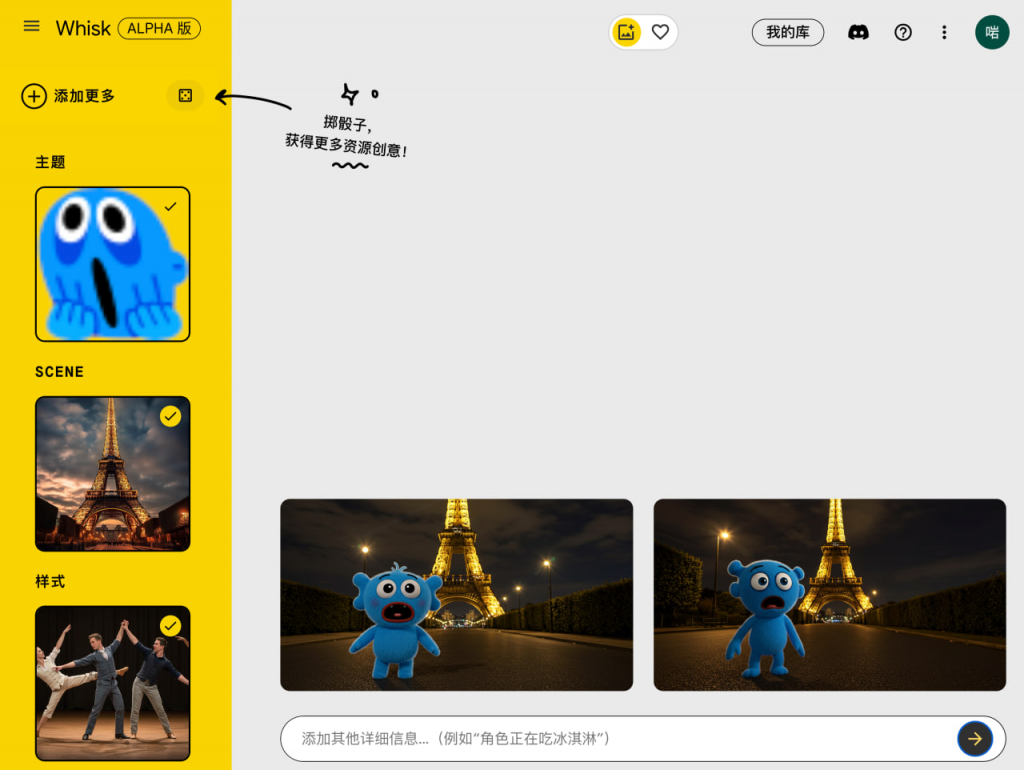
Google Labs 宣佈了幾個重要更新。除影片生成外,Whisk 最受矚目! Google 推出了Veo 2 和 Imagen 3 的改良版本,分別在影片和圖片生成方面達到業界頂尖水準,並整合到 VideoFX 和 ImageFX 工具中。 此外,一個名為 Whisk 的新工具也正式亮相,它允許使用者以圖片作為提示,結合 Imagen 3 和 Gemini 的技術,創造出獨特的影像。 文章最後還介紹了這些工具的應用範圍以及未來發展計畫,例如在 YouTube Shorts 和 Vertex AI 上的整合。 整體而言,文章旨在展示Google在AI影像與影片生成技術上的最新進展,以及其對提升使用者創造力和拓展應用場景的努力。

Google Labs 宣佈了幾個重要更新。除影片生成外,Whisk 最受矚目!

Google 推出了Veo 2 和 Imagen 3 的改良版本,分別在影片和圖片生成方面達到業界頂尖水準,並整合到 VideoFX 和 ImageFX 工具中。 此外,一個名為 Whisk 的新工具也正式亮相,它允許使用者以圖片作為提示,結合 Imagen 3 和 Gemini 的技術,創造出獨特的影像。 文章最後還介紹了這些工具的應用範圍以及未來發展計畫,例如在 YouTube Shorts 和 Vertex AI 上的整合。 整體而言,文章旨在展示Google在AI影像與影片生成技術上的最新進展,以及其對提升使用者創造力和拓展應用場景的努力。

Categories: 多模態模型, 影像處理, 新聞

Google Veo2 – 比 Sora 更高質!

Veo 2 是一款最先進的影片生成模型 Google DeepMind 的 Veo 2 能生成高品質、逼真的影片,解析度最高可達 4K,並具有精細的攝影機控制選項,能準確地模擬真實世界的物理現象和多種視覺風格。

Veo 2 是一款最先進的影片生成模型

Google DeepMind 的 Veo 2 能生成高品質、逼真的影片,解析度最高可達 4K,並具有精細的攝影機控制選項,能準確地模擬真實世界的物理現象和多種視覺風格。

Googles VEO 2 Just STUNNED The ENTIRE INDUSTRY! (Quantum Leap in AI Video)
Categories: 多模態模型, 影像處理

SwiftEdit 高速 AI 修圖

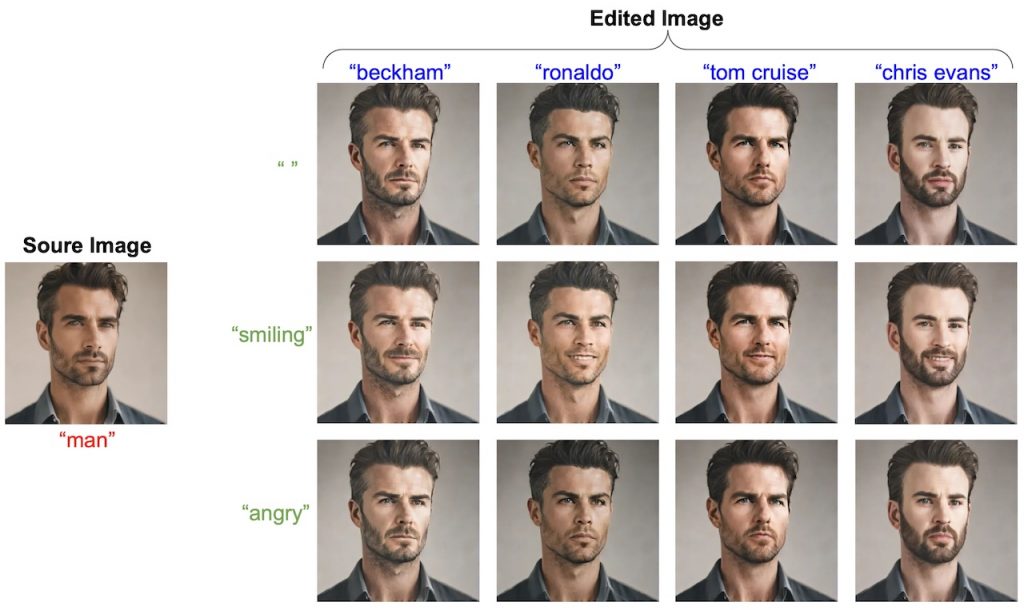
快速文字引導影像編輯工具 以0.23秒內完成影像編輯,比現有方法快至少50倍。SwiftEdit 的關鍵在於其一步到位反轉框架,能一步重建影像,以及遮罩引導的編輯技術,藉由注意力重新調整機制來進行局部編輯,同時保留背景細節。其雙階段訓練策略和自動提取編輯區域的機制,並透過範例展示其在人臉編輯和基準測試中的有效性和效率。 其目的在提供一個快速、使用者友善且高效的影像編輯工具。(暫未提供源碼) https://www.youtube.com/watch?v=nNT5wC5FeZU

Demo: SwiftEdit: Lightning Fast Text-guided Image Editing via One-step Diffusion
Categories: 影像處理

Motion Prompting 可控影像模型

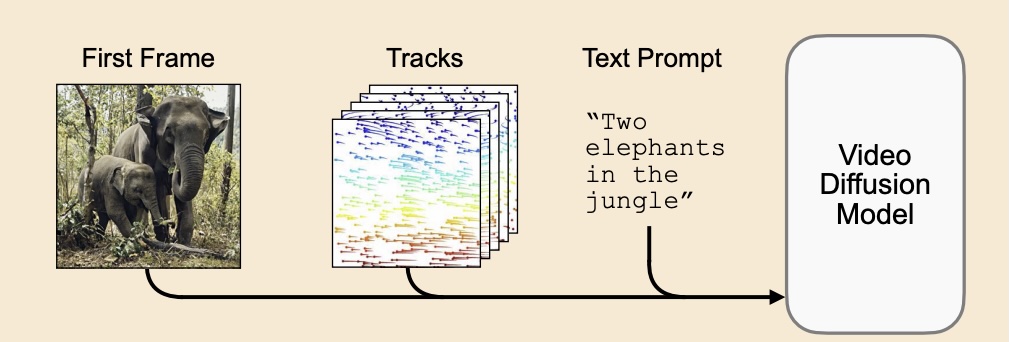
用於控制影片生成模型 利用 點軌跡 (point trajectories) 作為提示,以極其靈活的方式編碼單點或大量點的運動,甚至包含物體運動、場景變化、遮擋和稀疏運動。 研究者訓練一個以任意動作為條件的影片生成模型,並透過設計不同的 動作提示 來操控影片生成結果,例如控制物體運動、模擬物理現象、控制攝影機視角,甚至是動作轉移和影像編輯。網站分享了不同參數(如軌跡密度、文字提示)對結果的影響,並與其他相關方法進行比較。

Categories: 多模態模型, 影像處理, 新聞


SAMURAI – 視訊識別追踪

使用運動感知分段模型以實現零鏡頭視覺跟踪 Official repository of “SAMURAI: Adapting Segment Anything Model for Zero-Shot Visual Tracking with Motion-Aware Memory”

Categories: 模型, 影像處理


Page 21 of 22
1 … 19 20 21 22