Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

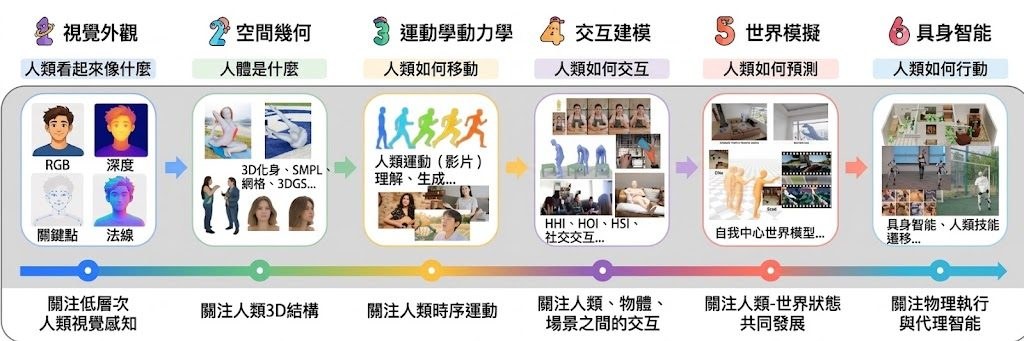
伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者。
項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

資源庫並非可直接下載執行的模型或軟件,使用方式是瀏覽 GitHub 內容及項目首頁,按 Academic Knowledge、Research Infrastructure 和 Community Learning Hubs 等部分尋找材料。研究者亦可透過社群渠道提交或維護資源,因此內容會隨社群整理持續更新,但完整度和一致性仍取決於後續貢獻。

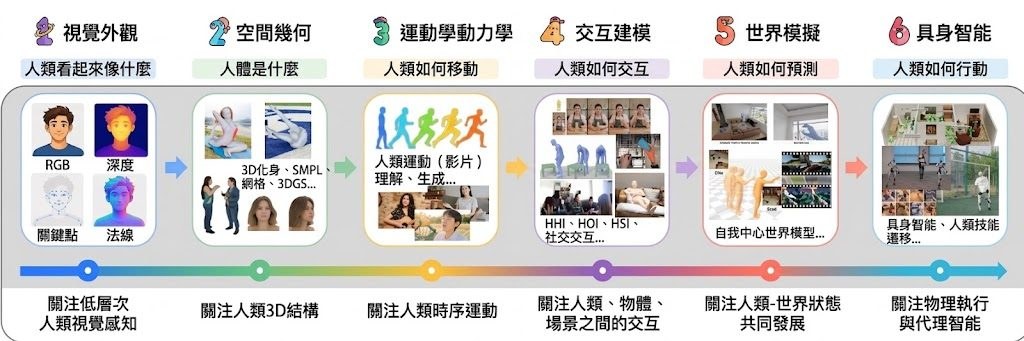
伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者,GitHub 資源庫和 survey 應該一併閱讀;只想立即執行模型或測試 API 的使用者,則需要另找具體實作項目。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

OmniAssistBench:以多輪互動評測即時影片助手的表現

OmniAssistBench 以 LLM-as-a-Judge 固定互動路徑測試 Omni-LLMs 的多輪影片助手能力,涵蓋685組開放式問答、7類任務,影片含自然語音、打字或手寫提示。評分顯示 Gemini-3-Pro 以66.4分領先。

OmniAssistBench proposes an annotation pipeline which allows annotators to build test samples from existing Internet vid

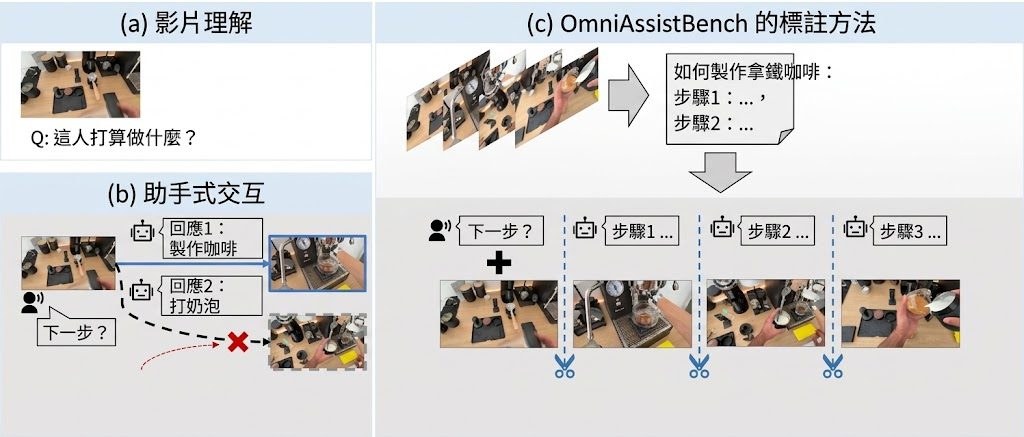
當影片助手的回答會改變使用者下一步行動,傳統只對固定影片問答的測試便難以反映真實體驗。OmniAssistBench 屬於 Omni-LLMs 的影片助手評測基準及數據集,透過固定互動路徑,處理多輪對話中影片內容會隨模型回應變化的問題。

項目涵蓋 685 組開放式問答,分成 Basic Tier 與 Advanced Tier,涉及社交理解、時間感知、手勢提示、程序指導及主動回應等 7 類主要任務和 16 類細分任務。影片取材自運動、煮食、講課、DIY 及談話節目,另有 3 個自行拍攝案例,每個平均超過 15 輪互動;問題會以自然語音、打字或手寫方式嵌入影片,而不是只放文字提示。

  • 以影片連同對應音訊輸入模型,再按互動回合回答問題
  • 由專家先整理影片步驟,再剪輯片段及加入字幕,固定測試路徑
  • 評分採用 LLM-as-a-Judge,原始 0 至 5 分再換算為 0 至 100
  • 建立數據集耗用超過 1,000 小時專家工時

這種做法比靜態影片問答更貼近助手場景,但固定路徑亦代表其他合理回應未必能在同一測試中獲得充分反映。Project homepage 的排行榜顯示,Gemini-3-Pro 整體得分為 66.4,Gemini-2.5-Pro 為 64.6,商用及開源 Omni-LLMs 都只達部分正確,反映可靠的即時影片助手仍有明顯改進空間。

研究團隊來自南京大學、南開大學及 University of Waterloo。測試者需要按照項目提供的評測流程處理影片和音訊,相關 Dataset、Project Page 及評估程式碼可供查閱;正式採用前應先確認版本、存取權限及評分流程是否已更新。

項目主頁 · GitHub

Categories: 開源, 南京大學, 字節跳動, Qwen, Gemini, Dataset 數據集

[技術文章] RecVerse 讓購物代理更像真人行為

RecVerse以分層記憶和整段軌跡訓練,模擬更貼近真人的網上購物流程。

Hero image preview

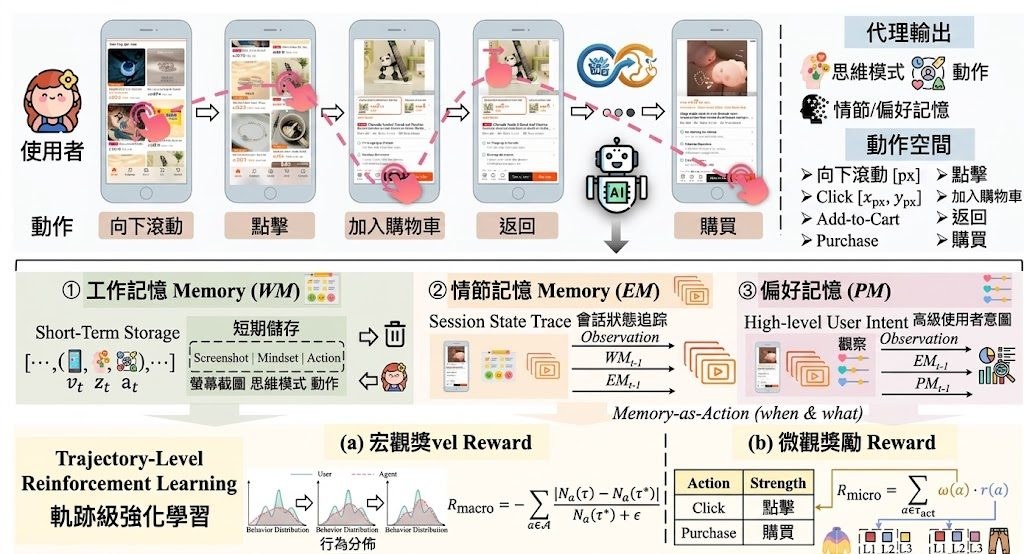
網上購物模擬器要重現真人由瀏覽、比較到購買的連續決定,才能支援推薦系統的離線測試和 Reinforcement Learning(RL)訓練。RecVerse 是一個以 GUI 為基礎的模擬代理,透過螢幕截圖理解頁面,生成多輪購物軌跡,處理長時間瀏覽中用戶狀態不斷變化的問題。

現有做法各有缺口:Rule-based simulators 依賴向量化商品特徵和預設行動空間,難以涵蓋複雜的電商介面;Large Language Models(LLMs)和 Vision-Language Models(VLMs)代理雖然加入推理及 persona 建模,長會話仍可能丟失早期觀察,或者把所有歷史硬塞進 context window。逐步模仿每個已記錄行動,亦可能令整段流程出現過度探索或過分被動等不自然模式。

RecVerse以認知啟發的分層記憶處理長期資訊,包括短期焦點用的 Working Memory、保存本次會話軌跡的 Episodic Memory,以及記錄高層次意圖的 Preference Memory。記憶更新本身被視為行動,代理可以按情況學習何時及應該保存哪些資訊。

訓練時,系統改用 trajectory-level RL,直接為完整購物會話評分,同時對齊真人的宏觀行動類型分佈和微觀購物意圖。研究團隊亦發布 USB(UserSimulationBenchmark)互動式電商 GUI 軌跡數據集;實驗結果指 RecVerse 在行為忠實度和意圖一致性上均優於現有基線。

  • 以螢幕截圖理解電商 GUI,生成多輪購物行為
  • 透過三層記憶保留短期焦點、會話經歷和用戶偏好
  • 用完整軌跡目標修正逐步模仿帶來的不自然行為
  • USB 提供互動式電商 GUI 軌跡數據集
  • 可用於推薦策略的離線及反事實測試

Paper

Categories: 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, 中國

ForgeWM 把遊戲世界模型推向 72 FPS 即時互動

由中大、騰訊等團隊開發的 ForgeWM,將遊戲畫面生成壓縮至一至四步,讓鍵盤、滑鼠及手掣輸入能即時改變虛擬世界。

ForgeWM

中香港中文大學、騰訊 PCG、復旦大學、上海人工智慧實驗室及香港科技大學的研究團隊,將 ForgeWM 做成開源的 action-conditioned video world models 訓練項目,處理遊戲輸入與連續畫面生成難以兼顧的問題。它以 Matrix-Game 2(MG2)為基礎,讓模型根據鍵盤、滑鼠或 gamepad 操作即時推演遊戲畫面。

ForgeWM 的價值在於把生成步數降至 1、2 或 4 步,換取更低延遲的互動體驗;取捨是畫面質素、控制準確度與推理速度仍要依賴訓練資料和硬件。相較只展示影片生成的做法,ForgeWM 直接處理 frame-aligned 的動作訊號,並將同一套流程移植到另一個 gamepad 驅動的 FPS 領域。

  • 一套四階段流程:bidirectional SFT、teacher-forced causal AR、consistency distillation、on-policy DMD
  • ForgeWM-1、ForgeWM-2、ForgeWM-4 分別對應一、二及四步生成
  • 單張 H20、352×640 畫面下,1-step 模型最高達 72 FPS
  • 完整公開 weights、training code 及 pre-encoded data

模型並非各自獨立訓練:Stage 0 先對目標遊戲作 bidirectional fine-tuning,之後固定為教師;Stage 1 將生成器改成 causal AR,Stage 2 壓縮 sampling trajectory,Stage 3 再用學生自行 rollout 的結果進行 on-policy matching。這個結構讓 ForgeWM-1、-2、-4 可從相同基礎流程按步數預算建立。

研究、遊戲 AI 及需要即時互動生成的團隊較容易受益,尤其適合測試鍵鼠控制的 Minecraft 或 gamepad FPS。資料提供的指標包括 168 ms per chunk、72 FPS 及 8×H20 完整訓練配置;模型及數據連結整理環境,要預留 8 張 H20 重現完整訓練流程。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, 上海人工智慧實驗室, 騰訊, 世界模型, 模型訓練, Video, World-Action Model

FACET-Terminal:讓終端任務由可執行環境先行生成

FACET 把技能、Docker 環境、解法與驗證器連成同一狀態,產出可真正執行驗證的終端任務。

FACET: Preserving Source Intent and Executable State in Terminal Task Synthesis

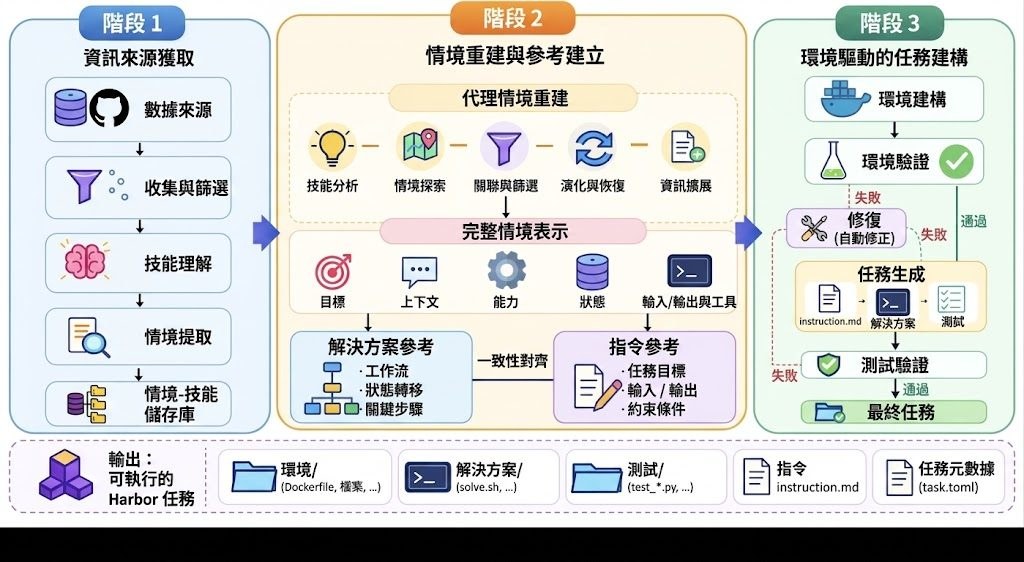
終端 AI Agent 最怕指令寫得合理,環境、解法和驗證器卻互相對不上。FACET(Fine-grained Agentic Construction of Executable Tasks)是一套終端任務合成框架,先建立並修復 Docker 環境,再讓指令、參考解法和驗證器共享同一套執行狀態,處理複雜任務難以穩定測試的問題。

項目由 71,341 個來源技能整理出 7,852 條場景—技能種子,最後取得 6,078 個通過執行驗證的任務,並從成功 rollout 篩選約 1.2K 條完整軌跡,用於監督微調 Qwen3.5 系列模型。環境中的檔案、路徑、套件、連接埠、資料結構和測試資料會沿流程傳遞,減少純文字交接造成的落差。

資源包括 FACET-Terminal-Tasks-6k 數據集,以及 FACET-Terminal-Qwen3.5-4B、9B 和 27B 模型。要重現任務合成流程,需要 Python 3.11–3.13、uv、Docker 和模型 API;配置與 Python 程式集中在 facet/,並提供 FORWARDREVERSEJOINT 三種生成策略作比較。

Terminal-Bench 2.1 的三次獨立執行平均結果顯示,4B、9B、27B 模型分別由 17.60、27.34、40.82 提升至 24.72、35.58、47.57;4B 相對提升 40.5%,27B 更接近同設定下 Qwen3.5-397B 的 49.06。這批數據規模仍然有限,任務質素亦依賴 Docker 環境和驗證器是否正確,較適合研究 Agent 訓練、Terminal-Bench 評測及需要可重現終端操作的團隊。

  • 資料基礎:6,078 個通過執行驗證的任務
  • 生成方式:環境先行,指令、解法與驗證器共享狀態
  • 公開模型:Qwen3.5 4B、9B、27B
  • 評測結果:27B 在 Terminal-Bench 2.1 達 47.57
  • 適合場景:終端 Agent 訓練、任務合成及可重現評測

項目主頁 · GitHub · 模型

Categories: 開源, 上海人工智慧實驗室, Agentic, 模型, 模型訓練, API, Python, 中國, Dataset 數據集

HarnessEval-W 讓世界模型評測留下可核查推理鏈

世界模型評測不再只給一個分數,HarnessEval-W把每次判斷拆成可追溯的證據樹,讓物理與因果錯誤更容易核對。

HarnessEval logo

當世界模型生成一段互動場景,真正難判斷的往往不是畫面是否漂亮,而是物理、因果和世界狀態有沒有隨行動正確演變。HarnessEval-W 屬於開源的 agentified benchmark,實際處理的是如何把這些需要理解上下文的評測工作,轉化成可檢查、可重現的判斷流程。

它借用 Large Language Model(LLM)生態常見的 harness 思路,先按每個 evaluation case 的初始世界、action 和 probe intent 分解問題,再由具備不同工具與上下文的 specialized sub-agents 分工判斷,最後由 parent agent 驗證證據並整合 verdict。每次評測都會留下 evidence tree,記錄測試內容、視覺依據和完整推理鏈,研究團隊可以追查分數由何而來,而不是只接受一個難以解釋的 scalar score。

  • 支援 330 個 evaluation cases、5,940 次 scored rollouts
  • 以 11 個 specialized evaluation skills 覆蓋品質、轉換與持續性
  • 涵蓋 18 個 world models,並提供 leaderboard 與可執行評測程式
  • 包含 harnesseval-metrics,以及 physical-plausibility backend harnesseval-pavrm

HarnessEval-W 在 intentional transition 上與人類 Bradley–Terry ranking 的 Spearman correlation 為 0.93;physical transition 的 pairwise accuracy 達 71.7%,高於 WBench 的 31.9%。重複評測的結果範圍亦較 WBench 窄 4.9 倍,但這些數字仍取決於案例設計、技能路由和代理判斷品質,不能直接視為所有世界模型任務的通用排名。

項目提供固定 plans、benchmark 資源、metric backends 和可延伸的 skill library;團隊可以先重現既有 cases,再提交新世界、新 action、新 probe family 或新 skill。它較適合研究世界模型、建立可審計評測流程,或需要比較物理合理性與狀態持續性的團隊;對只想快速取得單一分數的測試流程而言,完整證據樹會增加運算與整合成本,但換來更清楚的錯誤定位能力。

項目主頁 · GitHub

Categories: 開源, 北京大學, Agentic, 世界模型, , Dataset 數據集, Skill 技能

[技術文章] pixel-space 模型可以追平甚至超過 latent-space 對應模型

研究聚焦 pixel-space text-to-image diffusion models 的訓練卡位,找出點樣喺大規模條件下兼顧畫質同速度。作者用 latent-to-pixel 策略,令 pixel-space 模型更接近甚至超過 latent-space 表現。

Hero image preview

上圖是透過 pixel-space text-to-image diffusion models 的方法訓練的 Z-Image-Turbo (Pixel) 產生的圖像。在企業級 H800 GPU 上,推理延遲僅約 0.2 秒。

Pixel-space text-to-image diffusion models 一直有兩個吸引位:直接生成像素,唔受 VAE 壓縮上限限制,亦可以省去解碼步驟。但喺大規模訓練下,佢哋收斂速度明顯慢過 latent-space 模型,令「畫質、效率、可訓練性」三者之間嘅平衡一直唔夠成熟。

呢篇工作針對嘅正係呢個落差。作者先比較 pixel-space 同 latent-space 喺大規模 pre-training 下嘅行為,再提出 latent-to-pixel 策略:先喺 latent space 學到生成先驗,再轉去 pixel space 做 post-training,避免一開始就喺難度更高嘅像素空間硬推。

佢哋亦系統研究咗多個轉換設計,包括 weight initialization、data composition、prediction target、decoder architecture 同 noise schedule,整理出一套可行做法。結果顯示,做法調整得當之後,pixel-space 模型可以追平甚至超過 latent-space 對應模型,推理端仲有 3.18 到 4.75 倍嘅速度提升。

  • 直接處理 pixel-space diffusion models 喺大規模訓練時收斂慢嘅問題
  • 用 latent-to-pixel 路線,先學先驗,再轉入像素空間微調
  • 檢視多個關鍵訓練選項,搵出實用 recipe
  • 在畫質不退讓之下,換取更快的 end-to-end inference
  • 對想做高效文生圖系統、又在意生成細節保留嘅團隊最有參考價值

Paper

Categories: 香港科技大學, 南京大學, 阿里巴巴, 模型, 模型訓練, Image, txt2img, 香港

ClawGym:為 Claw 類代理搭建可訓練環境

ClawGym 讓本地、帶狀態的工作空間可用來合成資料、訓練代理同評估表現。你可以把它理解成一套面向 Claw-style personal agents 的研究與實驗框架。

Og image

ClawGym 把原本分散的代理開發流程收攏到同一個工作框架內,重點是處理本地、帶狀態工作空間中的任務生成、訓練同評測。對做 agent 研究或想驗證 Claw-style personal agents 的人來講,佢解決嘅唔係單一模型能力,而係點樣有系統咁建立可重複的實驗流程。

它嘅做法唔係只提供一個執行環境,而係同時涵蓋資料合成、agent 訓練同 benchmark 評估。令研究者可以用同一套基礎去跑不同任務,再睇代理喺有狀態工作空間入面表現有幾穩定。

幾個重點值得留意:
– 針對 local、stateful workspace,適合需要保留上下文同操作痕跡的任務
– 同時涵蓋 synthesized data、training 同 evaluation,減少流程分散
– 聚焦 Claw-style personal agents,而唔係泛用式聊天代理
– 已釋出 ClawGym-Bench 同 ClawGym-SynData,方便做對照測試同資料實驗

從公開資訊睇,ClawGym 亦一路延伸到更大範圍的 RL on general agent tasks,甚至可以透過 OpenClaw、Claude Code 呢類較複雜的 black-box agent harness 去做統一訓練。對想比較不同 agent 工作流、或者研究黑箱代理強化學習的人,佢提供咗一個較完整的基座。

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, 軟件, Medical醫學, 安全, OpenClaw, 中國, Dataset 數據集, Skill 技能

MobileMem 把手機長期記憶放入真實場景測試

手機助手要記住一年的生活,難點不只是搜尋資料,更要理解跨應用、跨模態的長期脈絡。

logo

手機助手若要回答「女兒七歲生日有哪些照片」或核對過敏藥物,單靠短對話記憶很快會失準。MobileMem 屬於端側長期記憶(on-device long-term memory)的評測框架與資料集,將一年手機經歷整理成可重現的測試環境,檢驗記憶系統能否跨應用保留、連結及找回重要資訊。

它涵蓋 365 天、12 個應用程式,以及每位使用者平均 1.72M tokens 的資料規模,來源包括對話、日曆、筆記、瀏覽紀錄和相片等異質內容。與只測單輪問答或獨立文件檢索的做法相比,MobileMem 更接近長期使用情境,但同時令資料整理、隱私處理和推理成本變得更複雜。

資料分為兩條 benchmark track:text 供文字記憶系統處理長期對話與結構化 mobile-app events;omni 則加入 screenshots 和 photos,測試多模態記憶。它本身不是模型,而是用來比較不同 memory systems、分析失敗原因及建立 leaderboard 的測試基礎。

  • 支援文字與多模態兩類測試
  • 涵蓋跨應用、長期且知識密集的 mobile agent trajectories
  • 可從 HuggingFace 下載資料集
  • Dataset Explorer branch 提供互動式資料瀏覽
  • 現有資訊未列出具體模型分數,需查看 leaderboard 或自行重跑測試

研究人員可先下載 HuggingFace 資料集,按 text 或 omni 軌道接入自己的記憶模型,再利用網站和 Dataset Explorer 檢查案例。適合開發 mobile agents、personalized assistant、長期 RAG 或 multimodal memory 的團隊;涉及健康紀錄、家庭相片等私人內容時,仍要自行確認資料授權、匿名化和端側部署要求。

項目主頁 · GitHub

Categories: 開源, Agentic, RAG, 多模態模型, Medical醫學, 中國, Dataset 數據集

Page 2 of 15
1 2 3 4 15