MBM:跨類別動作轉移突破

你可以把它理解成一套跨類別影片動作轉移框架,重點是外形差很多時仍保住動作與身份。

Framework

想把一段動作搬到另一個角色或畫面,最怕形態差太遠時連身份都一併扭曲。MBM 走的是一套 motion transfer 研究框架,重點是把跨類別動作轉移做得更穩,讓 reference video 的動作可以連同 text,必要時再加一張 reference image,一起驅動生成。

它分兩段處理:Stage I 先學 heterogeneous abstract motion conditions,再 bootstrap cross-category motion pairs;Stage II 再用 raw reference videos 把這套監督內化。推理時直接靠 reference video、text 和 optional reference image,不需要 explicit motion extraction 或 test-time optimization。

它和只在相近外形之間搬動作的做法不同,目標是連 same-category、near-category 到 far-category 都盡量維持 motion fidelity 與 target preservation。資料同時提到 OpenVMT-Dataset 和 OpenVMT-Bench,前者是 instance-level motion-equivalent cross-content pairs,後者則用逐步拉大的 category gap 去測。

  • 兩階段框架先學抽象動作,再把監督內化到生成流程
  • 推理端直接吃 reference video、text、optional reference image,流程較短
  • 主打跨類別動作轉移,適合影片生成、角色動作遷移、動畫合成
  • 在大形態差距下仍可維持較好的動作保真與目標保留

項目主頁 · GitHub

Categories: 開源, 北京大學, AI productions, Video, Image, 框架

[技術文章] StyleForge 以反事實推理統一室內家具風格配搭

面對固定間隔的室內佈局,StyleForge 不再逐件揀家具,而是連同整個房間一齊判斷風格協調。你可以把它理解成一個會追蹤跨家具衝突的選件框架。

Hero image preview

固定佈局的室內家具風格配搭,難點唔係搵到單件外觀相符嘅家具,而係放埋一齊之後會唔會撞色、撞材質,甚至整體氣質唔夾。StyleForge 就係針對呢個問題而設,喺唔改變家具類別、位置、朝向同比例嘅前提下,幫系統為每個家具槽位揀出更一致嘅組合。

現有做法多數只係逐件檢索,或者靠靜態關係去描述房間,結果容易忽略全局配搭。StyleForge 改用 scene-level structured selection framework,先由凍結嘅 multimodal large language model(MLLM)抽取風格線索,再由可學習嘅候選分佈配合 dynamic hypergraph style field,捕捉家具之間更高階嘅依賴。

佢另一個重點係 counterfactual style preference learning。做法係將每個候選視為當前風格場入面嘅局部替換,然後用 Mahalanobis energies 去評估同上下文嘅相容性,訓練時再交替優化風格場同候選 logits;推理時只更新房間專屬嘅候選 logits,逐步修正跨槽位衝突。

  • 同時考慮單件相關性同整體房間協調
  • 用動態 hypergraph 去表達跨家具依賴
  • 以反事實推理檢查候選喺場景中的相容性
  • 推理階段只調整房間專屬 logits,模型主體保持凍結
  • 喺 3D-FRONT 上做出較一致嘅固定佈局家具安排

作者喺 3D-FRONT 上展示咗更高嘅 furniture retrieval 表現,同時亦提升 scene-level style coherence。對做虛擬室內設計、3D 內容製作,或者需要穩定室內擺設嘅 immersive embodied environments,呢種「先睇整體,再揀單件」嘅方法會更貼近實際需要。

Paper

Categories: 框架, 3D, 中國

See2Think 驗證多模態模型有冇「睇圖再諗」

多模態模型會畫輔助線、標示區域,未必代表後續推理真係依賴咗呢些中間視覺狀態。See2Think想量度的,正正就是這段常被忽略的過程。

See2Think — Do Multimodal Models Really Use Intermediate Visual States?

見到模型會畫線、裁圖、標記物件,很多人自然會當它「有睇過先答」。See2Think屬於基準測試加診斷框架,焦點不是只看最後答啱幾多,而是拆開檢查中間視覺狀態有冇被真正用到、渲染是否忠實,以及後續推理有冇因此改變,這點對多模態模型(Multimodal Models)尤其關鍵。

它的核心設計分成兩部分:See2ThinkBench 收錄 1,200 條 visually dependent 問題,涵蓋 2D structured reasoning、3D scene reasoning 同 real-world visual reasoning;另一部分是 Visual Action-of-Thought(VAoT)流程,會把文字思路、structured visual actions、rendered states 同之後的推理串連起來。這種做法比單看 final-answer accuracy 更有診斷力,因為可以分辨模型是在「做出圖像」還是在「依賴圖像」。

同類研究常停留在結果分數,See2Think較著重受控比較。它設有 CoT、NoRender、Full、WrongRender 等 matched comparisons,又會檢查 render-benefit、corrupted-feedback sensitivity,以及 process judging 裡的 relevance、faithfulness、uptake,換句話說,不只問模型答得對不對,還會問中間那一步是否相關、是否被正確執行、以及模型有沒有吸收回來的視覺資訊。

  • 適合研究多模態推理、agent 行為分析、視覺工具鏈設計的團隊
  • 強項在於把「中間圖像是否有用」變成可觀察、可干預的測試問題
  • 覆蓋圖表、幾何、符號結構、3D 空間關係到真實圖片場景
  • GitHub 已公開程式與 quick start 線索,但論文仍標示為 coming soon,細部實驗設定仍要以後續正式文件核對

對模型評估要求較細緻的情境,這個項目很有參考價值;想拿它直接當應用工具就未必是同一回事。它更像研究型基礎設施,幫團隊判斷多模態系統的推理鏈是否可信,而不是單純追求更高答題分數。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 上海人工智慧實驗室, Agentic, 多模態模型, 3D, Dataset 數據集

OpenRSI 實現 AI 可控的自我進化流程

OpenRSI唔只放出模型,而係連訓練、任務、搜尋流程一併公開。對想研究 AI4AI 同 Machine Learning Engineering 的團隊來說,它更像一套可重跑的實驗場。

OpenRSI by Frontis

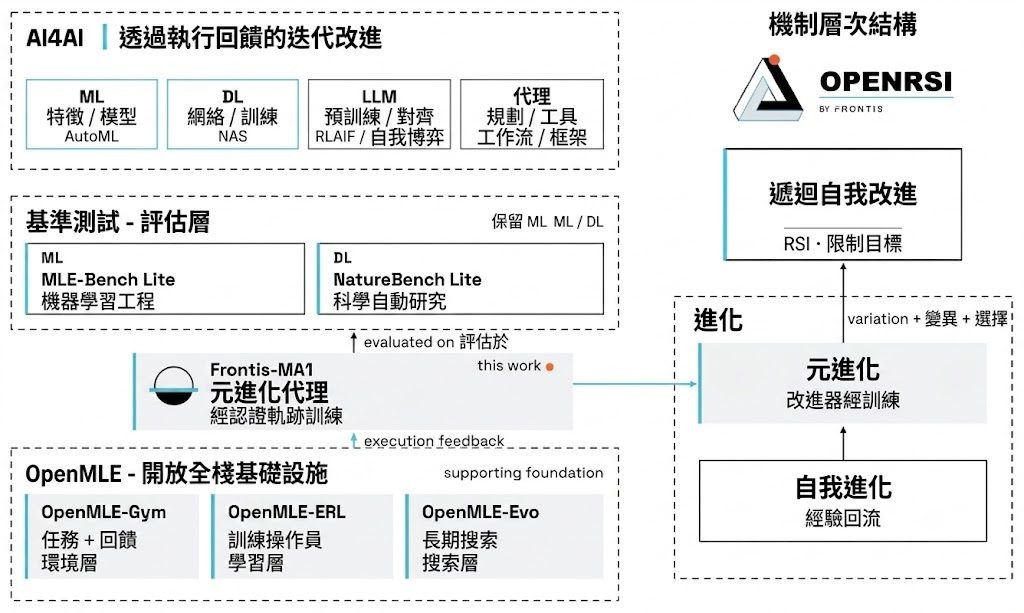
OpenRSI(Recursive Self-Improvement) 唔係單獨放出一個模型,而係把「AI improving AI」拆成可以執行、量度同重現的整套機械學習工程流程。它屬於開源研究框架加模型組合,核心想處理的是:點樣令 AI 不只寫程式,而係能夠持續改良建立 AI 的方法本身。

OpenRSI 由 OpenMLE 同 Frontis-MA1 連動組成。OpenMLE 負責提供可驗證任務環境、執行回饋、RL 與 evolutionary search;Frontis-MA1 則是一個 post-trained AI4AI model,圍繞 Draft、Improve、Debug、Crossover 四種程式演化操作運作,將訓練到的能力接到長步驟搜尋流程之中。呢種做法的取捨很明顯:它追求可重跑與可評測,所以系統較完整,也比只放模型權重的項目更講究環境與任務設計。

項目較適合研究 Agentic workflow、Machine Learning Engineering、自動化實驗搜尋,或者想分析 execution-grounded learning 點樣落地的團隊。資料已列出 Hugging Face 模型、GGUF 衍生版本、Tasks 同 SFT traces,亦有專屬 project page;但目前公開資訊著重系統構成與結果展示,README 摘錄未完整交代詳細安裝步驟,部署前仍要配合原始倉庫與外部連結自行核對。

  • OpenMLE 提供 gym、RL、Evo 等完整堆疊,不只是一組 benchmark
  • Frontis-MA1 把 operator learning 同 long-horizon search 接埋,重點在可執行研究循環
  • 公開內容包括模型、任務資料集、SFT traces,同時照顧訓練與評測重現
  • 提供 GGUF 格式在本地執行推理 的衍生版本,方便不同部署路線

效能方面,項目頁面列出 Frontis-MA1 在 MLE-Bench Lite 由 39.39 提升到 71.21,設定為每個 task 12 小時、單張 RTX 4090 並限制 12 GB VRAM,成績高於 GPT-5.5 + Codex。呢個結果反映它強項在於把執行回饋、後訓練同演化搜尋接成一個閉環;不過現階段它仍主要面向 Machine Learning Engineering,較像一個為 RSI 研究而建的開放實驗平台,而唔係通用型開發工具。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, 模型, Dataset 數據集

OpenRSI 想把 AI 研發流程變成可執行系統

OpenRSI唔只放出模型,而係連訓練、任務、搜尋流程一併公開。對想研究 AI4AI 同 Machine Learning Engineering 的團隊來說,它更像一套可重跑的實驗場。

OpenRSI by Frontis

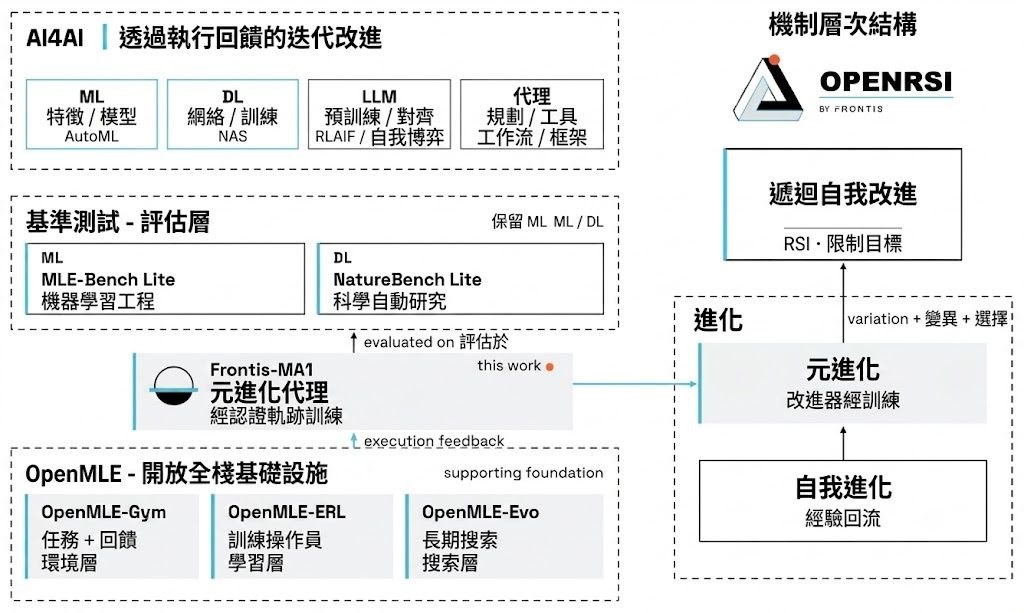
OpenRSI(Recursive Self-Improvement) 唔係單獨放出一個模型,而係把「AI improving AI」拆成可以執行、量度同重現的整套機械學習工程流程。它屬於開源研究框架加模型組合,核心想處理的是:點樣令 AI 不只寫程式,而係能夠持續改良建立 AI 的方法本身。

OpenRSI 由 OpenMLE 同 Frontis-MA1 連動組成。OpenMLE 負責提供可驗證任務環境、執行回饋、RL 與 evolutionary search;Frontis-MA1 則是一個 post-trained AI4AI model,圍繞 Draft、Improve、Debug、Crossover 四種程式演化操作運作,將訓練到的能力接到長步驟搜尋流程之中。呢種做法的取捨很明顯:它追求可重跑與可評測,所以系統較完整,也比只放模型權重的項目更講究環境與任務設計。

項目較適合研究 Agentic workflow、Machine Learning Engineering、自動化實驗搜尋,或者想分析 execution-grounded learning 點樣落地的團隊。資料已列出 Hugging Face 模型、GGUF 衍生版本、Tasks 同 SFT traces,亦有專屬 project page;但目前公開資訊著重系統構成與結果展示,README 摘錄未完整交代詳細安裝步驟,部署前仍要配合原始倉庫與外部連結自行核對。

  • OpenMLE 提供 gym、RL、Evo 等完整堆疊,不只是一組 benchmark
  • Frontis-MA1 把 operator learning 同 long-horizon search 接埋,重點在可執行研究循環
  • 公開內容包括模型、任務資料集、SFT traces,同時照顧訓練與評測重現
  • 提供 GGUF 格式在本地執行推理 的衍生版本,方便不同部署路線

效能方面,項目頁面列出 Frontis-MA1 在 MLE-Bench Lite 由 39.39 提升到 71.21,設定為每個 task 12 小時、單張 RTX 4090 並限制 12 GB VRAM,成績高於 GPT-5.5 + Codex。呢個結果反映它強項在於把執行回饋、後訓練同演化搜尋接成一個閉環;不過現階段它仍主要面向 Machine Learning Engineering,較像一個為 RSI 研究而建的開放實驗平台,而唔係通用型開發工具。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, 模型, Dataset 數據集

PALATE 改寫角色扮演 AI 才算演得好

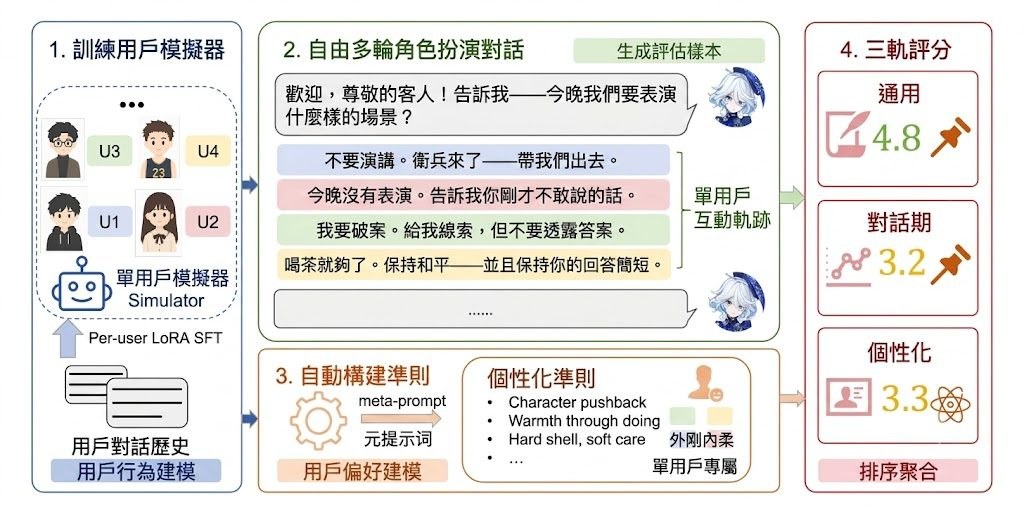
現有角色扮演評測用固定對話歷史加統一評分尺,難以反映真實用戶體驗。PALATE 改為訓練專屬用戶模擬器並生成個人化評分準則,讓評估貼近每個用戶的真實感受。

Overview of the PALATE evaluation pipeline

PALATE(Person-Aligned LLM-Simulated-User Assessment with Tailored Evaluation)的核心做法,是為每位參與者訓練一個專屬的 LoRA 用戶模擬器,讓模擬器和候選角色扮演 AI 自由多輪對話,再從該用戶的歷史數據自動生成一套個人化評分尺。評估拆成三條軌道:針對特定用戶–AI 配對的個人化體驗品質、跨用戶通用的回合級角色扮演品質,以及整個對話過程的連貫性與發展。

角色扮演 RPAs(Role-playing agents ) 的表現好不好,往往不只是模型本身的問題,而是和它對話的那個用戶決定。現有基準普遍要求模型接續一段預寫好的「借用對話」,再用統一的評分尺去評那段回應,結果把模型能力、前置對話品質、個人偏好混在一起打分。中國科技大學與 MetaStone 的團隊指出,這種做法忽略了用戶之間的巨大差異,也無法在真正的多輪場景下做科學評估。

團隊用 16 個候選系統生成 1,600 條獨立軌跡進行評測。個人化軌跡上,Qwen3-Max 領先;GPT-5.4 在通用軌跡表現最佳;Claude Sonnet 4.6 則主導會話軌跡。值得注意的是,沒有任何模型在所有五位用戶上都勝出,反映出個人化評測的必要性。個人化評分尺與人類判斷的一致性達到 0.613,高於通用評分尺。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 框架, 中國, Dataset 數據集

Temporal-Distance-JEPA 訓練世界模型能懂「時間距離」

香港浸會大學團隊把 JEPA 世界模型由「會預測」推近一步到「更識規劃」。Temporal-Distance-JEPA 針對離線示範缺少回報訊號的痛點,直接從軌跡次序挖出可用的進度成本。

Repository image for HKBU-KnowComp/Temporal-Distance-JEPA

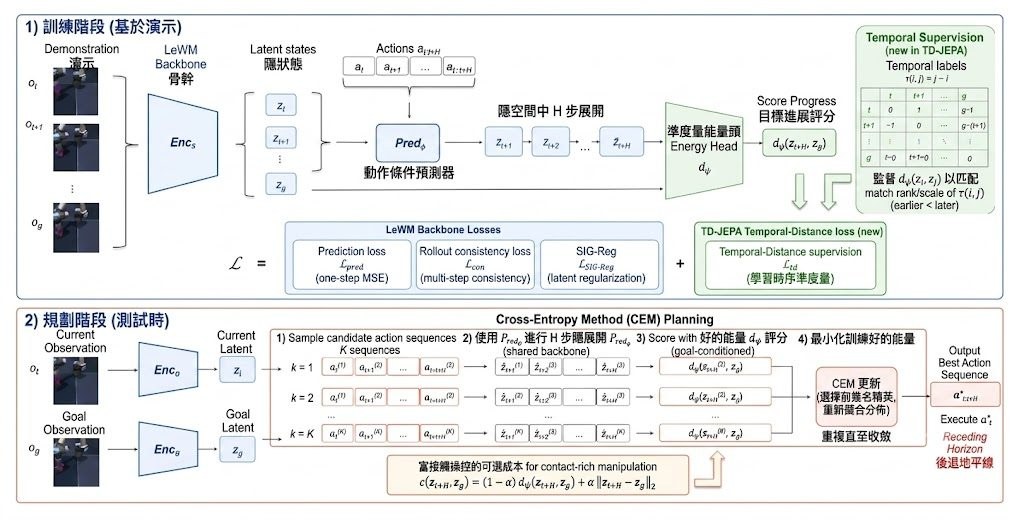
香港浸會大學 HKBU KnowComp 的 Jiaxin Bai 公開了 Temporal-Distance-JEPA 論文重現項目,核心不是再做一個更複雜的世界模型,而是修正 JEPA 規劃常見的落差:訓練時學短期 latent prediction,規劃時卻往往直接拿 latent Euclidean distance 當成目標進度。這個項目屬於模型研究重現項目,處理的是離線示範沒有 reward 時,planner 點樣判斷哪條想像路徑更接近目標。

作者保留 LeWM encoder–predictor 與 SIGReg backbone,但不再只依賴 embedding 幾何,而是從 reward-free demonstration logs 挖出 directed temporal cost。做法沿住論文邏輯很清楚:同一條 trajectory 的先後步序提供 positive targets,跨 trajectory 配對充當 heuristic negatives,再用 rollout-consistency 令學到的成本更貼近 planner horizon。這種 framing 直接回應舊範式把 latent L2 當成進度代理的限制,因為拓撲主導任務未必適合只看幾何距離。

結果在 Two-Room、Reacher 這類 topology-dominated tasks,規劃時直接部署 mined cost d_psi;到了 Push-T、OGB-Cube 這類 contact-rich tasks,則改用同一個 temporally trained checkpoint 上的 latent l2 planning。locked evaluation 下,Two-Room 成功率提升到 100.0%,高於 LeWM 的 97.4%;OGB-Cube 亦比 LeWM 高 14.2 分,並且整體上對 LeWM 與 RC-aux baseline 都能持平或更好。

  • 建基於 stable-worldmodel、stable-pretraining 與 LeWM 既有布局,重點在訓練目標與規劃成本的重新對齊
  • 公開庫是 paper-reproduction release,保留 Python CLI,但刻意不附 cluster/Slurm 包裝
  • 資料以 HDF5 形式放在 STABLEWM_HOME,涵蓋 Push-T、Two-Room、Reacher、OGB-Cube
  • 採用 10 epochs,並附有 locked results、cost matrix、diagnostics 等結果資料

這個庫比較像給已有研究工作流的人接手重跑:有 Python 環境、requirements、Hydra config、資料位置與 checkpoint 輸出方式,但沒有替不同排程系統準備現成封裝。歷史上的 contrastive SoftJEPA 相容程式仍可能留在 losses.py 或 jepa.py,不屬於公開配置;換句話說,閱讀與重現時要以 td_jepa 設定為準。對做 world model、offline RL、latent MPC 的研究團隊來說,這個項目最有價值的地方,是它把「表示學到什麼」與「規劃要怎樣排序未來」重新綁在一起。

GitHub · Paper

Categories: 開源, 浸會大學, Embedding, 世界模型, 模型訓練, 香港, Python, 中國

ClinFusion 把醫療影像讀懂再回答

ClinFusion瞄準的不是一般聊天,而是把2D與3D醫療影像連同文字指令一併理解。它想解決的重點,是醫療多模態模型常見的看得多、答得快,卻未必貼近臨床判讀。

radar chart

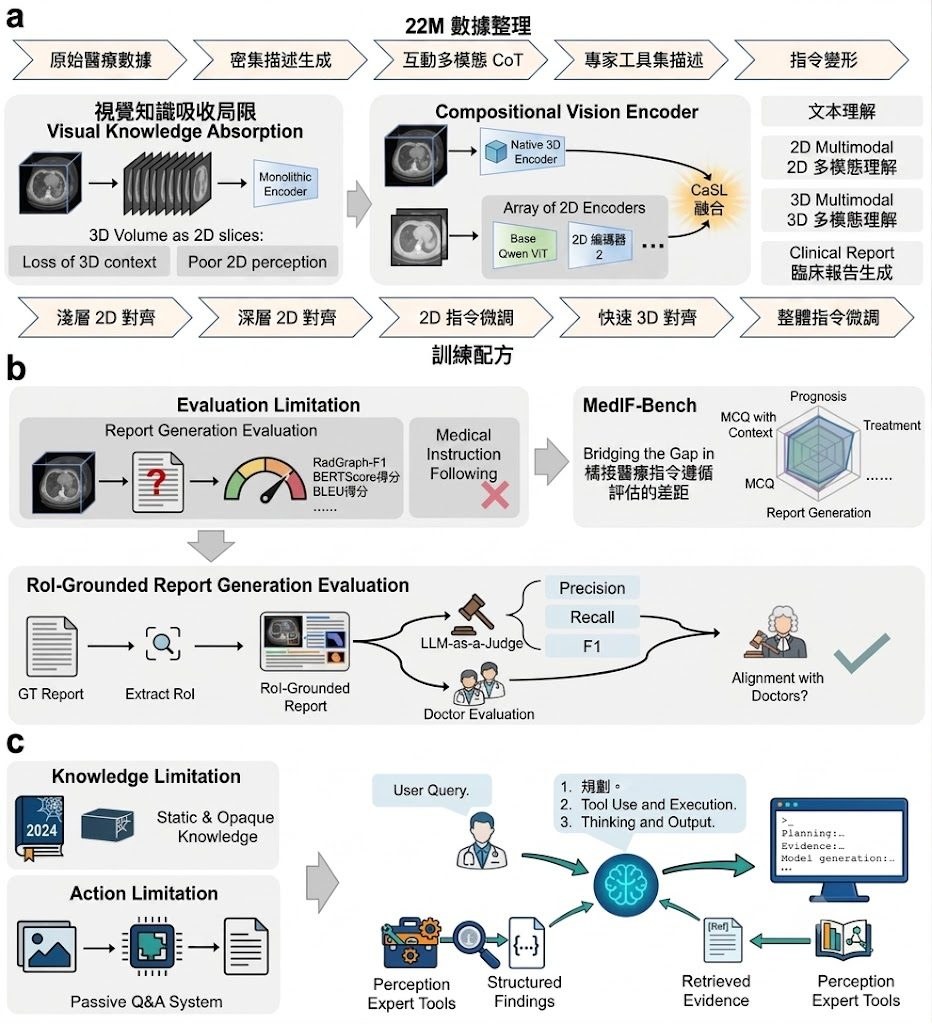
醫療多模態模型最易失準的位置,往往不是會不會答,而是有沒有真正對準影像內容。ClinFusion屬於模型,更準確地說是面向臨床理解的 vision-centric Multimodal large language models (MLLMs) 系統,重點放在同時處理 2D 圖像、原生 3D NIfTI 影像與文字任務,減少只靠文字對齊時常見的臨床細節流失。

現有做法常把醫療問題當成一般多模態問答處理,但作者認為這種範式忽略了 3D 影像與放射科判讀流程,因此用 compositional and cascaded vision encoder 配合 Cascade Spatial-Aware Locality Fusion,把 2D 與 native 3D 醫療影像放進同一個 fused encoder。另一個關鍵不是只換模型,而是連評測也改寫:加入 MedIF-Bench 檢查 instruction following,並用 region-of-interest-grounded 方法評估報告生成的 factualness。

論文給出的成績相當進取:ClinFusion 在 24 個基準中有 20 個超過 Hulu-Med、Lingshu 等開源醫療 MLLMs,也在 16 個比較裡有 13 個勝過 GPT-5.2 與 Gemini-3-Flash。盲測部分由 board-certified radiologists 進行,報告排名亦拿到最佳,RoI-grounded metric 與專家判斷的相關性也最高,這點比單看自動分數更有說服力。

  • 可接受文字 prompt、2D 圖像路徑,以及 3D NIfTI volumes(.nii.gz)
  • 定位不是通用聊天,而是臨床導向的整體醫療理解
  • 核心取向是把 2D/3D 視覺編碼與臨床一致的評測一併重做
  • 已公開模型推理方向,但儲存庫資訊未完整交代部署流程與完整安裝細節

較適合留意這個項目的,會是做醫療 AI、放射影像、多模態研究或醫療報告生成評測的團隊。它的亮點在於把「模型看見了什麼」與「臨床上是否講得準」放到同一條線上;限制亦很清楚,現有 GitHub 資訊主要集中在作者主張與推理輸入格式,真正要落地到醫院工作流,仍要再看公開模型、硬件需求與後續工具鏈是否齊備。

GitHub · 模型

Categories: 開源, 清華大學, 阿里巴巴, 模型, 多模態模型, Qwen, Image, Medical醫學, 3D, 中國, Dataset 數據集

FinanceComplexQA 點評:金融長文件問答基準

想測試模型是否真係讀得懂財務文件,FinanceComplexQA比一般抽句式問答更貼近難題。它把中英雙語、推理、多步計算與文件依據綁在同一個基準內。

Finance-ComplexQA at a Glance

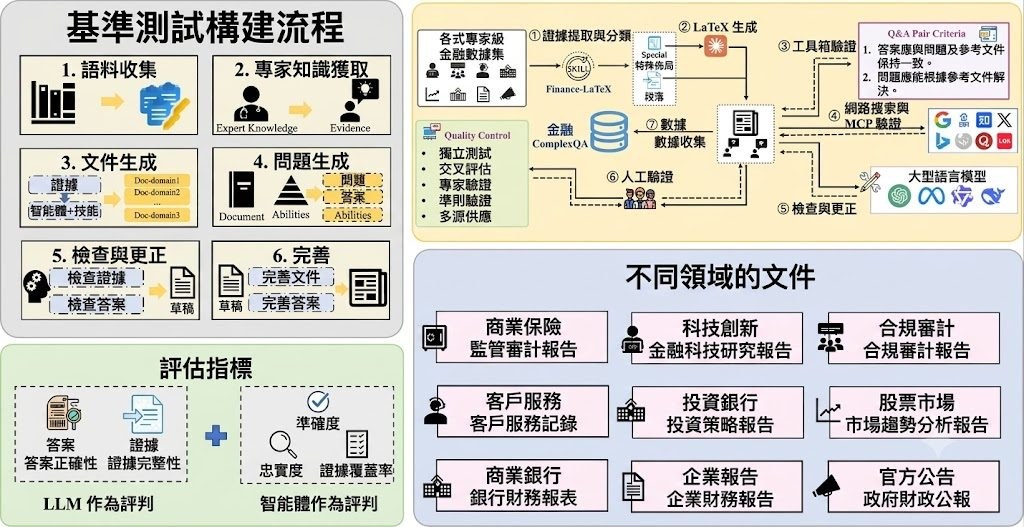
金融問答最容易失真的位置,不是模型識唔識術語,而是它會否真正在整份參考文件入面推理、比對同計數。FinanceComplexQA屬於數據集/Benchmark,焦點不是背答案,而是檢驗 LLMs 和 agents 能否根據完整 reference documents 回答複雜金融問題。

它修正了只靠 parametric knowledge 或抽取單一段落的評測範式。作者把重點放在 document-grounded complex financial QA,要求答案同問題及原始文件一致,並涵蓋 multi-hop reasoning、numerical calculation、comparison、implicit inference、planning、summarization 同 evidence-grounded verification,對 RAG、Agentic workflow 同長文本閱讀能力都有參考價值。

資料結構本身亦有取捨。FinComplexQA-Pro 收錄 2,026 組獨立 QA,按語言、金融場景與任務分類組織;同一題會以 scene_categories 與 task_categories 兩種視角出現,所以總記錄視圖有 4,052 筆。另有 overall 提供 agent_answer、agent_thinking 及 LLM-as-a-judge 分數,但這些分數只適合做診斷訊號,不能當 ground truth。

  • 支援中文與英文,但兩個子集覆蓋的文件領域不同,schema 亦不完全一致
  • 較適合逐個子目錄讀取 JSONL,而不是一開始合併全部資料
  • 可用 exact match、數值容差、F1、semantic similarity 等方法比對輸出
  • 附有 Reference_documents,方便追查 PDF 與 LaTeX 原文證據

部署和測試的理解方式相當直接:資料主要在 Hugging Face 發佈,研究團隊可先挑單一語言、單一 task category 載入,再把模型輸出對照 gold answer 或文件證據做評估。它較受惠於做金融 RAG、長文件 QA、Agent 評測或雙語研究的團隊;要留意的是金融事實具時效性,而且項目已明確標示僅供研究與評估,不應延伸成投資、會計、法律或財務建議。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, RAG, 多模態模型, 微軟, DeepSeek, 中國, Dataset 數據集

RIPO 直指 LLM 強化學習探索崩塌

RIPO 不是再調一個 PPO-Clip 變體,而是直接質疑量度策略差異的方法。對想提升 LLM 推理訓練穩定度的人,這個方向值得留意。

Repository image for Aiolus-X/RIPO

訓練 LLM 做長鏈推理時,最麻煩的不只是算力,而是策略很容易愈學愈保守,最後卡在少數高機率答案附近。RIPO 屬於一個面向 LLM 強化學習的演算法研究項目,針對的正是 PPO-Clip 在後訓練階段常見的 exploration collapse,想解決罕見但關鍵動作愈來愈難被探索到的問題。

作者沒有沿用「再補幾個 heuristic」的路線,而是直接指出舊範式的核心錯位:PPO-Clip 以 Euclidean metric 量度 policy discrepancy,但 policy 本身更貼近一個 Riemannian manifold。呢個幾何不一致會令低機率區域更新過份保守、高機率區域又過份進取,最後令探索能力收縮;Riemannian Isometric Policy Optimization(RIPO)則改為追求等距的 policy update,嘗試同時守住 exploration 與 exploitation 的平衡。

論文描述中,RIPO 另一個重點是 bias-variance trade-off 較理想,令優化過程更穩定。成效方面,它在七個 competition-level benchmarks 上都優於既有 LLM RL algorithms,當中對 GRPO 在 AIME24 的提升最高可達 60%;這類結果相當吸引,但仍然要留意 benchmark 與訓練設置是否能完整轉移到你手上的模型與資料。

  • 核心批評很明確:PPO-Clip 的幾何假設不適合 policy update
  • 方法重心不是加獎勵技巧,而是重寫策略更新的度量方式
  • 對數學推理、長時序決策這類要靠探索找到解法的訓練場景較有價值
  • 成績亮眼,但更適合有能力重跑 benchmark 與訓練流程的研究團隊驗證

從提供的 GitHub 資訊看,儲存庫描述混入了 verl 這個 RL training library 的內容,因此閱讀與部署前要先分清:RIPO 是演算法與論文方向,verl 則較像承載 LLM RL 訓練流程的開源基建。較合理的理解方式,是把 RIPO 視為可整合進現有 LLM RL framework 的新策略更新方法;真正落地通常要配合既有訓練庫、GPU 叢集配置,以及像 GRPO、PPO 一類後訓練 dataflow 一起測試。

GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 模型訓練, OpenAI, 框架, , Anthropic, Dataset 數據集

Page 4 of 15
1 2 3 4 5 6 15