TeleAntiFraud 開放反詐數據與模型,建立可重現研究基礎

TeleAntiFraud 將數據集、模型、評測和程式碼集中開放,讓電信反詐研究更容易驗證與延伸。

Hero image preview

面對電信詐騙檢測需要數據、模型和一致評測標準的問題,TeleAntiFraud 以開源研究社區形式,集中提供相關資源,涵蓋數據集、模型、論文及可重現的研究基礎設施。項目由中國人民公安大學聯合發起,適合研究人員、反詐技術團隊及需要測試檢測方法的開發者使用。

社區目前公開 TeleAntiFraud 數據集、AntiFraud-SFT 模型,以及論文與程式碼倉庫,並提供 Hugging Face 模型與數據入口。相比只發布單一模型或個別研究結果,這種整合方式讓使用者可以由數據、訓練資源一路追到論文和程式碼,較方便重現實驗及比較不同方法。

可直接關注的資源包括:
– TeleAntiFraud 數據集及相關論文入口
– AntiFraud-SFT 模型發布與研究資料
– 已錄用論文及對應的公開程式碼、模型和數據
– 面向音頻文本反詐檢測的 SAFE-QAQ 研究

社區列出的最新進展包括 TeleAntiFraud-28k 獲 ACM MM 2025 接收,以及 SAFE-QAQ 獲 ACL 2026 主會接收;後者聚焦慢思考強化學習框架。網站目前未提供統一的性能數字或詳細測試結果,讀者仍需按各論文及資源頁面的評測設定理解模型能力和限制。
項目主頁

Categories: 開源, 模型, 模型訓練, 框架, , 中國, Dataset 數據集

小米公開 CodeMidas 強化學習訓練進度

小米以即時指標公開 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練狀態,並連結至程式編碼代理研究。

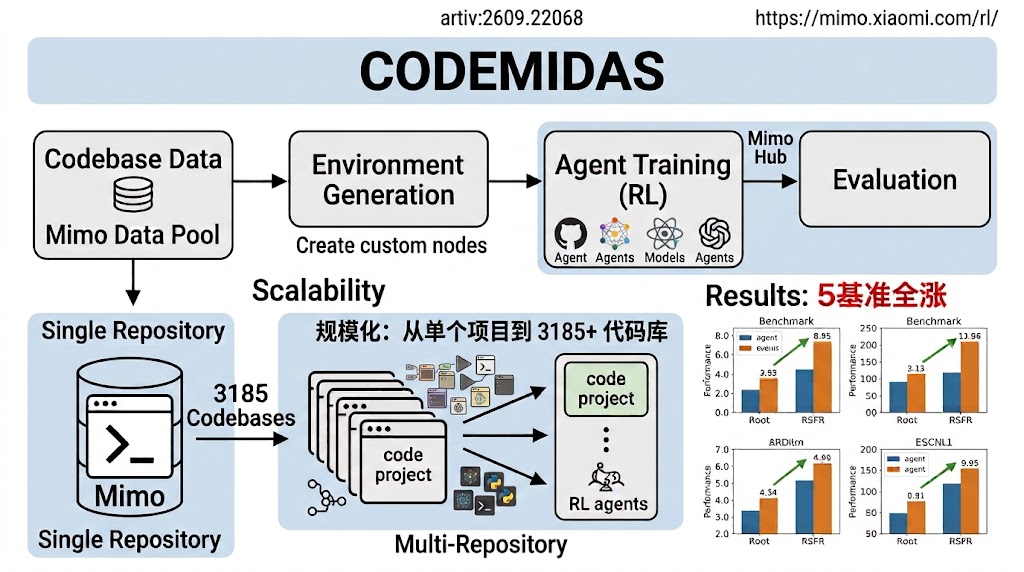
CodeMidas 把模型訓練過程帶到公開視野,展示 mimo-v2.6-pro 與 mimo-v2.6-flash 兩組 reinforcement-learning runs 的即時指標。對需要追蹤模型能力如何形成的研究者和開發者而言,這類介面可用來觀察訓練是否持續、何時中斷,以及不同模型版本的進度差異。

小米以 trainer 直接提供的 metrics 為主,未有完整列出指標定義、數值解讀或最終評測結果。因此,讀者可以把它視為訓練監察入口,而不是已完成模型的性能報告;畫面亦提示可能出現重新連線狀態,資料連續性仍需留意。

根據 CodeMidas 研究,mimo 從程式碼本身擴展 agentic coding reinforcement learning environments。這個方向處理的問題,是如何建立足夠多、又能反映真實編程任務的訓練環境,讓 coding agents 在程式修改、執行與驗證等流程中學習,而不只依賴靜態範例。

資訊:
– 同時追蹤 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練
– 指標由 trainer 即時更新,適合觀察訓練進程
– CodeMidas 聚焦由程式碼擴展 agentic coding RL environments

對模型研究、AI agent 和編程工具開發者來說,頁面提供了一個觀察訓練公開化的窗口;一般使用者則應等待正式模型說明和獨立評測,才適合判斷其編碼能力及穩定性。

項目主頁 · 模型

Categories: 開源, 香港大學, 北京大學, Agentic, 模型訓練, 工具, Discord, 編程, 小米-Xiaomi

HarnessVLN:不訓練也能走的統一導航框架

HarnessVLN 把視覺、語言、空間證據交給一套 Agent Harness 統籌,用零訓練方式處理多任務導航,並以層化記憶與時空圖解決長程失敗。

Repository image for AgibotGeneral/harnessvln

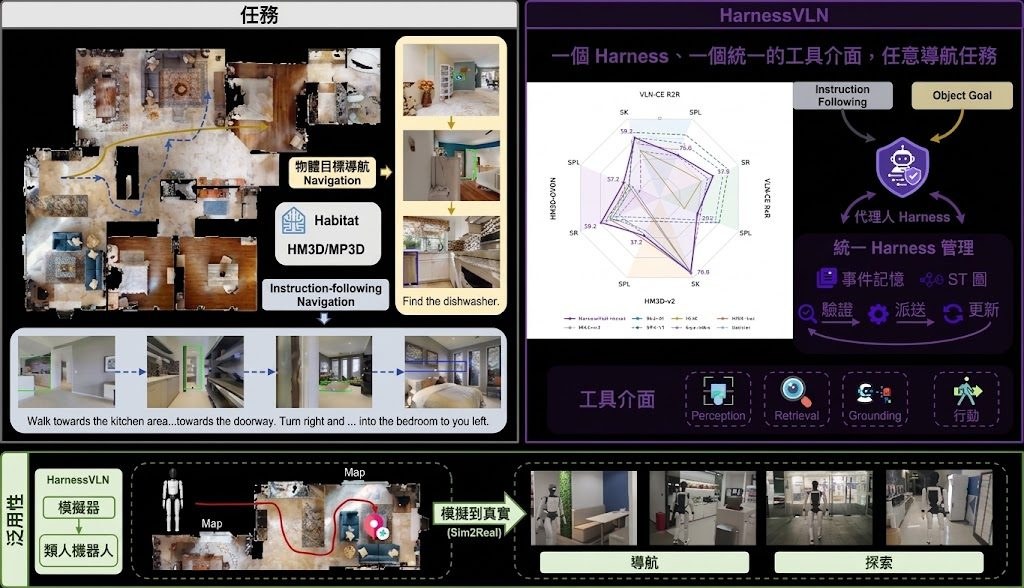
Embodied Navigation 過去依賴大規模訓練與任務專用流程,但不同場景的 pipeline 各自為政,難以共享空間證據與錯誤紀錄。HarnessVLN 把這個痛點攤開:現有 training-free 方法雖然借助多模態大語言模型,卻缺乏把「提案」與「空間證據、任務進度、執行失敗」對齊的機制,於是同一個 agent 在長時序任務中容易重複犯錯、難以回收。

作為一個訓練無需更新的 agent harness,HarnessVLN 用統一工具介面串接感知、檢索、定位、導航、恢復與終止,並透過層化事件記憶與持久化時空圖(Spatiotemporal Graph)保留可重用的空間證據與失敗標註,讓跨子目標的經驗真正沉澱。提案不再直接落地,而是先被 Agent Harness 結合幾何可行性與過往失敗做驗證,再分派給工具執行。

在 R2R、RxR、HM3D-v2、HM3D-OVON 等基準上,HarnessVLN 報出 60.8、53.9、76.0、59.3 的 SR%,覆蓋 instruction navigation 與 online exploration 兩種形態,並提供真機 demo 與模擬環境。對機器人團隊、具身 AI 研究者與需要快速驗證導航策略的工程師來說,它提供一個不必從零訓練就能橫向比較的底層框架。

重點摘要

  • 訓練無需更新:以 Agent Harness 統一感知、檢索、定位、導航、恢復與終止工具
  • 層化事件記憶 + 時空圖:把子目標進度與空間證據沉澱為可重用資產
  • 提案先驗證再執行:用幾何可行性與失敗紀錄把 LLM 操作提案過濾一次
  • 覆蓋 R2R、RxR、HM3D-v2、HM3D-OVON 等多項導航基準
  • 同時提供模擬與真機 demo,適合做跨任務導航策略的快速評測

對在意長時序導航穩定性、想避開昂貴 fine-tuning 的團隊,這套來自南京大學、清華大學與 AGIBOT 合作的方案,給出一條「不訓練也能走得更穩」的工程化路線。

項目主頁 · GitHub · Paper

Categories: 開源, 南京大學, 清華大學, Agentic, 多模態模型, 模型訓練, Robotic, 框架, 工具, Dataset 數據集

RoboSPA 用 280 個難度變體幫你壓力測試

RoboSPA 是浙江大學團隊針對 Vision-Language-Action 模型推出的診斷式基準,透過逐步拉高空間歧義與程序步數,揭開現有機器人策略在精準定位與長程規劃上的短板。

Repository image for fanzhenxuan/RoboSPA

當 VLA(Vision-Language-Action)模型在乾淨、短任務的環境中跑出不錯的成功率,要怎樣才知道它是真正「理解」指令,還是只是剛好蒙對?RoboSPA 給出的答案是:把場景弄得更亂、把步驟拉得更長,然後看模型從第幾關開始崩潰。這是一個基準與數據集項目,建基於 RoboTwin 2.0 模擬框架(SAPIEN + CuRobo),由浙江大學主導,已獲 EMNLP 2026 收錄。

它把 56 個基礎任務各衍生出五個難度級別(L1–L5),共 280 個變體,覆蓋五種機械臂實體(Franka、Piper、UR5、Aloha-AgileX、ARX-X5),總計 527K 條軌跡、約 108M 步數、997 小時互動影片。Spatial 維度持續加入外觀相近的候選物,Procedural 維度則逐步疊加子目標、執行順序、重複次數與記憶需求。

與只看最終二元成敗的傳統做法相比,RoboSPA 額外提供兩個診斷指標:空間任務用 ONTA(Object-Normalized Target Accuracy) 衡量模型能否在「看起來都像」的物件中選對目標,並以 chance-corrected 方式扣掉隨機命中;程序任務則用 Progress Score(PS) 計算實際完成的子目標比例,反映模型在中途卡住或跳步的真實狀況。

適合機器人實驗室、VLA 模型開發者,以及需要評估策略可擴展性的團隊。支援自帶策略接入,數據與代碼均已公開。研究端在多個代表性 VLA 模型上的結果顯示,空間關係、低階精細動作與長程記憶仍然是明顯瓶頸。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, Video, VLA, 框架, 中國, Dataset 數據集

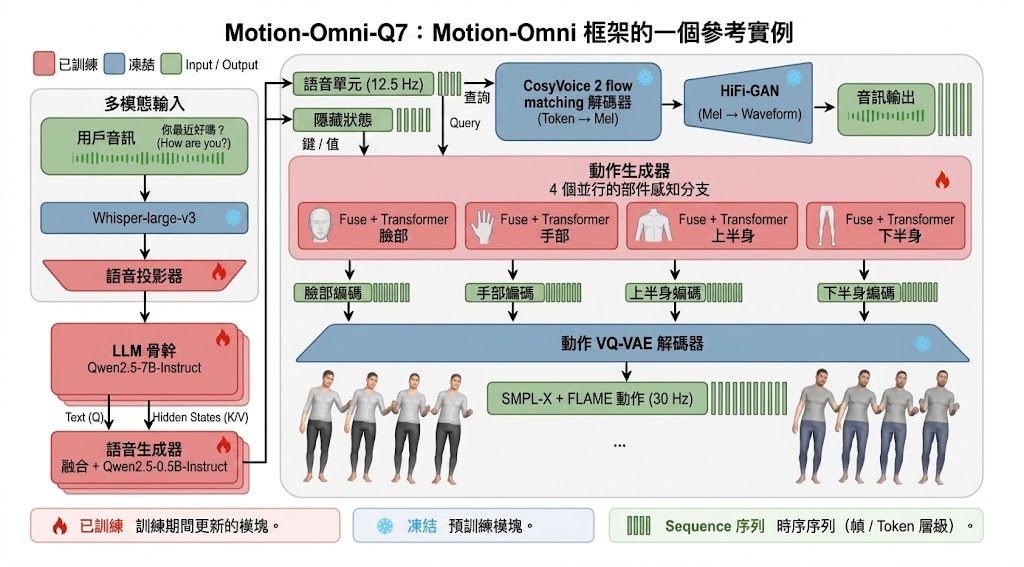
Motion-Omni:「講嘢」同「做嘢」視為同一件事,直接生成全身動作

Motion-Omni 把語音和全身動作綁在同一個模型,講一句話就能即時生成對應嘅身體動作、表情同手势,適合需要邊講邊做嘅虛擬角色。

Motion-Omni framework

試過睇虛擬角色傾偈,個口形郁但身體硬晒,或者要逐段人手配動作?Motion-Omni 想解決嘅就係呢種「聲有、體無」嘅唔自然感。佢係一個端到端嘅多模態模型,輸入一段語音,輸出唔只有語音本身,仲有頭部、表情、手势以至全身姿態,全部喺同一個框架一齊生成,避免傳統做法分開處理再硬砌嘅斷裂感。

Motion-Omni 用咗一個統一嘅 tokenizer 把語音、文本同動作 token 化,配合 LoRA(Low-Rank Adaptation)adapter 等輕量微調技術,令模型可以同時學語音同肢體表達。生成嘅動作涵蓋手部、軀幹、面部表情,適合需要即時互動嘅場景,例如 AI 助手、虛擬客服、遊戲 NPC、語音驅動嘅動畫原型。

傳統動畫要先錄關鍵動作、再做 lip-sync 後製,而坊間部分開源方案往往只能控制頭部或者手部其中一樣。Motion-Omni 嘅做法係將「講嘢」同「做嘢」視為同一件事,所以動作會跟語氣、節奏同步變化,唔使額外人手調整。佢同時支援文字輸入,等開發者可以更直接控制角色行為。

對做 AI 角色、互動內容、語音動畫嘅團隊嚟講,呢種端到端做法可以慳唔少配動作同後製嘅工序,尤其適合需要快速原型嘅項目。讀者可以透過官方頁面睇影片 demo,評估生成動作嘅自然度同延遲表現,再判斷適唔適合自己嘅工作流。

重點摘要

  • Motion-Omni 係一個端到端多模態模型,同時輸出語音、表情同全身動作
  • 用統一 tokenizer 加 LoRA adapter 處理語音、文本同動作 token
  • 覆蓋頭部、手部、軀幹同面部表情,適合即時互動角色
  • 傳統做法分開配音同配動作,呢個模型將兩者合併生成
  • 適用於 AI 助手、虛擬客服、遊戲 NPC、語音動畫原型等場景

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 北京大學, AI productions, 模型, 多模態模型, Video, 框架, 語音, 動畫

Qwen-Audio Realtime API 上線:以 WebSocket 即時串接語音對話

阿里巴巴雲 Model Studio 推出 Qwen-Audio Realtime API,用 WebSocket 串流處理語音輸入與輸出,支援 VAD 偵測與雙向文字回傳,適合即時語音助理開發。

Og image

想在應用程式裡加入即時語音對話,但又不想自己串接一堆音訊前處理、ASR、TTS 的流程?阿里巴巴雲 Model Studio 這次直接把 Qwen-Audio 做成可即時呼叫的 Realtime API,開發者只要透過 WebSocket 連線,就能處理語音輸入、文字輸入,並即時收到串流音訊與文字回應。

這個 API 的設計重點在於「一條連線做完整件事」。客戶端與伺服器以 JSON 事件雙向溝通,支援語音活動偵測(VAD),讓系統知道用戶何時開始與結束說話,省去自行判斷靜音的麻煩。對話中的每一則訊息會以 conversation item 形式保存,整個 session(即一條 WebSocket 連線)則負責維護設定與上下文狀態。

服務端點分為中國(北京)與新加坡兩個區域,皆已改用 workspace-specific 專屬網域,官方表示穩定度與推論表現都比原本的共用網域更好。連線時需使用 wss:// 協定,並在 request header 帶上 Authorization: Bearer <your_api_key>,API key 會在 WebSocket 握手階段驗證,若無效會直接回 HTTP 401/403。

若你的項目是語音助理、即時翻譯、客服 robot 或電話自動化,會感受到整合成本明顯降低——不用分別串 ASR、LLM、TTS,只要管理好 WebSocket 的事件流即可。舊網域雖然仍可用,但官方強烈建議遷移至新網域以取得更佳體驗。

重點摘要

  • 即時雙向串流:WebSocket 連線同時處理音訊輸入與串流輸出,搭配 VAD 自動偵測語音起止。
  • JSON 事件溝通:所有互動以結構化事件傳遞,方便除錯與日誌記錄。
  • 雙區域專屬網域:中國(北京)與新加坡皆提供 workspace-specific 端點,穩定度與推論表現提升。
  • 簡化整合流程:免去自行串接 ASR、LLM、TTS 的負擔,適合快速建構語音應用。
  • 原有網域仍可用:但官方建議盡快遷移以享受新網域的效能改善。

項目主頁

Categories: 阿里巴巴, 文字轉語音, Qwen, API, Audio, Robotic, 語音, 中國

Lucida:用「解析、生成、放置」三步把實景變成可編輯的模擬場景

字節跳動 Seed 團隊把真實室內環境拆解成獨立物件資產,透過閉環姿態修正讓重建結果能直接用於模擬。

Og image

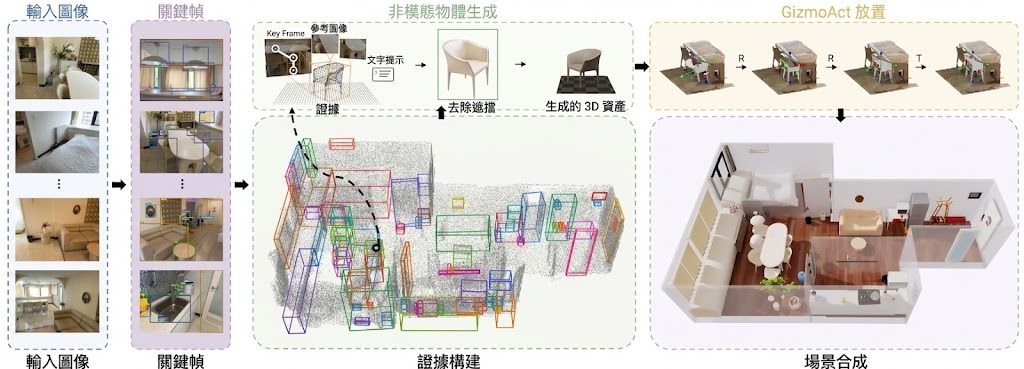
從一段真實拍攝的室內影片,要還原成可以模擬、可逐個編輯嘅場景,一直都係 3D 重建嘅痛點:擺位、遮擋同殘缺幾何往往令資產難以重用。Lucida 就係針對呢個矛盾提出嘅方案,屬於實景到模擬(real-to-sim)類嘅場景建模系統。

整個流程分成三步。第一步 Parse 揀選有用嘅關鍵幀,跨視角對應實例並建立場景圖,輸出遮擋、局部點雲同參考視圖等證據。第二步 Generate 利用每組證據合成無遮擋嘅物件影像,再提升成完整、可編輯嘅 3D 資產。第三步 Place 先粗略初始化,再用 GizmoAct 喺閉環中反覆執行姿態編輯,直到渲染結果同觀察對齊。

GizmoAct 係呢套系統嘅核心控制器,由視覺語言模型(VLM)操作 3D 編輯器,每一步根據渲染觀察、點雲疊加同正交視圖等線索,落一個可執行嘅姿態修正。同一條策略可應付由 Boxer、Any6D* 到 SAM 3D 等不同初始化,並以最多 4 個視圖同 12 步修正完成對齊。

Lucida 喺 R2S、CA-1M 同 Aria Digital Twin 數據集上都提升咗場景級 3D 物件檢測、姿態估計同完整場景重建指標。重建出嚟嘅場景以一組獨立、可編輯嘅 mesh 呈現,每件物件都準備好進入模擬階段。

對從事機器人模擬、室內數據合成或場景理解嘅團隊,呢套閉環做法比起傳統單次擬合更能容忍幾何誤差同遮擋問題,令實景資產更易直接落落去模擬器使用。

重點摘要

  • 三步流程:Parse、Generate、Place 把實景拆解成可重用物件資產
  • GizmoAct 閉環修正:VLM 操作 3D 編輯器,反覆落姿態編輯直到對齊
  • 初始化容忍度高:同一策略兼容 Boxer、Any6D*、SAM 3D 等不同起點
  • 輸出可直接模擬:每件物件係獨立、可編輯 mesh
  • 多數據集提升:喺 R2S、CA-1M、Aria Digital Twin 都有指標改進

項目主頁

Categories: 北京大學, 字節跳動, 視覺模型, Video, Image, 3D

GLM-5.3 開放權重,卻為大型雲端供應商設門檻

GLM-5.3 (753B 參數),已在 Hugging Face 發佈權重,但新授權條款不再採用 MIT,並要求大型提供商接受安全審查。

Og image

想自行下載模型權重、在本地或私有環境運行 GLM-5.3 753B 參數的團隊,現在多了一項不能忽略的授權考量。Z.ai 已把 GLM-5.3 上載到 Hugging Face,讓研究者和開發者取得模型權重,但同時撤下過往的 MIT license。

這個安排令「開放權重」與「完全不設限制的開源授權」出現清楚分別。模型檔案可以取得,不代表所有公司都能按照相同條件提供服務;收入超過 100 億美元的提供商,需要先接受安全審查,條款明顯針對大型雲端及 AI 服務供應商。

對小型團隊、研究人員和需要控制資料流向的企業,GLM-5.3 的權重仍可能方便本地推理、模型整合及內部測試。不過,將模型包裝成公開 API、雲端推理服務或大規模商業產品前,必須先核對新 license 的適用範圍和審查要求。

  • 權重已放上 Hugging Face,降低取得模型的門檻
  • GLM-5.3 不再使用 MIT license
  • 開放權重不等於不受授權條款限制
  • 收入超過 100 億美元的提供商須接受安全審查
  • 商業服務和大規模分發需要額外檢查合規要求

模型

Categories: 開源, 模型, 中國

VoiceMem 讓語音 AI 記住你的情緒與偏好

VoiceMem 以流式雙腦架構處理事實記憶、情緒與人格,讓語音智能體在對話中更懂使用者,同時控制延遲與成本。

VoiceMem Logo

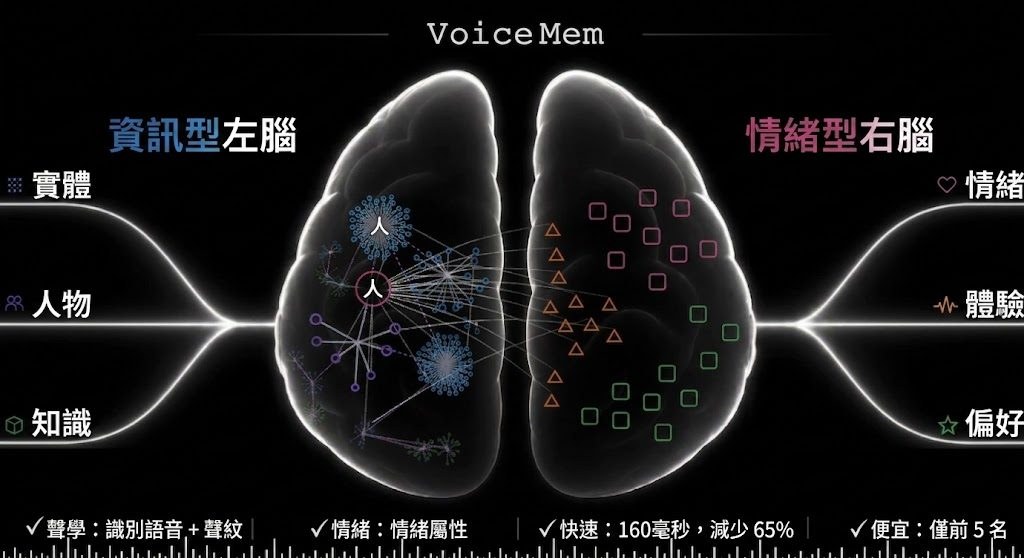
語音智能體要記住「我是素食者、對堅果過敏」,並不只是保存轉錄文字,還要分辨人物、情緒、偏好與性格。VoiceMem 屬於語音 AI 記憶引擎及可整合的庫,處理音訊輸入、記憶抽取、檢索和回應前的上下文注入,讓長期個人化對話不必每次重新建立背景。

它採用 VoiceMem Dual-Brain Streaming Architecture(流式雙腦架構):左腦以 schema 與 entity 組織事實記憶,右腦獨立管理情緒、偏好和人格,亦維護跨 entity 的關聯。音訊仍在輸入期間,系統已經分段、轉錄、抽取資料並寫入記憶圖;查詢時先路由及排序,只把 Top-K 記憶放入上下文,減少語音回應需要處理的內容。

  • 左腦在 Top-3 限制下維持 Mem0 的滿載性能
  • 右腦加入長短期情緒歸因及交叉節點
  • 透過壓縮資訊、分層儲存和流式查詢降低等待時間
  • 單輪查詢約需 300 token,架構及底層記憶引擎可替換

VoiceMem 內置 ASR(Automatic Speech Recognition)、聲紋、場景、情緒感知及本地 embedding 元件,亦提供離線記憶引擎和 streaming interface。倉庫資訊包含 Python 庫、互動式網頁 demo、VoiceMem_Default_Models_Env 模型環境,以及可選的 Qwen 回應模型;但完整硬件要求、服務依賴和模型授權仍需按連結內容逐項確認,不能單靠 README 推斷。

ChatMem-400K 以記憶世界構建、SLM 驗證的 online on-policy distillation 和人工修訂三階段製作,配合 VoiceMem Model Families 的 Qwen3 6 35B A3B Qlora 模型系列。這令項目較適合需要長期語音陪伴、個人助理、客服或具情緒連續性的 voice agent 團隊;對只需短對話轉錄的工作流,雙腦記憶層會增加整合和維護成本。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 清華大學, Agentic, Embedding, 多模態模型, Qwen, Python, , 語音

GameXpert-Bench | Coding Agents for Game Development

騰訊團隊聯同多間院校提出 GameXpert-Bench,專門看 Coding Agents 能否做出、修好再優化可玩遊戲。它把生成、修復同多輪改進放入同一條流程去評估。

Og image

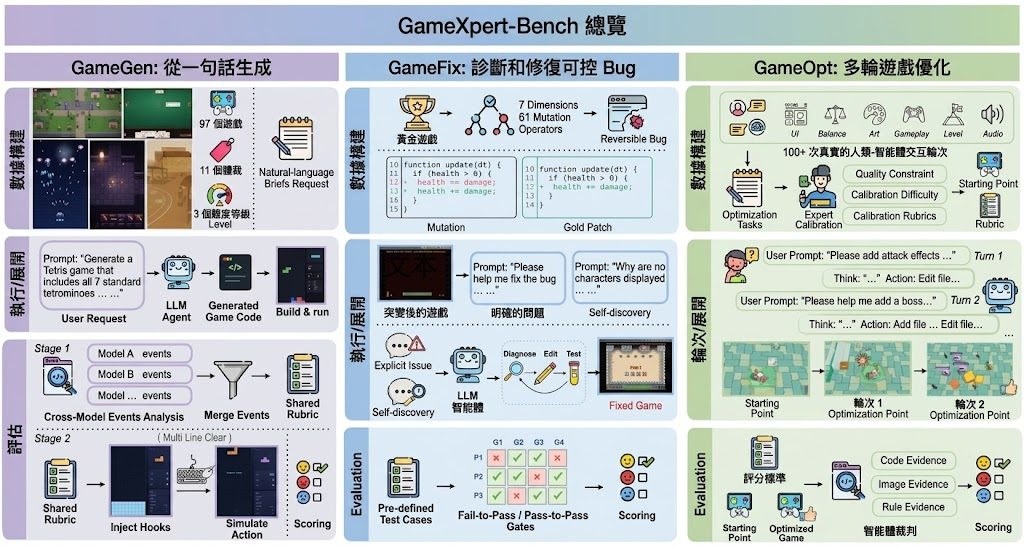
騰訊 Hunyuan Team、Lightspeed Studios,聯同 CASIA、清華大學、香港科技大學、香港中文大學深圳等團隊,提出 GameXpert-Bench,用來檢驗 Coding Agents 在遊戲開發上的真實能力。它不只看程式碼寫得像不像,還看能否真的做出可玩遊戲、找出錯誤,並在多輪修改後保持功能完整。

這個項目處理的是一個很實際的落差:很多代理可以生成看似合理的程式,但一到互動、畫面、音效、介面同可玩性要同時成立,就容易出問題。GameXpert-Bench 把整個生命週期拆成三條軌道,分別測首次生成、修復缺陷,以及連續優化,逼近真實開發流程。

  • GameGen 測試從零開始生成可玩遊戲,沒有預設引擎或素材
  • GameFix 測試對已知缺陷的診斷與修復,亦包括自行發現問題的情況
  • GameOpt 測試多輪改進時能否保住核心玩法與既有功能
  • 評估不只看程式,還結合互動行為、代碼檢查同人工判斷

目前公開資料提到共有 97 個生成任務、100 個修復任務,以及 17 條多輪優化鏈,涵蓋 2D 和 3D 遊戲。整體結果指向一個清楚結論:寫出看似合理的實作,比起交出經過驗證、又唔會在後續修改中壞掉的遊戲容易得多。

對做 Coding Agents、遊戲工具鏈、或研究 agentic software engineering 的讀者,這個基準特別有參考價值。它把「能寫」和「能交付」分開,令模型在真實工作流中的短板更容易被量度出來。

項目主頁

Categories: 香港中文大學, 香港科技大學, 清華大學, 騰訊, Agentic, Audio, 軟件, 3D, 編程, Dataset 數據集

Page 1 of 15
1 2 3 15