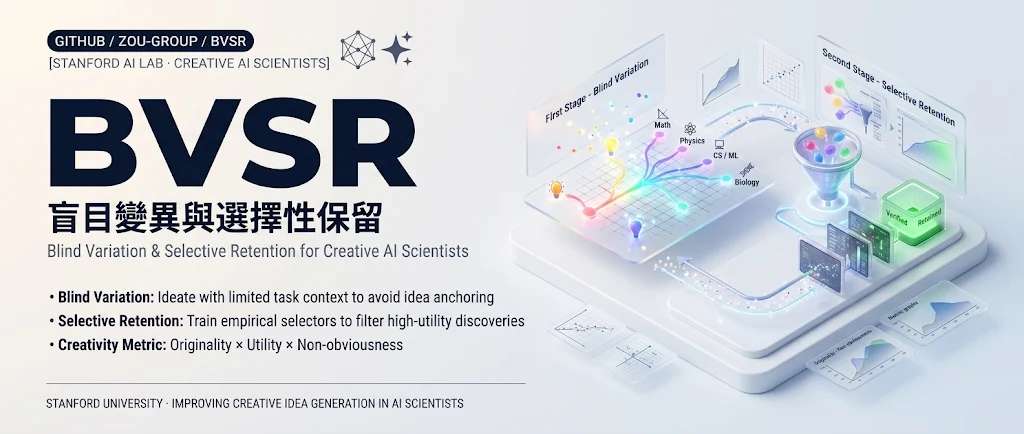
刻意少給任務資料,再挑選值得測試的構思,是 Blind Variation, Selective Retention(BVSR)這套研究框架的做法。它協助 Artificial Intelligence(AI)科學家探索新方向,把資訊留給後續篩選,減少構思被熟悉方法牽引。
篩選器從同一任務已驗證的提案學習,因此仍需先累積實驗結果。項目文件報告,淘汰一半候選後,仍保留創意排名前 5% 提案的 79%,以及實用性排名前 5% 提案的 82%;節省驗證資源的代價,是漏掉部分好構思。
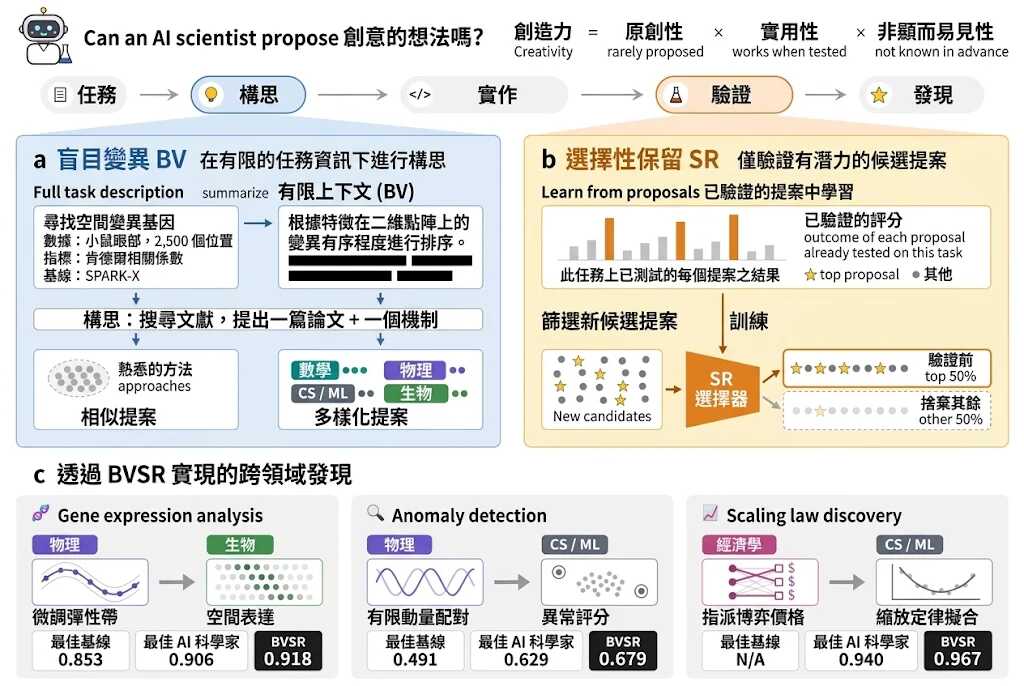
- 構思階段限制任務資訊,擴闊探索方向。
- 篩選階段比較已驗證提案,學習優先次序。
- 接入 SimpleTES 後,五項任務最終得分均提高。
重現實驗需取得 Llama-3.1-8B-Instruct 與 gemma-3-4b-it 的存取權,並準備資料下載及 bubblewrap 隔離執行環境;提供的資料未交代兩個模型各自分工。已有自動實驗流程及驗證紀錄的研究團隊,較容易測試這套方法能否減少自身任務的驗證次數。