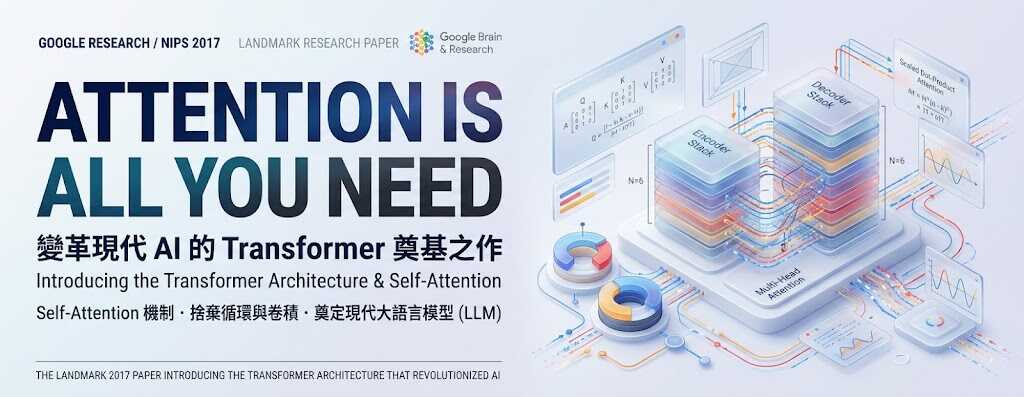
Transformer 架構核心概念與數學深度解析
經典論文精讀 · Vaswani et al. (NeurIPS 2017) · 繁體中文深度精校 · 閱讀時間約 18 分鐘
01. 循環神經網絡的瓶頸與注意力的誕生
在 2017 年之前,幾乎所有頂尖的自然語言處理(NLP)模型都是圍繞著循環神經網絡(RNN)構建。RNN 的核心設計是「按時間步長循序遞歸」:處理當前第 t 個詞時,必須仰賴前一個時間步的隱藏狀態 h_{t-1}。這種遞迴結構存在三大致命缺陷:
- 無法高度並行運算:計算必須依序等待,序列長度時間複雜度強制為
O(n),無法發揮現代 GPU 矩陣算力。 - 長距離依賴資訊遺忘:數十步之後容易發生梯度消失或爆炸,難以捕捉跨段落語意。
- 固定向量資訊瓶頸:強行將整句話壓縮至單一固定維度向量中。
正如論文標題所宣示的:「Attention Is All You Need」——捨棄循環與卷積,僅靠注意力機制實現一步到位全局直連!
02. 宏觀架構全貌:Encoder-Decoder 的堆疊智慧
原始 Transformer 由左側 6 層編碼器(Encoder Stack)與右側 6 層解碼器(Decoder Stack)協同組成。點擊下方互動方塊,即時查看各層張量形狀與數學運算:
03. 核心引擎:自注意力 (Self-Attention) 與除以 √d_k 的數學必然
自注意力機制公式:Attention(Q, K, V) = softmax( (Q · K^T) / √d_k ) · V
- Query (Q):「我正在尋找什麼?」代表當前位置詞彙的檢索訊號。
- Key (K):「我是什麼特徵標籤?」代表所有詞彙的索引標籤。
- Value (V):「我包含的真實內容」代表加權平均後聚合的詞彙語意。
04. 多頭機制:多維語意子空間的聯合投影
公式:MultiHead(Q, K, V) = Concat(head_1, ..., head_h) · W^O
在標準 Transformer 中,將總維度 d_model = 512 均分給 h = 8 個注意力頭,每個頭的維度為 d_k = 64。8 個頭各自在 64 維子空間獨立運算,計算量與單頭完全一致,卻獲得了 8 倍的特徵表徵多樣性!
05. 空間感知:正弦與餘弦位置編碼
公式:PE(pos, 2i) = sin(pos / 10000^{2i/d}),PE(pos, 2i+1) = cos(pos / 10000^{2i/d})
根據三角和角公式 sin(ω(pos+k)) = sin(ω·pos)cos(ω·k) + cos(ω·pos)sin(ω·k),相對位移 k 可由 2×2 線性旋轉矩陣推導,使網絡輕鬆掌握詞語相對距離!
06. 逐位置前饋神經網絡 (FFN)
公式:FFN(x) = max(0, xW_1 + b_1)W_2 + b_2。隱藏層先將維度放大 4 倍至 2048,經激活函數後降回 512。FFN 扮演大模型的事實記憶庫,第一層激發概念模式,第二層調用相關事實知識。
07. 解碼奧秘:因果遮罩與 Cross-Attention
- 因果遮罩 (Causal Mask):在未來時間步填入
-1e9,強制未來權重為 0,防止自回歸生成時偷看答案。 - 交叉注意力 (Cross-Attention):Query 來自解碼器,Key 與 Value 來自編碼器頂層,建立跨語言/跨模態對齊通道。
08. 現代 PyTorch 核心精簡實作
import math
import torch
import torch.nn as nn

class ScaledDotProductAttention(nn.Module):
    def __init__(self, temperature: float = 1.0):
        super().__init__()
        self.temperature = temperature
        self.softmax = nn.Softmax(dim=-1)

    def forward(self, q, k, v, mask=None):
        d_k = q.size(-1)
        scores = torch.matmul(q, k.transpose(-2, -1)) / (math.sqrt(d_k) * self.temperature)
        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)
        attn_weights = self.softmax(scores)
        return torch.matmul(attn_weights, v), attn_weights

class MultiHeadAttention(nn.Module):
    def __init__(self, d_model: int = 512, n_heads: int = 8):
        super().__init__()
        self.d_model = d_model
        self.n_heads = n_heads
        self.d_k = d_model // n_heads
        self.w_q = nn.Linear(d_model, d_model, bias=False)
        self.w_k = nn.Linear(d_model, d_model, bias=False)
        self.w_v = nn.Linear(d_model, d_model, bias=False)
        self.attention = ScaledDotProductAttention()
        self.w_out = nn.Linear(d_model, d_model, bias=False)

    def forward(self, q, k, v, mask=None):
        B = q.size(0)
        q_h = self.w_q(q).view(B, -1, self.n_heads, self.d_k).transpose(1, 2)
        k_h = self.w_k(k).view(B, -1, self.n_heads, self.d_k).transpose(1, 2)
        v_h = self.w_v(v).view(B, -1, self.n_heads, self.d_k).transpose(1, 2)
        out, weights = self.attention(q_h, k_h, v_h, mask=mask)
        concat = out.transpose(1, 2).contiguous().view(B, -1, self.d_model)
        return self.w_out(concat), weights
09. 模型演進:BERT、GPT 到現代 LLM
- Encoder-Only (BERT):雙向全注意力,主打語意理解與檢索向量化。
- Decoder-Only (GPT-4, Claude, DeepSeek):因果單向自回歸,統治通用語言生成與推理。
- Encoder-Decoder (T5, Whisper):跨序列對齊,主導機器翻譯與語音轉文字。
10. 深度 FAQ
Q: 為何推論時需要 KV Cache?
避免重複計算歷史 Key/Value,將每步生成複雜度從 O(n^2) 降為 O(n)。
Q: 什麼是 FlashAttention?
利用 GPU SRAM/HBM 分塊 Tiling 計算,不把巨大矩陣寫回顯存,大幅降低長文本記憶體開銷。