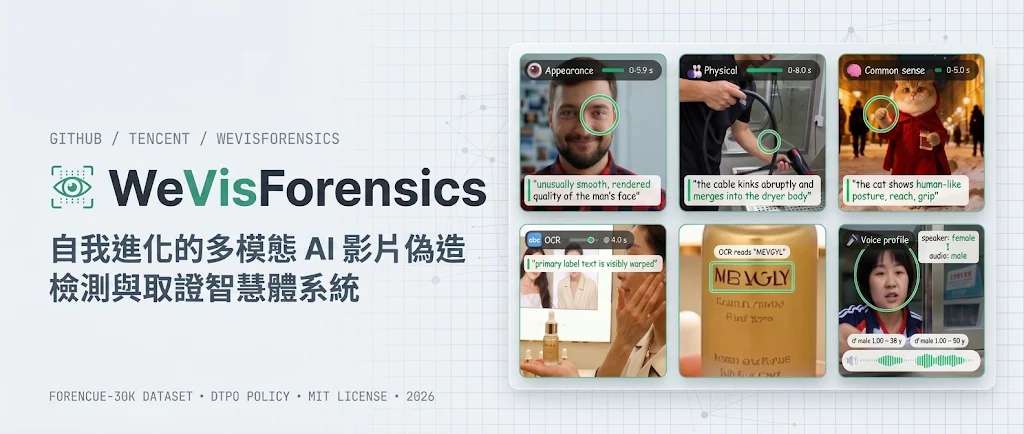
WeVisForensics 是騰訊 WeChat Vision 團隊開發的影片鑑偽 agentic framework,負責判斷 AI 生成影片是真實還是偽造,並交代局部證據。它的 WeVisForensics-DTPO 在四組基準的平均準確率為 95.2%,高於既有方法中平均最高的 VideoVeritas(86.2%);兩者的比較條件是 GenBuster-Bench、GenBuster-Bench++、MintVid General 及 AgenticCue。
這種結果不只是單一模型看完整段影片後給答案。WeVisForensics-4B 在 GenBuster-Bench++ 的準確率為 97.5%,該項最佳既有方法為 91.4%;但在 MintVid General 的 Wan2.5 測試中,BusterX++ 為 87.3%,WeVisForensics-DTPO 為 85.6%。這個落差提醒使用者,整體平均領先不代表每種生成器或測試條件都佔優。
調查由 investigator 負責:它先以每秒一格讀取最多 16 格畫面,每一步輸出一個 JSON action,選擇呼叫檢查員,或直接回答 real/fake。它會先讀取檢查結果,再安排下一步,並在五步內作結。相較一次 chain-of-thought 推理,逐次選擇檢查項目和時間窗,較能追查只出現片刻或局部的痕跡;預先固定的多 agent 流程則較難因應不同影片改變檢查方向。
視覺檢查員會以每秒兩格解碼指定時段,回報判斷、信心程度和簡短觀察。visual_appearance 檢查紋理、邊界、閃爍與光照;physical_consistency 查看動作、身體結構、接觸和物料。common_sense 追查事件次序與因果,ocr_consistency 則在指定時間偵測文字,再檢查裁切出的字形。這些分工讓每個檢查員只報告自身能核對的線索,減少把所有判斷混在同一段推理的情況。
影片有人物說話時,voice_profile 會比對聲音與畫面人物的年齡、性別和情緒;asr_analysis 會檢查逐字稿內容及時間。研究設計的出發點是生成痕跡種類不一,而且可能只存在短片段,因此 investigator 要選擇檢查角色、時段與停止時機。若只提升調查策略,固定不變的檢查員仍可能看漏細微痕跡;DTPO 因而讓兩層 agent 共用互動回饋,較快更新 investigator,並以標註過的痕跡時段引導檢查員較慢更新。
訓練資料 ForenCue-30K 結合不同角色的鑑證標註和互動紀錄,分別訓練檢查員執行檢查,以及 investigator 協調檢查。這套資料安排針對的不只是「看過哪些痕跡」,也包括「何時叫哪個檢查員」;不過項目文件沒有提供獨立消融數字,不能據此判定每個訓練環節各自貢獻多少準確率。
使用方式取決於測試規模。單 GPU vLLM 配置以一張 24 GB GPU 共用 Qwen/Qwen3.5-4B,透過 LoRA adapters 切換角色;多 GPU 配置則為各檢查員分配獨立 vLLM server,面向大規模評測。Transformers 配置同樣需要至少 24 GB GPU,OCR 在 CPU 執行,並須使用獨立環境,因為 demo 指定 PyTorch 版本。Gradio demo 可上載影片並選取最長 16 秒的時段;沒有 GPU 時,可重播 demo/examples/ 內十個案例,但這不等同現場推論。
研究結果仍要按測試範圍解讀:GenBuster-Bench 是訓練時同類測試,GenBuster-Bench++ 與 MintVid General 檢查不同基準或生成器,AgenticCue 則測試調查流程。項目文件亦記錄 WeVisForensics-SFT 的平均準確率為 91.3%,低於 WeVisForensics-DTPO 的 95.2%;不同基準的結果並非每項都勝過最佳對手。項目文件的 2026-11 公告稱 4B LoRA weights 已發布,但待辦清單仍把 Hugging Face 權重及 AgenticCue benchmark 列作未完成,下載與重現前宜核對實際檔案狀態。