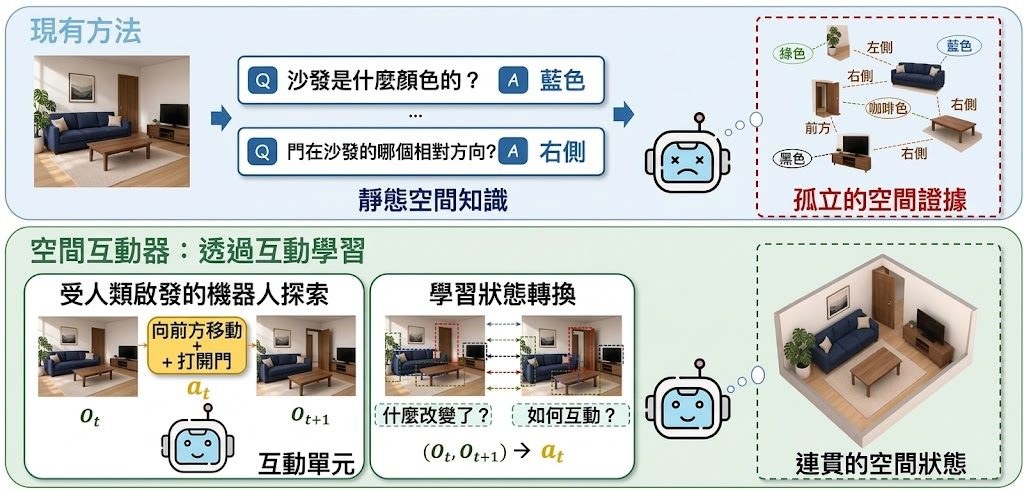
當畫面中的物件被打開、移動,或者代理人在場景中轉身前進,答案不再只是辨認位置,而是要推斷每一步行動帶來的改變。Spatial-Interactor 屬於視覺語言模型的訓練項目,針對模型難以理解狀態轉移及連續空間軌跡的問題,從可觀察的物理互動記錄建立訓練訊號。
項目把能力分成三層:L1 處理視點大致固定時的物件與世界狀態變化;L2 推理代理人移動造成的自身視角變化;L3 將連續的局部轉移整合成完整、長距離的互動軌跡。LSI-108K 以互動記錄、幾何軌跡、狀態及姿態資料產生可驗證的問答目標,令訓練內容不只停留在單張影像的空間關係。
訓練先以 supervised fine-tuning (SFT) 學習 L1 及 L2 的局部轉移,再利用 On-Policy Distillation (OPD) 整合長軌跡中的連續證據。推理時模型只接收原始視覺輸入與問題,毋須依賴額外提供的中間狀態;這有助於測試模型能否自行重建互動過程,但也代表長距離推理仍會受視覺理解及累積誤差影響。
項目涵蓋四個 vision-language models,並以狀態轉移診斷、打亂影格後的時間敏感度,以及局部與長軌跡推理結果作分析。較適合研究視覺代理人、機械人感知、具身 AI 及需要理解動作後果的場景;GitHub 資訊提供程式碼、模型與資料的連結,但未交代完整安裝及測試流程,不能單憑頁面內容判定下載後即可直接運行。
- L1 分析外界物件及場景的狀態轉變
- L2 把 ego-motion 對觀察結果的影響納入推理
- L3 將多個局部轉移串連成完整軌跡
- SFT 負責局部學習,OPD 負責長距離整合
- 模型只需原始視覺輸入與問題作推理