GigaWorld-Policy-0.5 推向機械人即時反應

機械人要邊看邊動,卡位往往不在「會不會做」,而在「能不能夠即時做」。GigaWorld-Policy-0.5嘗試用更輕量的推理路徑,保留世界模型訓練收益,同時壓低本地延遲。

機械人控制最難受的地方,常常不是動作生成本身,而是模型一邊理解畫面、一邊預測未來場景時,推理成本高到難以閉環運作。GigaWorld-Policy-0.5屬於 World Action Model(WAM),重點是保留未來視覺動態對訓練的幫助,但在執行階段只解碼動作,減少為了生成未來影片而付出的額外開銷。

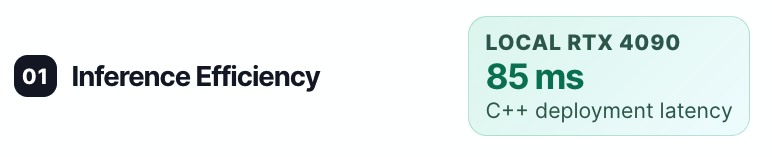
它延續 action-centered 的路線,再加入 Mixture-of-Transformers 架構,將視覺建模與動作生成分成不同 expert。咁樣做的取捨很清楚:訓練期間仍然利用未來場景演化強化動作學習,推理時則走較輕的 action-only pathway,提升即時控制效率。資料提到,它在本地 RTX 4090 上可做到 85ms inference latency,目標就是支援更接近即時的部署。

另一個值得留意的位置,是它不只改模型結構,亦加入 agent-based AutoResearch pipeline 來搜尋訓練配置。這種做法主要是減少手動調 hyperparameter 的時間,讓實驗設定更有系統地被篩選。對做 Robotic、世界模型或策略學習的人來說,這比單純追求更高指標更實用,因為整個訓練流程的效率同樣影響迭代速度。

  • 保留 future visual dynamics 的訓練收益,但推理時只輸出動作
  • 用 Mixture-of-Transformers 分開 visual expert 與 action expert,降低活躍計算量
  • 以 mixed Action-Conditioned World Modeling(AC-WM)和 WAM 訓練,加強視覺與動作的耦合
  • 引入 agent-based AutoResearch pipeline,提升訓練配置搜尋效率
  • 已公開論文、程式碼與模型,方便研究用途跟進

整體來看,GigaWorld-Policy-0.5處理的是世界模型常見的速度與控制落地矛盾:訓練想要看得多、學得深,部署又要夠快。現有資料顯示,它把重心放在更有效率的 action-centered WAM 路線,適合關注即時機械人控制、閉環部署與本地推理表現的人。
項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, 模型, 模型訓練, Video, Robotic, 框架, 編程

用行為地圖看懂 Agent Harness

想查清代理會唔會刪檔前先確認,最難唔係搵唔到碼,而係搵唔齊完整行為鏈。Harness Handbook 把分散實作整理成可追溯的行為地圖。

Hero image preview

想理解 coding agent 點樣真正執行、點樣做安全檢查,或者想改成自己團隊用得上的流程,卡位通常唔在於缺少文件,而在於行為分散喺大量程式碼之中。Harness Handbook 就是針對 agent harness 的整理方法,把「某個行為點樣發生」變成可導航、可核對、可修改的路徑。

它處理的是行為同實作之間斷開的問題。像「刪除檔案前會否先詢問」這類問題,往往涉及多個 implementation sites,不是搜 delete、permission、confirm 就能直接還原全貌。Harness Handbook 以 behavior-level manual 方式重組這些零散位置,讓人可以由問題出發,一步步找到對應的 behavior units、相關程式碼證據,以及可能受影響的修改位置。

  • 把分散程式碼整理成可閱讀的 behavior map
  • 每個行為步驟都連到可驗證的 code evidence
  • 支援理解、審核與修改共用同一套入口
  • 著重 human in the loop,方便持續檢查系統變化

這種做法同一般 code index 或關鍵字搜尋的差異,在於它不是單純列出檔案,而是直接對應「系統會點做」。對開發者、維護大型 agent 項目的人,或者要審視安全邏輯的團隊,都會比較實用;連 coding agents 也可借這份 Handbook 更準確找到相關程式碼。

資料顯示,項目還提供 Handbook Studio,將這套 behavior map 變成可操作的入口。現階段重點不在推出另一個模型,而是為複雜 agent harness 建立一層可解釋、可審核的結構,令系統隨版本演進時,仍然保留清晰的行為脈絡。

項目主頁

Categories: 開源, 騰訊, Agentic, 框架, Vibe Coding, 編程

KnowAct-GUIClaw 跨平台 GUI 代理

想讓代理真正代你點按、輸入同切 App,難處從來不只係識畫面。KnowAct-GUIClaw把記憶、路由同技能接埋,重點放喺長流程任務穩定完成。

GUIClaw

要代理跨桌面、Android、iOS 同 HarmonyOS 幫你做事,最易失手的位通常唔係單一步驟,而係多個 App 之間點樣接續執行。KnowAct-GUIClaw屬於 Agentic 自動化框架/工具,核心處理的是長流程 GUI automation:由理解意圖、揀路徑、執行操作,到把經驗寫回記憶與技能庫,令之後的任務唔使每次由零開始。

同類 GUI agent 常見做法,是把畫面理解同動作決策綁成單次 observe-reason-act 迴圈;作者認為這種固定範式一遇上跨 App、跨系統流程,就容易缺少任務分解、歷史經驗同可重用技能。KnowAct-GUIClaw改用 Know–Route–Act–Reflect,前面先整理證據與路由,後面再把軌跡蒸餾成 memory 同 skills,取向明顯偏向「愈用愈熟手」而唔係單次回答最聰明。

部署上有兩條路:一條是完整 host,配合 nanobot webui、gateway 同 agent 去跑;另一條是獨立 guiclaw 工具,讓其他 host、腳本或終端直接調用。GUI automation 會改變裝置狀態,驗證任務應先用 dry-run,同時用測試裝置或測試帳號,這點對企業內部流程、自動測試、數碼助理場景尤其重要。

  • 支援 desktop、Android、iOS、HarmonyOS,重點係跨平台一致流程
  • 以 memory store 同 skill store 補強長流程任務,而唔只靠即場推理
  • 在 MobileWorld benchmark 取得 64.1%,頁面稱超過多個 open agent frameworks 及部分 closed agents
  • 對不同底模有泛化效果:Kimi-2.6 提升 8.5%,Qwen3.5-35B-A3B 提升 16.2%

受惠最大的,會是要處理重複 GUI 流程的團隊,例如行動裝置測試、跨 App 任務編排、個人助理型代理開發。不過它的價值未必只在榜單,而係把 GUI agent 從「會操作畫面」推向「會累積經驗再操作畫面」。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 工具, Dataset 數據集, Skill 技能

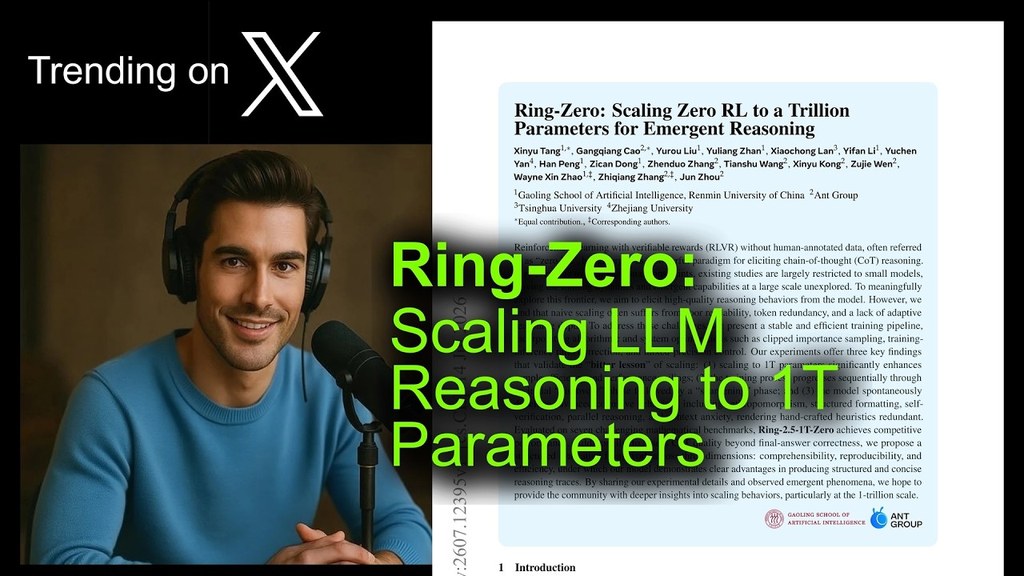
Ring-Zero 1T 參數零樣本強化學習

唔靠人工標註推理步驟,模型一樣可以練出更成熟的思考方式。Ring-Zero 想解的,正是大模型推理愈大愈難教、愈難穩定訓練的問題。

Og image

當模型愈做愈大,真正困難唔只係算力,而係點樣令佢喺冇人工示範推理鏈嘅情況下,仍然學到清晰、有效又可延伸嘅思考方式。Ring-Zero 屬於大型語言模型推理訓練研究,重點放喺將 zero RL 擴展到 1T 參數,觀察推理能力會唔會隨規模自然湧現。

呢個項目要處理嘅問題幾具體:以 Reinforcement Learning with Verifiable Rewards(RLVR)直接訓練 base model,雖然可以避開昂貴嘅人工 chain-of-thought(CoT)資料,但簡單放大規模會帶來可讀性差、token 冗餘,同埋推理深度唔夠靈活。Ring-Zero 針對呢幾個卡位,加入 clipped importance sampling、training-inference ratio correction 同 mixed-precision control,目標係令訓練流程更穩定,輸出亦更精煉。

同常見依賴監督式推理示範或者較細模型做 zero RL 嘅做法相比,Ring-Zero 想證明一件事:規模本身會改變模型學推理嘅方式。研究者觀察到訓練大致會經歷「discovery」再到「sharpening」兩個階段,而且模型會自發出現 anthropomorphism、structured formatting、self-verification、parallel reasoning 同 context anxiety 等行為,顯示部分人手設計技巧未必再係必要。

  • 把 zero RL 擴展到 1T 參數,核心焦點係大規模推理湧現
  • 唔用人工標註 CoT,改用 RLVR 從 trial-and-error 中學習
  • 除咗最終答案,仲額外檢查 comprehensibility、reproducibility、efficiency
  • 在七個數學 benchmark 上,Ring-2.5-1T-Zero 表現具競爭力

對研究 LLM 推理、模型訓練同 scaling law 嘅讀者,呢個項目最有參考價值。佢唔單止關心分數高低,仲嘗試回答大模型點樣學會更短、更有結構、亦更容易重現嘅 CoT;呢一點對之後做 AGI、模型訓練同推理優化都幾關鍵。

Youtube · Paper

Categories: 清華大學, 模型訓練, 安全, AGI, 中國, Dataset 數據集

MonkeyOCRv2 文件通用 OCR 底座

掃描文件、表格、公式到場景文字,往往要分開處理。MonkeyOCRv2想做的是用同一套視覺編碼器,接住多語言文件理解與 OCR 工作流。

overview

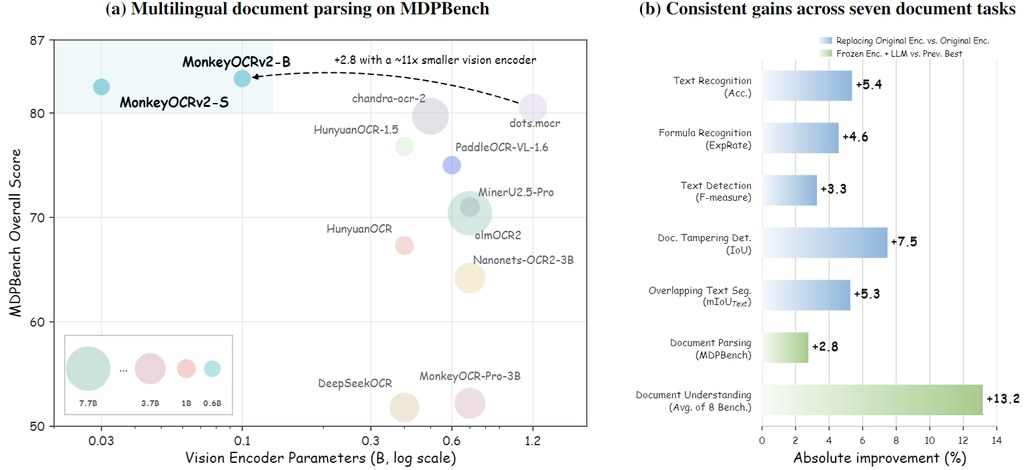
文件 AI 最麻煩的地方,在於文字辨識、版面解析、文件理解、公式辨識,甚至竄改檢測,很多時都要拆成幾個模型串起來。MonkeyOCRv2 把自己放在視覺文字基礎模型的位置,核心不是只追單一 OCR 指標,而是想用同一個 encoder 同時覆蓋多語言文件 parsing、understanding、text recognition、formula recognition 以至 scene text detection。

它採取的路線很明確:不像部分做法會按任務各自訓練小模型,MonkeyOCRv2 強調 fine-grained text modeling、cross-task representation learning 同 cross-lingual generalization,等於先把「文字作為視覺內容」這件事學得更深,再把能力分流到不同文件任務。這種取向的好處,是同一套底座較適合研究團隊或產品團隊整合工作流;代價則是現有資訊仍以模型發布為主,完整效能對比與部署細節還要結合論文與 checkpoint 再判斷。

現階段最值得留意的,是項目已不只放出單一模型名稱,而是分成幾條較清晰的能力線。 MonkeyOCRv2 vision encoder,以及面向 multilingual document parsing 的 MonkeyOCRv2-Parsing、面向 efficient document understanding 的 MonkeyOCRv2-Und,並提供 Hugging Face 與 ModelScope checkpoint,代表測試方式大致會圍繞下載權重後,按任務接入 parsing、recognition 或 understanding 流程,而不是單純打開一個聊天介面就完成。

  • 涵蓋 OCR、文件理解、公式辨識、竄改檢測、重疊文字分割等多類任務
  • 提供 MonkeyOCRv2-S、MonkeyOCRv2-B、MonkeyOCRv2-AS,不同 backbone 對應不同場景
  • S、B 版本偏向 Recognition / Parsing / Understanding,AS 版本偏向 Detection / Segmentation
  • 已公開 Demo、Hugging Face 集合與 MonkeyDocv2 數據集線索,方便交叉驗證

從現有公開資訊看,這個項目較適合做 Document AI、智能審核、票據與表單處理,也適合想比較 dots.mocr、PaddleOCR-VL、Qwen3-VL 這類路線差異的人。它未必是最輕量的選擇,但「一個編碼器橫跨多任務與多語言」這個方向,對需要長期維護文件工作流的項目有相當吸引力。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Qwen, OpenAI, 影像處理, 框架, Medical醫學, Dataset 數據集

RINO 用圖像編輯統一視覺任務

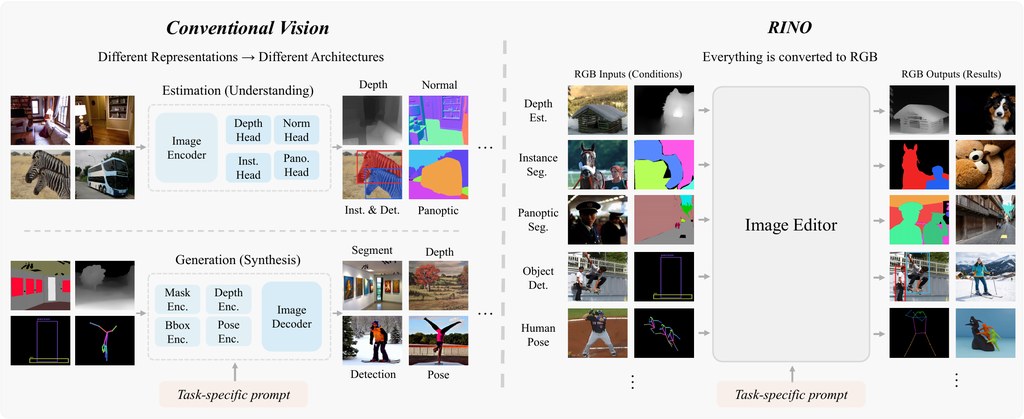
把深度、分割、姿態估計都改寫成 RGB 圖像輸入輸出,RINO 想驗證一個大膽方向:凍結式 image editor 能否直接兼任理解與生成。

RINO unifies vision under a single RGB interface: one frozen image editor, driven by a task-specific prompt, handles est

與其為每個視覺任務各自接駁 head、decoder 或 adapter,RINO 選擇更激進的路線:全部改寫成 RGB In, RGB Out。它屬於一個以 PyTorch 實作的研究型評測與實驗項目,核心問題是檢查單一凍結式 image editor,能否同時處理視覺理解與條件生成,而毋須為深度、segmentation、pose 之類任務另建模組。

這個定位帶來的吸引力很直接:流程統一、介面統一、後端也能互換。項目目前接上三個開源 image-edit 模型作為黑盒後端,包括 Qwen-Image-Edit、FireRed-Image-Edit 與 LongCat-Image-Edit;任務目錄結構一致,每個 task 都有獨立 evaluate 程式與 output 結果,方便逐項跑 benchmark,比起各任務各寫一套推理邏輯,整理與比較都省事得多。

但它的取捨同樣明顯。RINO 並沒有訓練新模型,也不做 fine-tuning,而是堅持用 released weights 直接測 zero-shot 表現;好處是比較乾淨,較能反映 image editor 本身的泛化能力,限制則是上限會被原生編輯模型綁住,對結構化輸出是否穩定、是否容易受 prompt 與渲染方式影響,仍要按任務逐個看。

  • 重點不是追求單一任務最佳成績,而是測試「同一個 RGB 介面」能否橫跨多類視覺工作
  • 三個後端可互換:Qwen-Image-Edit、FireRed-Image-Edit、LongCat-Image-Edit
  • 採用 copied official metric code 評分,數字理論上較容易與既有文獻對齊
  • 部署理解不複雜:安裝依賴後,按 task 準備 dataset,再選 BACKEND 與對應 MODEL 便可執行評測

較適合留意這個項目的,會是想研究 unified vision 介面、比較不同 image editor 泛化力,或者想把多個 benchmark 收攏到同一工作流的團隊。現有資訊未列出完整成績表,但它已清楚交代評測方法、資料夾規格與模型來源;作為研究驗證平台,價值在於提出一套可重覆比較的做法,而不是即刻取代每類任務的專用模型。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, Image, 影像處理, Python, Dataset 數據集

AMID 把醫學影像建模流程交畀代理協作

AMID唔係只幫你諗模型,而係想連驗證、提交物料同審計痕跡一併產出。你可以把它理解成面向醫學影像比賽與研究任務的自動化建模工作流。

AMID logo

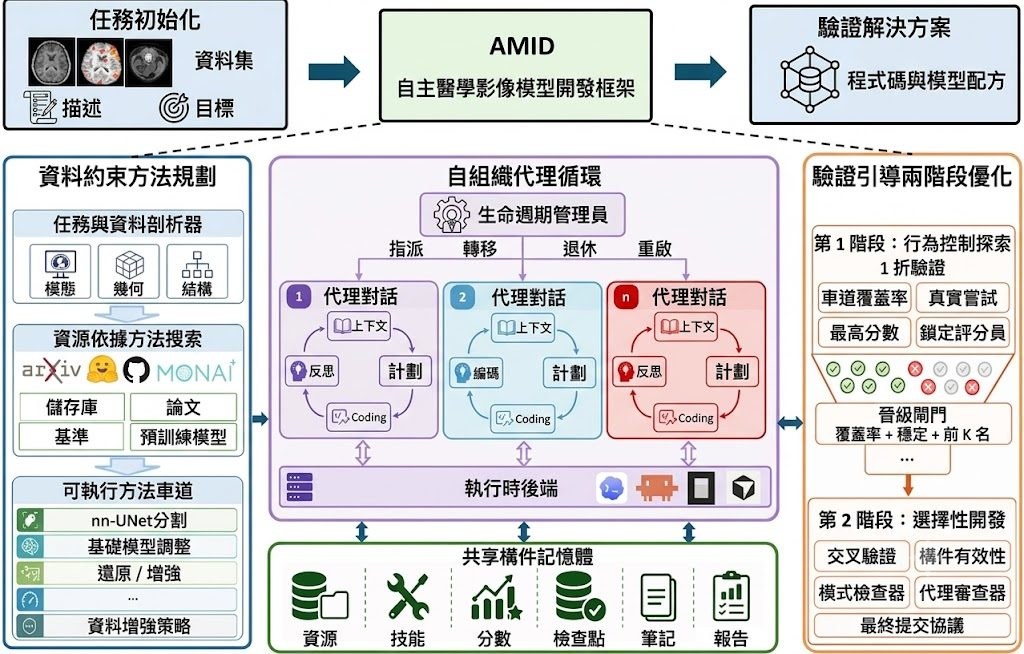
醫學影像建模最麻煩的位,往往唔係只係揀網絡,而係每個任務都有唔同資料形態、指標、切分規則同提交要求。AMID把呢個痛點拉到枱面:它屬於一個 autonomous multi-agent framework,目標唔係產生一段建議文字,而係交出可訓練、可推理、可驗證、可提交的完整模型產物。

現有通用 MLE agent 往往沿用比較粗略的搜尋與試錯範式,先提方案、再寫碼、再靠結果反覆修補;作者認為放到醫學影像場景,呢種做法容易忽略資料條件、驗證協議同提交格式。AMID改用 Data-Conditioned Method Planning,先按任務資料與可運行資源整理出可執行的 method lanes,再用 Verification-Guided Two-Stage Optimization 由早期廣泛探索,轉去後期集中追蹤有潛力路線,同時持續檢查 metric computation、validation protocol 同 prediction artifacts。

呢種取向的差異,在於它把「做得出分數」同「流程可核對」放埋一齊處理。對醫療 AI 團隊、挑戰賽參賽者,或者要同時管理 2D 影像、3D volumes、segmentation masks、class labels 等異質資料的人,AMID的吸引力在於減少人手串接流程的時間;代價是它目前仍以技術報告與任務解法報告為主,README亦寫明 source code 尚未釋出,暫時未到可以直接部署測試的階段。

效能方面,AMID用 ReX-MLE 的 20 個 medical imaging challenge tasks 做基準,比較對象包括一般用途 MLE systems,同時拿 human-designed challenge solutions 作參照。作者指出它整體表現優於被評測的通用系統,部分任務接近或追平人手設計方案;現階段較適合把它理解成一套清晰的方法論與工作流藍圖,而唔係即裝即跑的開源工具。

  • 核心定位係 autonomous multi-agent framework,處理醫學影像模型開發與驗證交付
  • 主要方法包括 Data-Conditioned Method Planning 同 Verification-Guided Two-Stage Optimization
  • 輸出唔止模型建議,仲包括 training code、inference code、weights、prediction files 同 audit trail
  • 基準測試來自 ReX-MLE 的 20 個任務,整體表現優於通用 MLE systems
  • 目前已公開 technical report 同 20 份 solution reports,source code 尚未發布

相關模型與系統脈絡方面,AMID直接對比的是 general-purpose MLE systems,同時以 human-designed challenge solutions 作為高水位參考。它未有把重點放在單一 backbone 或某個固定醫學影像模型,而是把多代理規劃、優化與驗證流程包成可重複的方法,呢點比單次調參工具更值得留意。

GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 多模態模型, 模型訓練, 微軟, Image, 影像處理, 框架, 香港, Medical醫學, 3D, Dataset 數據集

MuScriptor 把多樂器轉譜拉近可用水位

想把整首歌拆成可編輯的 MIDI,MuScriptor 提供一條比舊式轉譜工具更貼近真實錄音的路。它重點唔係只識單一樂器,而係處理混音後仍然保留多聲部。

MuScriptor logo

聽住一段完整歌曲,直接整理出可編輯的 MIDI,本來最易卡住嘅位係多樂器同時出現之後,音色、失真同重疊頻段會令轉譜結果迅速走樣。MuScriptor 針對嘅正正係呢種情況:它屬於開源音樂轉譜模型,目標係將真實世界嘅多樂器錄音轉成符號化樂譜,而唔係只喺單一樂器或合成資料上做得好睇。

舊一代 Automatic Music Transcription 往往依賴大量 synthetic training data,代表性做法如 MT3,喺合成測試集成績可以唔錯,但一落到真實混音音樂就容易失準。MuScriptor 嘗試修正呢個範式,先分析 synthetic data pre-training 嘅作用,再結合真實音訊 fine-tuning,同時加入 reinforcement learning 做 post-training,重點唔係追求實驗室式乾淨訊號,而係提升跨曲風、多樂器錄音嘅泛化能力。

對一般創作者、編曲人、音樂研究者同需要把歌曲快速轉成 MIDI 工作流嘅團隊來講,呢個項目吸引力幾直接。它提供 web UI 同 CLI 兩種方式,本地可先用 uvx muscriptor serve 背後嘅介面理解效果,亦可以用命令列批次處理;首次執行前要有 HuggingFace 帳戶並接受模型授權,權重會下載後快取,本地網頁服務預設只開喺 127.0.0.1,改成 --host 0.0.0.0 就可以喺區域網路存取。

  • 已公開 small、medium、large 三個模型,分別為 103M、307M、1.4B 參數
  • small 較適合 CPU-only 環境,medium 係預設速度與準確度平衡,large 追求更高準確率但更重
  • 模型架構採用 transformer decoder only
  • 支援 instrument presence conditioning,用來控制轉譜時聚焦邊類樂器
  • 播放功能唔係單純示意,而係透過完整 SoundFont synthesizer SpessaSynth 回播

限制亦寫得算坦白:權重受 CC BY-NC 4.0 約束;Intel Mac 要留意 PyTorch 同 Python 版本配搭。現有資料指出它訓練用到 170k 首歌,涵蓋 classical music 到 heavy metal,定位上明顯比只靠小量真實資料、再用大批合成音訊補足嘅方法更著重真實混音可用性。對需要高質多樂器 AMT 嘅人,MuScriptor 目前最值得留意嘅,係它唔再只展示「可以轉譜」,而係開始處理「轉出嚟能否進入後續編曲或分析」呢個關鍵差距。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Mac, Python, 音樂, Dataset 數據集

reasoning-blind-spots:找出 AI 推理盲點的測試集

blind-spots-bench 把看似簡單的題目變成壓力測試,幫你看清前沿模型在哪些推理步驟容易失手。

front page new

最值得留意的矛盾,是題目對人類不算難,卻會令前沿模型露出推理短板;blind-spots-bench 屬於基準測試與資料集項目,用來檢查 AI 在抽象、文字及多模態推理題上的失誤位置。

很多模型評測偏向看總分或通用能力,這個項目把焦點放在「盲點」:模型可能懂得生成流暢答案,卻在追蹤規則、連鎖映射或跨模態線索時走錯一步。資料集已放在 Hugging Face,格式包括 parquet,規模少於 1K,較適合做針對性壓測,而不是當成大規模訓練資料。

  • 定位清楚:針對 frontier AI models 的 reasoning capabilities 做壓力測試。
  • 工作流完整:以 Inspect AI 作為 evaluation framework,並提供 scripts 重現評測。
  • 可檢查答案:grader.py 負責 Scorer/Grader/Verifier logic,solver.py 處理 Solver/Generator logic。
  • 覆蓋形式:資料包含 Image 與 Text,題型可分為 Text-only 與 Multi-to-text。

安裝與部署層面,這不像一般應用工具按幾個掣便完成任務;較合理的理解是把它接入評測流程,透過 conf/ 的 Hydra 設定、scripts/ 的重現腳本,以及 notebooks/ 的分析視覺化,對模型輸出做批量測試與比較。

結果表列出 mean@4、pass@4、out-tks 與 cost ($/100) 等指標,並可見 GLM-4.7、GLM-5、GLM-5.1、GLM-5.2 等相關模型。它較適合模型研發團隊、評測工程師、AI 產品團隊用來補足一般 benchmark 看不到的錯誤模式;若只想找聊天機械人的日常排行榜,這個項目的粒度會顯得更偏研究與診斷。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, OpenAI, Image, 框架, Dataset 數據集

SpectraReward:用 MLLM 反讀圖片做文生圖獎勵

想提升文生圖結果,但又唔想另外訓練獎勵模型,SpectraReward提供了一條更直接的路。它用預訓練 MLLM 反過來讀圖還原提示詞,作為生成好壞的依據。

Og image

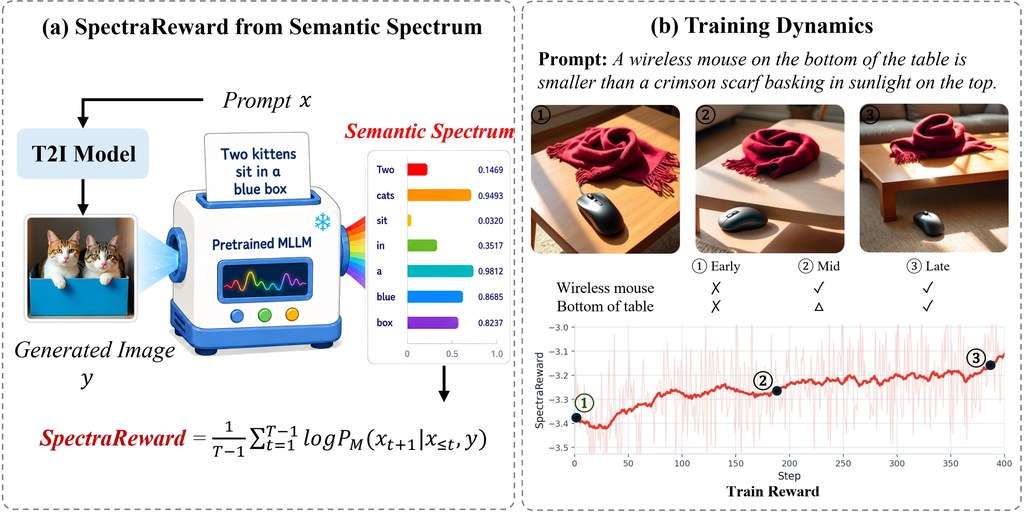
文生圖訓練最麻煩的一環,往往不是生成本身,而是怎樣穩定判斷圖片有冇跟足提示詞。SpectraReward 屬於影像生成 reinforcement learning 的獎勵方法,處理的正是這個問題:它不靠人工偏好標註,也不用再微調 reward model,而是借用預訓練 Multimodal Large Language Models(MLLMs)本身已有的圖文對齊能力,直接替生成結果打分。

核心做法很直觀:先讓 MLLM 看生成出來的圖片,再檢查它能否把原本的 prompt「讀返出嚟」。SpectraReward 用一次 image-conditioned、teacher-forced forward pass,計算 prompt 的平均 log-likelihood,數值越高,代表圖片越能還原文字意圖。相比常見做法要模型直接評分、回答拆解後的驗證問題,這個方法少了額外訓練步驟,也減少了設計評分流程的負擔。

項目亦提出 Self-SpectraReward,對 BAGEL 這類 unified multimodal models(UMMs)尤其有意思。做法是讓同一個模型的 understanding branch,為 generation branch 產生的樣本評分,形成 self-reward。這種安排的重點不在模型愈大愈好,而在 reward 與 policy 是否真正對齊;資料指出,這種內部對齊效果有時可追平,甚至超過更大型的外部 MLLMs。

  • 不需要 preference labels,也不需要 reward-model fine-tuning
  • 只用一次 MLLM forward pass,就可計出 training-free reward
  • 把「圖片能否還原 prompt」變成可量化的獎勵訊號
  • Self-SpectraReward 適合 BAGEL 類 unified multimodal models(UMMs)

從結果描述來看,reward 提升時,複雜場景生成質素也同步改善,表示這個訊號不只理論上合理,亦能推動可見的畫面進步。對正在做 text-to-image generation、影像模型強化學習,或想減少外部獎勵模型依賴的讀者來說,SpectraReward 提供了一種更省步驟、但仍保留語義判斷能力的路線。文中提到的模型包括 MLLMs,以及 BAGEL 這類 unified multimodal models。

項目主頁 · GitHub

Categories: 香港大學, 北京大學, 字節跳動, 多模態模型, 模型訓練, Image, 影像模型, txt2img, 香港

Page 69 of 183
1 … 67 68 69 70 71 … 183