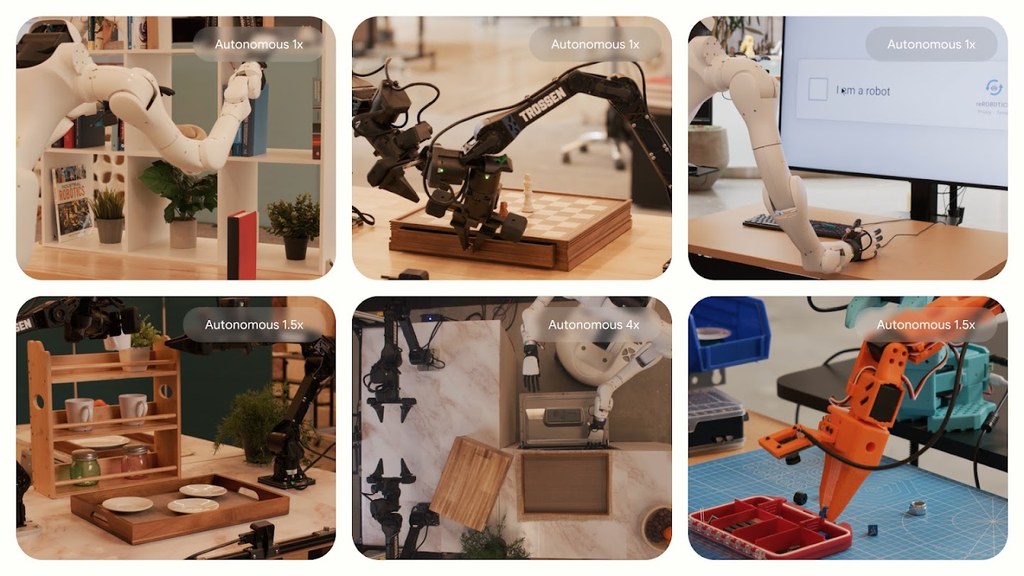
Gemini Robotics 2 想令機械人動作更完整

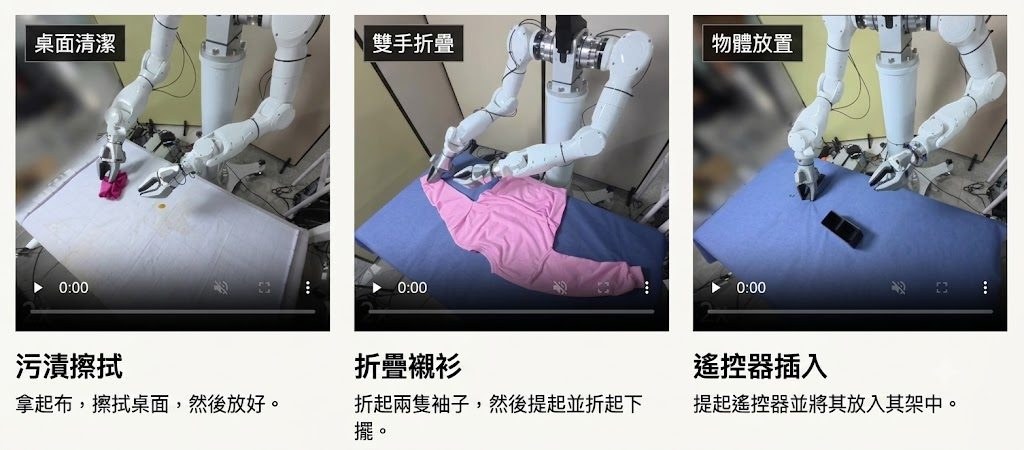
重點唔止係識睇同識答,而係令機械人連身體控制都更連貫。Gemini Robotics 2 指向的是把感知、推理同動作放入同一條工作流。

CSJxggUnu5m5TfompiXP2z7YLThhUvDn2 kBueCZv6HCEWWefUt WLzM6wxnTV1sTGqBbvmXDnOTB12W18NDr2NgFVXvHKCiTtjfXpyzuOYPJZXlg=w1440

機械人最難處理的,往往不是單一步驟,而是由看見環境、理解指令,到整個身體協調完成動作的連續過程。Gemini Robotics 2 聚焦的正是這個落差,嘗試把 whole body intelligence 帶入機械人,讓系統不只會辨識和規劃,還能更自然地連動身體控制。

Google DeepMind 把它放在 Gemini Robotics 這條 physical AI 路線之下,定位清楚偏向機械人操作與互動。相比只處理螢幕、語言或單一機械臂任務的做法,這個方向更重視整體行為是否連貫,包括感知、推理、用工具與跟環境互動能否接上同一套能力。

對研究機械人、embodied AI 同 VLA 工作流的人來說,這類項目最有參考價值的地方,在於它瞄準真實場景中的協調問題,而不是只展示單點能力。文章提供的內容仍屬簡介層面,未見完整評測細節、量化指標或部署條件,所以現階段較適合當成技術方向觀察,而不是直接當作可落地規格。

  • 把機械人的感知、推理與身體動作放到同一條能力鏈
  • 核心關注點是 whole body intelligence,而不只是語言或視覺理解
  • 屬於 Gemini Robotics 系列,延伸 Google DeepMind 的 physical AI 佈局
  • 現有公開資訊偏介紹性,性能與限制仍有待更多技術資料補充

整體來看,Gemini Robotics 2 反映出機械人模型正在由「識唔識做判斷」走向「能唔能夠完整做完一個動作」。對需要長步驟操作、工具使用與環境互動的場景,這種整合式能力會比單一模組升級更值得留意。
項目主頁

Categories: Agentic, 世界模型, Google, Gemini, NanoBanana, Video, VLA, Audio, Robotic, 安全, Skill 技能

MiniMax H3 頂級高清影片生成

MiniMax H3 提供咗一套較完整的影片生成 API。它重點不只是出片,仲包括參考生成同影片編輯控制。

Og image

做影片內容時,最麻煩往往不只是「生成一段片」,而係點樣令角色、鏡頭起承轉合同參考素材保持一致。MiniMax H3 屬於多模態影片模型,處理的正正係呢類控制力需求:除咗 Text-to-Video,亦支援以首幀、尾幀、參考圖片、參考影片同音訊去引導生成結果。

對內容團隊、短片創作者同需要自動化出片流程的開發者而言,呢個項目的吸引力在於輸入方式夠彈性。你可以由一段 prompt 起步,也可以加入第一張或最後一張畫面去約束開場與收尾;當需要保留人物、動作、鏡頭風格、聲線或剪接節奏,則可改用 Reference Generation。

MiniMax Just Dropped a Open Source "Seedance Killer"
  • 支援 Text-to-Video、First/Last-Frame Image-to-Video、Reference Generation
  • 統一理解 text、image、video、audio,多種素材可混合輸入
  • 輸出最高為 2K,片長 4 至 15 秒,只接受整數秒
  • 參考輸入上限包括最多 9 張圖片、3 段影片、3 段音訊,混合檔案總數上限 12

規格上,MiniMax H3 支援常見長闊比,圖片、影片與音訊都有清晰的格式及大小限制,例如影片可用 H.264/AVC、H.265/HEVC,圖片可用 JPG、PNG、WEBP,音訊則支援 WAV、MP3。音訊不能單獨提交,必須配合圖片或影片一齊使用;而較大的素材更建議用 URL 方式傳入,避免 API request body 超出 64 MB。

現有資料集中在能力範圍、輸入限制同 API 使用方向,能夠幫你快速判斷適唔適合接入工作流。

項目主頁

Categories: MCP, 多模態模型, 視頻模型, API, Video, Image, Audio, 語音, MiniMax

LTX-2.3 Black-Magic 黑暗補景 LoRA

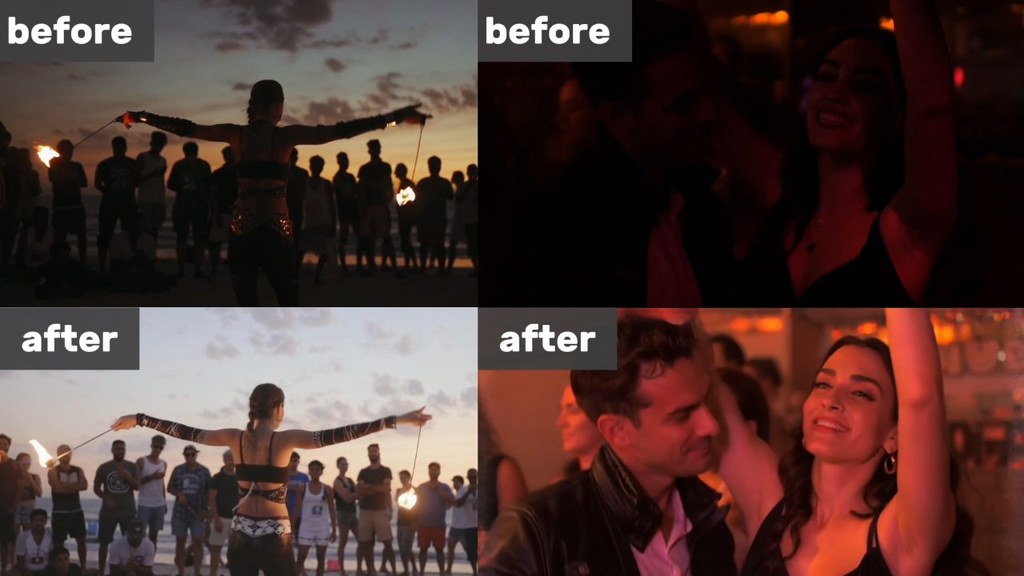
夜景片段唔夠光,未必只係拉高亮度就解決到。呢個 LoRA 走生成式 VFX 路線,重點係補出畫面可能存在的內容。

Og image

拍到過暗片段時,最直接嘅痛點係一加光就爆雜訊、細節仍然唔見。LTX-2.3-Black-Magic-LoRA 明確建基於 Lightricks/LTX-2.3,以 adapter 形式提供 IC-LoRA,定位唔係忠實還原訊號,而係替黑位內容做具時間連貫性嘅生成式重建,所以更接近 video-to-video 視覺特效模型,而唔係傳統 low-light enhancement。

取捨亦講得好清楚:當原始畫面資訊太少,模型會「推斷」暗處可能有咩,而唔係保證還原真實場景。呢種做法對氣氛鏡頭、夜景、舞台火光、森林或室內昏暗片段有吸引力,因為畫面觀感會比單純提亮更自然;但用喺證據保存、監控取證或要求真實性的工作,就要非常審慎。

項目提供嘅技術資訊相對精簡。已知它使用 diffusers,pipeline tag 係 video-to-video,模型檔案列出 black-magic-ic-lora-450.safetensors,而名稱中標示對應 LTX-2.3 22B。不過頁面截圖內容未見上下文長度、GGUF 格式量化、mmproj、llama.cpp、Ollama、LM Studio、MTP draft speculation、v2 更新紀錄、檔名變更或 chat template 說明,代表呢頁並唔係本地 LLM 部署型模型卡,相關部分無法確認。

  • 基礎模型已明示為 Lightricks/LTX-2.3,關係為 adapter,而唔係完整重訓主模型。
  • 能力核心係 shadow reconstruction,重建暗部觀感,唔等於忠實還原原始訊號。
  • 標籤集中在 ltx-video、low-light、generative-video、vfx、lighting,用途相當聚焦。
  • 已知檔案只有 black-magic-ic-lora-450.safetensors。

同一般曝光修正最大分別,在於接受「畫面不夠資料時需要生成補完」呢個前提。使用者應該將它視為風格化且偏後期製作取向嘅影像模型;想改善觀感、保住影片連續性,它有明確價值,但要用作真實場景還原,頁面本身已經劃清界線。

項目主頁 · 模型

Categories: 開源, 視覺模型, NVIDIA, Video, Image, Python, LTX

DeepSeek-V4-Flash 公測版重點更新

DeepSeek 把 V4-Flash 推上正式版 API 公測,焦點唔止係模型名稱更新,而係 Agent 工作流明顯變得更能打。對寫碼、自動化同工具調用有需求的人,呢次變更值得留意。

Og image

想用同一個 API 入口處理寫碼、自動化操作同工具調用,2026-07-31 呢次更新最值得留意。DeepSeek-V4-Flash 正式版已經開放 API 公測,調用方式維持不變,只要把模型名稱設為 deepseek-v4-flash,就可以切換到最新版本,對現有接入項目來講改動相對少。

今次更新的重點唔係介面改版,而係 Agent 能力明顯加強。官方列出的 Terminal Bench 2.1、NL2Repo、Cybergym、DeepSWE、Toolathlon verified 同 Automation Bench (Public) 等基準分數,都指向同一件事:V4-Flash 針對 Coding Agent、終端操作、工具使用同全棧開發場景做咗強化,而且公開測試成績已經高過 V4-Pro-Preview。

技術上,DeepSeek-V4-Flash-0731 的模型結構、尺寸都同 DeepSeek-V4-Flash-Preview 一致,更新集中在後訓練,意味住提升主要來自調整模型行為,而唔係換咗一個更大架構。它同時原生支援 Responses API 格式,亦有針對 Codex 做適配,對已經圍繞 API 建立 Agent 工作流的團隊會更易接入。

幾個重點可以直接整理如下:
– deepseek-v4-flash 已可直接使用正式版 API 公測
– API 調用方式不變,現有項目遷移成本較低
– Agent 能力是今次更新核心,涵蓋 coding、terminal 同 tool use
– Responses API 已原生支援,並針對 Codex 做咗適配
– 今次只更新 V4-Flash API,DeepSeek-V4-Pro API 以及 APP/WEB 端模型未有改動

使用上亦要留意邊界。現有資料有提供模型名、相容格式同基準測試結果,但未見更完整的安裝步驟、下載方式或者端到端接入流程;另外,官方亦講明今次並未更新 DeepSeek-V4-Pro API。對想盡快把 Agent 能力接入現有產品的人,V4-Flash 呢次公測比較像一次低改動、偏向工作流升級的更新。

項目主頁

Categories: Agentic, 模型, DeepSeek, API, Vibe Coding, 工具, 編程

Microsoft Mage:4B 多模態輕量路線

想做影像生成、編輯,甚至進一步研究多模態模型,但運算資源有限,Mage 會係一個值得留意的方向。它把 4B 規模壓到夠細,同時仍然追住更大模型的表現。

gallery

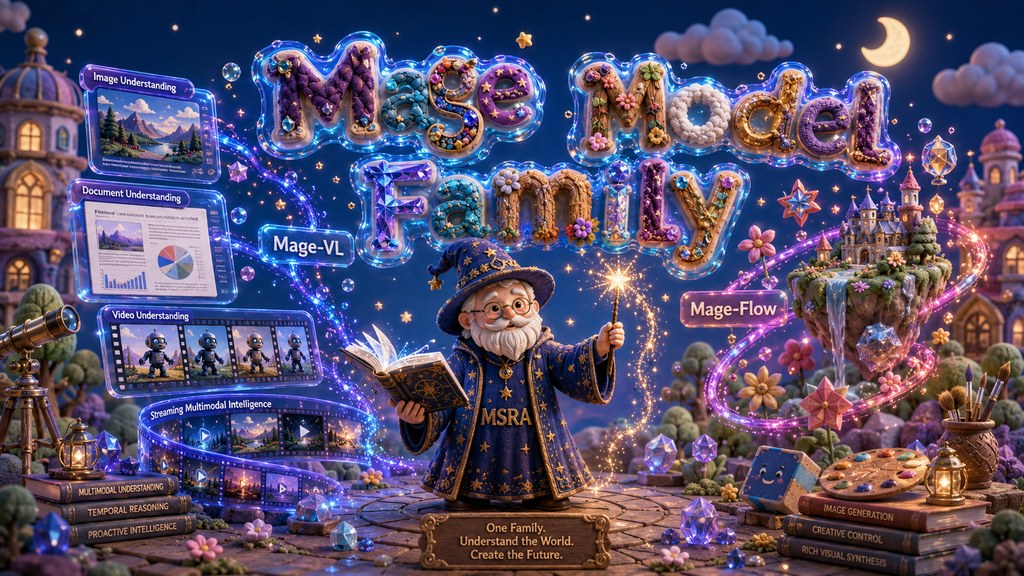
當你想喺有限 GPU 預算下做影像生成、編輯,甚至延伸到影像與影片理解,Mage 這個開源模型家族的定位就相當直接:用固定 4B 參數規模,處理多模態理解與生成兩條路線,目標唔係堆大模型,而係保留研究可控性同部署可行性。

Mage 目前最完整的是 Mage-Flow,屬於模型家族中的生成與編輯分支。它把 Mage-VAE 同 Native-Resolution Multimodal Diffusion Transformer 組合起來,前者負責更高效率的 latent tokenizer,後者負責文字生圖與指令式修圖;同時提供 Base、RL-aligned 同 4-step Turbo 版本,方便按畫質、對齊程度與速度取捨。另一條線 Mage-VL 對準 image/video understanding,但程式與權重細節仍待釋出。

同類開源影像模型很多都靠更大參數量換效果,Mage 的判斷明顯不同:它把重點放喺 codec-aligned efficiency,同一個 checkpoint 已可覆蓋 512 到 2048、不同長闊比,連 4:1 這類極端尺寸都原生支援,減少多套模型或額外縮放流程。它在生成、編輯表現上可與 Qwen-Image 20B、FLUX.2 32B、FireRed-Image-Edit 20B 等較大型開源系統競爭,但取捨是 Mage-VL 仍未完整開放,整個家族現階段更適合關注研究與工作流整合的人先行評估。

Super fast Image Edit model Mage-Flow on 8GB VRAM
  • 固定 4B 規模,主打可訓練、可微調、可部署
  • Mage-Flow 已覆蓋 text-to-image 與 instruction-based image editing
  • Mage-VAE 以更低 encode/decode MACs 減輕高解析度瓶頸
  • 單一 checkpoint 支援 512–2048 與多種 aspect ratio
  • Turbo 版本強調速度,1024² 在單張 A100 有明確推理數字

部署與測試方面,現有資料顯示 Hugging Face 已提供多個 Mage-Flow 與 Mage-Flow-Edit 權重,適合先用現成 checkpoint 驗證生成、修圖與速度,再決定是否進一步做微調。對做垂直領域影像項目、想研究後訓練方法,或者需要把高解析度生成放入較實際算力條件的人,Mage 的吸引力不在花巧包裝,而在它用一條輕量路線,把研究、性能與部署成本拉回較平衡的位置。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Stable Diffusion, Video, Image, 影像模型, 影像處理, txt2img, Medical醫學

ReDesign 把平面圖轉為可編輯設計

ReDesign想做的,就是把一張匯出圖,文字、圖層轉成獨立像素圖層結構,重新變成可編輯設計。

Repository image for jintae-00/ReDesign

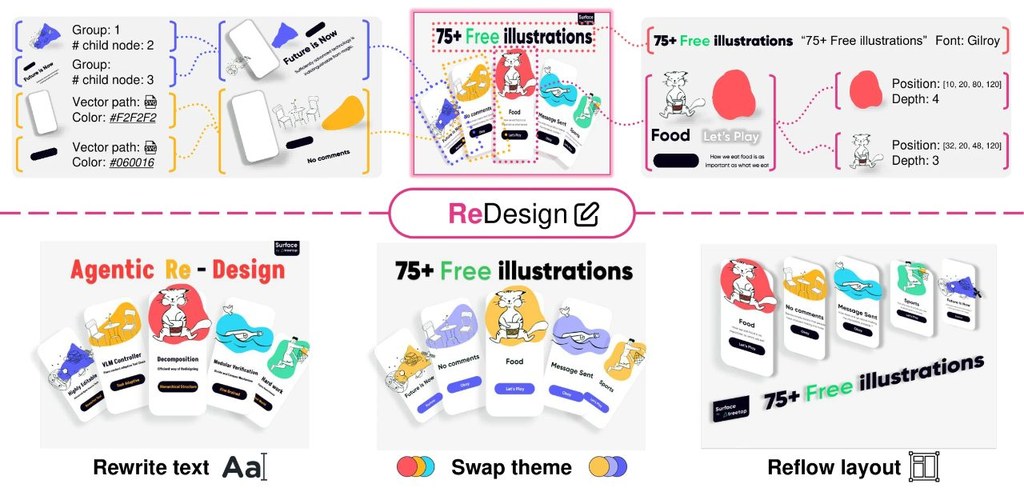
設計原檔遺失之後,最麻煩唔係畫面睇唔到,而係改唔到字、拆唔開圖層、調唔到前後次序。ReDesign屬於Agentic取向的研究型工具,目標係由單張 raster image 重建出可編輯設計結構,輸出成帶有文字、向量形狀、群組同 z-order 的 JSON hierarchy。

它的判斷方式唔係一次過猜完整個版面,而係將設計當成 layer tree,由大區域開始逐層拆細,再用 verifier 檢查每一步成唔成立。呢個取向比起只做 OCR、只做分割,或者直接做多圖層分解更完整,代價就係系統較重,亦要配合多個視覺工具同較高 GPU 記憶體,當中 Qwen 相關 worker 官方已寫明大約要對應 55 GB 級別資源先容易跑得順。

相關模組之間的分工幾清楚:VLM controller 負責揀動作,文字會交由 PaddleOCR、字體辨識、Hi-SAM 同 LaMa 處理;物件與圖層則會用到 Qwen-Image-Layered、GroundingDINO、SAM 2、connected-component analysis 同 VTracer。換句話講,呢個項目唔係單一模型,而係把多個模型與工具串成一條可驗證的還原流程,較適合研究設計還原、可編輯圖形生成,或者想將靜態素材重新帶回設計工作流的團隊。

  • 單張平面圖可還原成可編輯 JSON hierarchy
  • 支援文字、向量形狀、圖片、群組與 z-order
  • 採用 coarse-to-fine tree expansion,加上 verifier 修正分支
  • 效能展示基於 Figma-909,指標上普遍優於多個 baseline

評測方面,項目頁面列出 Figma-909 這個 Dataset 數據集,並顯示 ReDesign 在 L1、PSNR、LPIPS、PQ 同 F1 等指標整體領先 baseline,說明它唔只重建外觀,亦較重視元素級別的可編輯性。儲存庫已提供 agent、baseline 同工具後端結構,但它更似一個研究系統而唔係輕量腳本;較值得留意的是多 GPU 分片、平行 worker 同視覺工具的資源安排,較適合有運算環境的研究者或產品團隊深入測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 視覺模型, 多模態模型, Qwen, Image, 影像處理, Dataset 數據集

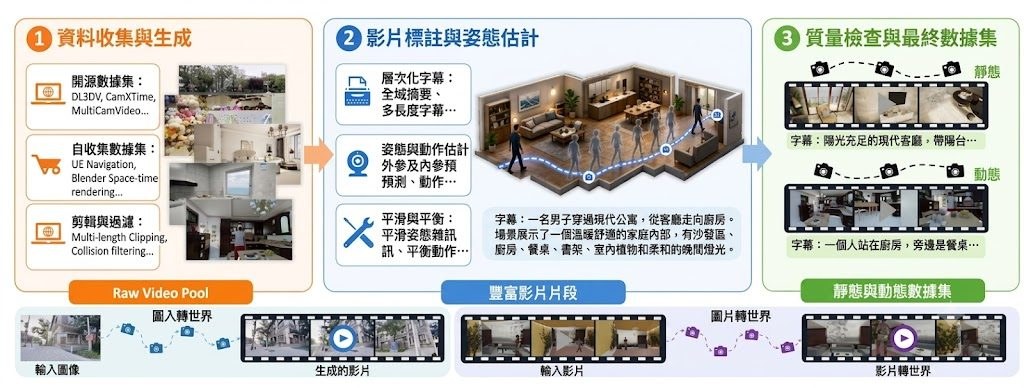
Wonder:Adobe 把影片變成可探索世界

輸入一張圖或一段片,Wonder會延伸出可持續探索的互動場景。重點不只係生成畫面,而係鏡頭移動之後,世界仍然記得之前見過嘅內容。

huggingface logo

由一張圖片或一段影片出發,Wonder會建立一個可以邊走邊看的互動式 Video World Model,處理的是「鏡頭一直移動,但場景仍要連貫」這個難題。你向前推、左右轉,甚至回到之前看過的位置,畫面都要盡量保持幾何、外觀同動態一致,而唔係每一格重新幻想一次。

呢個項目吸引的地方,在於它兼顧了互動感同穩定性。官方資料指出,Wonder支援 image-to-video 同 video-conditioned generation,提供 6-DoF camera control,並以接近固定延遲維持最長一分鐘的探索;對想做可遊走場景、遊戲世界原型、動畫預覽,或者互動式視覺敘事的人來講,呢種體驗比單次生成短片更有用。

為咗令鏡頭控制唔只停留喺抽象指令,Wonder把相機平移與旋轉轉成可對齊畫面的密集視覺證據,再配合 3D scaffold 同 environment map 去建立可導航空間。它亦保留完整歷史的 KV caches,再用 sparse attention 抽取相關記憶,令系統可以在不明顯拖慢回應下,維持較長距離的一致性。

  • 支援 I2V+V2V multimodality,可由圖片或影片開始生成互動世界
  • 提供 6-DoF camera control,重點是可探索而唔係只看固定鏡頭片段
  • 以 sparse attention 配合完整歷史記憶,改善長時段連貫性
  • 官方展示為 16 FPS rollout,頁面上的 32 FPS 影片屬線性插幀後處理

訓練部分用了 Mixture-of-Students 設計,並以 GAN Control Regularization 處理蒸餾時的 camera drift,目標是同時保住控制能力同長期一致性。現階段公開資訊以示範與技術報告為主,Code 同 HuggingFace 尚未釋出;不過單看定位,Wonder已經清楚指向一類更接近「可互動世界」而唔係「一次性影片生成」的世界模型方向。

項目主頁

Categories: 開源, 視頻模型, 世界模型, 模型訓練, Video, Image, 3D

HiFi-UMI 用純人類示範訓練可落地機械手策略

唔使先收機械人數據,亦可以把人手操作片段變成可部署的 manipulation policy。HiFi-UMI 想處理的,正是資料取得太貴又太慢的卡位。

Hero image preview

收集機械人操作數據一直又貴又慢,尤其牽涉真機示範、重覆錄製同場景對齊時,門檻會再高一截。HiFi-UMI(Universal Manipulation Interface) 聚焦在 robotic manipulation 訓練流程,嘗試只靠高保真人類示範資料,學出之後可以直接部署的 manipulation policy,重點放在減少對 robot data 的依賴。

它吸引人的地方,不是單純把人類影片拿來做模仿學習,而是想處理一個更難的落差:人類動作同機械人執行方式並不一樣,但資料又最容易先由人收集。HiFi-UMI 的方向,是用 high-fidelity UMI data 把這種落差壓低,令純 robot-free data 也有機會支撐 deployable policy。

適合留意這個項目的人,會是做 imitation learning、robot learning,或者正面對資料成本過高的研究與開發團隊。當工作流卡在「冇足夠真機數據先練唔到模型」時,這類方法提供了一條先用高質人類資料起步的路。

  • 核心取向是 robot-free data,減少收集真機示範的成本
  • 重點不只在學習動作,還在能否得到 deployable manipulation policies
  • 依賴的是 high-fidelity UMI data,而唔係低配對、低一致性的隨意示範
  • 最受用的場景是資料昂貴、真機時間有限的 robotic 項目

現有資料只交代了項目的核心主張,未見更完整的模型結構、訓練細節或評測數字,所以現階段較適合把它理解成一個很鮮明的研究方向:先提升人類示範資料的可用性,再把學到的能力推近真實部署。要判斷它比其他做法強幾多,仍要等更完整的技術內容同 benchmark 結果。

項目主頁

Categories: Robotic, Dataset 數據集

Sol-Attn:免訓練稀疏注意力 影片生成加速達 2.1 倍

Sol-Attn 用一套即時運作的稀疏注意力機制,讓預訓練好的影片與圖像生成模型無須重新訓練,就能跑得更快兼保留畫質。對本地部署或自建生成管線的人來說,等於多了一個現成的加速選項。

Og image

影片生成模型愈來愈強,但推理速度依然是開發者和創作團隊最常卡住的地方。NVIDIA Research 提出的 Sol-Attn,正正針對這個矛盾:它把「訓練用嘅成本」同「推理時嘅效率」分開處理,讓預訓練模型無須重新訓練就可以直接加速。

Sol-Attn 屬於免訓練(training-free)嘅稀疏注意力機制,做法是動態計算一個 query 相關嘅閾值,即場篩走低貢獻嘅注意力區塊,同時把未選中嘅分數重用做近似補償,整個過程喺一次 online-softmax 內完成。換句話講,它毋須事先計好一張路由表,亦唔會直接丟棄被跳過嘅區塊,因此能保留長尾分佈對最終畫面嘅影響。

喺 Wan 2.1、Hunyuan 1.5、LTX 2.3、Bernini 等多個主流模型上,Sol-Attn 都做到約 2 倍嘅速度提升,同時畫質幾乎唔受影響。若配合 Sol-Engine 中其他加速技巧,仲可以推到 5 倍嘅端到端加速。對於要跑長影片、做後製編輯,或者本地有限顯示卡環境嘅使用者來說,呢個幅度算係幾實用嘅改進。

對比以往「離線先揀一次、再丟棄」嘅做法,Sol-Attn 最大嘅差異在於即場判斷同重用機制。讀者如果本身就喺度搵方法縮短生成等待時間,又唔想額外花資源微調模型,呢套方案值得留意。

項目主頁 · GitHub

Categories: 視頻模型, 模型訓練, NVIDIA, Video, Image, LTX

quote-and-retrieve:用「引文+檢索」的視覺文件理解

你可以把它理解成:當 VLM 答對問題卻指錯位置,問題未必出在模型,而是出在要求它輸出座標這種介面設計。換成「引文+檢索」後,歸因召回率翻倍,幻覺率近乎減半。

Repository image for Ryenhails/quote-and-retrieve

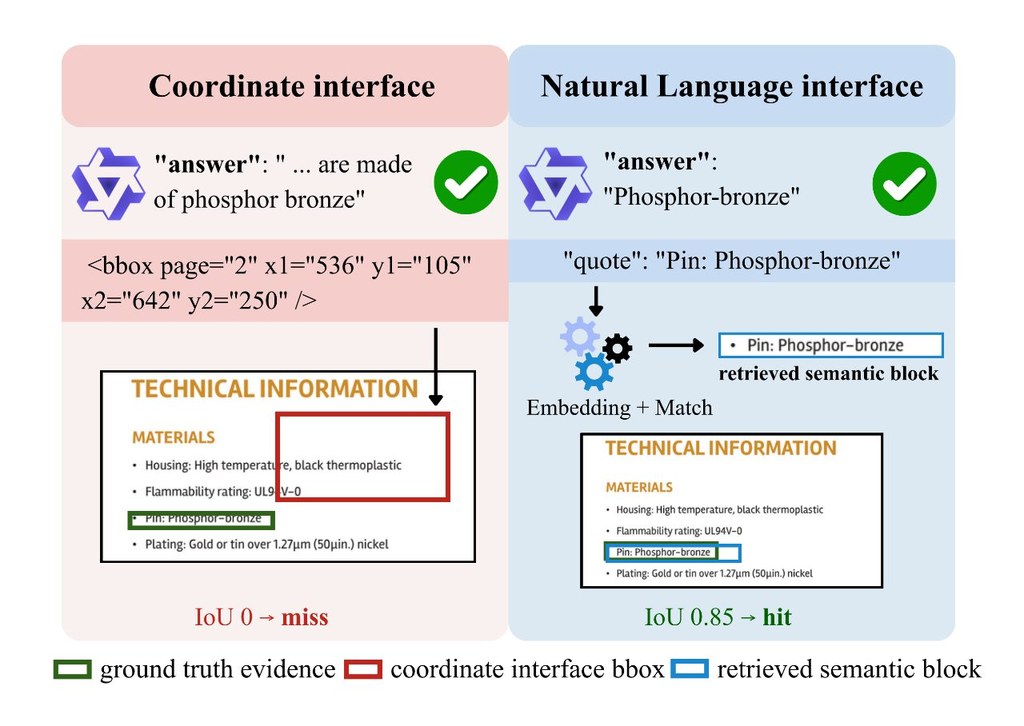
視覺語言模型 (VLM) 讀完文件回答問題時,傳統做法會要求它同時輸出 bounding box 標註證據位置;然而開源模型經常「答對但指錯」,這現象被稱為 Attribution Hallucination。這個來自赫爾辛基 Aalto 大學的開源項目主張,問題癥結很大程度是輸出介面本身的限制,而非模型缺乏 grounding 能力。

他們設計了一組控制變量實驗:固定模型、輸入頁面、題目與評分機制,僅改變證據表達方式。座標介面要求模型逐 token 生成框;語言介面則由模型輸出逐字引文,再交由外部 layout parser 與 retriever 找回對應區域(表格與圖片透過 caption 或註解引用)。在四個家族共六款開源 VLM 上,evidence recall 由座標介面下最高 8 分躍升至語言介面的 26 至 47 分,hallucination rate 近乎砍半,而答題品質幾乎不變。

基於這個對比,作者進一步提出 region-label-free GRPO 訓練方法:獎勵訊號只讀取 gold answer 與檢索區域的裁切圖,毋須任何 region-level 標註。8B 模型在這個框架下,strict attributed accuracy 由 22.4 提升至 33.8,等於用更便宜的監督換到明顯的歸因改善。

對於處理長文件、多模態表格或需要可追溯證據鏈的團隊(例如文件審核、研究文獻回顧)來說,這條 quote-and-retrieve 路線既繞開昂貴的人工框標註,也避開模型不擅長的座標生成。想要快速感受差異,只需 clone 項目後執行 python src/score_citevqa.py examples/sample_predictions.jsonl 與同一指令對座標版本跑一次;附帶的範例檔只有四題合成題,卻已重現論文核心發現。

重點摘要:
– 問題重新定位:歸因幻覺多屬輸出介面產物,並非模型能力不足
– 介面切換:座標介面換成引文+外部 retriever,evidence recall 由 ≤8 升至 26–47
– 訓練替代方案:region-label-free GRPO 用 gold answer+裁切圖作獎勵,毋須昂貴框標註
– 規模效益:8B 模型 strict attributed accuracy 由 22.4 提升至 33.8
– 快速驗證:附範例 JSONL,無需 GPU 即可重現對比結果

GitHub · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, Clone, Python

Page 61 of 183
1 … 59 60 61 62 63 … 183