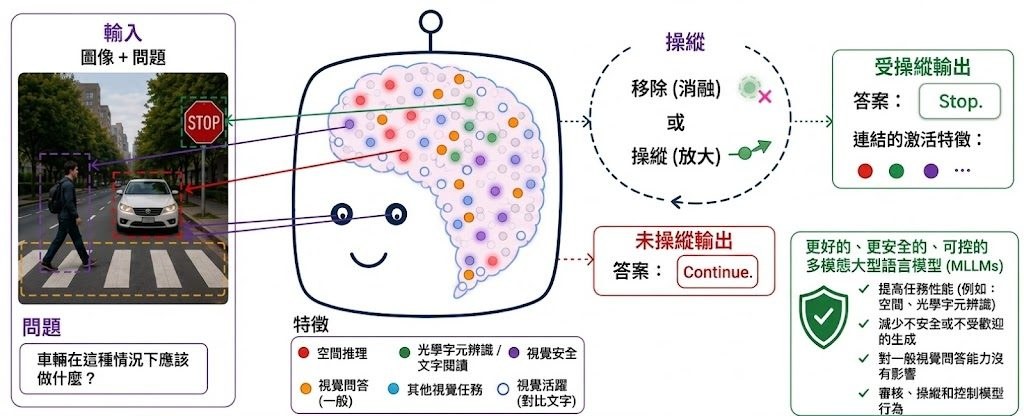
MMDiff 以特徵差分操控多模態模型行為

MMDiff 把文字模型同多模態版本之間嘅差異拆開,找出受視覺訓練改寫嘅特徵,再用嚟削弱或引導模型行為。對做多模態安全、空間推理同 OCR 嘅團隊,佢提供咗一條可解釋又可干預嘅路。

MMDiff

MMDiff(Multimodal Model Diffing)係一套研究型方法,處理嘅問題唔係再訓練模型,而係先睇清楚多模態大型語言模型(Multimodal Large Language Models, MLLMs)入面邊啲特徵因為視覺訓練而改變,再將呢啲特徵移除或引導。對要做審核、除錯、對齊行為嘅團隊,呢種做法比單靠黑盒輸出更實用。

佢嘅核心做法係將基礎語言模型嘅 sparse autoencoder(SAE)同多模態 SAE 對齊比較,再用 contrastive per-token firing 去揀出任務相關特徵。之後可以做 causal removal,或者用 MMDiff-CAA 喺相關層面 steering,直接改變模型喺空間推理、OCR 同安全場景嘅輸出傾向。

項目提供咗對應嘅 SAE checkpoints,亦有針對 LLaVA-MORE、PaliGemma 2 同 InternVL3.5 嘅結果。作者做咗視覺空間理解、多模態安全同 OCR 評測,指出移除單一特徵可令目標能力下降,同時一般 VQA 受影響好細,顯示呢套方法唔係純觀察,而係真係可以做定向控制。

  • 可用嚟定位多模態訓練改寫咗邊啲特徵
  • 可以將特定行為削弱,而唔一定要重訓整個模型
  • 對做 OCR、空間推理、模型安全審查嘅團隊特別有用
  • 測試結果顯示,目標能力下降明顯,一般 VQA 干擾相對細
  • 方法可跨幾個 MLLM 家族轉用,唔只限單一模型

項目主頁 · GitHub · 模型

Categories: 開源, 多模態模型, 微軟

MobileMem 把手機長期記憶放入真實場景測試

手機助手要記住一年的生活,難點不只是搜尋資料,更要理解跨應用、跨模態的長期脈絡。

logo

手機助手若要回答「女兒七歲生日有哪些照片」或核對過敏藥物,單靠短對話記憶很快會失準。MobileMem 屬於端側長期記憶(on-device long-term memory)的評測框架與資料集,將一年手機經歷整理成可重現的測試環境,檢驗記憶系統能否跨應用保留、連結及找回重要資訊。

它涵蓋 365 天、12 個應用程式,以及每位使用者平均 1.72M tokens 的資料規模,來源包括對話、日曆、筆記、瀏覽紀錄和相片等異質內容。與只測單輪問答或獨立文件檢索的做法相比,MobileMem 更接近長期使用情境,但同時令資料整理、隱私處理和推理成本變得更複雜。

資料分為兩條 benchmark track:text 供文字記憶系統處理長期對話與結構化 mobile-app events;omni 則加入 screenshots 和 photos,測試多模態記憶。它本身不是模型,而是用來比較不同 memory systems、分析失敗原因及建立 leaderboard 的測試基礎。

  • 支援文字與多模態兩類測試
  • 涵蓋跨應用、長期且知識密集的 mobile agent trajectories
  • 可從 HuggingFace 下載資料集
  • Dataset Explorer branch 提供互動式資料瀏覽
  • 現有資訊未列出具體模型分數,需查看 leaderboard 或自行重跑測試

研究人員可先下載 HuggingFace 資料集,按 text 或 omni 軌道接入自己的記憶模型,再利用網站和 Dataset Explorer 檢查案例。適合開發 mobile agents、personalized assistant、長期 RAG 或 multimodal memory 的團隊;涉及健康紀錄、家庭相片等私人內容時,仍要自行確認資料授權、匿名化和端側部署要求。

項目主頁 · GitHub

Categories: 開源, Agentic, RAG, 多模態模型, Medical醫學, 中國, Dataset 數據集

HumanTracker 想解決人形動作評測失真

影片睇落穩唔穩,未必等於關節誤差低。HumanTracker把人類偏好納入評測,補回人形動作追蹤最常被忽略的一段。

HumanTracker

只看關節角度誤差,往往會把腳滑、落地時機錯、支撐不穩這些觀感上很明顯的問題沖淡。HumanTracker屬於資料集加評測工具類型,核心不是再做一個追蹤模型,而是替 humanoid motion tracking 建立更貼近人眼判斷的 benchmark,讓 teleoperation 與 whole-body imitation 的結果不只「數值過關」,影片也更可信。

它的價值在於同時補兩個缺口:一邊擴大測試覆蓋,另一邊重寫評分方法。項目收錄約 153 小時光學動作資料、來自 24 位專業表演者,整理成四類動作家族,專門拉開日常步態、高動態、互動動作與接地穩定性之間的差異;再用 12K human-labeled preference pairs,訓練出偏好對齊的 HumanScore,去判斷哪條 tracker trajectory 更接近人會接受的效果。

跟 MPJPE 這類逐幀 kinematic 指標相比,HumanScore 重點不在每一幀有幾準,而在整段軌跡有沒有出現長時間滑步、抖動、漂移與失去平衡。官方提供的結果顯示,HumanScore 在測試集對人類偏好的對齊率達 90.83%,比較強的傳統診斷指標高 6.78 分;README 亦保留 Succ、MPJPE 與 HumanScore 幾種分數,代表它不是取代舊指標,而是把「物理上站不站得住」這件事補回評估流程。

  • 約 153 小時新採集 optical motion,涵蓋 25K 級別標註片段
  • HumanScore 來自 trajectory reward model,學的是人對整段動作的偏好
  • 儲存庫提供 evaluation harness、HumanScore reward model 同數據處理工具
  • 適合做人形機械人追蹤、模仿學習、teleoperation 評測的研究團隊使用

這個 GitHub 儲存庫比較像研究評測基建:重點是下載資料集、跑 evaluation harness、再用 HumanScore 與傳統指標一起看結果,而不是即開即用的終端產品。受益最大的會是做人形控制、動作追蹤與模仿策略比較的團隊,因為它能幫你分辨模型究竟只是把姿勢角度擬合得好,還是真的把接觸、穩定與動作連貫度處理好。限制也很明確:它主要提升的是評測可信度,不等於直接改善 tracker 本身能力。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, World-Action Model, Dataset 數據集

RA-Bench 直指危機假影片檢測盲點

危機事件影片最麻煩之處,不是合成得花巧,而是看起來太像真。RA-Bench把檢測器拉回真實傳播場景,專門測試這個落差。

RA-Bench: Can we defend against generated crisis videos?

當一段災難、戰事或公共事故影片本身已有真實事件做錨點,檢測器往往無法只靠內容違和感分辨真偽。RA-Bench屬於影片檢測基準資料集,針對的正是 AI 生成危機影片貼近真實新聞片段後,現有偵測方法還能否守得住。

它的做法有一個關鍵判斷:不再拿脫離情境的合成片去測,而是把真實危機影片與對應生成版本配對,並且涵蓋四個開源與五個閉源生成器。資料規模有 17,886 段影片,當中包括 1,830 段 real anchors、16,056 段生成片,另設 RA-Bench-HumanProof 與 RA-Bench-LastMile,前者收錄連人工審查者都一致誤判為真的 633 段影片,後者再測試影片經過連續傳播處理後,檢測器會否失準。

這個項目把「像真」、「會誤導人」、「經社交傳播後失真」三件事放在同一套測試裡。相對於只看配對樣本的資料集,它多了一層來源泛化與傳播鏈穩健性的要求;代價是資料權限較複雜,完整版本有部分 real anchors 只提供原始 URL,未必人人都能直接重跑 full 軌道。

  • public-media 只評估可重新分發的真實錨點配對,較適合公開重現與初步比較
  • full 依照完整論文清單評估,也要求處理只提供 URL 的真實來源
  • Hugging Face 釋出公開媒體約 93.8 GB,生成影片完整提供,真實素材則經權利審核後部分保留來源連結
  • 評估採用 source-matched evaluation,會把每個生成來源放回其對應真實錨點脈絡判斷

對做影片鑑識、內容審核、新聞驗證與多模態安全研究的團隊,RA-Bench的價值很直接:它不是教模型辨認「很像假片的假片」,而是逼它面對會在人類審查與傳播流程中混過去的片段。限制也同樣清楚,這仍是 benchmark,不是現成檢測器;要得出可比較結果,仍要先準備預測輸出、下載資料,並處理部分真實來源無法重分發的存取條件。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 多模態模型, OpenAI, Video, Dataset 數據集

playwright-skill 技能讓代理即寫即跑瀏覽器流程

這個項目把 Playwright 自動化包進 Agent Skill,適合要把瀏覽器操作變成可重跑程式的場景。它偏向 code-first,重點是把測試、截圖、網絡攔截和多步流程直接交給代理生成。

Repository image for lackeyjb/playwright-skill

面對要反覆驗證頁面流程、抓截圖、做網絡攔截,或者把操作保留下來重跑的情境,這個項目提供的是一套給 coding agents 用的 Playwright 自動化技能,並同時包成 Claude Code Plugin,安裝與接入都比較直接。

它不是單純的瀏覽器控制工具,而是讓代理按需要寫出真正的 Playwright 程式,再即場執行。官方也明講,若只是一般互動式瀏覽,Playwright CLI 或 playwright-mcp 會更合適;這個項目更適合 code-first 工作流,當自動化本身就是要保留的產物。

安裝方式以 Vercel 的 skills CLI 為主,支援全域或指定項目安裝;結構上把 skill 放在 plugin 的 skills 目錄,方便不同 agent 讀取。它也主打可見瀏覽器預設開啟、穩定的模組解析、臨時檔安全清理,以及按需載入完整 API,減少代理一次讀入太多內容。

  • 適合要寫、執行、重跑 Playwright 腳本的工作流
  • 支援單步頁面測試,也支援多步流程與多個 context
  • 可用於 screenshot、video、network interception 等任務
  • 和純工具式控制相比,更重視可保存的程式碼結果
  • 受益較多的通常是做自動化測試、爬取流程驗證、代理工作流的人

整體看來,這個項目把「讓代理操作瀏覽器」提升成「讓代理產出可維護的 Playwright 程式」。它的價值不在於包辦所有瀏覽器需求,而在於把可視化執行、程式化控制和可重用性放到同一條工作流裡。

GitHub

Categories: 開源, Agentic, MCP, API, 編程, Skill 技能

MiniMax-H3-Text-Embeddings ?

這不是傳統 NLP 或 RAG 領域中所指的「文本向量嵌入(Text Embedding)」模型。

Og image

這不是傳統 NLP 或 RAG 領域中所指的「文本向量嵌入(Text Embedding)」模型。MiniMax-H3-Text-Embeddings 實際上是 DiffSynth-Studio 團隊為 MiniMax-H3 影片生成大模型所設計的「視覺特效/風格控制向量(Diffusion Templates / Textual Inversion)」。

MiniMax-H3 是一個高達 33B 參數的大型多模態生成模型,若要透過訓練 LoRA 來控制風格或特效,顯存與算力成本非常高。DiffSynth-Studio 團隊採用了類似 Textual Inversion(文字翻轉/概念嵌入) 的做法:

  1. 極輕量替代方案:將特定特效(如火爆、風暴、環繞鏡頭等)預先訓練或編碼成特徵 Tensor。
  2. 直接注入文字特徵層:這些檔案體積非常小,能在推理階段直接替換或疊加到 MiniMax-H3 的 Text Encoder 輸出上。
  3. 模組化與組合:使用者可以像掛載外掛一樣,組合多個特效 Embedding 來控制生成的影片視覺效果。

3. 總結建議

  • 如果你是在找 RAG / 知識庫 / 搜尋用的文本嵌入模型:請忽略此模型,這不是向量檢索工具。
  • 如果你是在使用 DiffSynth-Studio 進行 MiniMax-H3 影片生成:這是用來快速套用影片特效、節省顯存並替代重型 LoRA 的控制模組。

項目主頁

Categories: 開源, RAG, Embedding, 視頻模型, MiniMax

DeepSeek Harness 把 Agent 變成插件

DeepSeek Harness 想解決的唔係單一 Agent 功能,而係點樣把模型、工具同工作流拆開重組。對想長期調整 Agent 流程的團隊,呢個方向比單次 demo 更有參考價值。

Repository image for deepseek-ai/deepseek-harness

DeepSeek Harness 把 dsh 做成一個面向開發者的 Agent harness,重點不在於再包一層聊天介面,而是把模型、工具、技能、會話、沙箱、存儲、循環、調度同 UI 全部拆成插件,讓團隊用配置去換件、重組,同時保留可追蹤的執行過程。它處理的是 Agent 進入真實工作流後,經常要改工具鏈、換模式、查執行軌跡的維護問題。

你可以直接用 npx @deepseek-ai/dsh web 啟動 Web UI,也可以從原始碼安裝;兩種方式都指向同一件事:DeepSeek 並非只想交付一個可試玩的介面,而是提供一個可延伸的開發底座。現階段它仍屬 developer preview,兼容性破壞會持續出現,較適合願意跟住 API 與插件生態一齊迭代的團隊。

跟不少把能力寫死在框架內的做法相比,DeepSeek Harness 把 Cordis 放在核心位置,內核只負責插件載入、卸載與依賴關係,Agent 能力則交由插件之間透過服務與事件協作。好處是替換模型、工具或 preset 時毋須大改源碼;代價是系統理解成本較高,穩定性亦未到可安心鎖版的階段。

它提供標準模式、PTC 模式、極簡模式同創造模式,反映出同一套底層同時照顧編碼 Agent、基準測試同自訂 preset。當中較值得留意的是 Trajectory 視圖與僅追加式會話日誌,系統會記錄提示詞、工具調用、結果、子 Agent 調度與上下文注入,對除錯、回放、分叉同檢索都幾有用,但官方未提供明確基準分數,現時較難直接用量化結果同其他 Agent 框架比較。

  • 用 Cordis 作核心,將 Agent 各層能力拆成可替換插件
  • 可經 Web UI 快速測試,亦可由原始碼部署到自訂環境
  • Trajectory 與事件流日誌有助追查每一步決策與工具操作
  • developer preview 階段變動頻密,較適合開發者與研究型團隊
  • 重點價值在可組合工作流,而唔係單一模型能力展示

項目主頁 · GitHub

Categories: 開源, Agentic, DeepSeek, API, 工具, Skill 技能, UI/UX

Qwen3.8 系列的 27B 開放權重模型

Qwen3.8-27B以 27B 密集模型同時處理文字、圖片與影片,重點不只在識別內容,而是更穩定完成多步驟任務。它延續 Qwen3.5 架構,但頁面公開的本地量化與 GGUF 資訊仍未齊。

Og image

由 Qwen3.5 的架構基礎延伸而來,Qwen3.8-27B把長流程推理、Agentic 任務同原生視覺理解放入同一個 27B dense 模型。使用時最直接的差異,是它不只看圖答題,亦針對編程、專業工作、研究與多步驟任務完成度作強化,並保留可調整的 thinking control。

模型層面採用 Causal Language Model with Vision Encoder,屬於經過 pre-training 與 post-training 的 image-text-to-text 模型。27B 參數、64 層、hidden size 5120,以及混合 Gated DeltaNet 與 Gated Attention 的 hidden layout,反映它不是單純沿用傳統 dense Transformer 堆疊,而是針對長程依賴與效率作結構調整。

Qwen 3.8 27B BLOWS MY MIND! Best Local AI Model Yet! Basically Opus Locally! (Fully Tested)

對開發者而言,較有用的是推理行為控制:thinking mode 預設開啟,可按請求關閉;reasoning_effort 可調整推理深度;preserve_thinking 可保留歷史訊息中的 reasoning context。

  • 基礎模型可確認為 Qwen3.5 架構系統上的後訓練版本,而非獨立另起爐灶
  • 原生支援圖片與影片理解,定位比純文字模型更貼近 Agentic 與多模態工作流
  • 相容 Transformers、vLLM、SGLang、TokenSpeed,方便接入現有堆疊
  • 頁面未提供 GGUF 格式、量化檔名、mmproj、Ollama/llama.cpp/LM Studio 建議配置
  • 亦未見 MTP draft speculation、v2 檔名變更或 chat template 注意事項的具體說明

與同系前代相比,Qwen3.8主打的是可靠完成整段任務,而不只是單輪回答更聰明;與一般視覺語言模型相比,它更強調 environment feedback 下的自主規劃。目前公開的是 Transformers 格式權重與設定檔,未足以直接判斷本地量化部署門檻,所以硬件需求、推薦量化等級與不同量化之間的取捨,現階段只能等後續模型檔或社群移植版本補上。

模型

Categories: Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, API, 編程

Qwen3.8-2.4T-A95B 超大型開放權重文字推理模型

Qwen3.8 把 Qwen-Max 級別能力帶到開放模型,強項不只是答題,而係更穩定完成多步驟工作。

Og image

Qwen3.8-2.4T-A95B 把 Qwen-Max 級別的能力開放出來,而且明確建基於 Qwen3.5 的架構底層,BF16 safetensors 格式及1M上下文。定位上屬於 Causal Language Model,面向文字生成、編程、研究工作與長流程 Agentic 任務;相比只追求單輪回答,它更著重規劃、接收環境回饋,以及把多步驟工作做完。

Qwen3.8-2.4T-A95B 的核心規格相當進取:總參數 2.4T(2.4 trillion)參數,但每次啟動 95B,屬於典型大型 Mixture of Experts(MoE)路線,用較高總容量換取較可控的推理成本。模型經過 Pre-training 與 Post-training,並採用 Qwen3.5 架構延伸而來的層設計,包括 Gated DeltaNet、Gated Attention 與 MoE 組合,重點不是單純堆大,而是提升長鏈推理與任務完成的穩定性。

Qwen3.8-2.4T-A95B 主要來自兩個控制點:reasoning_effort 可調整推理深度,preserve_thinking 可保留歷史訊息中的 reasoning context。這代表它比較適合需要反覆修正、逐步執行的工作流,而唔係只看一次輸出的場景。頁面亦提到它對常見 harness 與開發工具有更廣泛支援,模型檔案可配合 Transformers、vLLM、SGLang、TokenSpeed 等推論堆疊。

  • 基礎模型可確認是建基於 Qwen3.5 architectural foundation。
  • 已知開放的是 Hugging Face Transformers 格式的 post-trained 權重。
  • 官方另有 Qwen3.8-Max 版本,功能更多,包含 vision input、non-thinking support、內建工具,以及預設 1M context length;但這些能力屬於官方服務版本,不應直接視為此頁權重全部具備。
  • 從已公開資訊看,它的優勢在於長流程 Agent 執行與專業工作可靠度提升;限制是硬體需求、完整上下文長度與量化部署細節未在此頁交代,離本地輕量部署仍有距離。

跟一般只強調 benchmark 分數的模型相比,它更強調任務完成率、規劃能力與工具鏈兼容性。由於缺少量化版本、推理記憶體需求與更完整評測數字,現階段較適合把它理解成面向高階推論服務與大型基建環境的開放權重,而不是即插即用的本地模型項目。

模型

Categories: 開源, Agentic, 模型訓練, Qwen, API, LLaMa, Ollama, 編程, Dataset 數據集

GLM-5.3 強化程式與安全分析能力

GLM-5.3 把重點放在寫程式、做 agent 同安全分析,並沿用 GLM-5.2 的架構與參數量。它同時帶來更強的開發表現與漏洞發現能力。

Og image

GLM-5.3 走的是實用取向,重點放在複雜軟件工程、agent 工作流同 cybersecurity。對要處理程式審查、漏洞發現、工具調用,或者生成較完整應用的團隊來講,它提供的是更穩定的能力提升,而不只是加大模型規模。

Z.ai 亦將它定位為旗艦模型,並強調 GLM-5.3 同 GLM-5.2 用同一個 base model,改進主要來自 post-training。這代表它嘅提升集中喺後訓練階段,而唔係重新改架構;同時,Open-Source Shield initiative 亦反映出它想推廣防禦型用途,並限制高風險濫用。

  • 在 Z.ai Code Bench 上,GLM-5.3 較 GLM-5.2 有 50% 的編碼提升。
  • 在 Terminal-Bench 3.0 同 Agents’ Last Exam (CLI) 上,取得開源 SOTA 成績。
  • 在 CyberGym 上達到 SOTA,漏洞發現能力明顯加強。
  • 在 exploit benchmarks 上,表現超過 GLM-5.2 一倍以上。
  • 它支援 1M context length 同 128K maximum output tokens,適合長流程任務。

官方亦列出多種能力,包括 Thinking Mode、streaming output、function calling、context caching、structured output 同 MCP,方便接入外部工具同資料源。對要做長對話、複雜任務編排,或者把模型接入現有系統嘅使用場景,這些功能比單次問答更有實際價值。

文中提到,GLM-5.3 在 coding、frontend design、backend logic、simulations 同 complex app generation 都有明顯進步;在 KingBench 3 上得分 73/80,即 91.25%,排到第 1。整體來看,佢更像一個偏向開發同防守用途的強力開源模型,而唔係只靠單一 benchmark 造勢的版本。

項目主頁

Categories: Agentic, MCP, API, 編程, Dataset 數據集

Page 50 of 183
1 … 48 49 50 51 52 … 183